
Kursus
Docker Tingkat Menengah
4 jam
10.3K
Sebagian besar developer ingin mencoba LLM lokal, tetapi mereka tidak tahu harus mulai dari mana.
Munculnya model open-source seperti Llama dan Mistral membuat AI lokal lebih mudah diakses dari sebelumnya. Anda tidak perlu mengeluarkan uang untuk OpenAI atau Anthropic atau khawatir mengirim data ke pihak ketiga. Tantangannya adalah sebagian besar panduan penyiapan melibatkan pengelolaan environment Python, driver CUDA, dan dependensi yang sering bermasalah saat berpindah mesin.
Ollama mengatasi ini dengan menyediakan cara sederhana untuk menjalankan LLM lokal dengan penyiapan minimal. Saat dipasangkan dengan Docker, Anda mendapatkan solusi yang bersih dan portabel yang bekerja dengan cara yang sama di berbagai sistem.
Dalam panduan ini, saya akan menunjukkan cara menyiapkan Ollama di Docker, menarik model pertama Anda, dan mulai menjalankan LLM lokal yang dapat diakses dari aplikasi apa pun.
Jika Anda benar-benar baru mengenal Docker, kami merekomendasikan Anda mengikuti Introduction to Docker untuk memahami dasar-dasarnya.
Anggap Ollama sebagai cara paling sederhana untuk menjalankan large language model di perangkat keras Anda sendiri.
Ini adalah runtime ringan yang menangani semua pekerjaan berat untuk LLM lokal. Anda tidak perlu mengelola environment Python, menginstal driver CUDA secara manual, atau mengutak-atik bobot model dan tokenizer. Ollama mengurus pengunduhan, pemuatan, dan penyajian model seperti LLaMA, Mistral, dan Gemma dengan satu perintah.
Privasi terpasang secara bawaan. Percakapan Anda tidak pernah meninggalkan mesin Anda. Tanpa kunci API, tanpa pelacakan penggunaan, tanpa data yang dikirim ke server eksternal. Ini menjadikannya ideal untuk pekerjaan sensitif di mana Anda tidak bisa mengambil risiko mengekspos kode kepemilikan atau informasi pribadi ke layanan pihak ketiga.
Alat ini dirancang untuk developer terlebih dahulu. Berjalan secara native di macOS dan Linux, menawarkan REST API sederhana untuk integrasi, dan kini bekerja di dalam container Docker. Ini berarti Anda dapat menjalankan penyiapan yang sama secara lokal selama pengembangan dan menerapkannya di mana pun Docker berjalan.
Anda mendapatkan server LLM siap produksi yang mulai berjalan dengan satu perintah dan bekerja secara offline.
Ollama bukan satu-satunya runtime LLM - coba juga n8n dan Qdrant.
Jawabannya sederhana — Anda mendapatkan seluruh manfaat menggunakan Ollama sambil menjaga sistem tetap bersih.
Menjalankan Ollama langsung di mesin Anda tidak masalah — ia hadir sebagai installer paket (.exe untuk Windows, .dmg untuk Mac) yang menangani semuanya untuk Anda. Namun Docker menawarkan satu keunggulan utama: isolasi.
Dengan Docker, Ollama berjalan di dalam containernya sendiri. Ini menjaga sistem host Anda tetap bersih. Tidak ada jejak instalasi di sistem utama Anda, tidak ada file tersisa saat Anda selesai menguji, dan mudah dihapus saat Anda ingin beralih versi atau bersih total.
Penyiapan yang sama bekerja untuk semua orang di tim Anda berkat reproducibility. Bagikan perintah Docker, dan siapa pun dapat menjalankan environment Ollama yang persis sama, terlepas dari apakah mereka menggunakan macOS, Linux, atau Windows.
Penerapan menjadi sederhana dengan dukungan lintas platform. Container yang sama yang berjalan di laptop Anda akan bekerja di server cloud, pipeline CI, atau mesin rekan kerja tanpa modifikasi.
Anda dapat menyalakan Ollama dalam hitungan detik dan menghapusnya sama cepatnya dengan penyiapan dan pembongkaran yang disederhanakan. Tanpa skrip uninstall, tanpa mencari file config, tanpa pembersihan sistem.
Ini membuat Docker sangat cocok untuk:
Singkatnya, Anda mendapatkan semua manfaat LLM lokal tanpa pusing penyiapan.
Mencari sumber daya Docker yang lebih praktis? 12 image container Docker untuk machine learning dan AI ini akan membantu Anda memulai.
Hanya butuh tepat tiga perintah untuk menjalankan Ollama di Docker.
Pertama, tarik image Ollama resmi dari Docker Hub:
docker pull ollama/ollama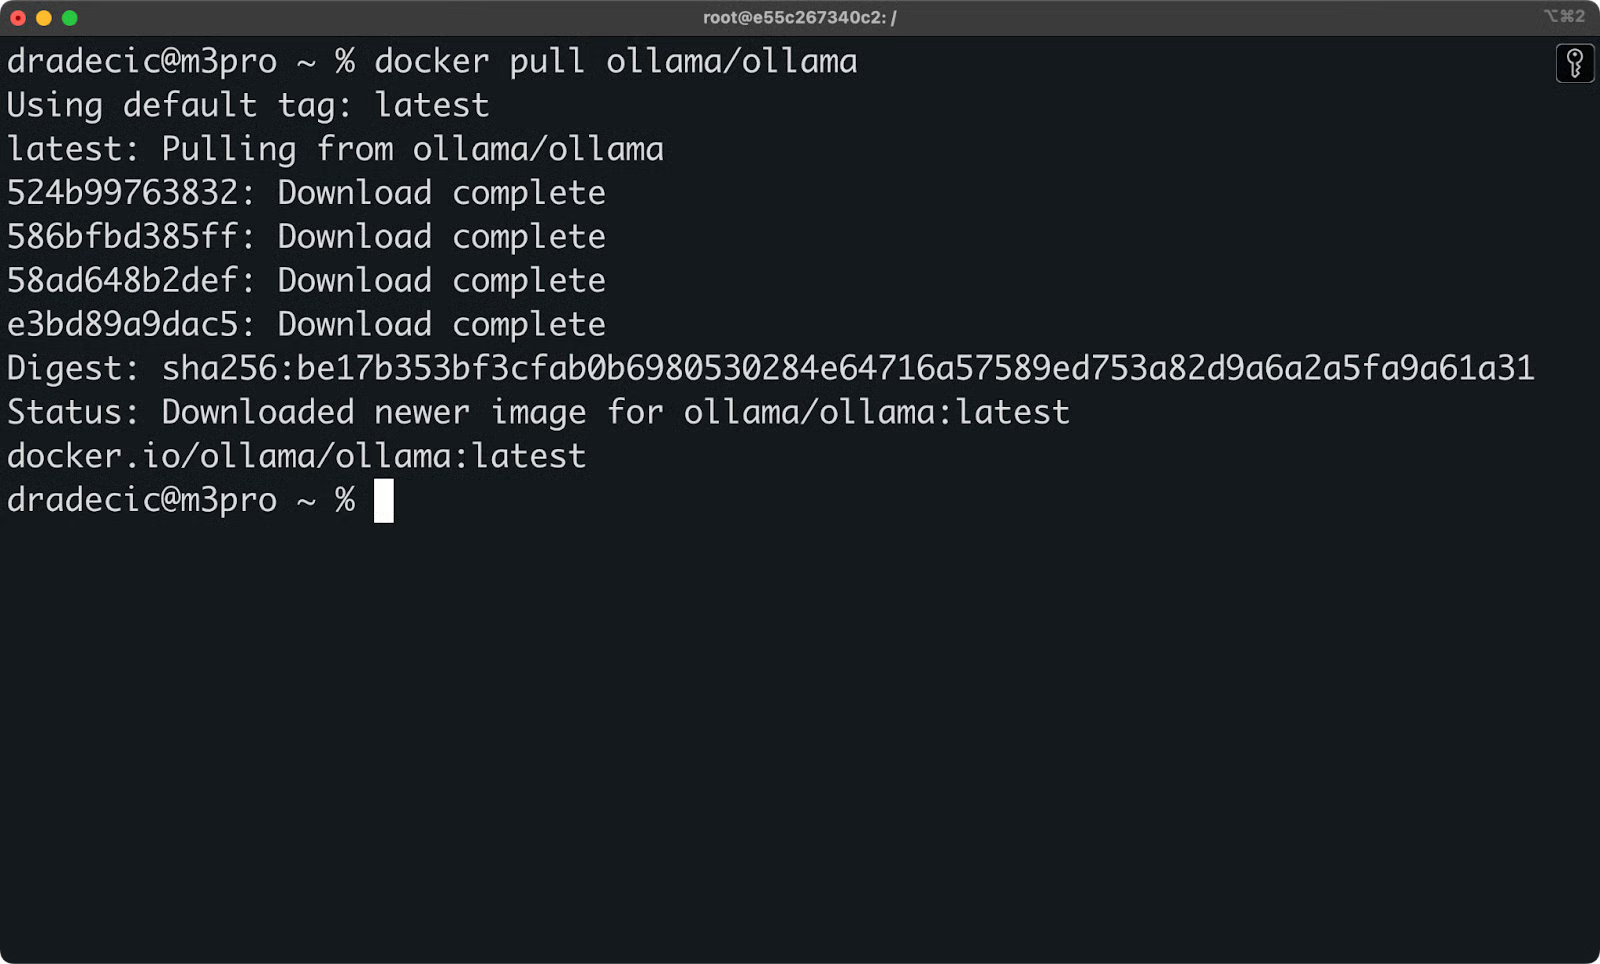
Menarik image ollama
Selanjutnya, jalankan container dengan pemetaan port dan volume yang tepat:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama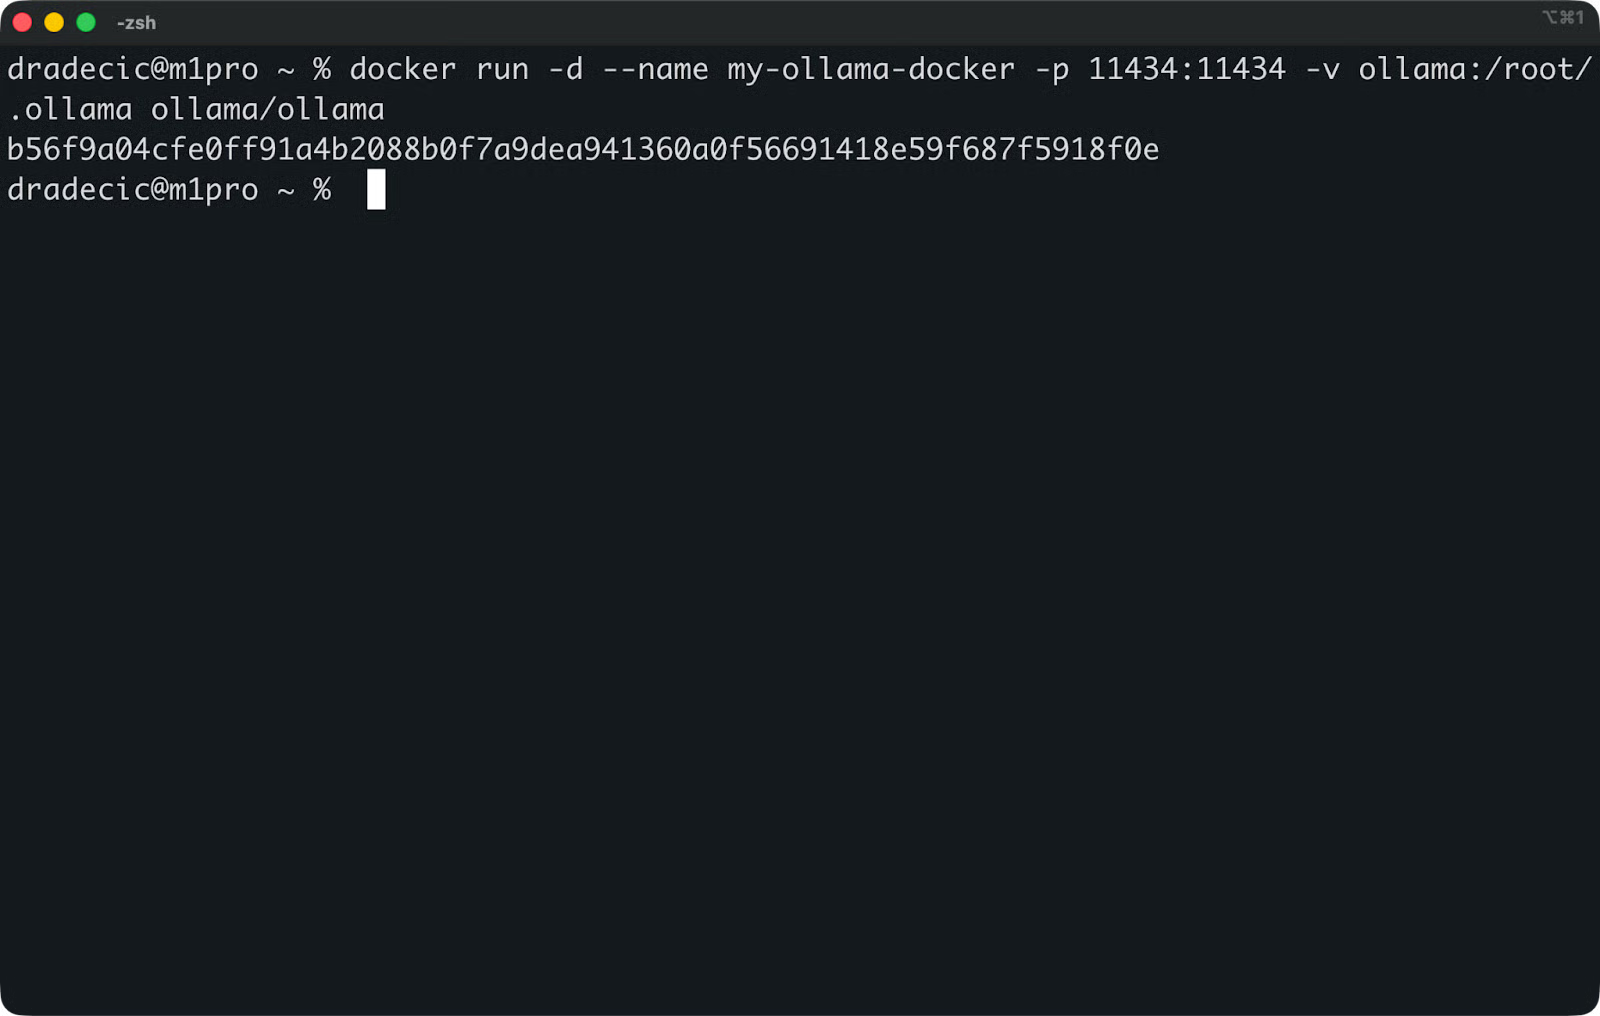
Menjalankan ollama
Berikut fungsi masing-masing flag:
-d menjalankan container di latar belakang--name my-ollama.docker memberi nama ramah untuk container Anda-p 11434:11434 memetakan port default Ollama ke mesin host Anda-v ollama:/root/.ollama membuat volume persisten untuk model yang diunduhContainer akan langsung mulai dan mendengarkan pada http://localhost:11434.
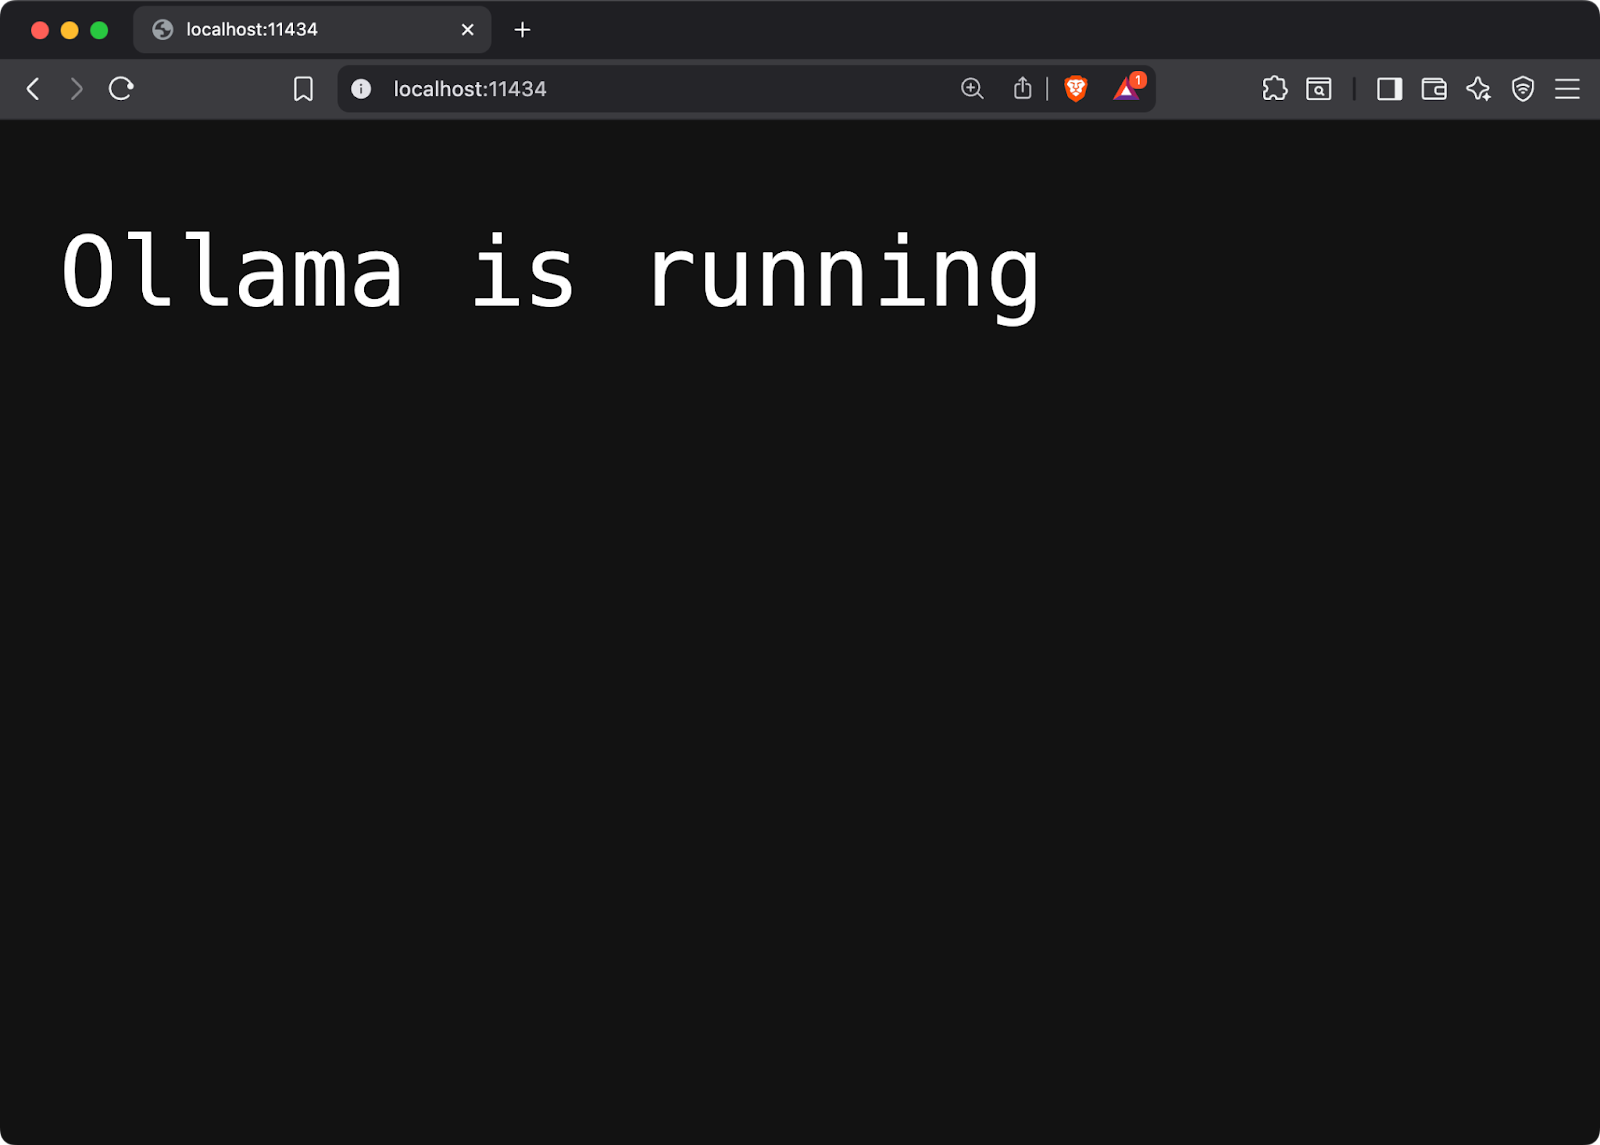
Ollama berjalan secara lokal
Sekarang unduh model untuk menguji apakah semuanya berfungsi:
docker exec -it my-ollama-docker ollama pull llama3.1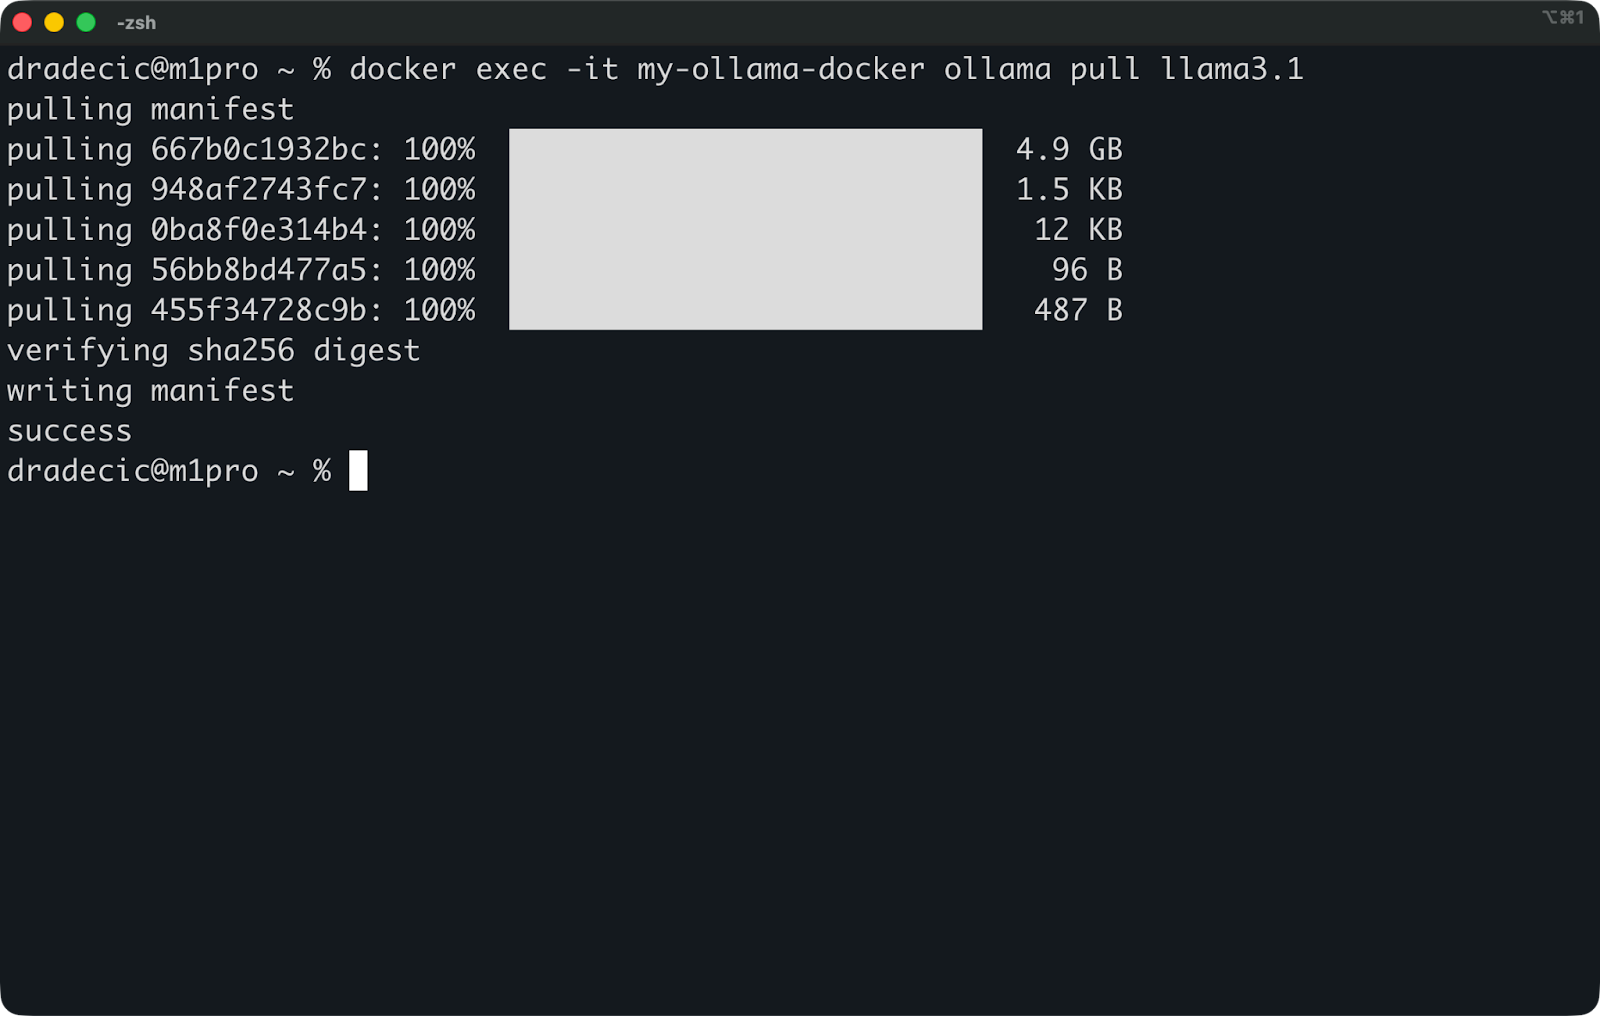
Menarik model Llama3.1
Ini akan mengunduh model Llama 3.1 8b ke dalam container Anda. Ukuran model sekitar 5 GB, sehingga pengunduhan dapat memakan waktu beberapa menit.
Anda dapat memverifikasi penyiapan dengan menampilkan daftar model yang tersedia:
docker exec -it my-ollama-docker ollama list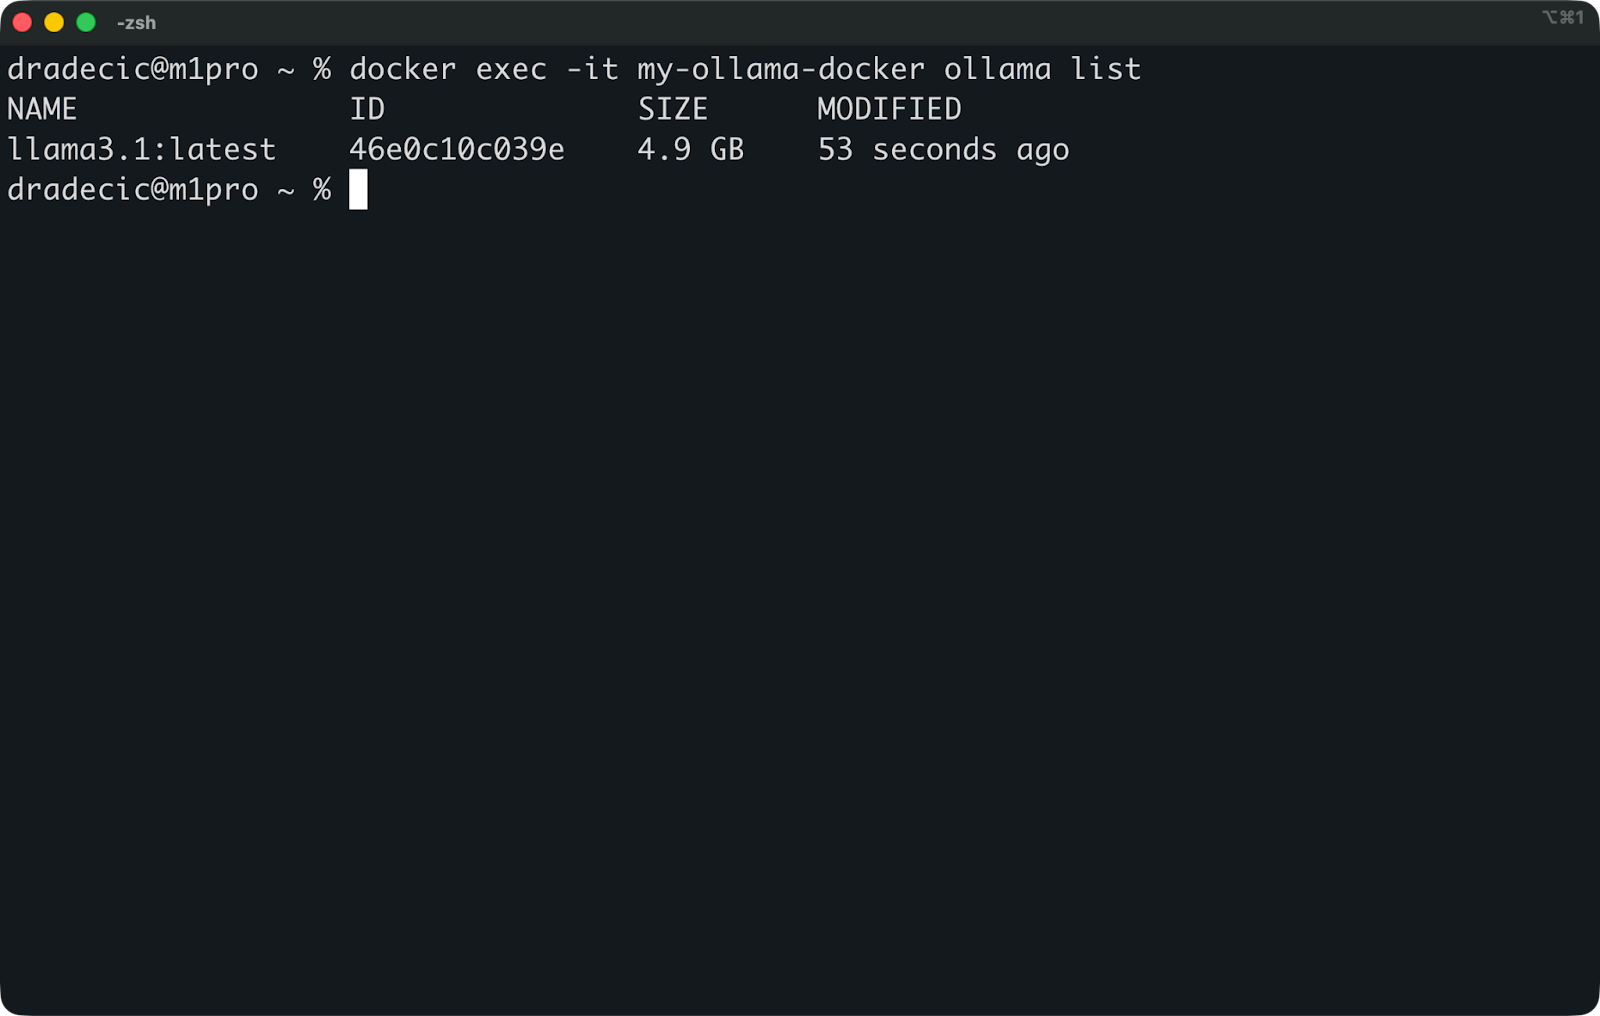
Menampilkan model yang tersedia
Pemetaan volume itu penting. Tanpanya, Anda akan kehilangan semua model yang diunduh saat container berhenti. Volume ollama:/root/.ollama mempertahankan model Anda antar restart dan pembaruan container.
Untuk penyiapan produksi, Anda mungkin ingin membangun image khusus dengan model pra-muat. Buat Dockerfile yang mengunduh model selama proses build:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
Ini memanggang model ke dalam image Anda, sehingga container baru mulai dengan semuanya siap pakai.
Setelah container Anda berjalan, Ollama bekerja seperti REST API lainnya.
Layanan mendengarkan pada http://localhost:11434 dan menerima permintaan HTTP standar. Anda tidak memerlukan klien atau SDK khusus — cukup kirim JSON dan dapatkan respons balik.
Berikut cara menghasilkan teks dengan perintah curl sederhana:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'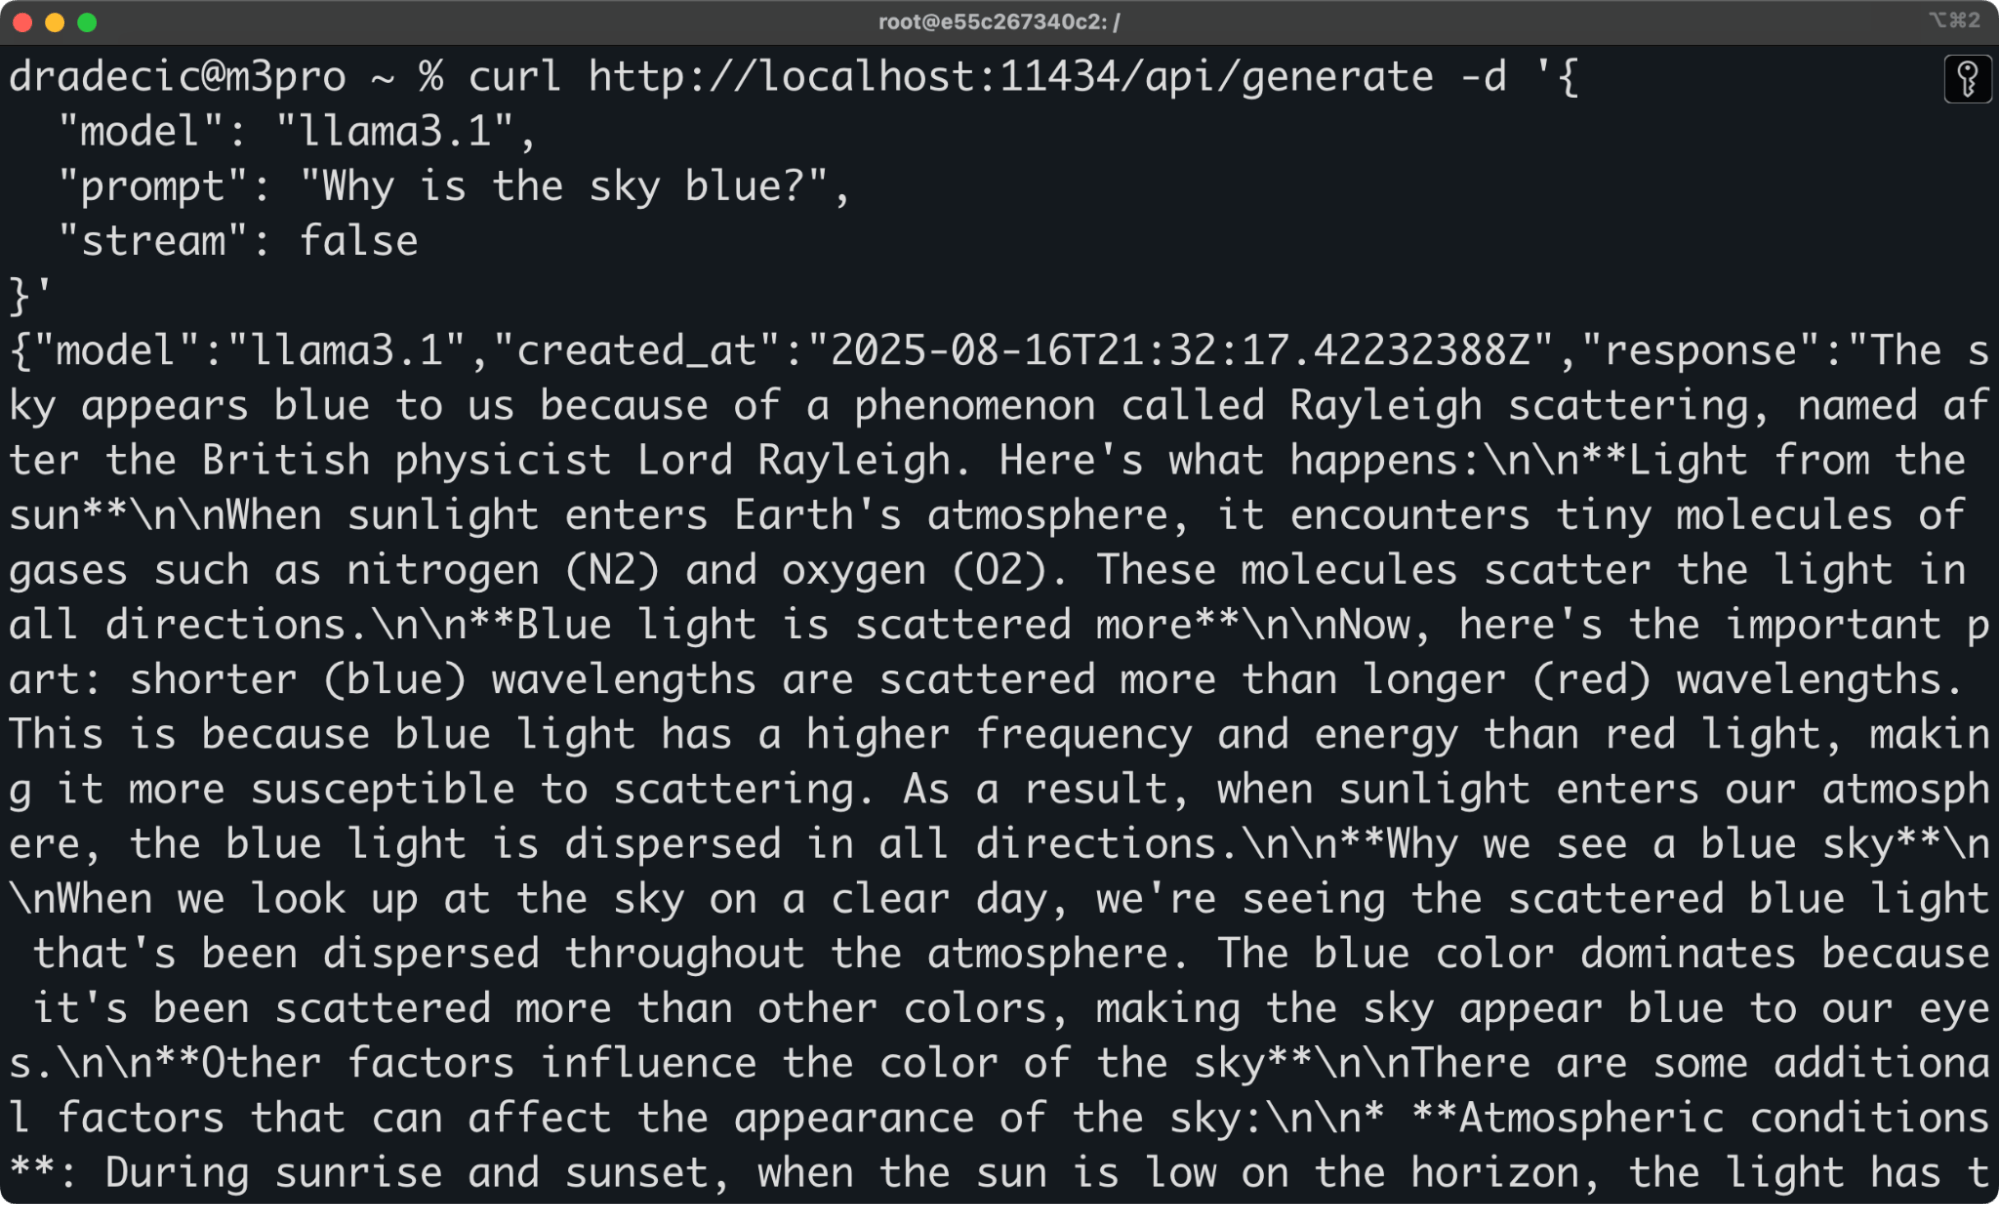
Mengakses ollama dengan curl
API mengembalikan respons JSON dengan teks yang dihasilkan. Atur "stream": false untuk mendapatkan respons lengkap sekaligus, atau "stream": true untuk menerima token saat dihasilkan.
Integrasi Python sama sederhananya:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])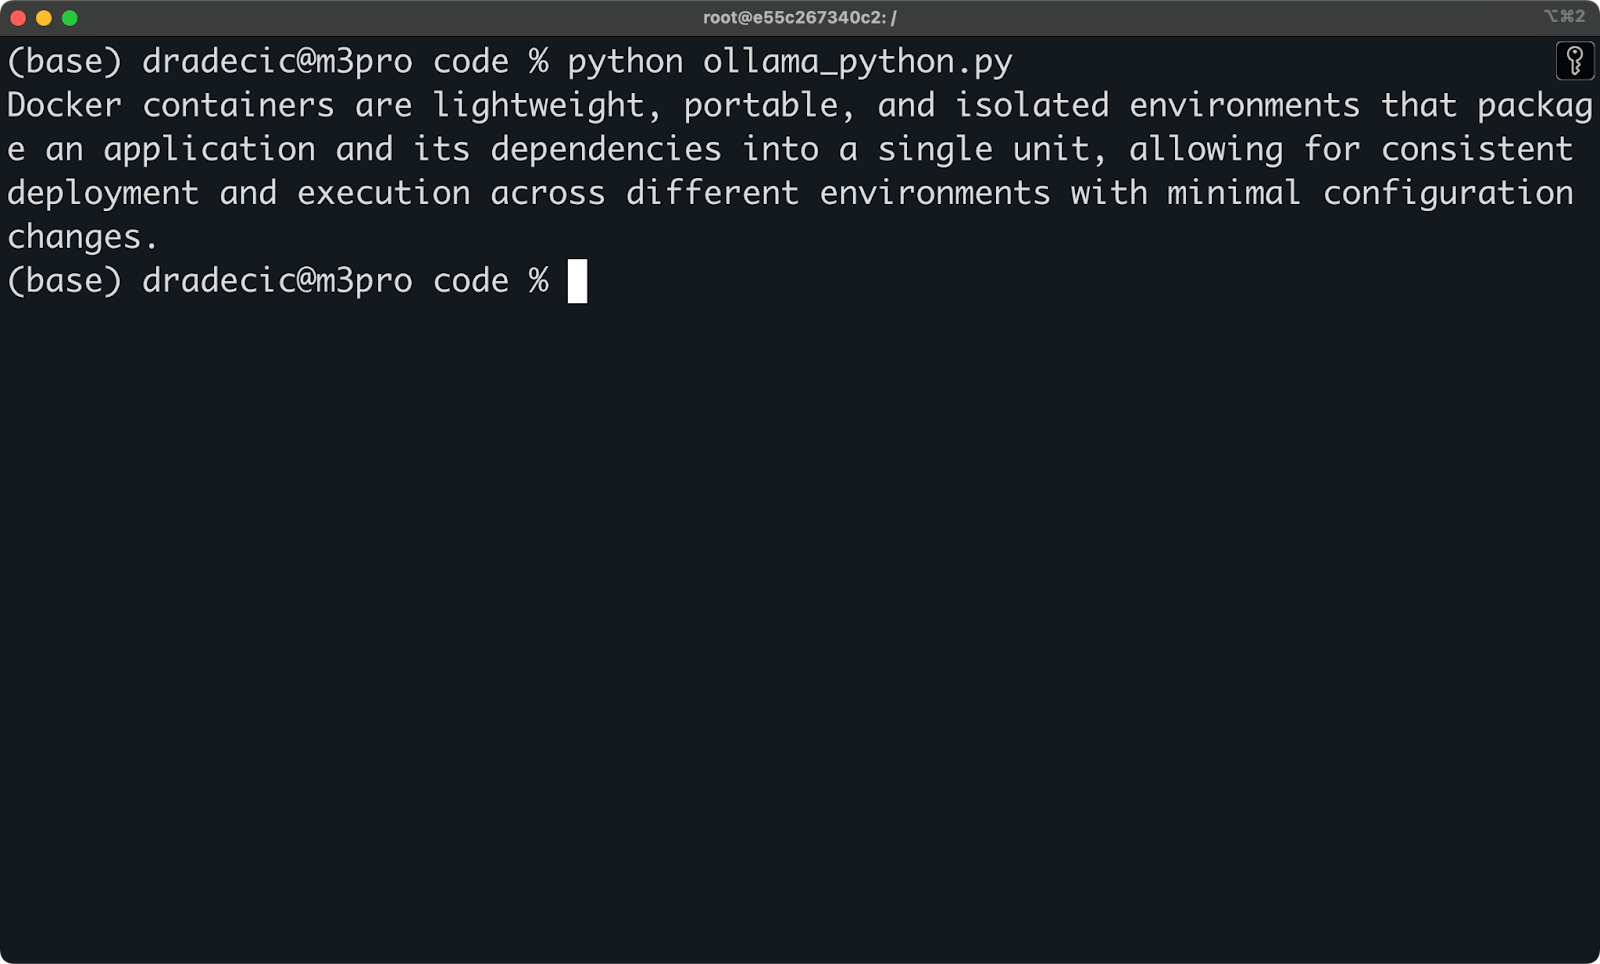
Mengakses ollama dengan Python
Ini membuat Ollama sempurna sebagai backend untuk aplikasi lokal. Anda dapat membangun antarmuka chat, alat pelengkapan kode, atau sistem analisis dokumen yang berkomunikasi dengan LLM dalam container tanpa mengirim data ke layanan eksternal.
Untuk alur kerja yang lebih kompleks, integrasi LangChain berfungsi langsung:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)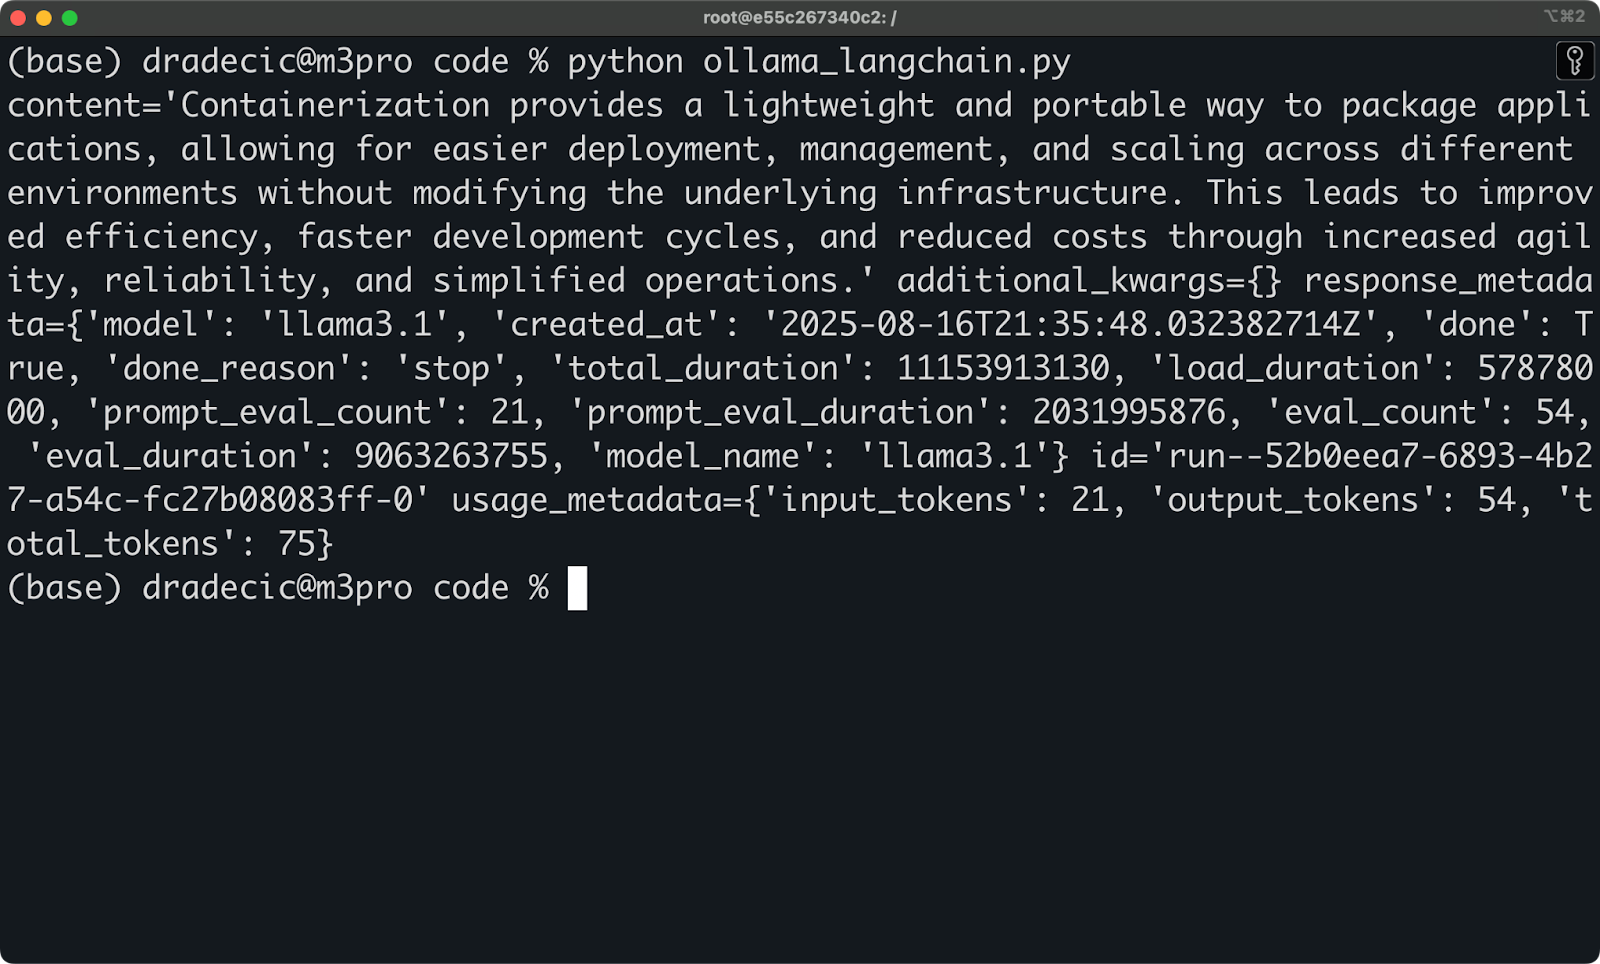
Mengakses ollama dengan LangChain
Anda mendapatkan seluruh kekuatan LLM lokal dengan kesederhanaan permintaan HTTP.
Pernah bertanya-tanya bagaimana aplikasi LLM diterapkan? Baca panduan langkah demi langkah kami tentang penerapan aplikasi LLM menggunakan Docker.
LLM lokal membutuhkan perangkat keras yang mumpuni untuk berjalan dengan baik, dan Docker menambah overheadnya sendiri.
CPU vs GPU membuat perbedaan besar. Ollama dapat berjalan pada sistem hanya-CPU, tetapi inferensi akan lambat, harapkan 30+ detik untuk respons sederhana. Dengan GPU modern, kueri yang sama selesai dalam kurang dari 5 detik. GPU NVIDIA bekerja paling baik, tetapi Apple Silicon Mac juga berkinerja baik, dan bisa menjadi opsi dengan nilai uang lebih baik.
Kebutuhan RAM meningkat seiring ukuran model. Model kecil seperti Llama3.1 8B membutuhkan setidaknya 8GB RAM sistem, sedangkan versi 70B yang lebih besar memerlukan 64GB atau lebih. Model tetap termuat di memori selama digunakan, sehingga Anda tidak bisa menjalankan model 13B pada mesin dengan RAM 8GB.
Ruang disk cepat bertambah. Setiap pengunduhan model memakan gigabita ruang disk:
Banyaknya versi model dan quantization akan dengan cepat melipatgandakan kebutuhan storage. Anda dapat memindahkan model ke drive eksternal jika penyimpanan menjadi masalah.
Overhead container minimal untuk komputasi namun berpengaruh pada storage. Image dasar Ollama kurang dari 1GB, tetapi model dipertahankan dalam volume Docker. Jika Anda membangun image khusus dengan model pra-muat, harapkan setiap image berukuran beberapa gigabita lebih besar dari basisnya.
Namun, alokasi memori di Docker kemungkinan perlu diperhatikan. Secara default, Docker Desktop membatasi memori container. Untuk model yang lebih besar, Anda harus meningkatkan batas ini atau menggunakan flag --memory saat menjalankan container.
Bottleneck perangkat keras biasanya adalah RAM, bukan CPU atau kecepatan disk.
Docker + Ollama memberi Anda kapabilitas AI yang menjaga data tetap privat dan biaya inferensi LLM tepat $0 (tidak termasuk listrik dan biaya pemeliharaan).
Asisten AI lokal adalah tempat kombinasi ini bersinar. Anda dapat membuat alat pelengkapan kode, generator dokumentasi, atau asisten penulisan yang sepenuhnya berjalan di mesin Anda. Tanpa biaya API, tanpa batasan kuota, tanpa data keluar dari jaringan Anda. Cukup arahkan editor atau IDE Anda ke localhost:11434 dan mulai membangun.
Pipeline RAG privat juga menjadi jauh lebih mudah diterapkan.
Anda dapat memuat dokumen perusahaan ke dalam basis data vektor, lalu menggunakan Ollama untuk menjawab pertanyaan tentangnya. Seluruh basis pengetahuan tetap internal, yang penting untuk informasi legal, finansial, atau kepemilikan yang tidak boleh menyentuh API eksternal.
Pengembangan chatbot offline memungkinkan Anda membuat prototipe dan menguji AI percakapan tanpa ketergantungan internet. Ini sempurna untuk penerapan edge, lingkungan air-gapped, atau situasi dengan konektivitas tidak andal. Bot Anda bekerja sama baiknya apakah Anda online atau sedang terbang di ketinggian 30.000 kaki.
Eksperimen model sebelum penerapan cloud menghemat uang dan waktu. Anda dapat menguji model, prompt, dan konfigurasi berbeda secara lokal sebelum berkomitmen pada inferensi cloud yang mahal. Anda dapat melakukan benchmarking performa, menyetel parameter, dan memvalidasi output tanpa menghabiskan kredit API.
Tim juga menggunakan pengaturan Docker dan Ollama ini untuk:
Anda mendapatkan kapabilitas AI kelas enterprise tanpa tagihan kelas enterprise.
Ada beberapa hal yang bisa menjebak saat menjalankan Ollama di Docker.
Dukungan GPU memerlukan penyiapan tambahan. Image Docker Ollama resmi mendukung GPU NVIDIA, tetapi Anda perlu menginstal NVIDIA Container Toolkit terlebih dahulu dan meneruskan flag --gpus all saat menjalankan container:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaTanpa ini, Ollama akan kembali ke mode hanya-CPU, yang berfungsi tetapi jauh lebih lambat. Jika Anda menggunakan Apple Silicon MacBook, ini tidak menjadi perhatian.
Masalah izin file dapat menyebabkan sakit kepala dengan volume Docker. Jika Anda me-mount direktori host alih-alih menggunakan volume bernama, Ollama mungkin tidak dapat menulis file model karena ketidakcocokan izin. Volume bernama seperti -v ollama:/root/.ollama sepenuhnya menghindari masalah ini.
Caching model antar restart berfungsi otomatis dengan pemasangan volume yang benar. Model yang Anda unduh dipertahankan di volume Docker, sehingga menghentikan dan memulai container tidak akan memerlukan pengunduhan ulang semuanya. Namun jika Anda tidak sengaja menghapus volume atau lupa flag -v, Anda akan kehilangan semua model.
Ingat solusi cepat berikut:
Masalah paling umum adalah lupa me-mount volume dan bingung kenapa model menghilang.
Docker membuat menjalankan LLM lokal menjadi sederhana, portabel, dan bersih.
Anda mendapatkan privasi secara desain, data Anda tidak pernah meninggalkan mesin Anda. Anda mendapatkan biaya yang terprediksi, tanpa tagihan API tak terduga atau pembatasan kuota. Dan Anda mendapatkan kendali penuh atas tumpukan AI Anda tanpa keterikatan vendor atau ketergantungan internet.
Penyiapannya hanya beberapa menit.
Tarik image, jalankan container, unduh model, dan Anda siap membangun. Tidak masalah apakah Anda memprototipe asisten AI, menjalankan pipeline RAG privat, atau sekadar bereksperimen dengan berbagai model, kombinasi ini memberi Anda kapabilitas kelas enterprise di laptop Anda.
Coba sekarang. Pilih model yang sesuai dengan perangkat keras Anda, jalankan container Ollama, dan mulai membangun sesuatu. Hambatan untuk memulai tidak ada.
Sebagai langkah berikutnya, kami merekomendasikan Anda menyiapkan dan menjalankan DeepSeek R1 secara lokal dengan Ollama.
Kursus Teratas DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt



