
Kurs
Orta Düzey Docker
4 sa
10.3K
Çoğu geliştirici yerel LLM’leri denemek istiyor ama nereden başlayacağını bilmiyor.
Llama ve Mistral gibi açık kaynak modellerin yükselişi, yerel yapay zekayı her zamankinden daha erişilebilir hale getirdi. OpenAI veya Anthropic’e tek kuruş harcamanıza gerek yok ve verilerinizi üçüncü taraflara göndermeyi dert etmezsiniz. Sorun şu ki çoğu kurulum rehberi, makineler arasında geçiş yaptığınızda kırılabilen Python ortamları, CUDA sürücüleri ve bağımlılıkların yönetilmesini içeriyor.
Ollama, yerel LLM’leri minimum kurulumla çalıştırmanın basit bir yolunu sunarak bunu çözüyor. Docker ile eşleştirdiğinizde, farklı sistemlerde aynı şekilde çalışan temiz ve taşınabilir bir çözüm elde edersiniz.
Bu rehberde, Docker’da Ollama’yı nasıl kuracağınızı, ilk modelinizi nasıl çekeceğinizi ve herhangi bir uygulamadan erişebileceğiniz yerel LLM’leri nasıl çalıştırmaya başlayacağınızı göstereceğim.
Docker’a tamamen yeniyseniz, temel kavramları anlamak için Introduction to Docker kursuna kaydolmanızı öneririz.
Ollama’yı, büyük dil modellerini kendi donanımınızda çalıştırmanın en basit yolu olarak düşünün.
Bu, yerel LLM’ler için tüm ağır işi üstlenen hafif bir çalışma zamanıdır. Python ortamlarını yönetmeniz, CUDA sürücülerini elle kurmanız ya da model ağırlıkları ve belirteçleyicileri çözmeniz gerekmez. Ollama, LLaMA, Mistral ve Gemma gibi modelleri tek bir komutla indirme, yükleme ve sunma işini üstlenir.
Gizlilik yerleşik olarak gelir. Konuşmalarınız asla makinenizden çıkmaz. API anahtarları yok, kullanım takibi yok, harici sunuculara gönderilen veri yok. Bu, tescilli kodu veya kişisel bilgileri üçüncü taraf hizmetlere ifşa etme riskini göze alamayacağınız hassas çalışmalar için onu ideal kılar.
Araç öncelikle geliştiriciler için tasarlandı. macOS ve Linux’ta yerel olarak çalışır, entegrasyon için basit bir REST API sunar ve artık Docker konteynerlerinin içinde de çalışır. Bu, geliştirme sırasında yerelde kullandığınız aynı kurulumu Docker’ın çalıştığı her yerde dağıtabileceğiniz anlamına gelir.
Tek komutla başlayan ve çevrimdışı çalışan, üretime hazır bir LLM sunucusu elde edersiniz.
Ollama tek LLM çalışma zamanı değil - n8n ve Qdrant’ı da deneyin.
Cevap basit — sisteminizi temiz tutarken Ollama’nın tüm faydalarını elde edersiniz.
Ollama’yı doğrudan makinenizde çalıştırmak gayet iyi çalışır — her şeyi sizin için halleden paketli bir yükleyiciyle (Windows için .exe, Mac için .dmg) gelir. Ancak Docker bir temel avantaj sunar: izolasyon.
Docker ile Ollama kendi konteynerinde çalışır. Bu da ana sisteminizi temiz tutar. Ana sisteminizde kurulum izi yok, test işiniz bittiğinde artakalan dosya yok ve sürüm değiştirmek veya tamamen temizlemek istediğinizde kolay kaldırma.
Aynı kurulum, yeniden üretilebilirlik sayesinde ekibinizdeki herkes için çalışır. Bir Docker komutu paylaşın; ister macOS, ister Linux, ister Windows kullansınlar, herkes tam olarak aynı Ollama ortamını çalıştırabilir.
Dağıtım, çoklu platform desteği ile basitleşir. Dizüstünüzde çalışan aynı konteyner, bulut sunucusunda, CI hattında veya bir çalışma arkadaşınızın makinesinde değişiklik gerektirmeden çalışır.
Basitleştirilmiş kurulum ve söküm ile Ollama’yı saniyeler içinde ayağa kaldırabilir ve aynı hızla tamamen kaldırabilirsiniz. Kaldırma betikleri yok, yapılandırma dosyalarını arayıp bulma yok, sistem temizliği yok.
Bu, Docker’ı şu durumlar için ideal kılar:
Kısacası, kurulum baş ağrılarını yaşamadan yerel LLM’lerin tüm faydalarını elde edersiniz.
Daha fazla pratik Docker kaynağı mı arıyorsunuz? Bu makine öğrenimi ve yapay zeka için 12 Docker konteyner imajı başlangıç için yeterli olacaktır.
Ollama’yı Docker’da çalıştırmanız tam olarak üç komut sürecek.
Önce, Docker Hub’dan resmi Ollama imajını çekin:
docker pull ollama/ollama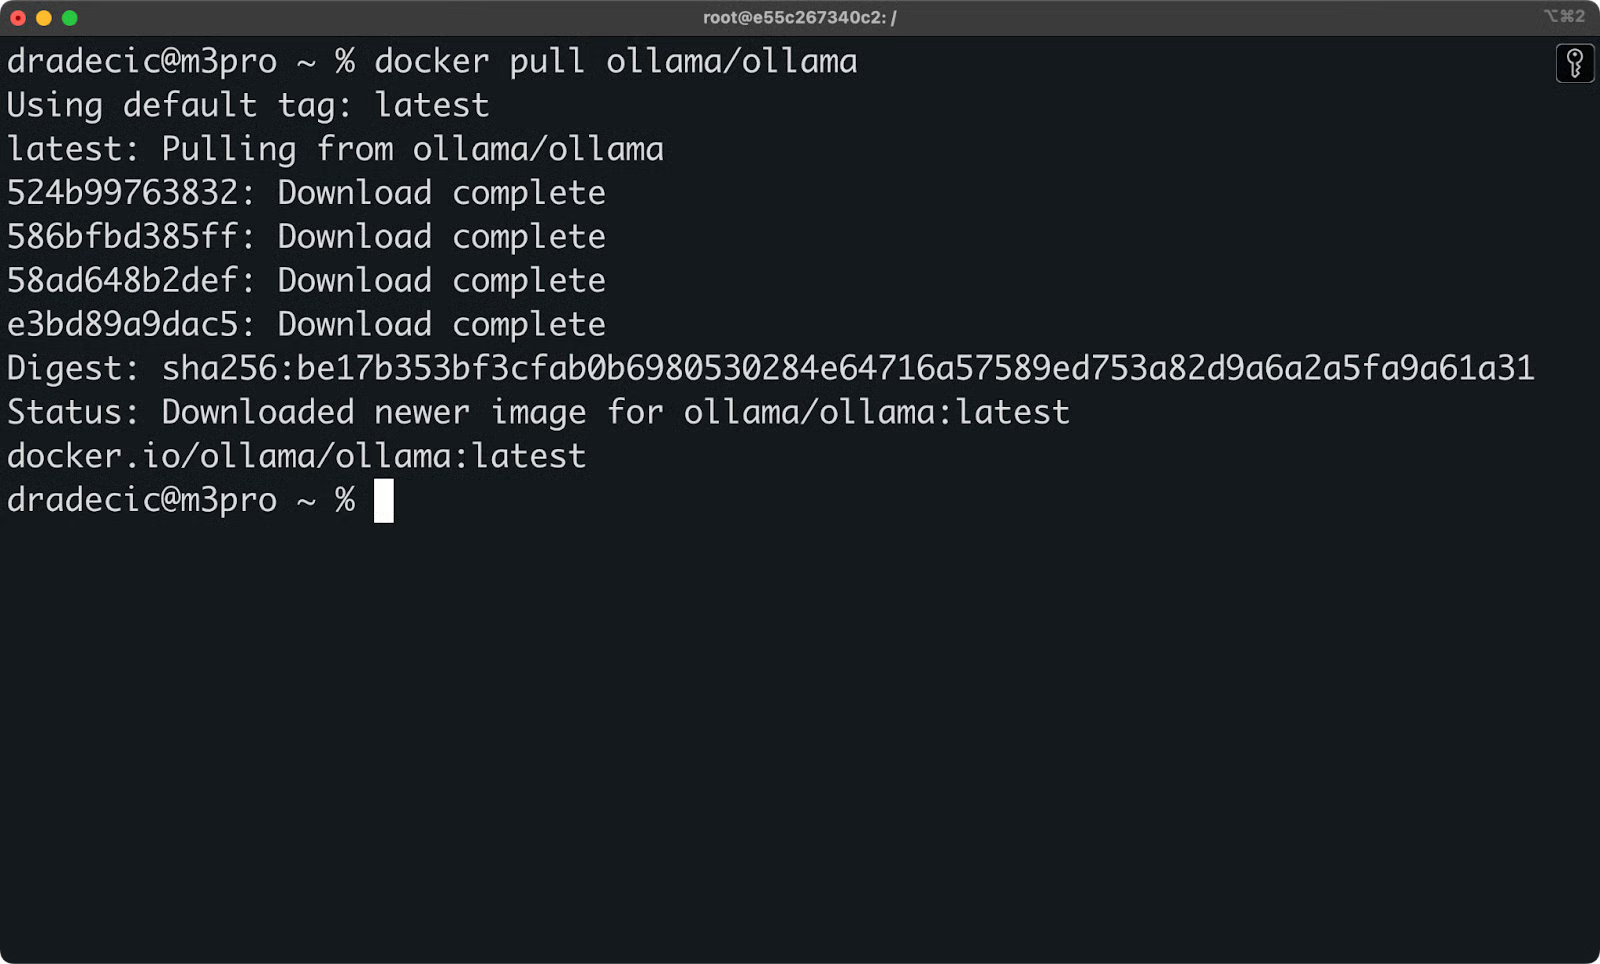
Ollama imajı çekiliyor
Ardından, doğru port ve birim eşlemeleriyle konteyneri çalıştırın:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama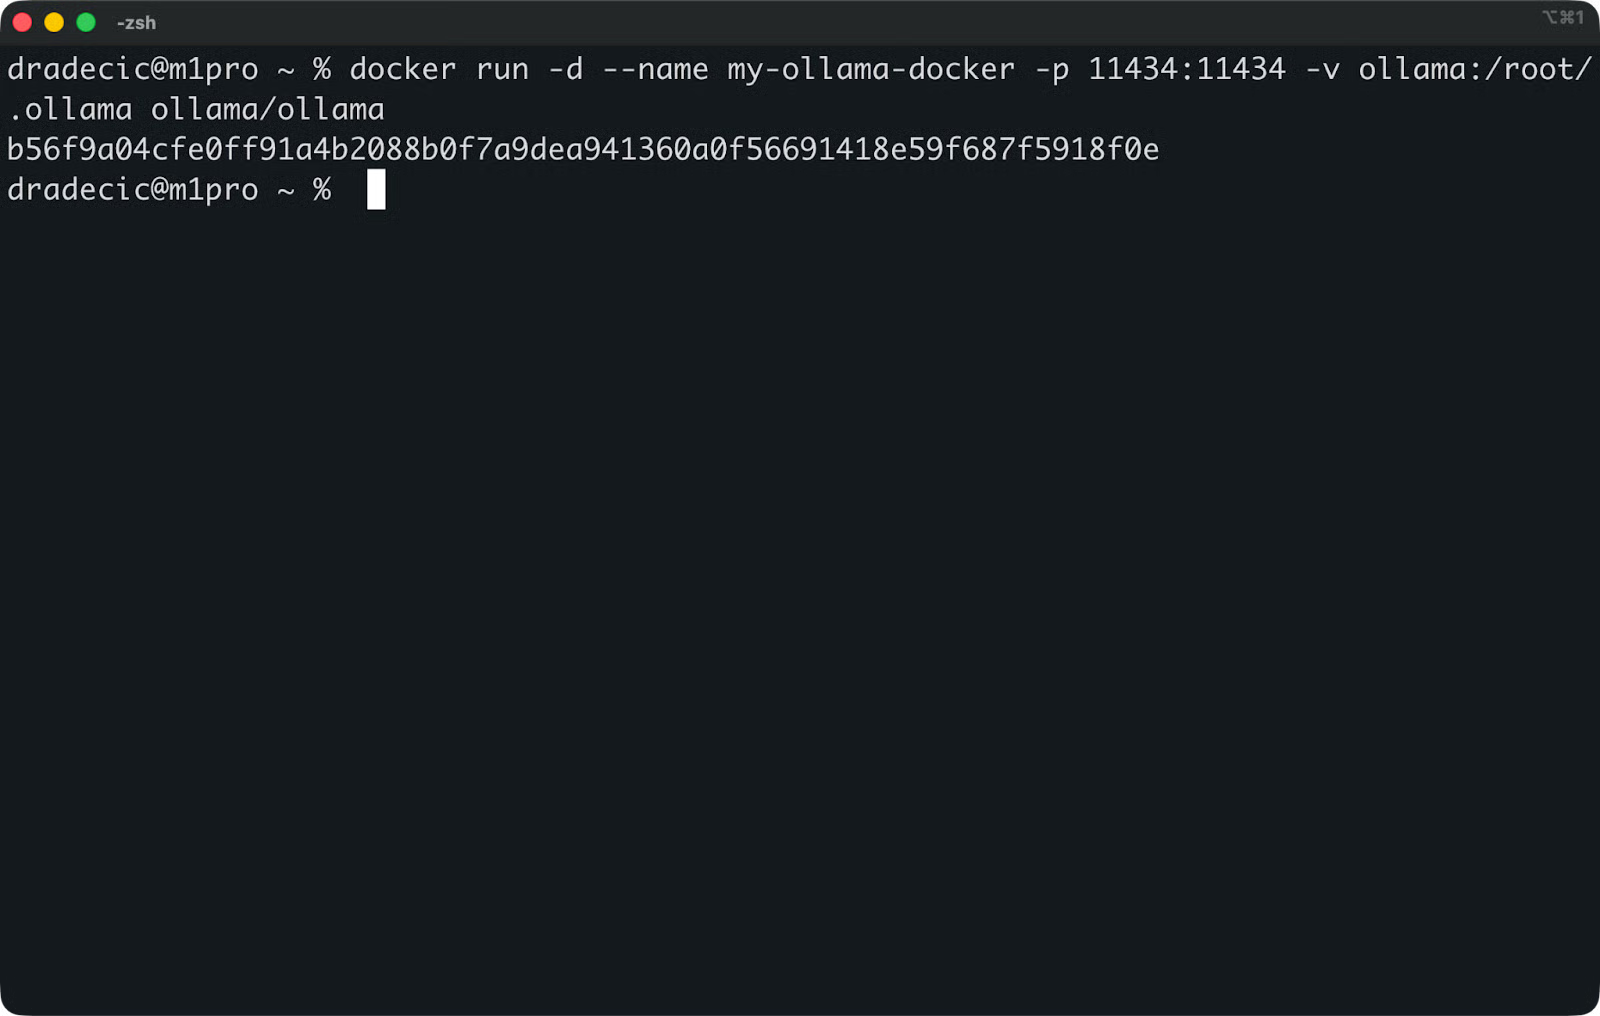
Ollama çalıştırılıyor
Her bayrak ne yapar, işte özet:
-d konteyneri arka planda çalıştırır--name my-ollama.docker konteynerinize anlaşılır bir isim verir-p 11434:11434 Ollama’nın varsayılan portunu ana makinenize eşler-v ollama:/root/.ollama indirilen modeller için kalıcı bir birim oluştururKonteyner anında başlar ve http://localhost:11434 adresinde dinlemeye geçer.
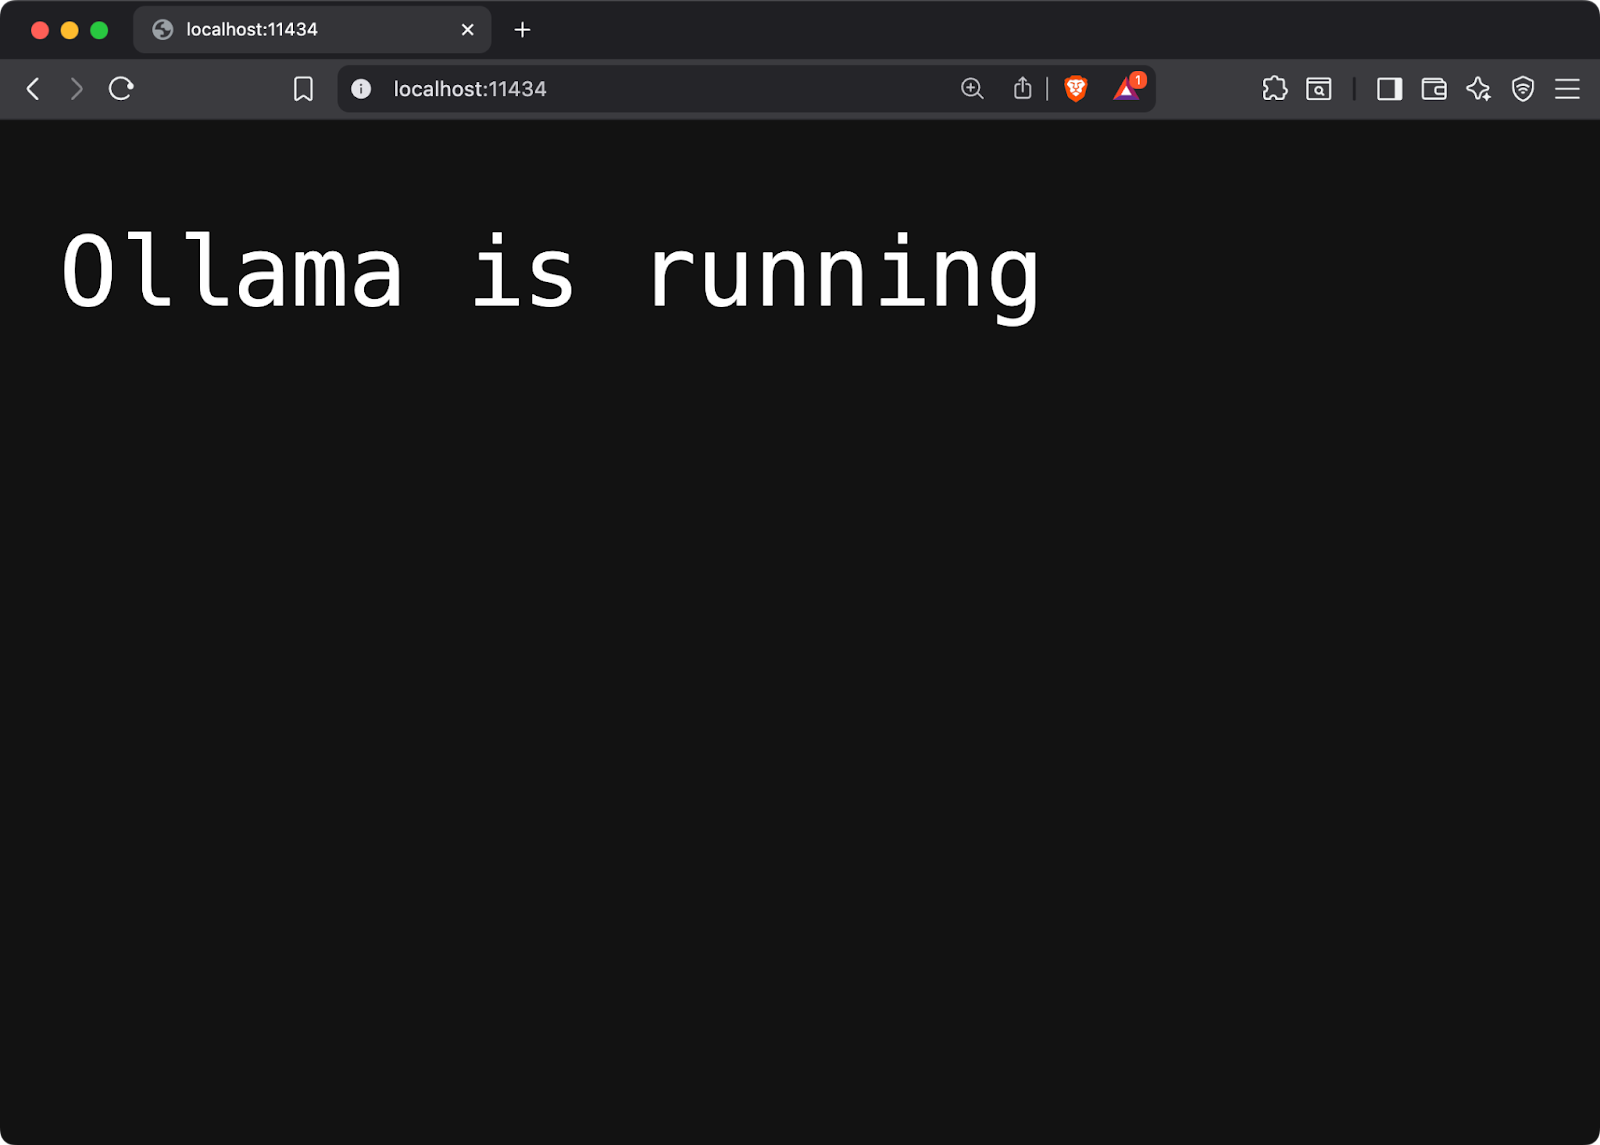
Ollama yerelde çalışıyor
Şimdi her şeyin çalıştığını test etmek için bir model indirin:
docker exec -it my-ollama-docker ollama pull llama3.1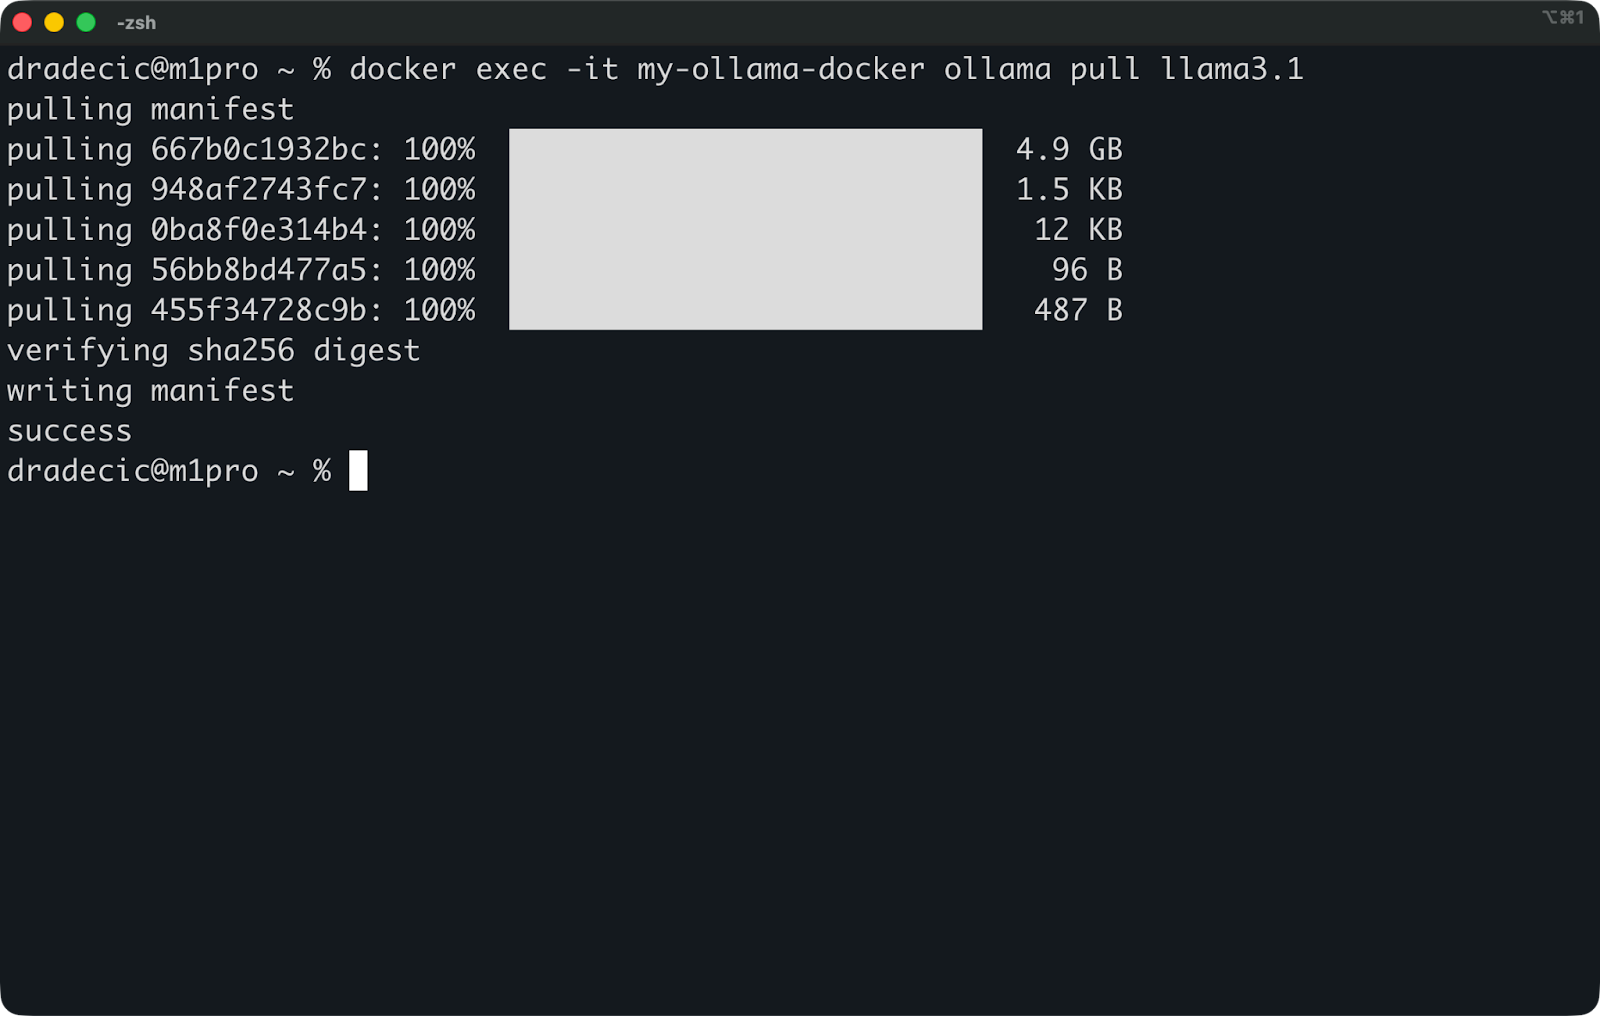
Llama3.1 modeli indiriliyor
Bu işlem, konteynerinizin içine Llama 3.1 8b modelini indirir. Model yaklaşık 5 GB boyutundadır; indirme birkaç dakika sürebilir.
Kurulumu, mevcut modelleri listeleyerek doğrulayabilirsiniz:
docker exec -it my-ollama-docker ollama list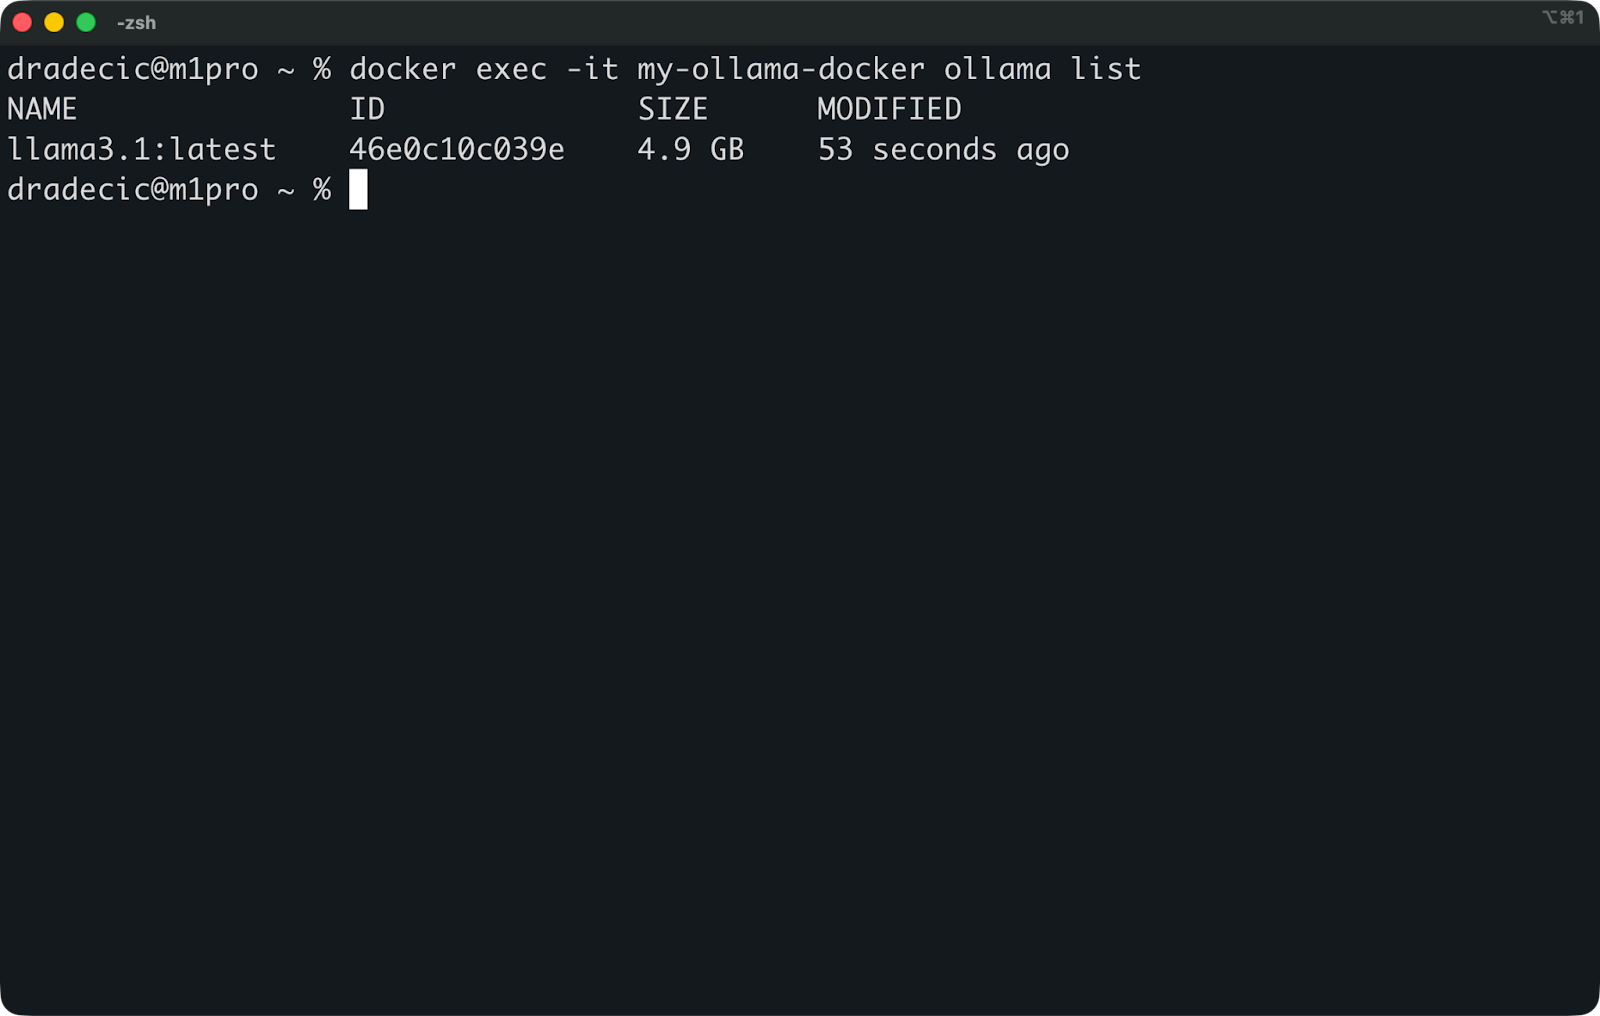
Mevcut modelleri listeleme
Birim eşleme önemlidir. Olmadan, konteyner durduğunda indirilen tüm modelleri kaybedersiniz. ollama:/root/.ollama birimi, modellerinizi konteyner yeniden başlatmaları ve güncellemeleri arasında kalıcı kılar.
Üretim kurulumları için önceden yüklü modellerle özel imajlar oluşturmak isteyebilirsiniz. Derleme sürecinde modelleri indiren bir Dockerfile oluşturun:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
Bu, modeli imajınıza gömer; böylece yeni konteynerler her şey hazır şekilde başlar.
Konteyneriniz çalıştığında, Ollama diğer tüm REST API’leri gibi davranır.
Hizmet http://localhost:11434 adresinde dinler ve standart HTTP isteklerini kabul eder. Özel istemcilere veya SDK’lara ihtiyacınız yok — JSON gönderin ve yanıtları alın.
Basit bir curl komutuyla metin nasıl üretilir, işte böyle:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'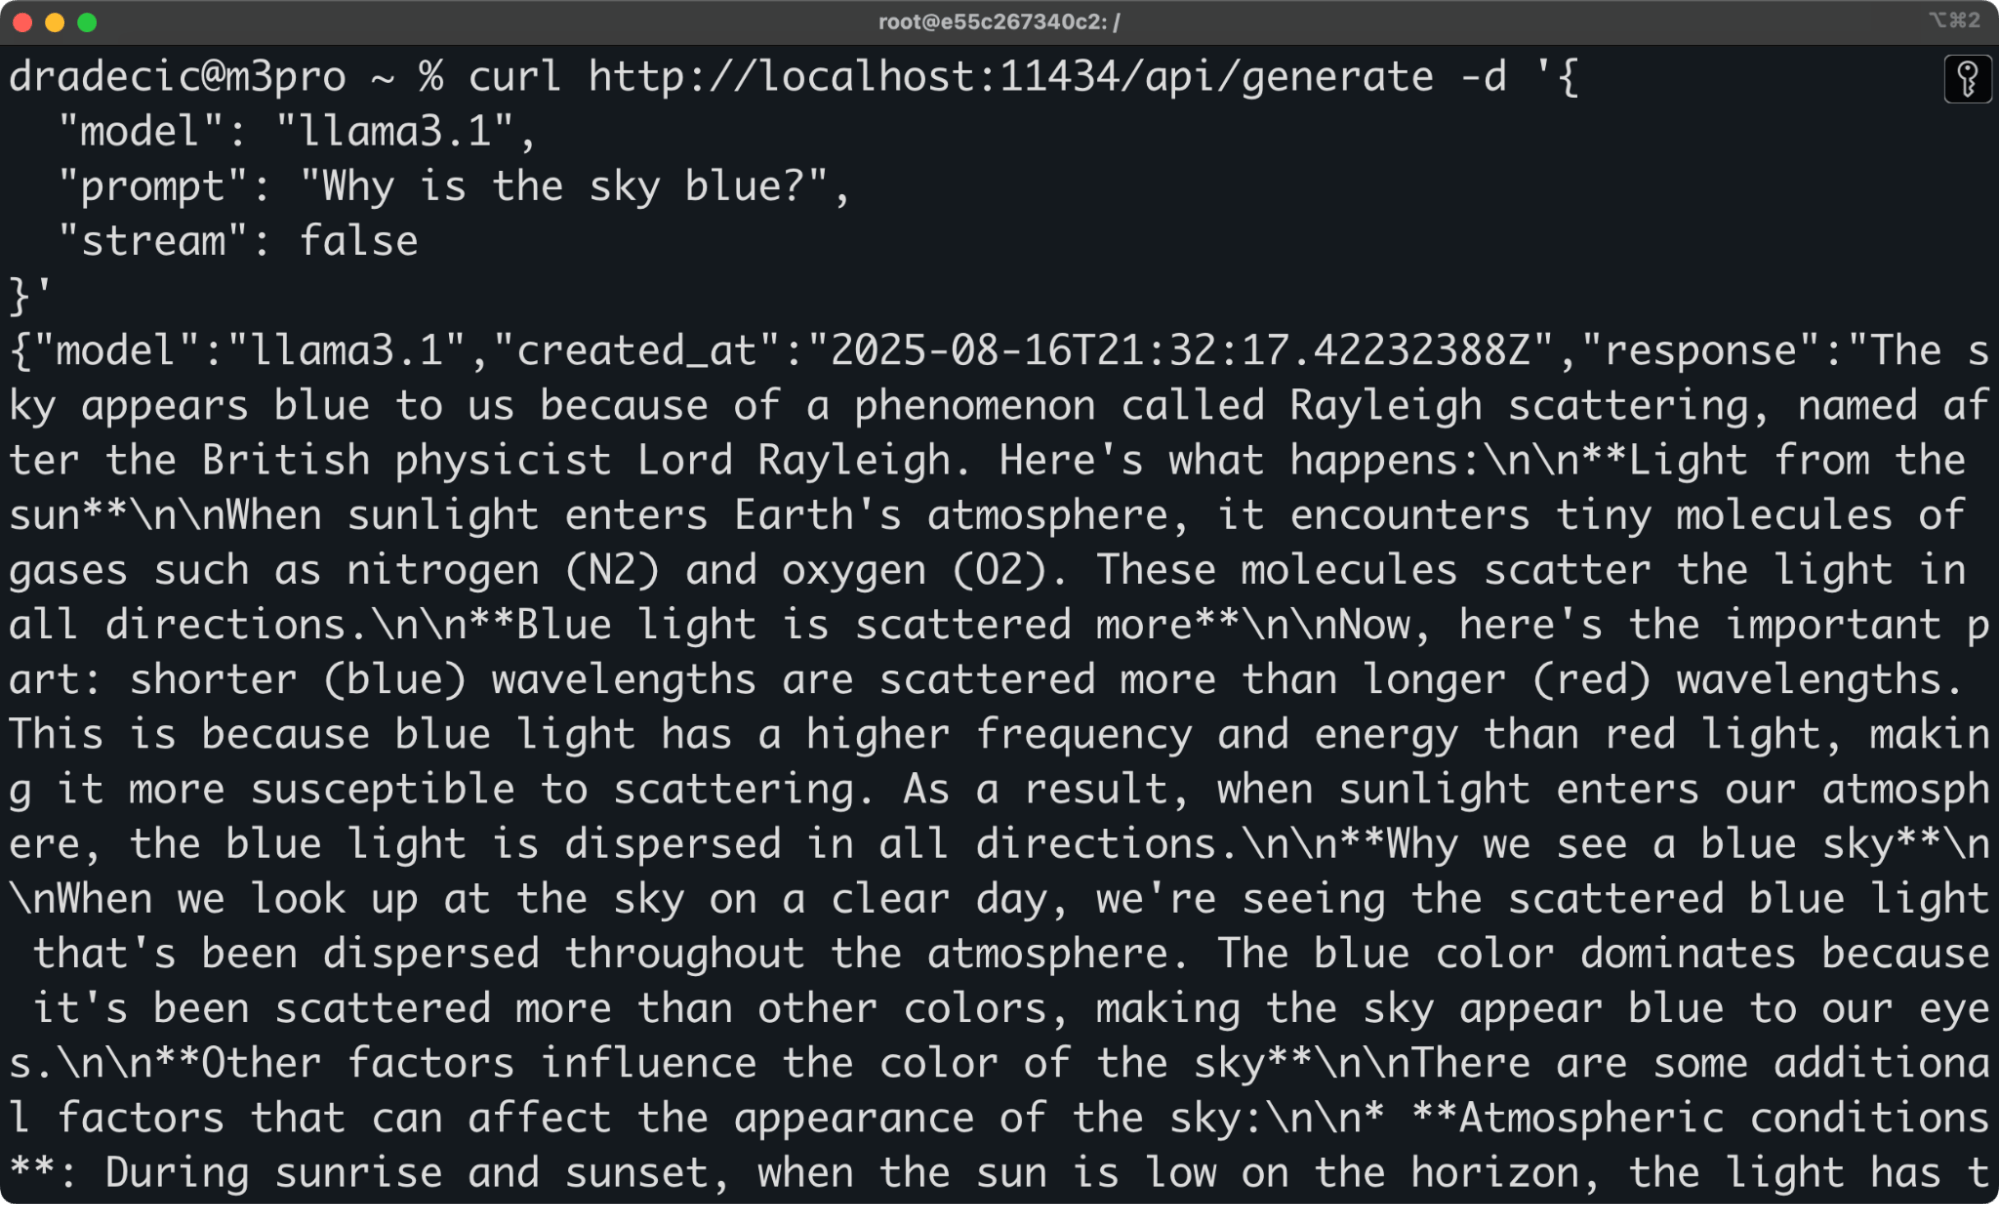
curl ile Ollama’ya erişim
API, üretilen metinle birlikte bir JSON yanıtı döndürür. Tam yanıtı bir kerede almak için "stream": false ayarlayın veya üretilen belirteçleri akış halinde almak için "stream": true kullanın.
Python entegrasyonu da aynı derecede basittir:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])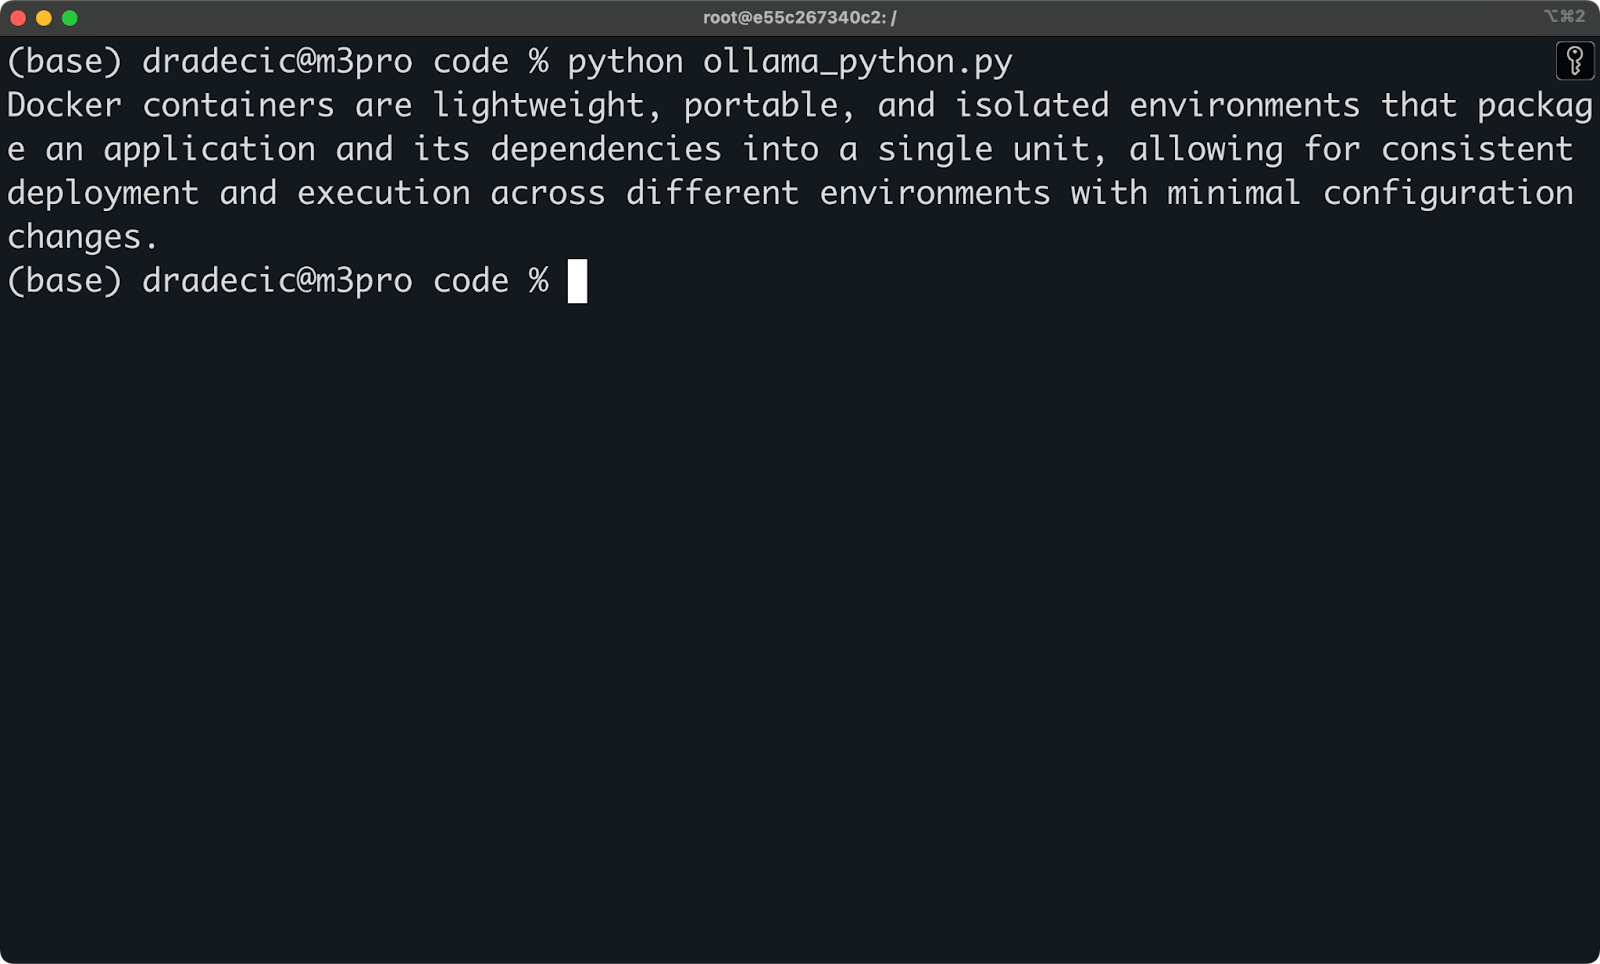
Python ile Ollama’ya erişim
Bu, Ollama’yı yerel uygulamalar için mükemmel bir arka uç yapar. Veri dış hizmetlere gönderilmeden konteynerize LLM’inizle konuşan sohbet arayüzleri, kod tamamlama araçları veya doküman analiz sistemleri oluşturabilirsiniz.
Daha karmaşık iş akışları için LangChain entegrasyonu kutudan çıkar çıkmaz çalışır:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)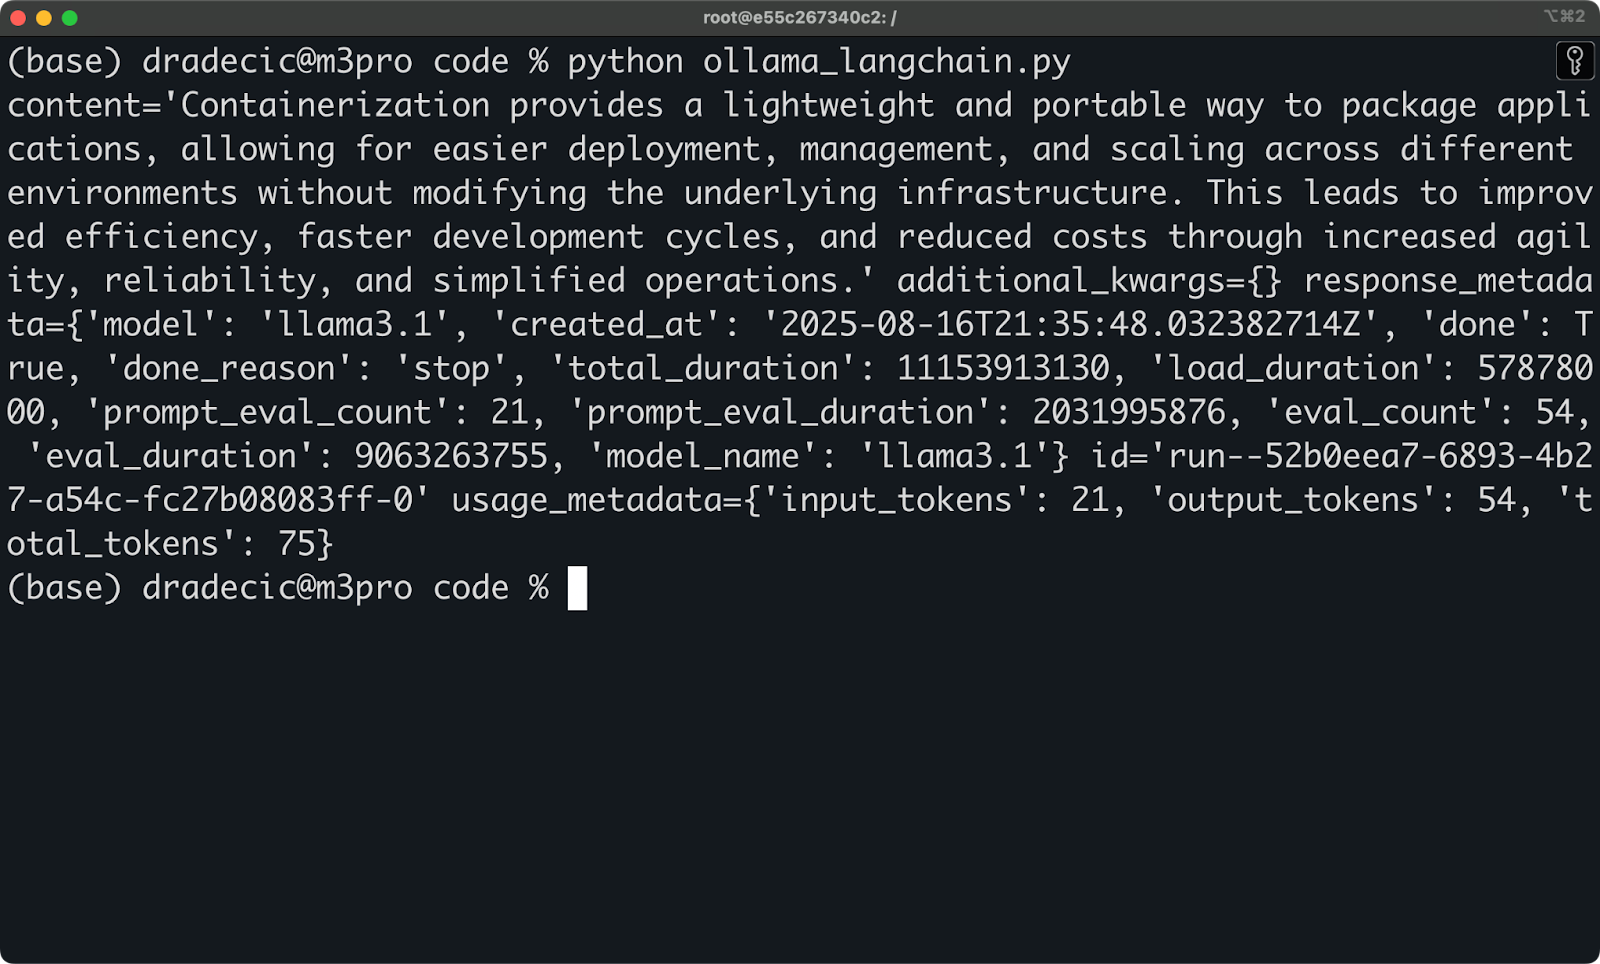
LangChain ile Ollama’ya erişim
HTTP isteklerinin basitliğiyle yerel LLM’lerin tüm gücünü elde edersiniz.
LLM uygulamaları nasıl dağıtılıyor diye merak ettiniz mi? Adım adım Docker kullanarak LLM uygulaması dağıtımı rehberimizi okuyun.
Yerel LLM’lerin iyi çalışması için ciddi donanım gerekir ve Docker kendi ek yükünü getirir.
CPU ve GPU arasındaki fark çok büyüktür. Ollama yalnızca CPU ile çalışan sistemlerde çalışabilir, ancak çıkarım yavaş olacaktır; basit yanıtlar için 30+ saniye bekleyin. Modern bir GPU ile aynı sorgu 5 saniyenin altında tamamlanır. NVIDIA GPU’lar en iyi sonucu verir, ancak Apple Silicon Mac’ler de iyi performans gösterir ve fiyat/performans açısından daha iyi bir seçenek olabilir.
RAM gereksinimleri model boyutuyla ölçeklenir. Llama3.1 8B gibi küçük modeller için en az 8 GB sistem RAM gerekir; daha büyük, 70B sürümler için 64 GB veya daha fazlası gerekir. Model kullanım sırasında bellekte yüklü kalır, bu nedenle 8 GB RAM’e sahip bir makinede 13B modeli çalıştıramazsınız.
Disk alanı hızla dolar. Her model indirmesi gigabaytlarca disk alanı gerektirir:
Birden fazla model sürümü ve kuantizasyon, depolama ihtiyaçlarını hızla katlar. Depolama bir sorun ise modelleri harici bir sürücüye taşıyabilirsiniz.
Konteyner ek yükü hesaplama için minimumdur ancak depolama için önemlidir. Temel Ollama imajı 1 GB’ın altındadır, ancak modeller Docker birimlerinde kalıcıdır. Önceden yüklü modellerle özel imajlar oluşturuyorsanız, her imajın temele kıyasla birkaç gigabayt daha büyük olmasını bekleyin.
Bununla birlikte, Docker’da bellek tahsisine muhtemelen dikkat etmek gerekir. Varsayılan olarak Docker Desktop, konteyner belleğini sınırlar. Daha büyük modeller için bu sınırları artırmanız veya konteynerleri çalıştırırken --memory bayrağını kullanmanız gerekir.
Darboğaz genellikle CPU veya disk hızı değil, RAM’dir.
Docker + Ollama, verilerinizi gizli tutarken LLM çıkarım maliyetinizi (elektrik ve bakım maliyetleri hariç) tam olarak 0 $’a indirir.
Yerel yapay zeka asistanları bu kurulumun parladığı yerdir. Tamamen makinenizde çalışan kod tamamlama araçları, dokümantasyon üreticileri veya yazma asistanları oluşturabilirsiniz. API maliyeti yok, hız sınırı yok, ağınızdan çıkan veri yok. Düzenleyicinizi veya IDE’nizi localhost:11434’e işaret edin ve geliştirmeye başlayın.
Özel RAG hatlarının dağıtımı da çok daha kolay hale gelir.
Şirket dokümanlarınızı bir vektör veritabanına yükleyebilir, ardından Ollama’yı bunlar hakkında soruları yanıtlamak için kullanabilirsiniz. Tüm bilgi tabanı dahili kalır; bu da harici API’lere dokunmaması gereken hukuki, finansal veya tescilli bilgiler için önemlidir.
Çevrimdışı sohbet botu geliştirme, internet bağımlılığı olmadan sohbet amaçlı yapay zekayı prototiplemenize ve test etmenize olanak tanır. Bu, uç dağıtımlar, hava boşluklu ortamlar veya bağlantının güvenilmez olduğu durumlar için idealdir. Botunuz, çevrimiçi olun ya da 30.000 fit irtifada uçuyor olun, aynı şekilde çalışır.
Buluta dağıtmadan önce model deneyleri para ve zaman kazandırır. Farklı modelleri, istemleri ve yapılandırmaları pahalı bulut çıkarımına bağlanmadan yerelde test edebilirsiniz. Performansı kıyaslayabilir, parametreleri ayarlayabilir ve API kredilerini tüketmeden çıktıları doğrulayabilirsiniz.
Ekipler ayrıca bu Docker ve Ollama kurulumunu şu amaçlarla kullanıyor:
Kurumsal düzeyde yapay zeka yeteneklerini, kurumsal düzey faturalar olmadan elde edersiniz.
Docker’da Ollama çalıştırırken sizi tökezletebilecek birkaç nokta var.
GPU desteği ek kurulum gerektirir. Resmi Ollama Docker imajı NVIDIA GPU’ları destekler, ancak önce NVIDIA Container Toolkit’i kurmanız ve konteynerinizi çalıştırırken --gpus all bayrağını geçirmeniz gerekir:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaBunu yapmazsanız, Ollama yalnızca CPU moduna geri döner; çalışır ama çok daha yavaş olur. Apple Silicon MacBook kullanıyorsanız bu konu sizi ilgilendirmez.
Dosya izinleri sorunları Docker birimleriyle baş ağrısına yol açabilir. Adlandırılmış bir birim yerine ana makineden bir dizin bağlarsanız, izin uyuşmazlıkları nedeniyle Ollama model dosyalarını yazamayabilir. -v ollama:/root/.ollama gibi adlandırılmış birimler bu sorunu tamamen ortadan kaldırır.
Yeniden başlatmalar arasında model önbelleği uygun birim bağlama ile otomatik olarak çalışır. İndirilen modelleriniz Docker biriminde kalıcıdır; bu nedenle konteynerleri durdurup başlatmak her şeyi yeniden indirmenizi gerektirmez. Ancak yanlışlıkla birimi siler veya -v bayrağını unutursanız tüm modellerinizi kaybedersiniz.
Şu hızlı çözümleri aklınızda tutun:
En yaygın sorun, birim bağlamayı unutup modellerin neden kaybolduğunu merak etmektir.
Docker, yerel LLM’leri çalıştırmayı basit, taşınabilir ve temiz hale getirir.
Tasarımdan gelen gizlilik elde edersiniz; veriniz makinenizden asla çıkmaz. Öngörülebilir maliyetler elde edersiniz; sürpriz API faturaları veya hız sınırlaması yok. Ve tam kontrol elde edersiniz; satıcıya bağımlılık veya internet zorunluluğu olmadan yapay zeka yığınınız üzerinde tam yetki sizde olur.
Kurulum birkaç dakika sürer.
İmajı çekin, konteyneri çalıştırın, bir model indirin ve hazır olun. İster bir yapay zeka asistanı prototipliyor, ister özel RAG hatları çalıştırıyor, ister yalnızca farklı modellerle deney yapıyor olun, bu kombinasyon size dizüstünüzde kurumsal düzeyde yetenekler sunar.
Şimdi deneyin. Donanımınıza uyan bir model seçin, Ollama konteynerini ayağa kaldırın ve bir şeyler inşa etmeye başlayın. Giriş engeli yok.
Bir sonraki adım olarak, DeepSeek R1’i Ollama ile yerelde kurup çalıştırmanızı öneririz.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



