
Khóa học
Docker nâng cao
4 giờ
10.3K
Hầu hết các nhà phát triển đều muốn thử LLM cục bộ, nhưng không biết bắt đầu từ đâu.
Sự trỗi dậy của các mô hình mã nguồn mở như Llama và Mistral đã khiến AI cục bộ trở nên dễ tiếp cận hơn bao giờ hết. Bạn không cần tốn xu nào cho OpenAI hay Anthropic, cũng không phải lo lắng về việc gửi dữ liệu của mình cho bên thứ ba. Thách thức là hầu hết các hướng dẫn thiết lập đều liên quan đến việc quản lý môi trường Python, driver CUDA và các phụ thuộc vốn thường hỏng khi bạn chuyển giữa các máy.
Ollama giải quyết điều này bằng cách cung cấp một cách đơn giản để chạy LLM cục bộ với thiết lập tối thiểu. Khi kết hợp với Docker, bạn có một giải pháp sạch sẽ, di động và hoạt động giống nhau trên các hệ thống khác nhau.
Trong hướng dẫn này, tôi sẽ chỉ cho bạn cách thiết lập Ollama trong Docker, kéo mô hình đầu tiên và bắt đầu chạy các LLM cục bộ mà bạn có thể truy cập từ bất kỳ ứng dụng nào.
Nếu bạn hoàn toàn mới với Docker, chúng tôi khuyến nghị bạn đăng ký khóa học Giới thiệu về Docker để nắm bắt các kiến thức nền tảng.
Hãy coi Ollama là cách đơn giản nhất để chạy các mô hình ngôn ngữ lớn trên phần cứng của riêng bạn.
Đó là một runtime gọn nhẹ xử lý mọi phần nặng nhọc cho LLM cục bộ. Bạn không cần quản lý môi trường Python, cài đặt driver CUDA thủ công, hay mò mẫm trọng số mô hình và tokenizer. Ollama đảm nhiệm việc tải xuống, nạp và phục vụ các mô hình như LLaMA, Mistral và Gemma chỉ với một lệnh.
Tính riêng tư có sẵn ngay từ đầu. Cuộc trò chuyện của bạn không bao giờ rời khỏi máy. Không API key, không theo dõi sử dụng, không gửi dữ liệu tới máy chủ bên ngoài. Điều này khiến nó hoàn hảo cho công việc nhạy cảm, nơi bạn không thể mạo hiểm lộ mã độc quyền hay thông tin cá nhân cho dịch vụ bên thứ ba.
Công cụ được thiết kế trước hết cho nhà phát triển. Nó chạy native trên macOS và Linux, cung cấp REST API đơn giản để tích hợp, và giờ hoạt động bên trong container Docker. Điều này có nghĩa bạn có thể chạy cùng một thiết lập cục bộ trong giai đoạn phát triển và triển khai ở bất cứ đâu Docker chạy được.
Bạn có một máy chủ LLM sẵn sàng cho sản xuất, khởi động bằng một lệnh và hoạt động ngoại tuyến.
Ollama không phải runtime LLM duy nhất - hãy thử n8n và Qdrant.
Câu trả lời đơn giản - bạn nhận trọn lợi ích của Ollama trong khi vẫn giữ hệ thống sạch sẽ.
Chạy Ollama trực tiếp trên máy của bạn vẫn ổn - nó đi kèm bộ cài sẵn (.exe cho Windows, .dmg cho Mac) xử lý mọi thứ cho bạn. Nhưng Docker mang lại một lợi thế then chốt: cô lập.
Với Docker, Ollama chạy trong container riêng. Điều này giữ cho hệ điều hành host sạch. Không dấu vết cài đặt trên hệ thống chính, không file thừa sau khi bạn thử nghiệm xong, và dễ dàng gỡ bỏ khi muốn chuyển phiên bản hoặc dọn dẹp hoàn toàn.
Cùng một thiết lập hoạt động cho mọi người trong nhóm nhờ tính tái lập. Chia sẻ một lệnh Docker, và bất kỳ ai cũng có thể chạy chính xác cùng môi trường Ollama, bất kể họ dùng macOS, Linux hay Windows.
Triển khai trở nên đơn giản với hỗ trợ đa nền tảng. Cùng container chạy trên laptop của bạn sẽ hoạt động trên máy chủ đám mây, pipeline CI hoặc máy của đồng nghiệp mà không cần chỉnh sửa.
Bạn có thể khởi tạo Ollama trong vài giây và gỡ bỏ hoàn toàn nhanh không kém với quy trình thiết lập và dọn dẹp đơn giản. Không script gỡ cài đặt, không phải lục tìm file cấu hình, không cần dọn hệ thống.
Điều này khiến Docker hoàn hảo cho:
Tóm lại, bạn có mọi lợi ích của LLM cục bộ mà không gặp đau đầu khi thiết lập.
Tìm thêm tài nguyên Docker thực chiến? 12 image Docker cho machine learning và AI này sẽ giúp bạn bắt đầu.
Bạn chỉ cần đúng ba lệnh để chạy Ollama trong Docker.
Đầu tiên, kéo image Ollama chính thức từ Docker Hub:
docker pull ollama/ollama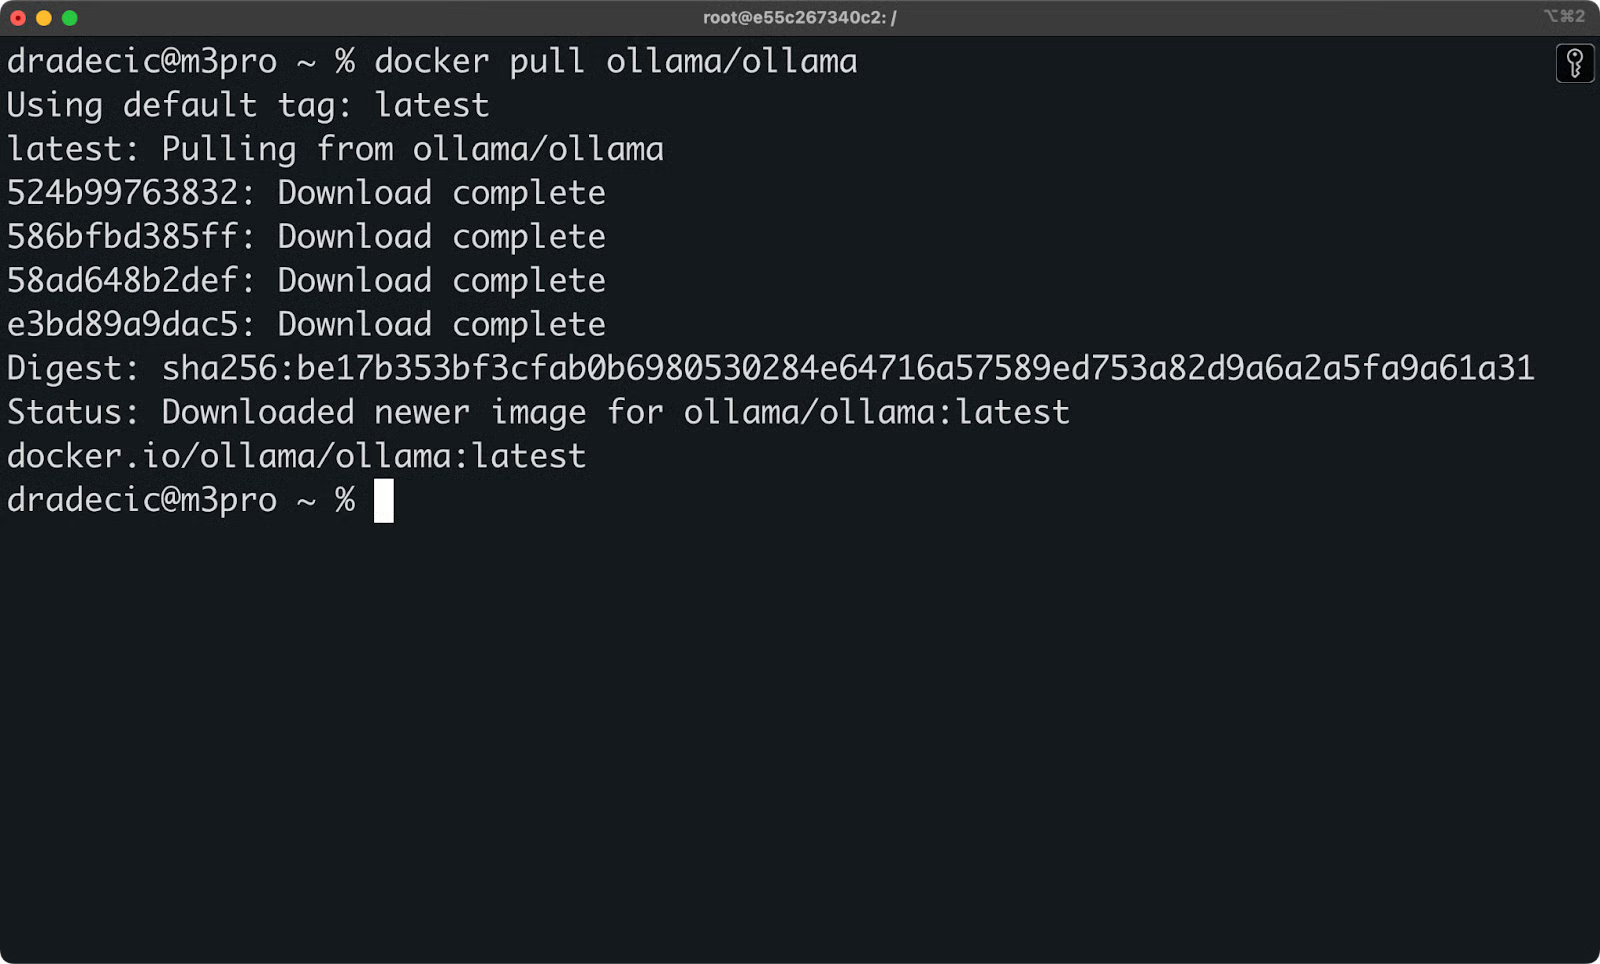
Kéo image ollama
Tiếp theo, chạy container với ánh xạ cổng và volume phù hợp:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama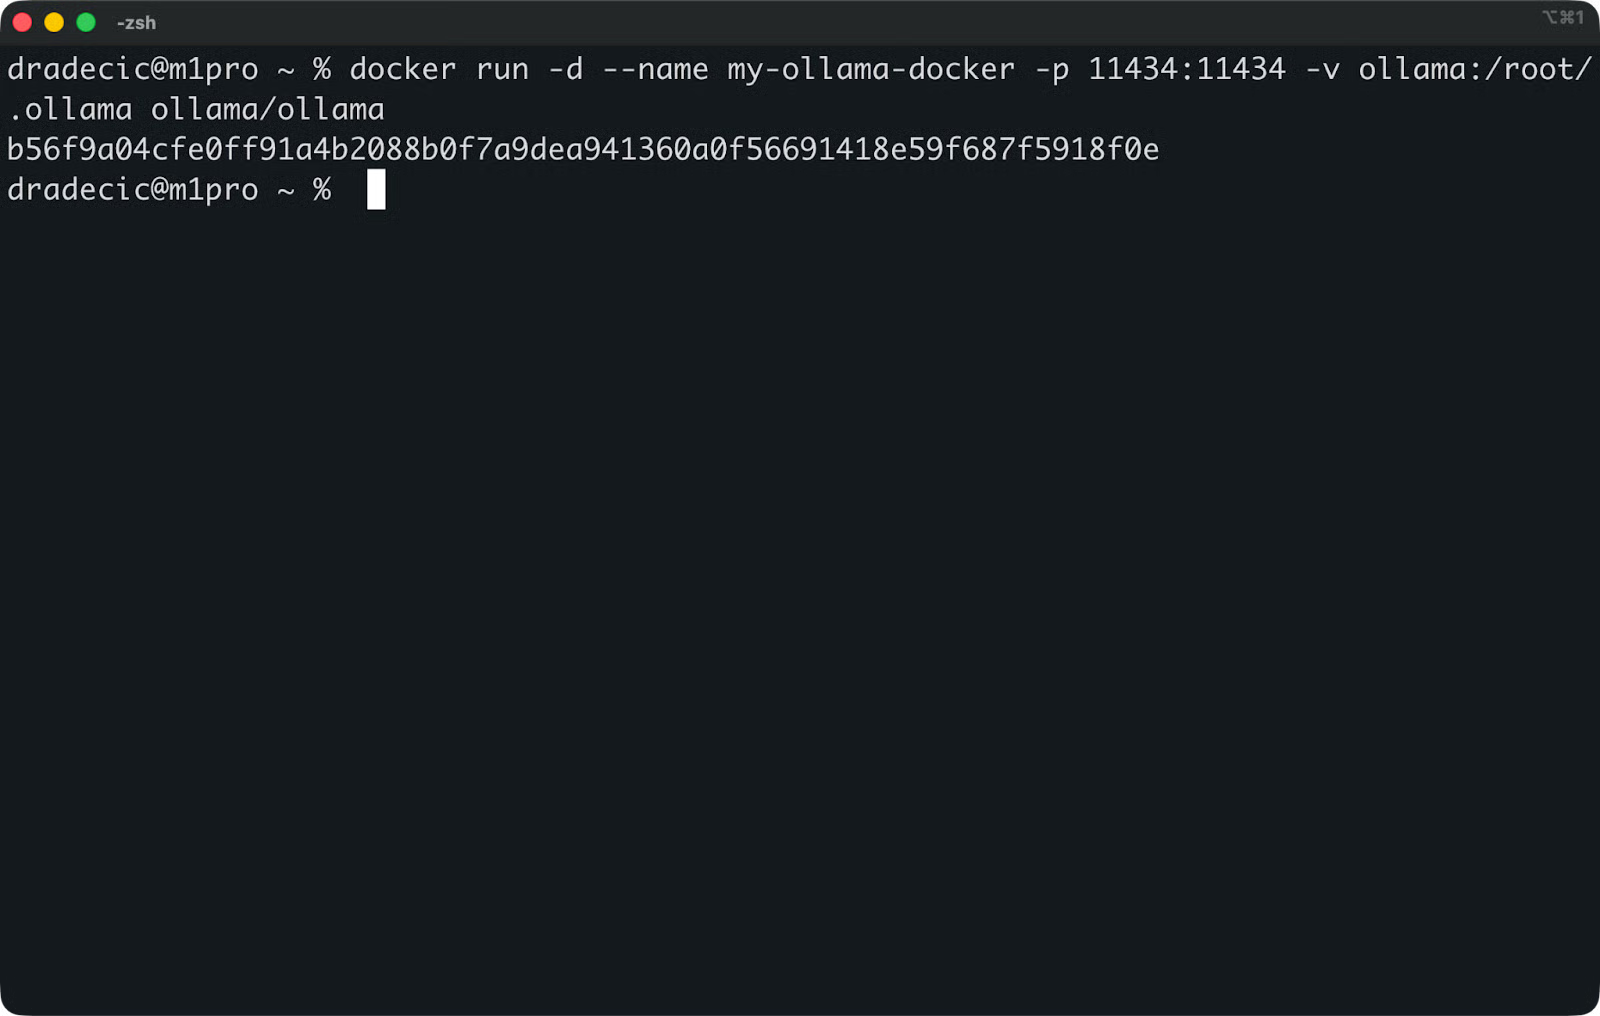
Chạy ollama
Ý nghĩa của từng cờ:
-d chạy container dưới nền--name my-ollama.docker đặt tên thân thiện cho container-p 11434:11434 ánh xạ cổng mặc định của Ollama tới máy host-v ollama:/root/.ollama tạo volume lưu trữ bền vững cho các mô hình đã tảiContainer khởi động ngay lập tức và bắt đầu lắng nghe tại http://localhost:11434.
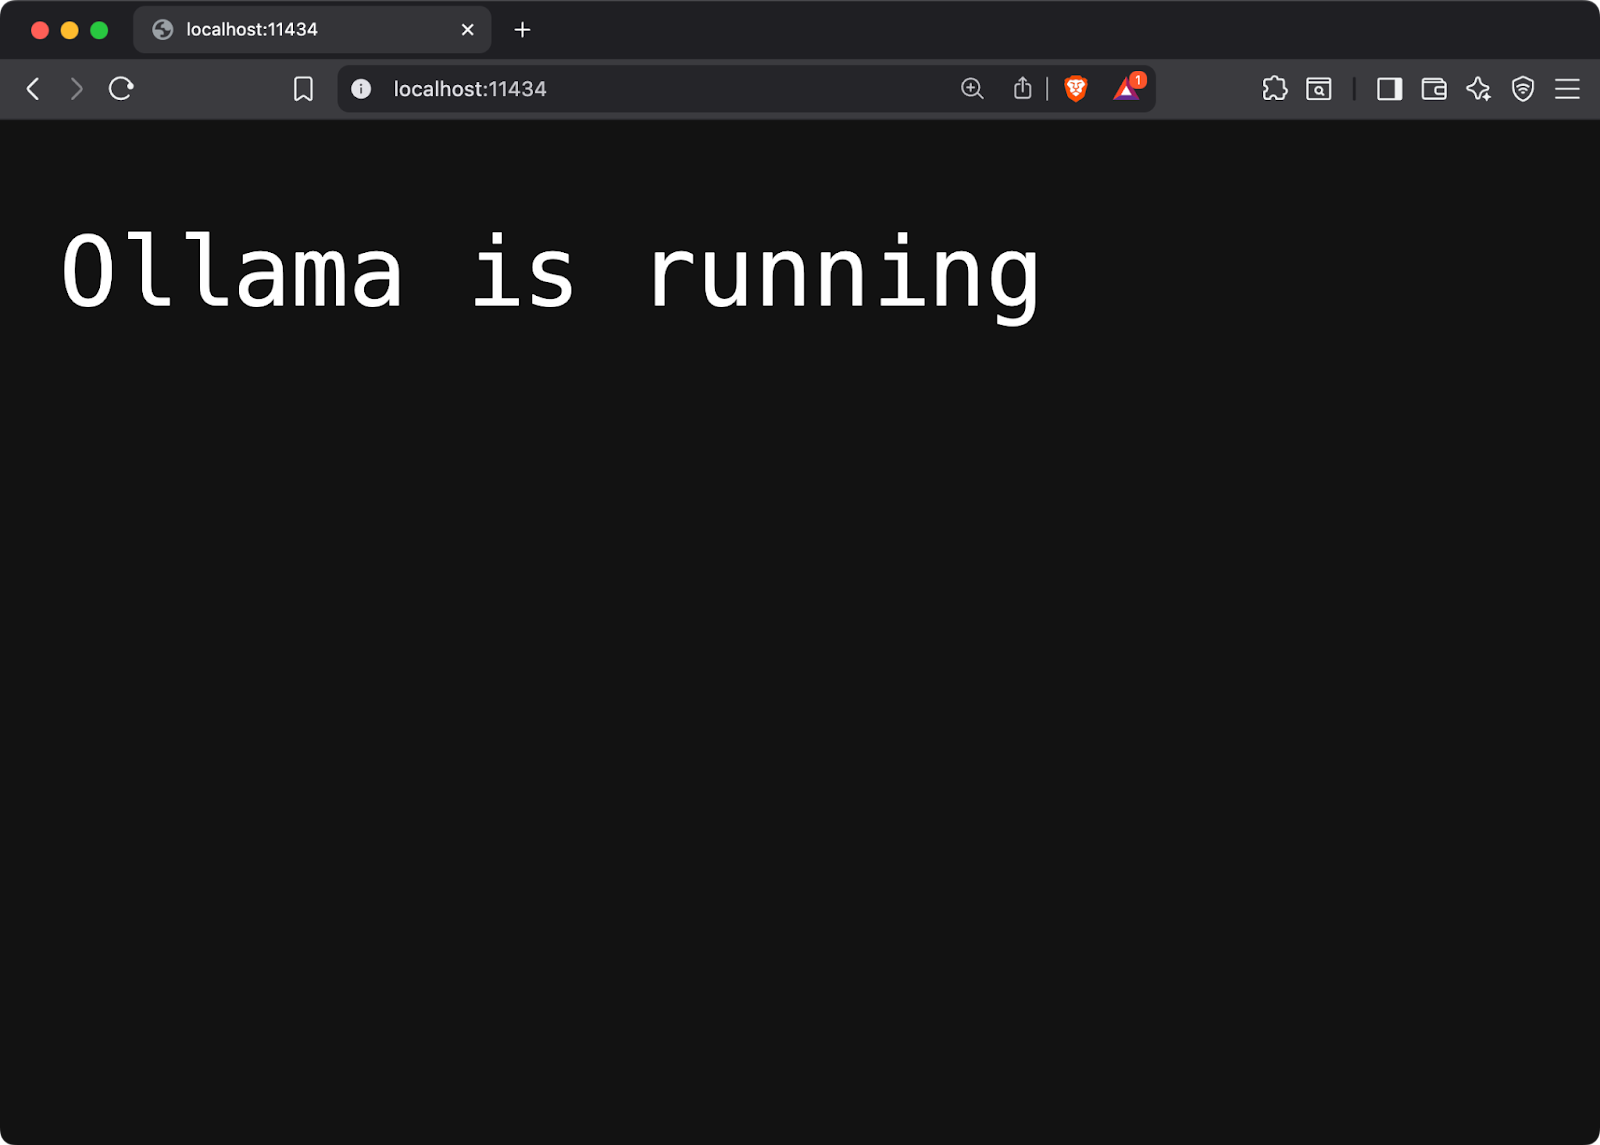
Ollama chạy cục bộ
Giờ hãy tải xuống một mô hình để kiểm tra mọi thứ hoạt động:
docker exec -it my-ollama-docker ollama pull llama3.1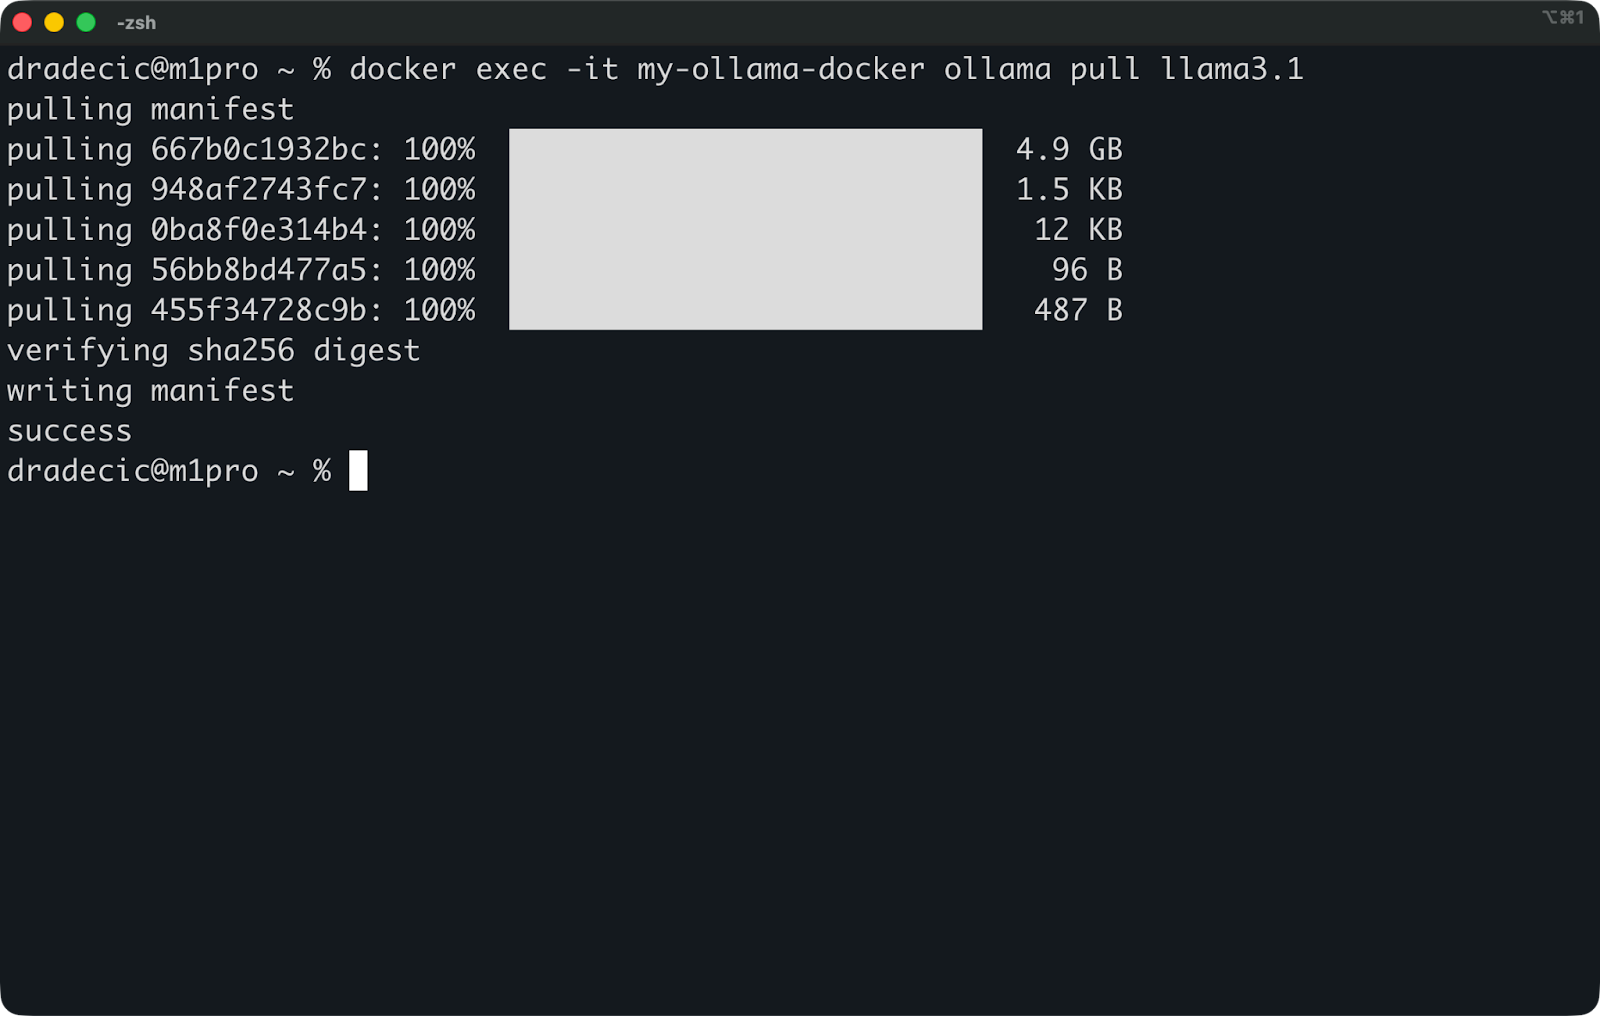
Kéo mô hình Llama3.1
Lệnh này tải mô hình Llama 3.1 8b vào trong container của bạn. Mô hình khoảng 5 GB, nên việc tải có thể mất vài phút.
Bạn có thể xác minh thiết lập bằng cách liệt kê các mô hình sẵn có:
docker exec -it my-ollama-docker ollama list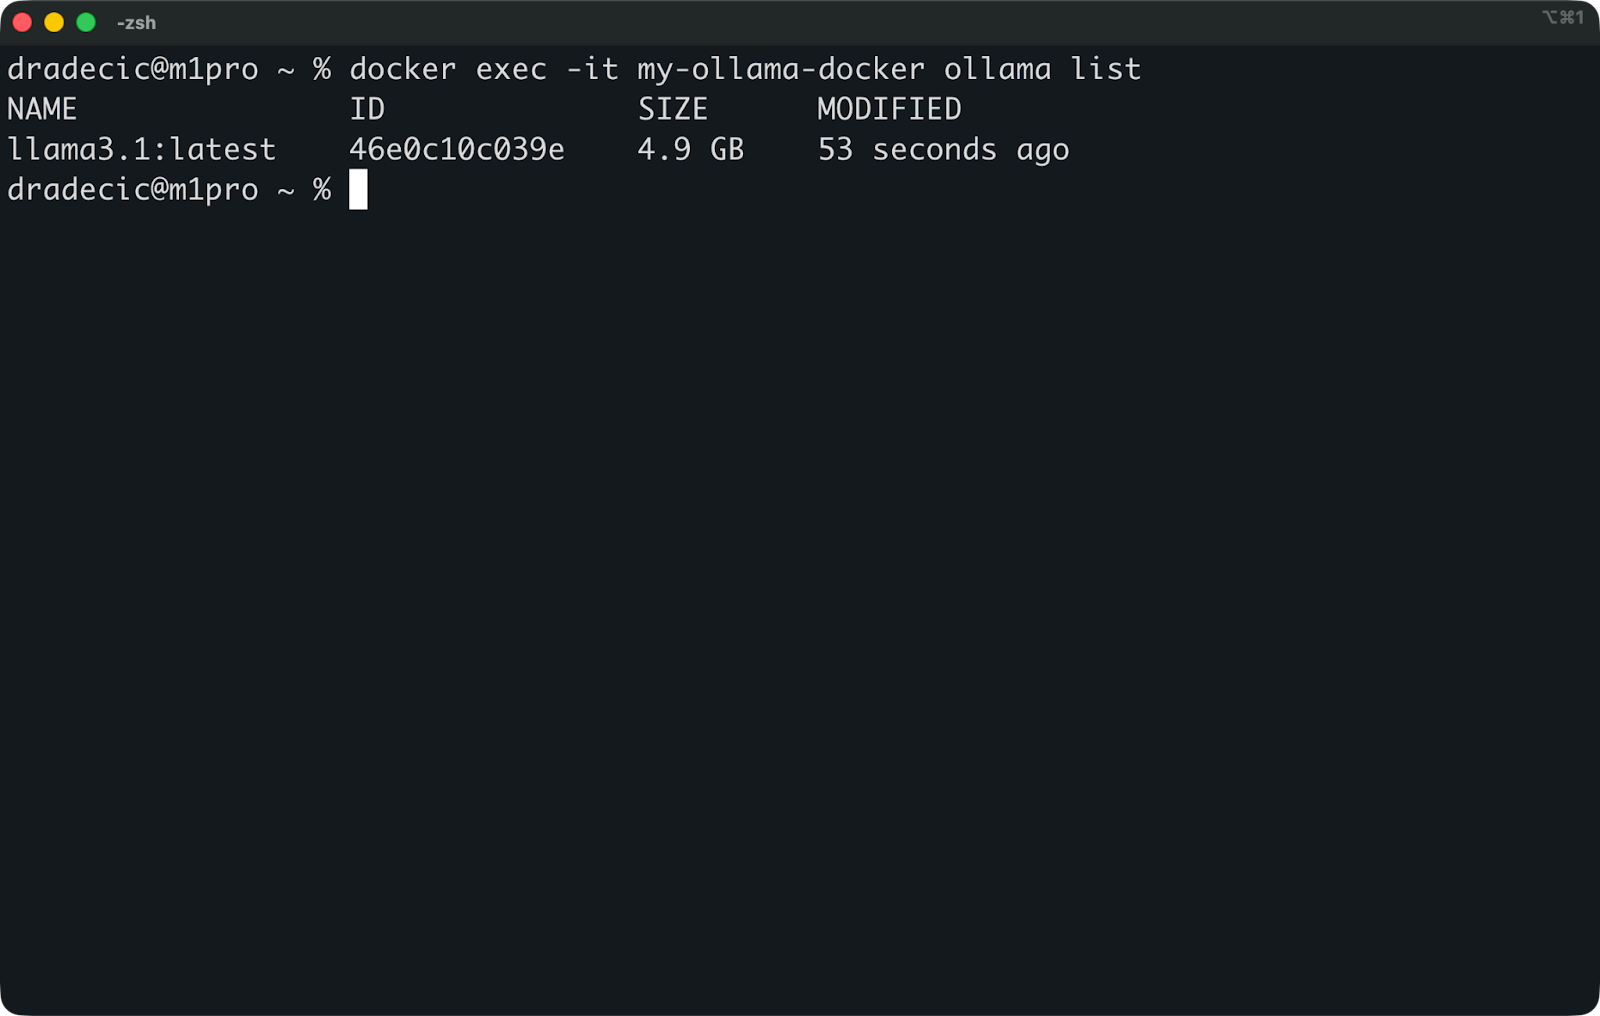
Liệt kê các mô hình sẵn có
Ánh xạ volume là rất quan trọng. Nếu không có nó, bạn sẽ mất tất cả mô hình đã tải khi container dừng. Volume ollama:/root/.ollama sẽ lưu giữ mô hình của bạn qua các lần khởi động lại và cập nhật container.
Với môi trường sản xuất, bạn có thể muốn xây dựng image tùy chỉnh với mô hình nạp sẵn. Tạo một Dockerfile tải mô hình trong quá trình build:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
Cách này đóng gói sẵn mô hình vào image, nên container mới khởi động là có mọi thứ sẵn sàng.
Khi container đang chạy, Ollama hoạt động như bất kỳ REST API nào khác.
Dịch vụ lắng nghe tại http://localhost:11434 và chấp nhận các yêu cầu HTTP tiêu chuẩn. Bạn không cần client hay SDK đặc biệt — chỉ cần gửi JSON và nhận phản hồi.
Cách tạo văn bản bằng một lệnh curl đơn giản:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'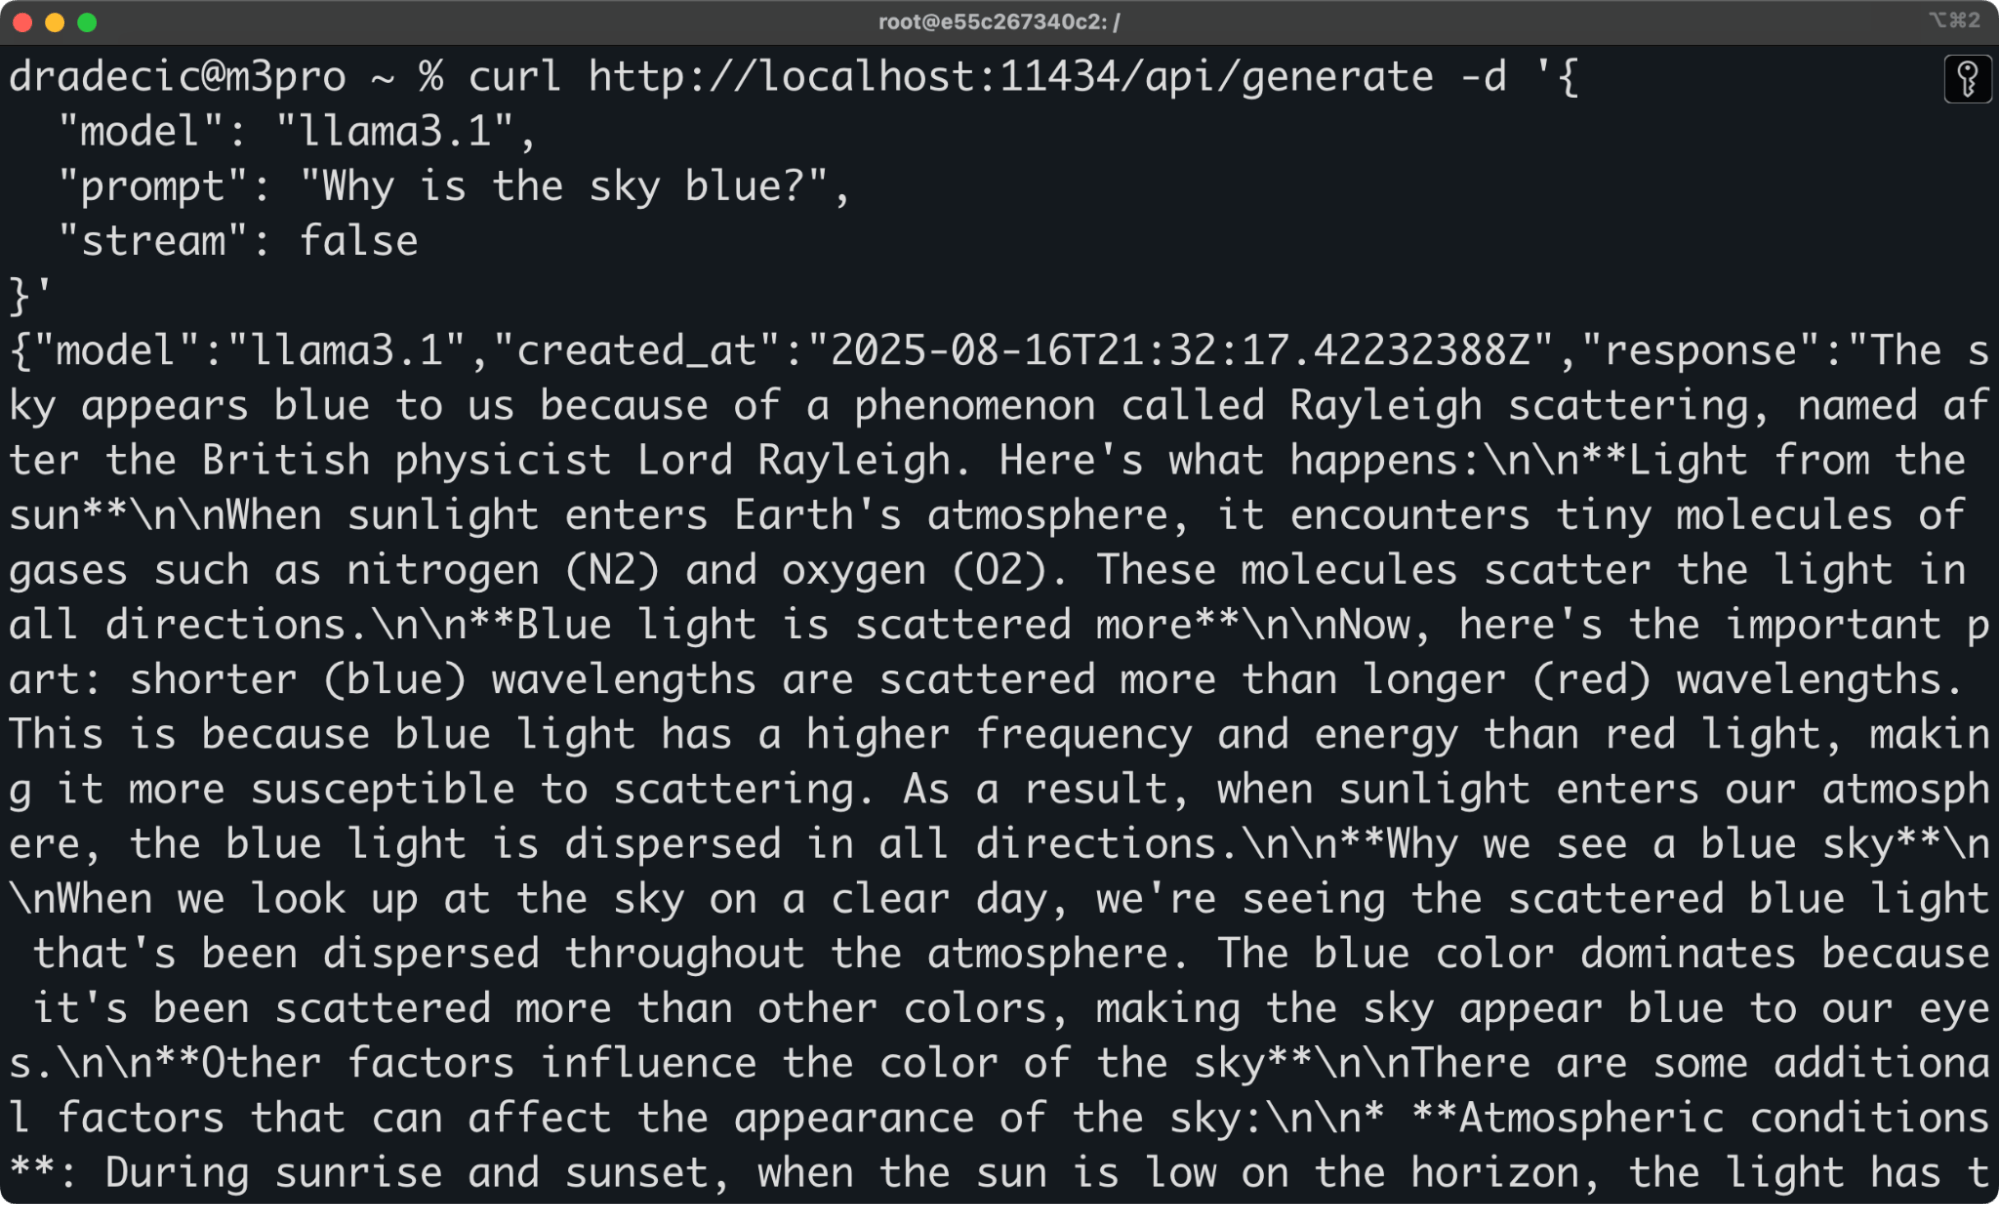
Truy cập ollama bằng curl
API trả về phản hồi JSON với văn bản được tạo. Đặt "stream": false để nhận toàn bộ phản hồi một lần, hoặc "stream": true để nhận token khi chúng được tạo ra.
Tích hợp Python cũng đơn giản như vậy:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])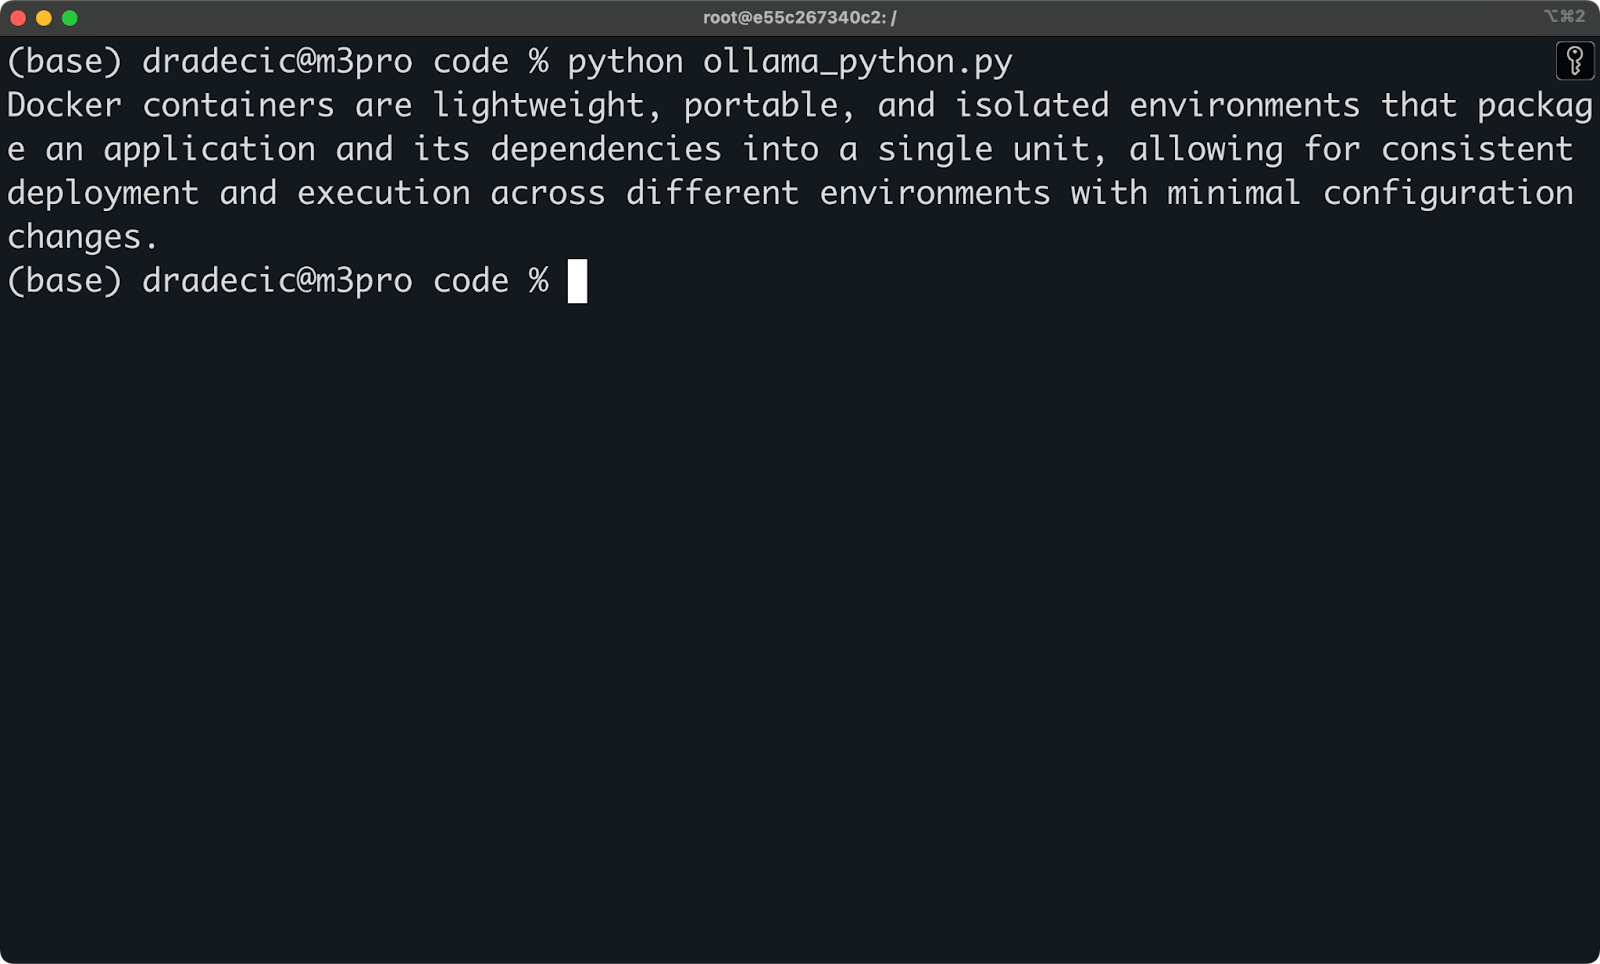
Truy cập ollama bằng Python
Điều này khiến Ollama trở nên hoàn hảo làm backend cho các ứng dụng cục bộ. Bạn có thể xây dựng giao diện chat, công cụ hoàn thành mã, hoặc hệ thống phân tích tài liệu giao tiếp với LLM trong container mà không gửi dữ liệu ra ngoài.
Với các quy trình phức tạp hơn, tích hợp LangChain hoạt động ngay lập tức:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)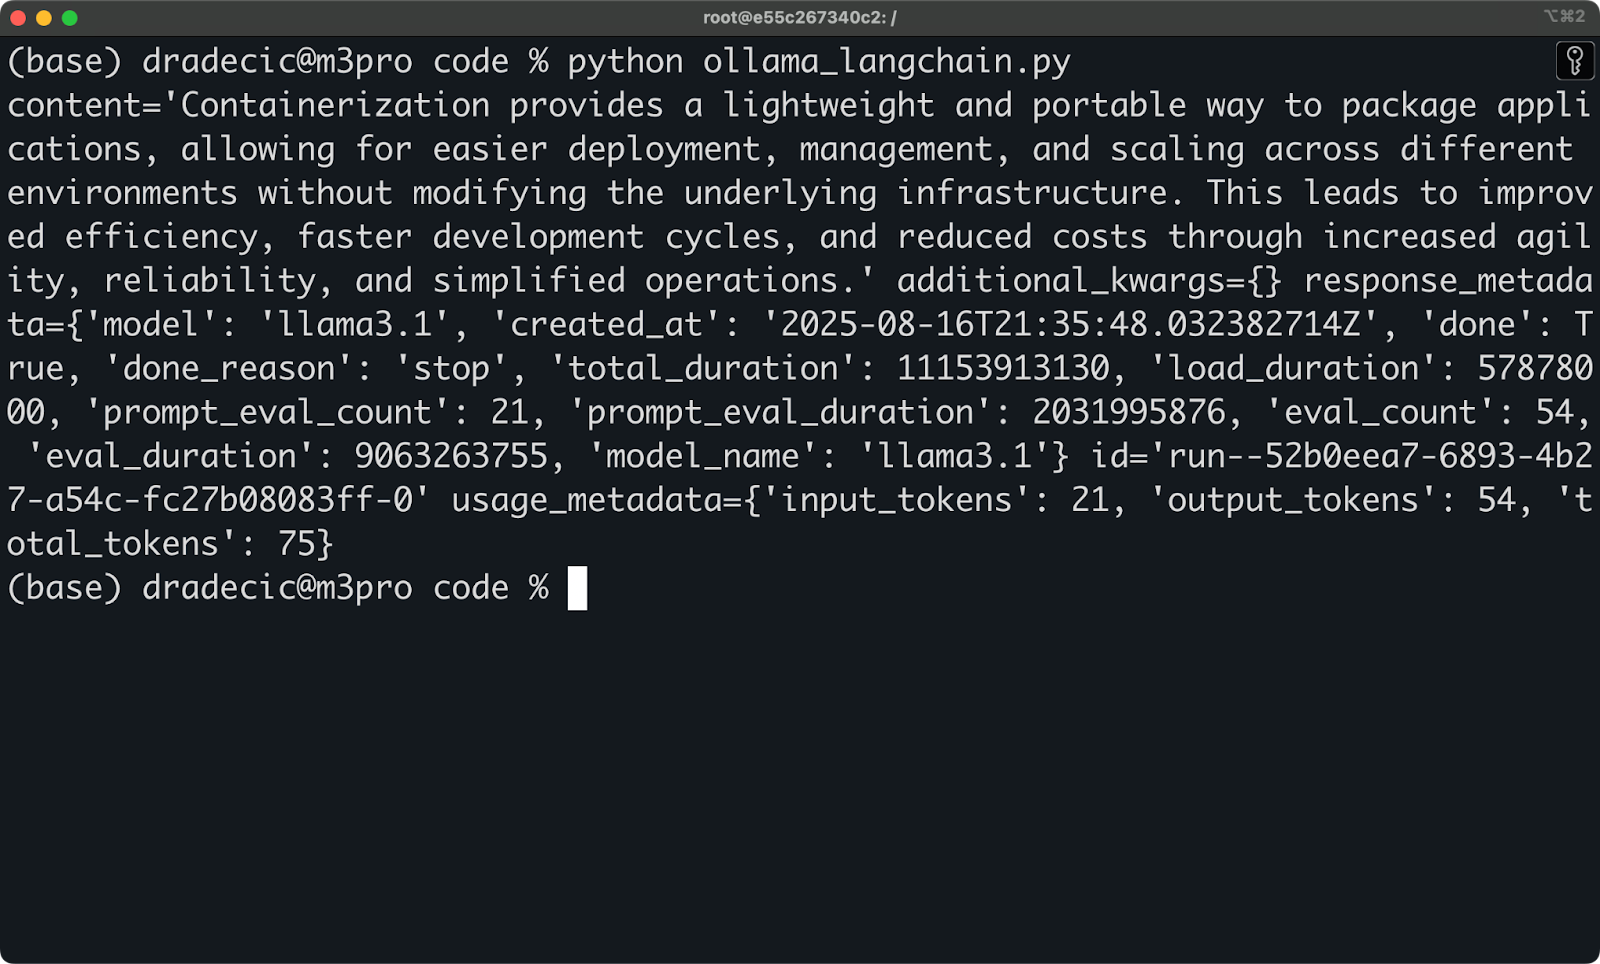
Truy cập ollama bằng LangChain
Bạn có toàn bộ sức mạnh của LLM cục bộ với sự đơn giản của các yêu cầu HTTP.
Bạn từng thắc mắc ứng dụng LLM được triển khai như thế nào? Hãy đọc hướng dẫn từng bước về triển khai ứng dụng LLM bằng Docker.
LLM cục bộ cần phần cứng mạnh để chạy tốt, và Docker cũng thêm chút chi phí phụ trợ của riêng nó.
CPU so với GPU tạo khác biệt lớn. Ollama có thể chạy trên hệ thống chỉ có CPU, nhưng suy luận sẽ chậm, hãy kỳ vọng 30+ giây cho phản hồi đơn giản. Với GPU hiện đại, cùng truy vấn hoàn tất dưới 5 giây. GPU NVIDIA hoạt động tốt nhất, nhưng các máy Mac Apple Silicon cũng cho hiệu năng tốt, thậm chí đáng tiền hơn.
Yêu cầu RAM tỷ lệ theo kích thước mô hình. Các mô hình nhỏ như Llama3.1 8B cần tối thiểu 8GB RAM hệ thống, trong khi phiên bản lớn 70B cần 64GB hoặc hơn. Mô hình được nạp trong bộ nhớ khi sử dụng, vì vậy bạn không thể chạy mô hình 13B trên máy chỉ có 8GB RAM.
Dung lượng đĩa tăng rất nhanh. Mỗi mô hình tải về ngốn hàng gigabyte dung lượng đĩa:
Nhiều phiên bản và mức lượng tử hóa của mô hình sẽ nhanh chóng nhân nhu cầu lưu trữ. Bạn có thể chuyển mô hình sang ổ ngoài nếu thiếu dung lượng.
Chi phí container là tối thiểu cho tính toán nhưng đáng kể với lưu trữ. Image Ollama nền dưới 1GB, nhưng mô hình được lưu trong các volume Docker. Nếu bạn xây image tùy chỉnh với mô hình nạp sẵn, hãy kỳ vọng mỗi image sẽ lớn hơn base vài gigabyte.
Tuy vậy, phân bổ bộ nhớ trong Docker có thể cần chú ý. Mặc định, Docker Desktop giới hạn bộ nhớ container. Với mô hình lớn, bạn sẽ cần tăng các giới hạn này hoặc dùng cờ --memory khi chạy container.
Nút thắt phần cứng thường là RAM, không phải CPU hay tốc độ đĩa.
Docker + Ollama mang đến năng lực AI vừa giữ dữ liệu của bạn riêng tư vừa đưa chi phí suy luận LLM về đúng $0 (không tính điện và bảo trì).
Trợ lý AI cục bộ là nơi cấu hình này tỏa sáng. Bạn có thể tạo công cụ hoàn thành mã, bộ sinh tài liệu hoặc trợ lý viết chạy hoàn toàn trên máy của bạn. Không chi phí API, không giới hạn tốc độ, không dữ liệu rời mạng của bạn. Chỉ cần trỏ trình soạn thảo hoặc IDE tới localhost:11434 và bắt đầu xây dựng.
Các pipeline RAG riêng tư cũng trở nên dễ triển khai hơn nhiều.
Bạn có thể nạp tài liệu công ty vào một cơ sở dữ liệu vector, rồi dùng Ollama để trả lời câu hỏi về chúng. Toàn bộ kho tri thức vẫn ở nội bộ, điều này quan trọng với thông tin pháp lý, tài chính, hoặc độc quyền không thể chạm vào API bên ngoài.
Phát triển chatbot ngoại tuyến cho phép bạn dựng mẫu và thử nghiệm AI hội thoại mà không phụ thuộc internet. Điều này hoàn hảo cho các triển khai biên, môi trường cách ly mạng, hoặc tình huống kết nối không ổn định. Bot của bạn hoạt động như nhau dù bạn online hay đang bay ở độ cao 9.000 mét.
Thử nghiệm mô hình trước khi triển khai đám mây giúp tiết kiệm tiền và thời gian. Bạn có thể thử các mô hình, prompt và cấu hình khác nhau cục bộ trước khi cam kết suy luận đám mây đắt đỏ. Bạn có thể benchmark hiệu năng, tinh chỉnh tham số và kiểm chứng đầu ra mà không đốt sạch tín dụng API.
Các nhóm cũng dùng cấu hình Docker và Ollama này cho:
Bạn có năng lực AI cấp doanh nghiệp mà không cần hóa đơn cấp doanh nghiệp.
Có một vài điểm dễ mắc lỗi khi chạy Ollama trong Docker.
Hỗ trợ GPU cần thiết lập bổ sung. Image Docker chính thức của Ollama hỗ trợ GPU NVIDIA, nhưng bạn cần cài NVIDIA Container Toolkit trước và truyền cờ --gpus all khi chạy container:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaNếu không, Ollama sẽ rơi về chế độ chỉ dùng CPU, vẫn chạy nhưng chậm hơn nhiều. Nếu bạn dùng MacBook Apple Silicon, điều này không liên quan tới bạn.
Vấn đề quyền truy cập file có thể gây phiền với volume Docker. Nếu bạn mount một thư mục host thay vì dùng named volume, Ollama có thể không ghi được file mô hình do lệch quyền. Named volume như -v ollama:/root/.ollama loại bỏ hoàn toàn vấn đề này.
Bộ nhớ đệm mô hình giữa các lần khởi động lại hoạt động tự động nếu mount volume đúng. Các mô hình đã tải sẽ được giữ trong volume Docker, nên dừng và khởi động lại container sẽ không cần tải lại. Nhưng nếu vô tình xóa volume hoặc quên cờ -v, bạn sẽ mất hết mô hình.
Hãy nhớ các cách khắc phục nhanh sau:
Lỗi phổ biến nhất là quên mount volume và tự hỏi vì sao mô hình biến mất.
Docker giúp chạy LLM cục bộ trở nên đơn giản, di động và sạch sẽ.
Bạn có tính riêng tư theo thiết kế, dữ liệu của bạn không bao giờ rời khỏi máy. Bạn có chi phí dự đoán được, không hóa đơn API bất ngờ hay giới hạn tốc độ. Và bạn có toàn quyền kiểm soát ngăn xếp AI của mình mà không bị khóa nhà cung cấp hay phụ thuộc internet.
Thiết lập chỉ mất vài phút.
Kéo image, chạy container, tải một mô hình, và bạn sẵn sàng xây dựng. Dù bạn đang dựng mẫu trợ lý AI, vận hành pipeline RAG riêng tư, hay chỉ thử nghiệm các mô hình khác nhau, tổ hợp này mang lại năng lực cấp doanh nghiệp ngay trên laptop của bạn.
Hãy thử ngay. Chọn một mô hình phù hợp phần cứng của bạn, khởi chạy container Ollama, và bắt đầu xây dựng. Rào cản gia nhập gần như không tồn tại.
Bước tiếp theo, chúng tôi khuyến nghị bạn thiết lập và chạy DeepSeek R1 cục bộ với Ollama.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
