
कोर्स
इंटरमीडिएट Docker
4 घंटा
10.3K
अधिकांश डेवलपर स्थानीय LLM आज़माना चाहते हैं, लेकिन उन्हें शुरुआत कहाँ से करें, यह पता नहीं होता।
Llama और Mistral जैसे ओपन-सोर्स मॉडल के उभार ने स्थानीय AI को पहले से कहीं अधिक सुलभ बना दिया है। आपको OpenAI या Anthropic पर एक पैसा भी खर्च करने की ज़रूरत नहीं, न ही अपना डेटा थर्ड पार्टियों को भेजने की चिंता। चुनौती यह है कि अधिकतर सेटअप गाइड में Python एनवायरनमेंट, CUDA ड्राइवर, और ऐसी निर्भरताएँ मैनेज करनी पड़ती हैं जो मशीन बदलते ही अक्सर टूट जाती हैं।
Ollama इसे सरल बनाता है—कम-से-कम सेटअप के साथ स्थानीय LLM चलाने का सीधा तरीका देता है। जब आप इसे Docker के साथ जोड़ते हैं, तो आपको एक साफ-सुथरा, पोर्टेबल समाधान मिलता है जो अलग-अलग सिस्टम पर एक ही तरह काम करता है।
इस गाइड में, मैं आपको Docker में Ollama सेट करने, अपना पहला मॉडल खींचने (pull) और ऐसे स्थानीय LLM चलाने का तरीका दिखाऊँगा जिन्हें आप किसी भी एप्लिकेशन से एक्सेस कर सकते हैं।
यदि आप Docker के लिए पूरी तरह नए हैं, तो हम सलाह देते हैं कि आप हमारे Introduction to Docker कोर्स में नामांकन करें ताकि बुनियादी बातें समझ सकें।
Ollama को अपने हार्डवेयर पर बड़े भाषा मॉडल चलाने का सबसे सरल तरीका समझें।
यह एक हल्का रनटाइम है जो स्थानीय LLMs के लिए भारी-भरकम काम संभालता है। आपको Python एनवायरनमेंट मैनेज करने, CUDA ड्राइवर मैन्युअली इंस्टॉल करने, या मॉडल वेट्स और टोकनाइज़र समझने की ज़रूरत नहीं। Ollama एक ही कमांड से LLaMA, Mistral, और Gemma जैसे मॉडल डाउनलोड, लोड, और सर्व कर देता है।
गोपनीयता बिल्ट-इन आती है। आपकी बातचीत आपकी मशीन से बाहर नहीं जाती। न API keys, न उपयोग ट्रैकिंग, न बाहरी सर्वरों पर डेटा भेजना। यह इसे संवेदनशील काम के लिए परफेक्ट बनाता है जहाँ आप थर्ड-पार्टी सेवाओं को स्वामित्व वाले कोड या व्यक्तिगत जानकारी उजागर करने का जोखिम नहीं ले सकते।
यह टूल पहले डेवलपर्स के लिए डिज़ाइन किया गया था। यह macOS और Linux पर नैटिव रूप से चलता है, एक सरल REST API देता है, और अब Docker कंटेनरों के अंदर काम करता है। इसका मतलब है कि आप डेवलपमेंट के दौरान वही सेटअप लोकली चला सकते हैं और जहाँ भी Docker चलता है, वहाँ इसे डिप्लॉय कर सकते हैं।
आपको एक प्रोडक्शन-रेडी LLM सर्वर मिलता है जो एक कमांड से शुरू होता है और ऑफ़लाइन काम करता है।
Ollama अकेला LLM रनटाइम नहीं है - n8n और Qdrant को भी आज़माएँ।
जवाब सरल है—आप अपने सिस्टम को साफ रखते हुए Ollama के उपयोग का पूरा लाभ पाते हैं।
Ollama को सीधे अपनी मशीन पर चलाना भी ठीक है—यह पैकेज्ड इंस्टॉलर (.exe Windows के लिए, .dmg Mac के लिए) के रूप में आता है जो सब संभाल लेता है। लेकिन Docker एक बड़ी बढ़त देता है: आइसोलेशन।
Docker में, Ollama अपने कंटेनर में चलता है। इससे आपका होस्ट सिस्टम साफ रहता है। आपके मुख्य सिस्टम पर इंस्टॉलेशन का कोई निशान नहीं, टेस्टिंग खत्म होने पर कोई बचे-खुचे फाइल नहीं, और जब भी संस्करण बदलना हो या पूरी तरह क्लीनअप करना हो, तो आसानी से हटाएँ।
टीम के सभी सदस्यों के लिए वही सेटअप काम करता है, पुनरुत्पादनक्षमता के कारण। बस एक Docker कमांड साझा करें, और macOS, Linux, या Windows—कोई भी बिल्कुल वही Ollama एनवायरनमेंट चला सकता है।
डिप्लॉयमेंट क्रॉस-प्लैटफ़ॉर्म सपोर्ट के साथ आसान हो जाता है। वही कंटेनर जो आपके लैपटॉप पर चलता है, वह बिना बदलाव क्लाउड सर्वर, CI पाइपलाइन, या सहकर्मी की मशीन पर भी चलेगा।
सरल सेटअप और टियरडाउन के साथ आप सेकंडों में Ollama स्पिन-अप कर सकते हैं और उतनी ही तेजी से हटा सकते हैं। न अनइंस्टॉल स्क्रिप्ट, न कॉन्फ़िग फाइल ढूँढ़ना, न सिस्टम क्लीनअप।
यह Docker को इन कामों के लिए परफेक्ट बनाता है:
संक्षेप में, सेटअप की झंझटों के बिना स्थानीय LLMs के सभी फायदे मिलते हैं।
और अधिक व्यावहारिक Docker संसाधन ढूँढ़ रहे हैं? ये मशीन लर्निंग और AI के लिए 12 Docker कंटेनर इमेज आपको शुरुआत करने में मदद करेंगी।
Docker में Ollama चलाने के लिए आपको ठीक तीन कमांड लगेंगे।
पहले, Docker Hub से आधिकारिक Ollama इमेज खींचें:
docker pull ollama/ollama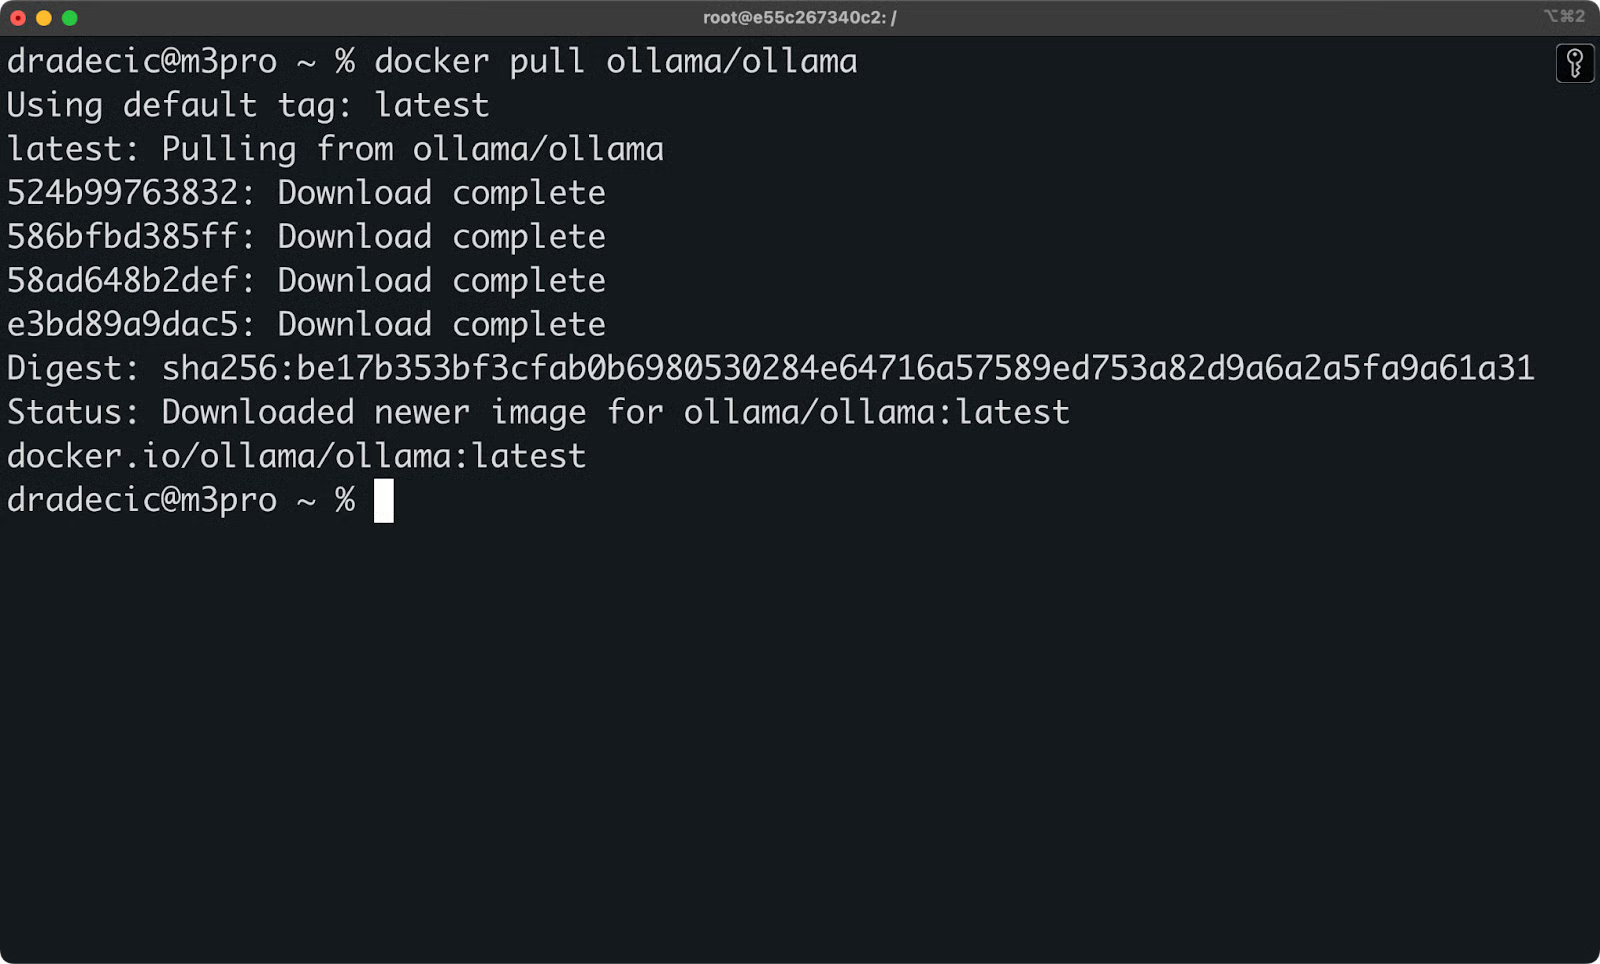
ollama इमेज खींचना
इसके बाद, सही पोर्ट और वॉल्यूम मैपिंग के साथ कंटेनर चलाएँ:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama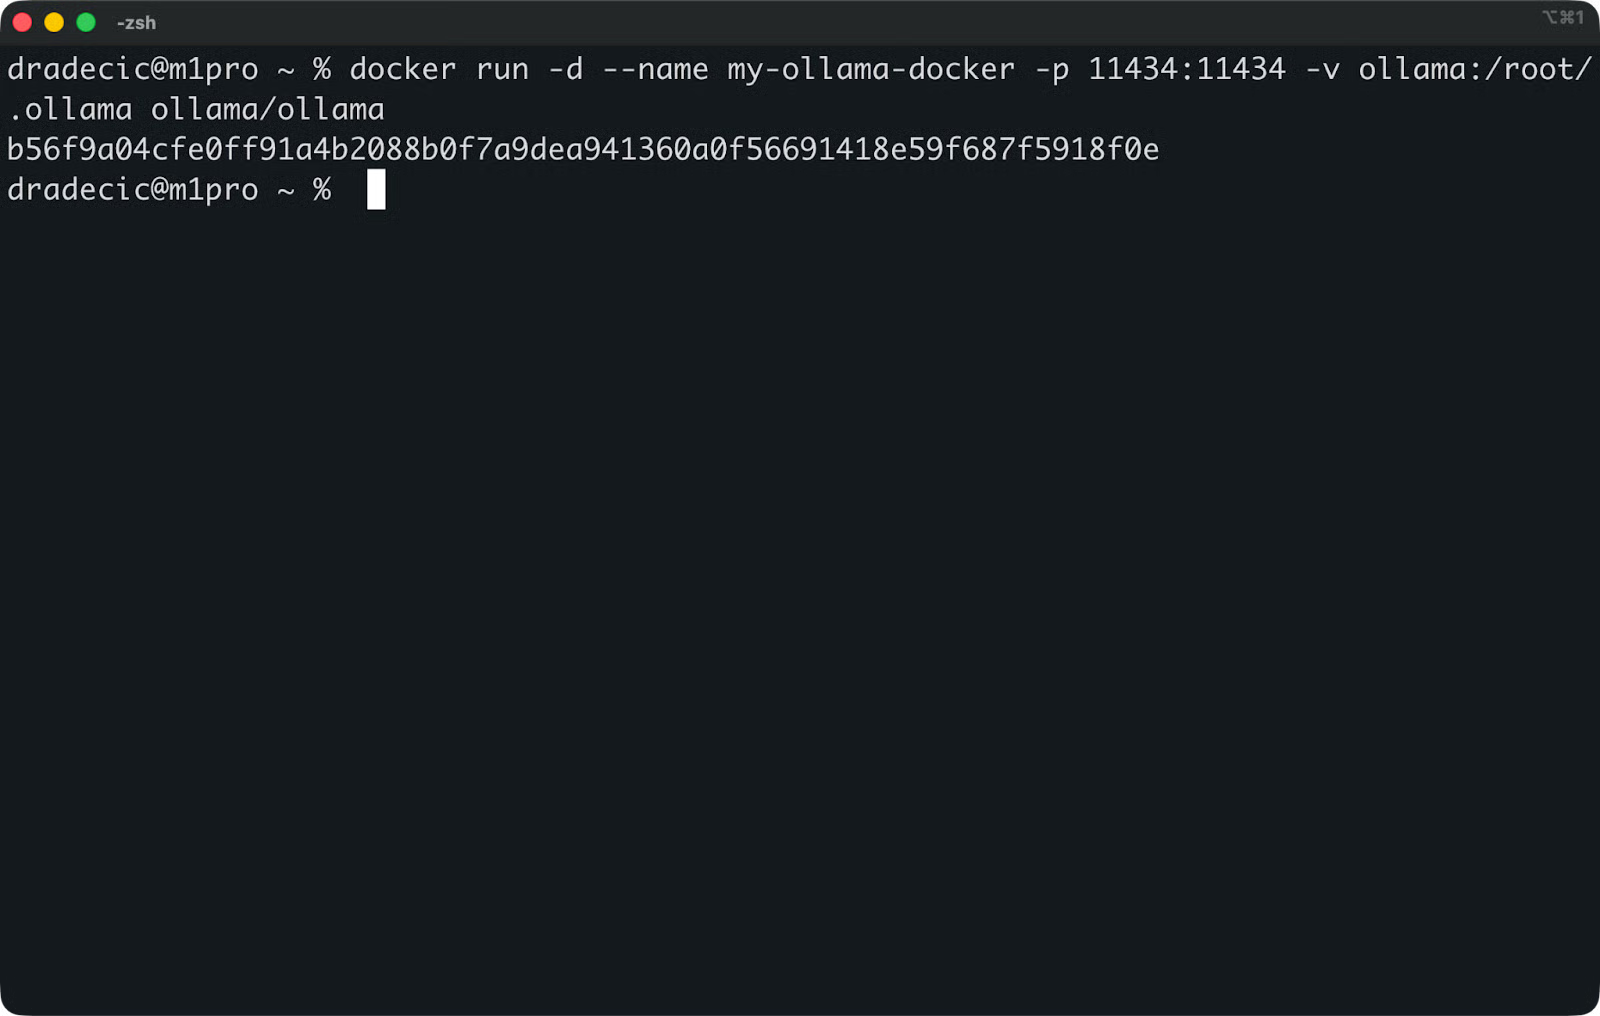
ollama चलाना
प्रत्येक फ़्लैग क्या करता है, यह रहा:
-d कंटेनर को बैकग्राउंड में चलाता है--name my-ollama.docker आपके कंटेनर को एक आसान नाम देता है-p 11434:11434 Ollama के डिफ़ॉल्ट पोर्ट को आपके होस्ट मशीन से मैप करता है-v ollama:/root/.ollama डाउनलोड किए गए मॉडलों के लिए एक स्थायी वॉल्यूम बनाता हैकंटेनर तुरंत शुरू होता है और http://localhost:11434 पर लिसन करना शुरू कर देता है।
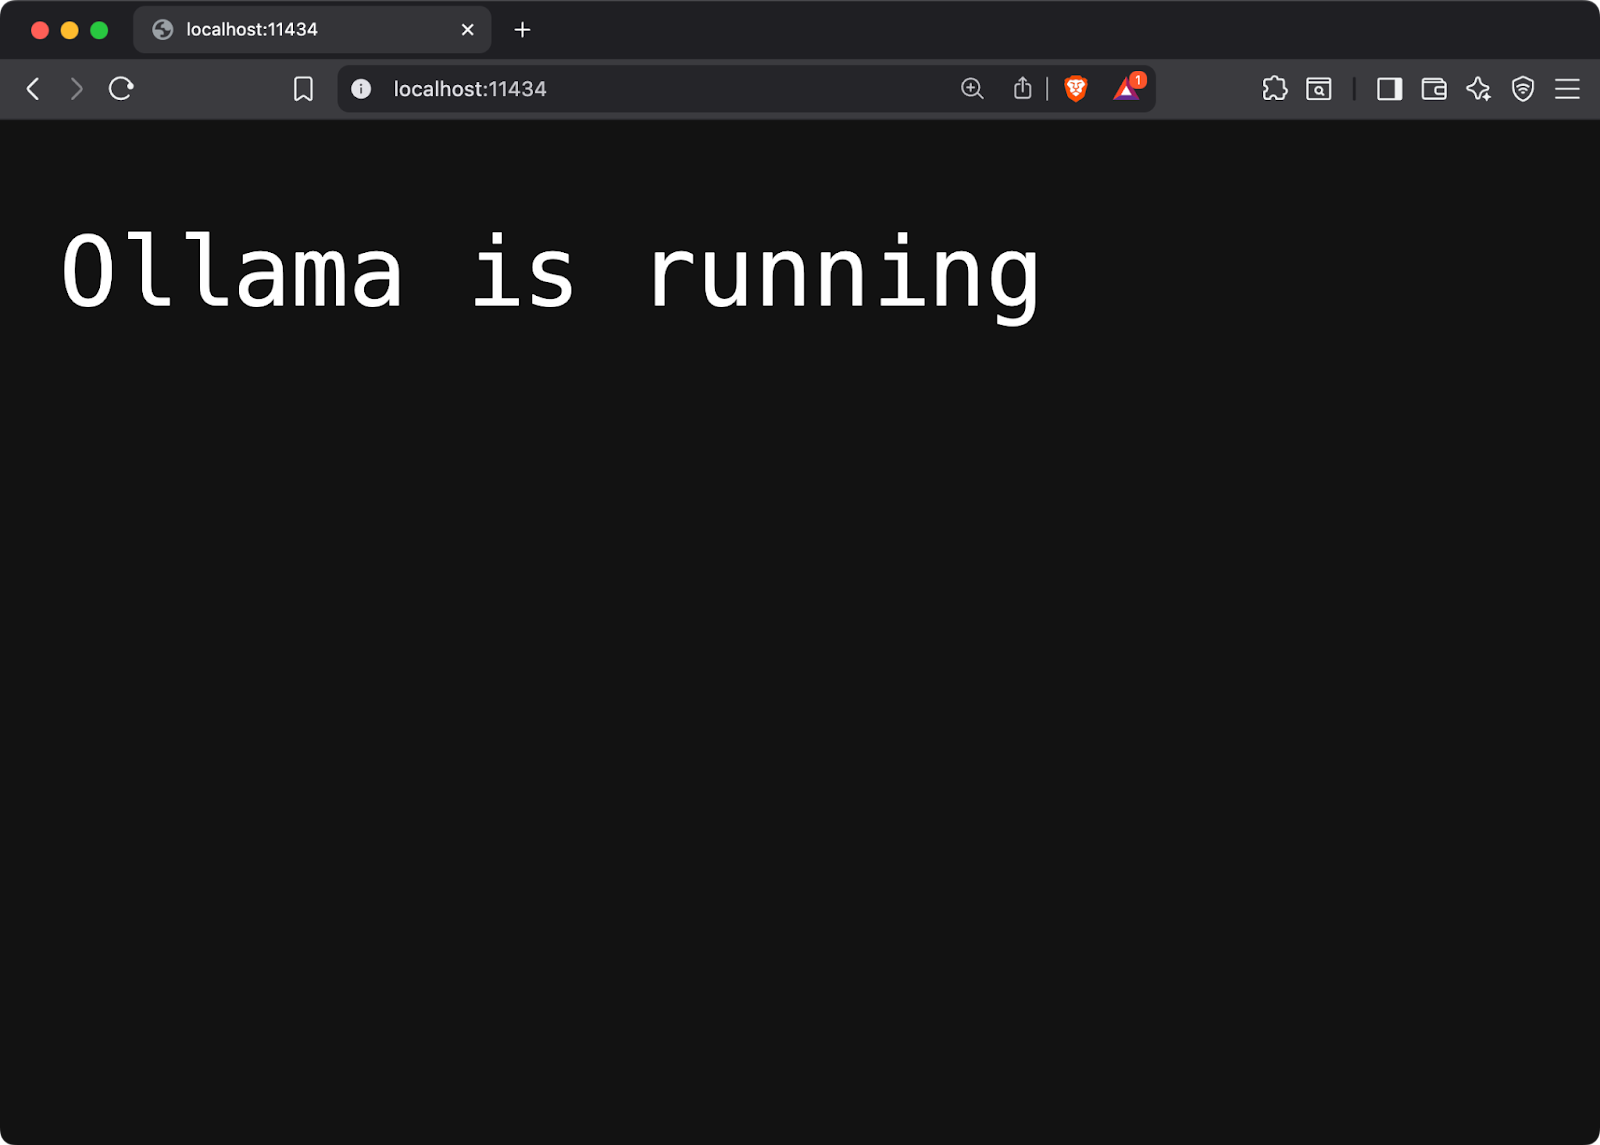
स्थानीय रूप से चल रहा Ollama
अब एक मॉडल डाउनलोड करें ताकि जाँच सकें कि सब कुछ काम कर रहा है:
docker exec -it my-ollama-docker ollama pull llama3.1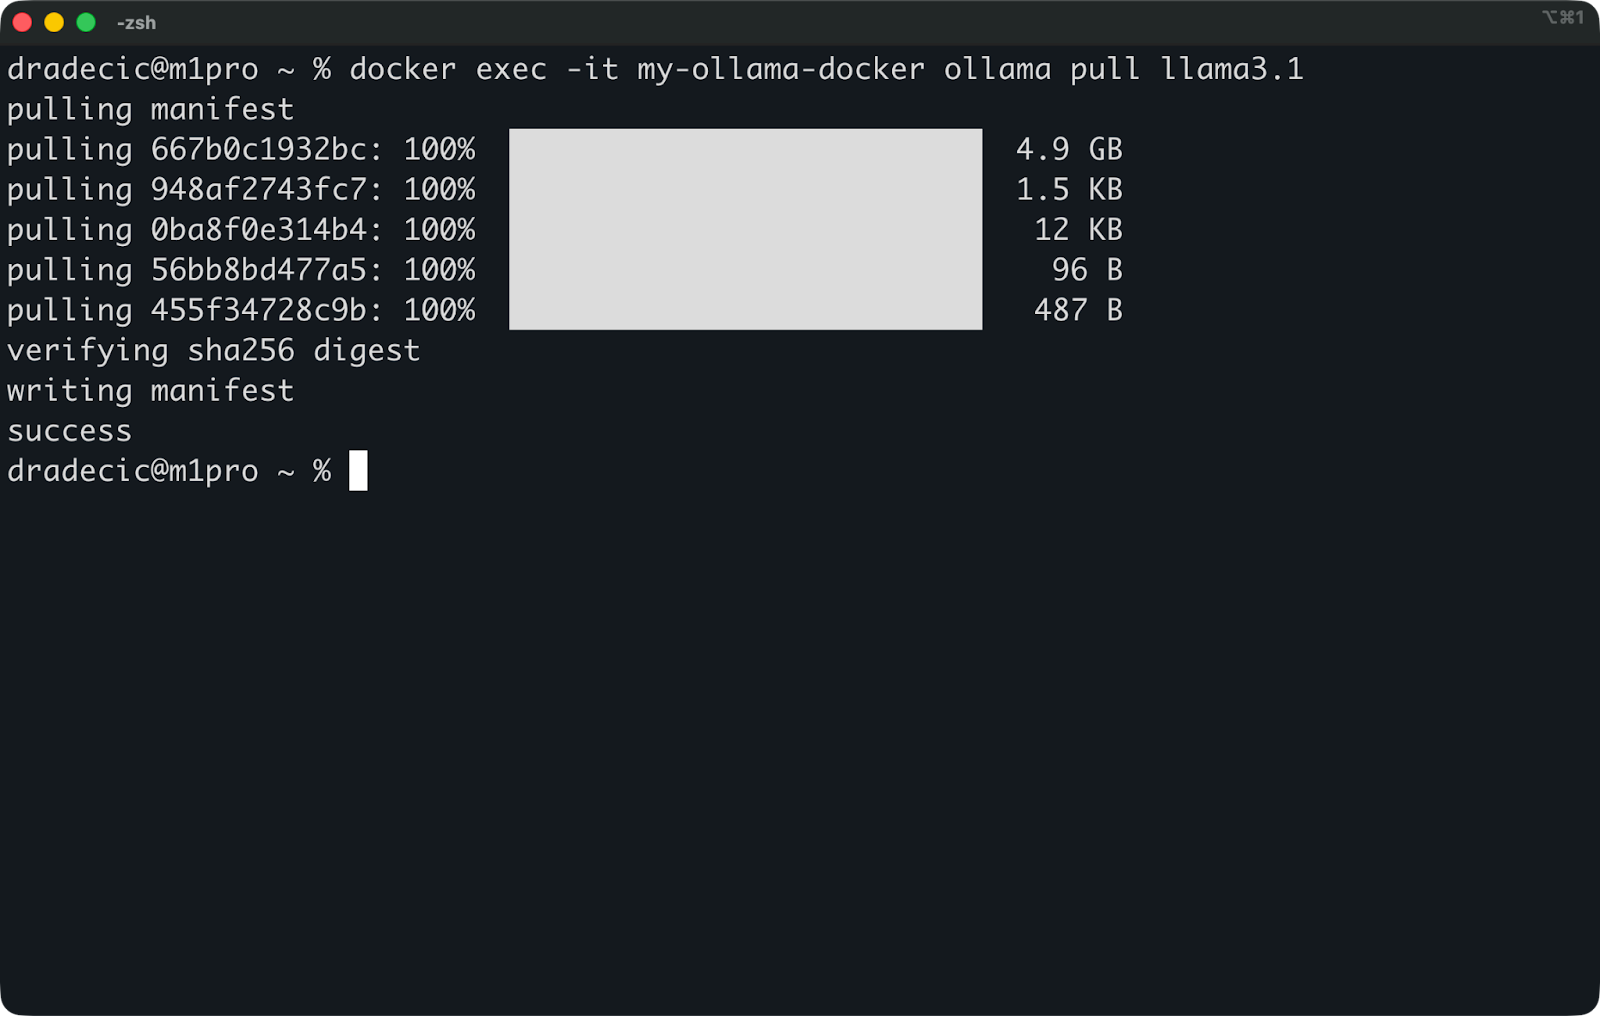
Llama3.1 मॉडल खींचना
यह आपके कंटेनर के अंदर Llama 3.1 8b मॉडल डाउनलोड करता है। मॉडल करीब 5 GB का है, इसलिए डाउनलोड में कुछ मिनट लग सकते हैं।
उपलब्ध मॉडलों की सूची दिखाकर सेटअप वेरिफ़ाई करें:
docker exec -it my-ollama-docker ollama list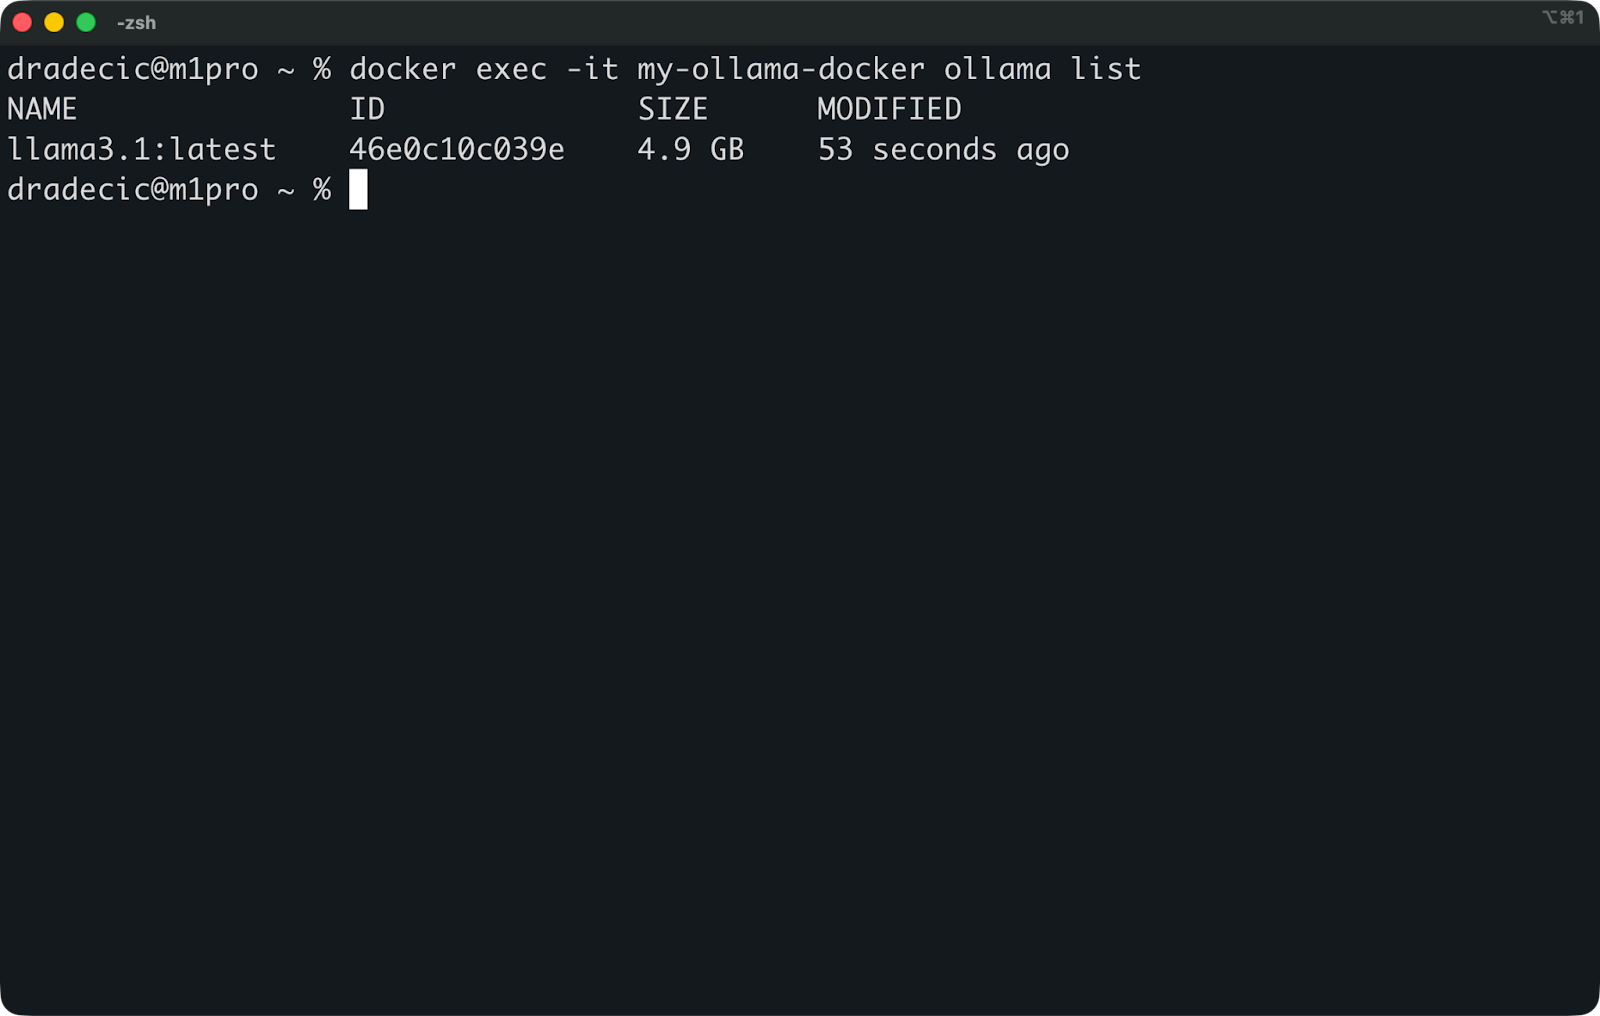
उपलब्ध मॉडलों की सूची
वॉल्यूम मैपिंग महत्वपूर्ण है। इसके बिना, कंटेनर रुकते ही आप सभी डाउनलोड किए गए मॉडल खो देंगे। ollama:/root/.ollama वॉल्यूम कंटेनर रीस्टार्ट और अपडे्ट्स के बीच आपके मॉडल्स को सुरक्षित रखता है।
प्रोडक्शन सेटअप के लिए, आप प्री-लोडेड मॉडल्स के साथ कस्टम इमेज बनाना चाह सकते हैं। एक Dockerfile बनाएँ जो बिल्ड प्रक्रिया के दौरान मॉडल डाउनलोड करे:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
यह मॉडल को आपकी इमेज में पका देता है, ताकि नए कंटेनर सब कुछ तैयार रहते ही शुरू हों।
एक बार कंटेनर चलने के बाद, Ollama किसी भी अन्य REST API की तरह काम करता है।
सेवा http://localhost:11434 पर लिसन करती है और मानक HTTP रिक्वेस्ट स्वीकार करती है। आपको किसी विशेष क्लाइंट या SDK की ज़रूरत नहीं—बस JSON भेजें और प्रतिक्रिया प्राप्त करें।
एक साधारण curl कमांड से टेक्स्ट जनरेट करने का तरीका यह है:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'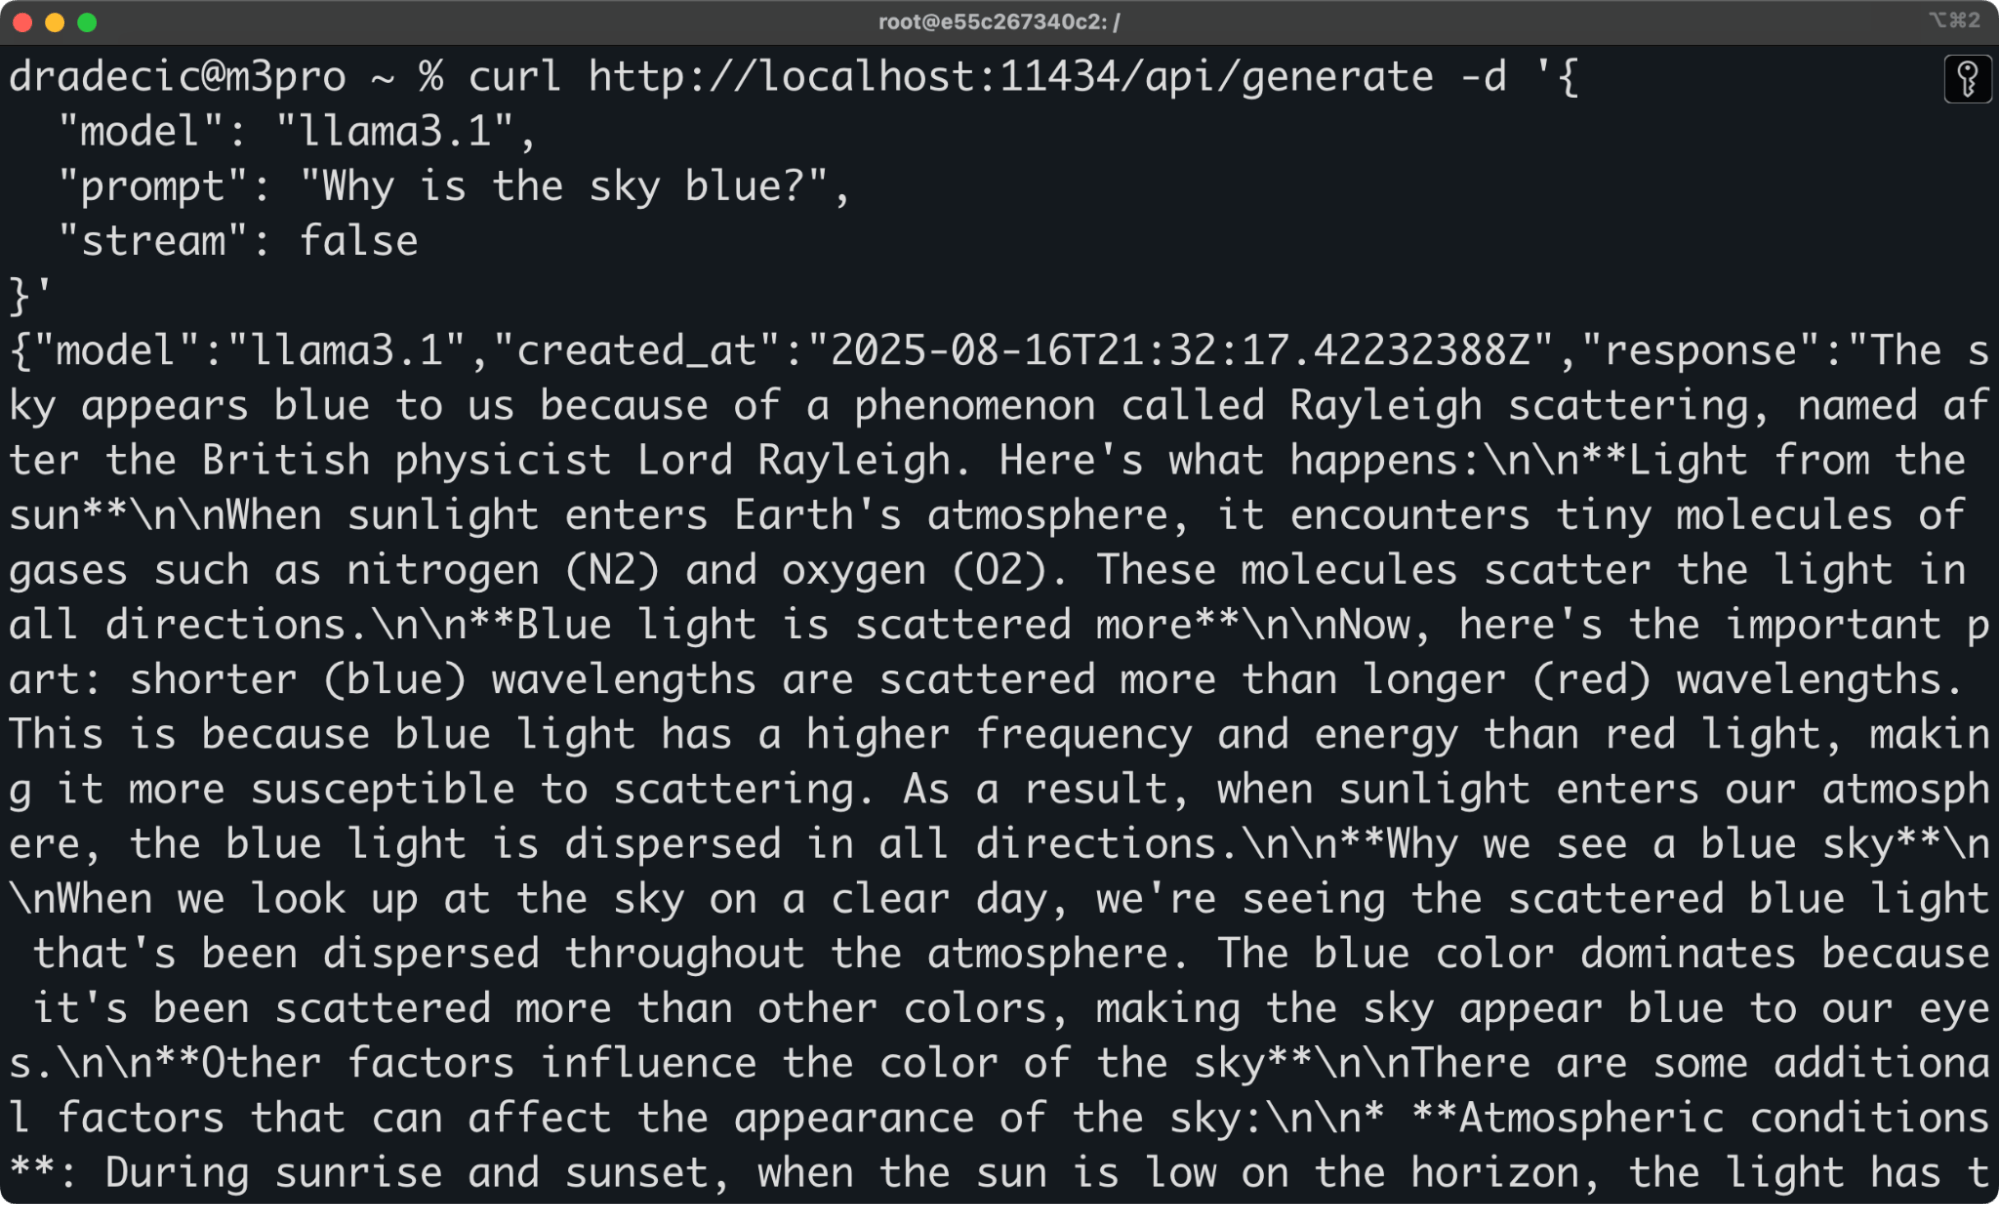
curl के साथ ollama एक्सेस करना
API जनरेटेड टेक्स्ट के साथ JSON प्रतिक्रिया देता है। पूरी प्रतिक्रिया एक साथ पाने के लिए "stream": false सेट करें, या टोकन जनरेट होते ही प्राप्त करने के लिए "stream": true।
Python इंटीग्रेशन भी उतना ही सरल है:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])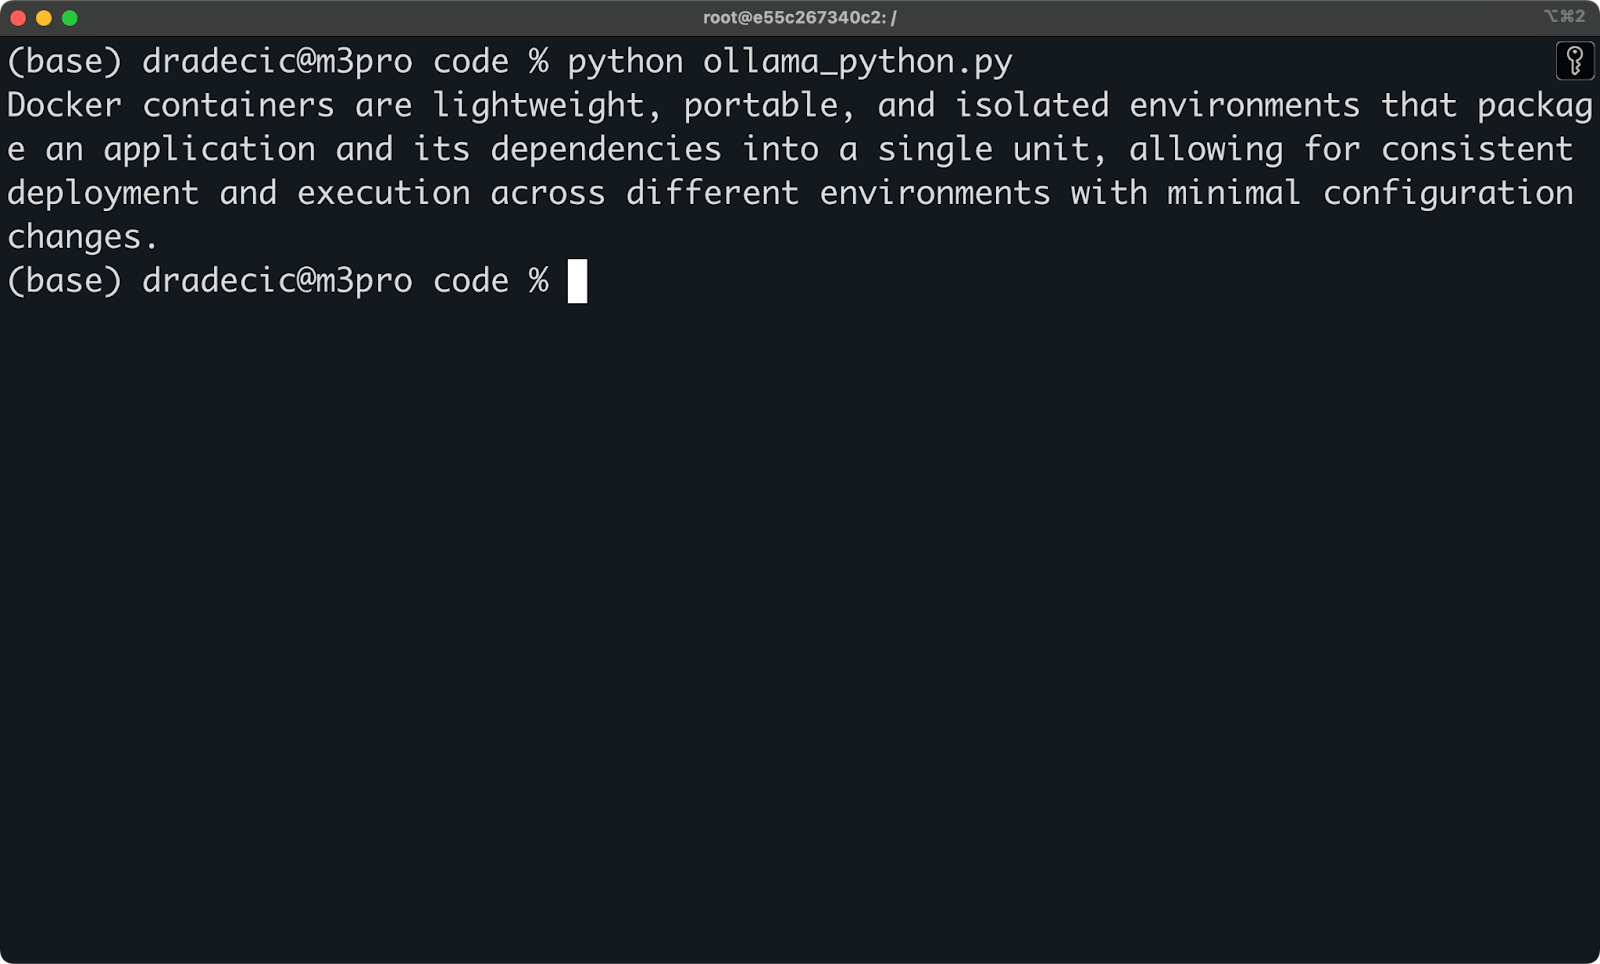
Python के साथ ollama एक्सेस करना
इससे Ollama स्थानीय एप्लिकेशनों के बैकएंड के रूप में परफेक्ट बन जाता है। आप चैट इंटरफेस, कोड कंप्लीशन टूल, या डॉक्यूमेंट विश्लेषण सिस्टम बना सकते हैं जो आपके कंटेनराइज्ड LLM से बात करते हैं, बिना डेटा बाहरी सेवाओं को भेजे।
अधिक जटिल वर्कफ़्लो के लिए, LangChain इंटीग्रेशन बॉक्स से बाहर काम करता है:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)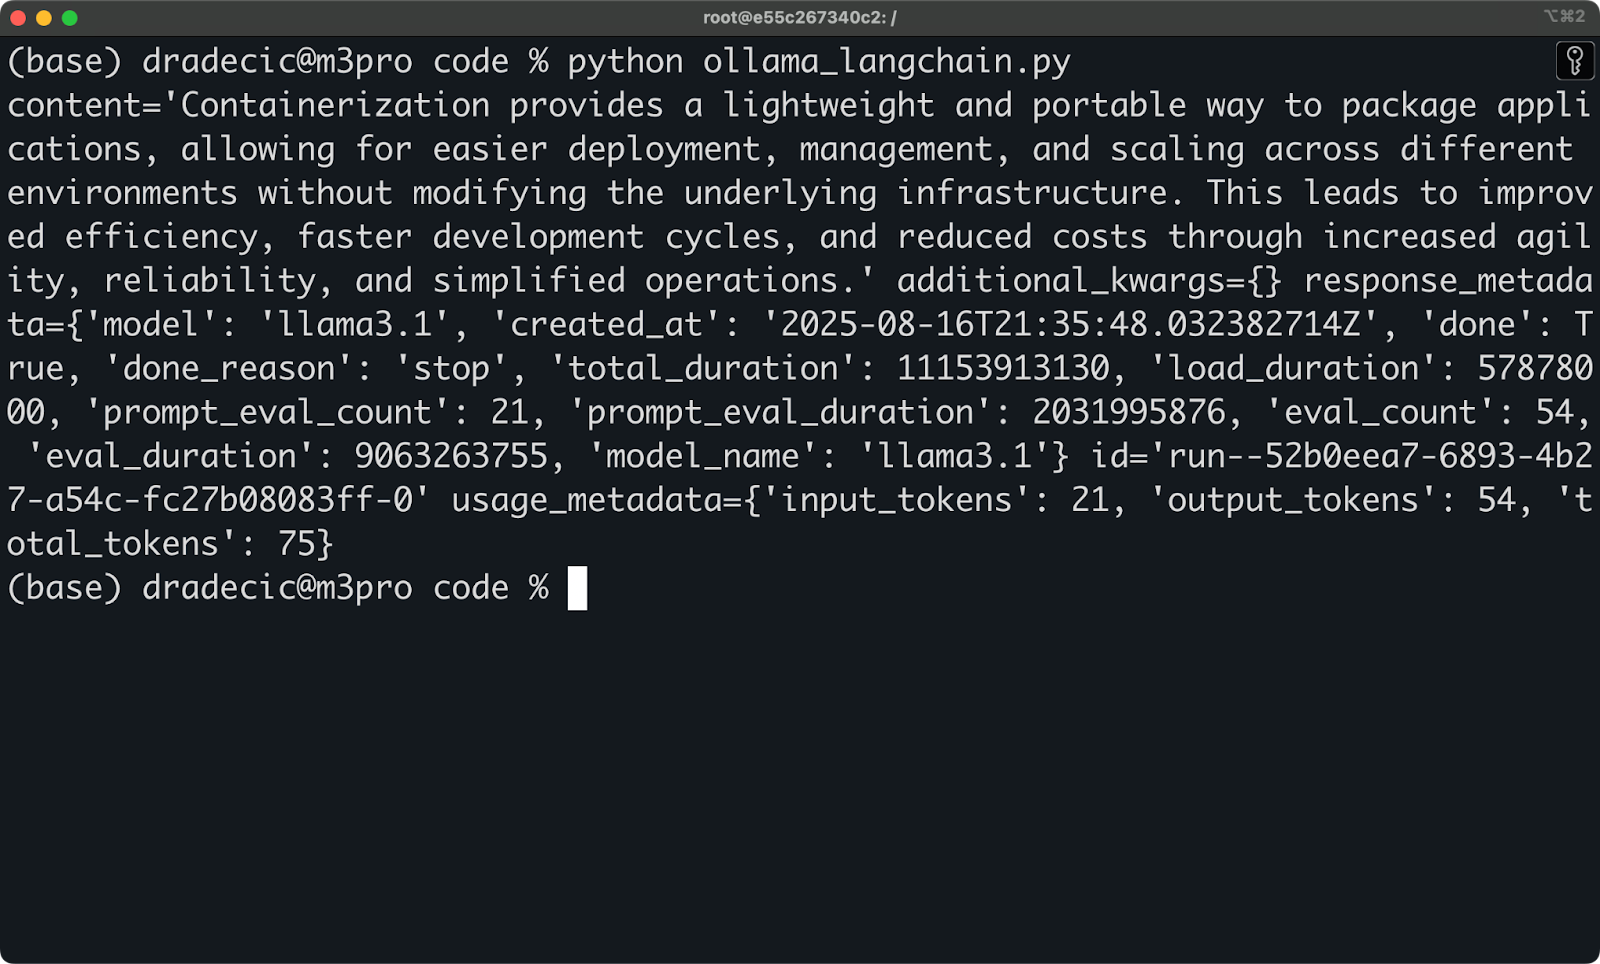
LangChain के साथ ollama एक्सेस करना
आपको HTTP रिक्वेस्ट की सरलता के साथ स्थानीय LLMs की पूरी शक्ति मिलती है।
क्या आपने कभी सोचा है कि LLM एप्लिकेशन कैसे डिप्लॉय होते हैं? हमारे चरण-दर-चरण गाइड को पढ़ें: Docker का उपयोग करके LLM एप्लिकेशन डिप्लॉयमेंट।
स्थानीय LLMs को अच्छे प्रदर्शन के लिए दमदार हार्डवेयर चाहिए, और Docker का अपना थोड़ा ओवरहेड भी होता है।
CPU बनाम GPU बड़ा फ़र्क डालते हैं। Ollama CPU-केवल सिस्टम पर चल सकता है, लेकिन इनफ़रेंस धीमा होगा—सरल प्रतिक्रियाओं के लिए 30+ सेकंड तक लग सकते हैं। आधुनिक GPU के साथ, वही क्वेरी 5 सेकंड से कम में पूरी हो जाती है। NVIDIA GPUs सबसे अच्छा काम करते हैं, लेकिन Apple Silicon Macs भी अच्छा प्रदर्शन देते हैं और पैसों के हिसाब से बेहतर विकल्प हो सकते हैं।
RAM की ज़रूरत मॉडल के आकार के साथ स्केल होती है। Llama3.1 8B जैसे छोटे मॉडल को कम-से-कम 8GB सिस्टम RAM चाहिए, जबकि बड़े 70B वर्ज़न को 64GB या अधिक। मॉडल उपयोग के दौरान मेमोरी में लोड रहता है, इसलिए आप 8GB RAM वाली मशीन पर 13B मॉडल नहीं चला सकते।
डिस्क स्पेस तेजी से बढ़ता है। हर मॉडल डाउनलोड कई गीगाबाइट लेता है:
कई मॉडल वर्ज़न और क्वांटाइज़ेशन स्टोरेज ज़रूरतों को तेज़ी से बढ़ा देते हैं। स्टोरेज समस्या हो तो आप मॉडल्स को एक्सटर्नल ड्राइव पर ऑफ़लोड कर सकते हैं।
कंटेनर ओवरहेड कम्प्यूट के लिए न्यूनतम है, लेकिन स्टोरेज के लिए मायने रखता है। बेस Ollama इमेज 1GB से कम है, पर मॉडल Docker वॉल्यूम में बने रहते हैं। यदि आप प्री-लोडेड मॉडल्स के साथ कस्टम इमेज बना रहे हैं, तो प्रत्येक इमेज बेस से कई गीगाबाइट बड़ी होगी।
हालाँकि, Docker में मेमोरी अलोकेशन पर ध्यान देना पड़ेगा। डिफ़ॉल्ट रूप से, Docker Desktop कंटेनर मेमोरी सीमित करता है। बड़े मॉडलों के लिए, आपको ये सीमाएँ बढ़ानी होंगी या कंटेनर चलाते समय --memory फ़्लैग का उपयोग करना होगा।
आमतौर पर हार्डवेयर की बाधा RAM होती है, CPU या डिस्क स्पीड नहीं।
Docker + Ollama आपको ऐसी AI क्षमताएँ देता है जो आपके डेटा को निजी रखती हैं और आपके LLM इनफ़रेंस की लागत को ठीक $0 पर रखती हैं (बिजली और रखरखाव लागत को छोड़कर)।
स्थानीय AI असिस्टेंट इस सेटअप की असली ताकत हैं। आप कोड कंप्लीशन टूल, डॉक्यूमेंटेशन जेनरेटर, या राइटिंग असिस्टेंट बना सकते हैं जो पूरी तरह आपकी मशीन पर चलते हैं। न API लागत, न रेट लिमिट, न डेटा आपके नेटवर्क से बाहर। बस अपने एडिटर या IDE को localhost:11434 पर पॉइंट करें और बनाना शुरू करें।
निजी RAG पाइपलाइन्स को डिप्लॉय करना भी बहुत आसान हो जाता है।
आप अपनी कंपनी के दस्तावेज़ों को एक वेक्टर डेटाबेस में लोड कर सकते हैं, फिर Ollama से उनके बारे में प्रश्नों के उत्तर दिला सकते हैं। पूरी नॉलेज बेस इंटरनल रहती है, जो कानूनी, वित्तीय, या स्वामित्व वाली जानकारी के लिए महत्वपूर्ण है जिसे बाहरी APIs को छूना नहीं चाहिए।
ऑफ़लाइन चैटबॉट डेवलपमेंट आपको इंटरनेट पर निर्भर हुए बिना संवादात्मक AI का प्रोटोटाइप और टेस्ट करने देता है। यह एज डिप्लॉयमेंट, एयर-गैप्ड एनवायरनमेंट, या जहाँ कनेक्टिविटी अविश्वसनीय हो, वहाँ के लिए परफेक्ट है। आपका बॉट वैसे ही काम करता है, चाहे आप ऑनलाइन हों या 30,000 फीट की ऊँचाई पर उड़ रहे हों।
क्लाउड डिप्लॉयमेंट से पहले मॉडल एक्सपेरिमेंटेशन समय और पैसे बचाता है। आप अलग-अलग मॉडल, प्रॉम्प्ट, और कॉन्फ़िगरेशन लोकली टेस्ट कर सकते हैं, महँगे क्लाउड इनफ़रेंस से पहले। आप परफॉर्मेंस बेंचमार्क कर सकते हैं, पैरामीटर ट्यून कर सकते हैं, और आउटपुट वेलिडेट कर सकते हैं, वह भी API क्रेडिट खर्च किए बिना।
टीमें इस Docker और Ollama सेटअप का उपयोग इन कामों के लिए भी करती हैं:
आपको एंटरप्राइज़-ग्रेड AI क्षमताएँ मिलती हैं, बिना एंटरप्राइज़-ग्रेड बिल के।
Docker में Ollama चलाते समय कुछ बातें हैं जो आपको उलझा सकती हैं।
GPU सपोर्ट के लिए अतिरिक्त सेटअप चाहिए। आधिकारिक Ollama Docker इमेज NVIDIA GPUs को सपोर्ट करती है, लेकिन पहले NVIDIA Container Toolkit इंस्टॉल करना होगा और कंटेनर चलाते समय --gpus all फ़्लैग पास करना होगा:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaइसके बिना, Ollama CPU-केवल मोड पर लौट आता है—जो काम तो करता है, पर काफी धीमा चलता है। यदि आप Apple Silicon MacBook पर हैं, तो यह बात आपको चिंतित नहीं करती।
फ़ाइल परमिशन इश्यूज़ Docker वॉल्यूम के साथ परेशानी खड़ी कर सकते हैं। यदि आप नेम्ड वॉल्यूम की जगह होस्ट डायरेक्टरी माउंट करते हैं, तो परमिशन मिसमैच के कारण Ollama मॉडल फाइलें लिख नहीं पाएगा। -v ollama:/root/.ollama जैसे नेम्ड वॉल्यूम इस समस्या से पूरी तरह बचाते हैं।
रीस्टार्ट्स के बीच मॉडल कैशिंग सही वॉल्यूम माउंटिंग के साथ अपने आप काम करती है। आपके डाउनलोड किए गए मॉडल Docker वॉल्यूम में बने रहते हैं, इसलिए कंटेनर को रोकना-शुरू करना सब कुछ फिर से डाउनलोड करने की ज़रूरत नहीं बनाता। लेकिन यदि आप गलती से वॉल्यूम डिलीट कर देते हैं या -v फ़्लैग भूल जाते हैं, तो आप अपने सभी मॉडल खो देंगे।
इन त्वरित फिक्सेस को याद रखें:
सबसे आम समस्या वॉल्यूम माउंट भूल जाना है और फिर समझना कि मॉडल गायब क्यों हो गए।
Docker स्थानीय LLMs चलाना सरल, पोर्टेबल और साफ बनाता है।
आपको डिज़ाइन से गोपनीयता मिलती है—आपका डेटा आपकी मशीन से बाहर नहीं जाता। आपको पूर्वानुमेय लागत मिलती है—न अप्रत्याशित API बिल, न रेट लिमिटिंग। और आपको पूरा नियंत्रण मिलता है—वेंडर लॉक-इन या इंटरनेट निर्भरता के बिना अपने AI स्टैक पर।
सेटअप में कुछ ही मिनट लगते हैं।
इमेज खींचें, कंटेनर चलाएँ, एक मॉडल डाउनलोड करें, और आप बनाने के लिए तैयार हैं। चाहे आप AI असिस्टेंट का प्रोटोटाइप बना रहे हों, निजी RAG पाइपलाइन्स चला रहे हों, या अलग-अलग मॉडलों के साथ प्रयोग कर रहे हों—यह संयोजन आपके लैपटॉप पर एंटरप्राइज़-ग्रेड क्षमताएँ देता है।
अभी आज़माएँ। अपने हार्डवेयर के अनुरूप एक मॉडल चुनें, Ollama कंटेनर स्पिन-अप करें, और कुछ बनाना शुरू करें। एंट्री की बाधा मौजूद ही नहीं है।
अगले कदम के रूप में, हम सलाह देते हैं कि आप DeepSeek R1 को Ollama के साथ स्थानीय रूप से सेटअप और रन करें।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
लर्निंग पाथ