Curso
Docker Intermediário
4 h
10.3K
A maioria dos desenvolvedores quer testar LLMs locais, mas não sabe por onde começar.
A popularização de modelos open source como Llama e Mistral deixou a IA local mais acessível do que nunca. Você não precisa gastar nada com OpenAI ou Anthropic, nem se preocupar em enviar seus dados para terceiros. O problema é que muitos tutoriais de instalação envolvem gerenciar ambientes Python, drivers CUDA e dependências que costumam quebrar quando você muda de máquina.
O Ollama resolve isso oferecendo uma forma direta de rodar LLMs locais com configuração mínima. Em conjunto com Docker, você tem uma solução limpa e portátil que funciona do mesmo jeito em diferentes sistemas.
Neste guia, vou mostrar como configurar o Ollama no Docker, baixar seu primeiro modelo e começar a rodar LLMs locais acessíveis por qualquer aplicação.
Se você é totalmente novo em Docker, recomendamos se inscrever no nosso curso Introduction to Docker para entender os fundamentos.
Pense no Ollama como a forma mais simples de rodar modelos de linguagem de grande porte no seu próprio hardware.
Ele é um runtime leve que faz todo o trabalho pesado para LLMs locais. Você não precisa gerenciar ambientes Python, instalar drivers CUDA manualmente ou decifrar pesos de modelos e tokenizers. O Ollama cuida de baixar, carregar e servir modelos como LLaMA, Mistral e Gemma com um único comando.
Privacidade desde a origem. Suas conversas nunca saem da sua máquina. Sem chaves de API, sem rastreamento de uso, sem dados enviados a servidores externos. É perfeito para trabalhos sensíveis em que você não pode correr o risco de expor código proprietário ou informações pessoais a serviços de terceiros.
A ferramenta foi pensada primeiro para desenvolvedores. Roda nativamente em macOS e Linux, oferece uma REST API simples para integração e agora funciona dentro de contêineres Docker. Isso significa que você pode usar a mesma configuração local no desenvolvimento e implantar em qualquer lugar que rode Docker.
Você tem um servidor de LLM pronto para produção que inicia com um comando e funciona offline.
O Ollama não é o único runtime de LLM — experimente n8n e Qdrant.
A resposta é simples — você aproveita tudo do Ollama mantendo seu sistema limpo.
Rodar o Ollama diretamente na máquina funciona bem — ele vem com instalador empacotado (.exe para Windows, .dmg para Mac) que cuida de tudo. Mas o Docker traz uma vantagem-chave: isolamento.
Com Docker, o Ollama roda em seu próprio contêiner. Isso mantém o host limpo. Sem rastros de instalação no sistema principal, sem arquivos sobrando quando você terminar os testes e remoção fácil ao trocar de versão ou fazer limpeza geral.
A mesma configuração funciona para todo mundo no seu time graças à reprodutibilidade. Compartilhe um comando Docker e qualquer pessoa pode rodar exatamente o mesmo ambiente do Ollama, esteja no macOS, Linux ou Windows.
A implantação fica simples com suporte multiplataforma. O mesmo contêiner que roda no seu notebook funciona em um servidor na nuvem, pipeline de CI ou na máquina do colega sem alterações.
Você sobe o Ollama em segundos e remove tudo na mesma velocidade com uma configuração e limpeza simplificadas. Sem scripts de desinstalação, sem caçar arquivos de configuração, sem varredura no sistema.
Isso torna o Docker perfeito para:
Em resumo, você tem todos os benefícios dos LLMs locais sem as dores de configuração.
Buscando mais recursos práticos de Docker? Estas 12 imagens de contêiner Docker para machine learning e IA vão acelerar sua jornada.
Você precisa de exatamente três comandos para rodar o Ollama no Docker.
Primeiro, faça o pull da imagem oficial do Ollama no Docker Hub:
docker pull ollama/ollama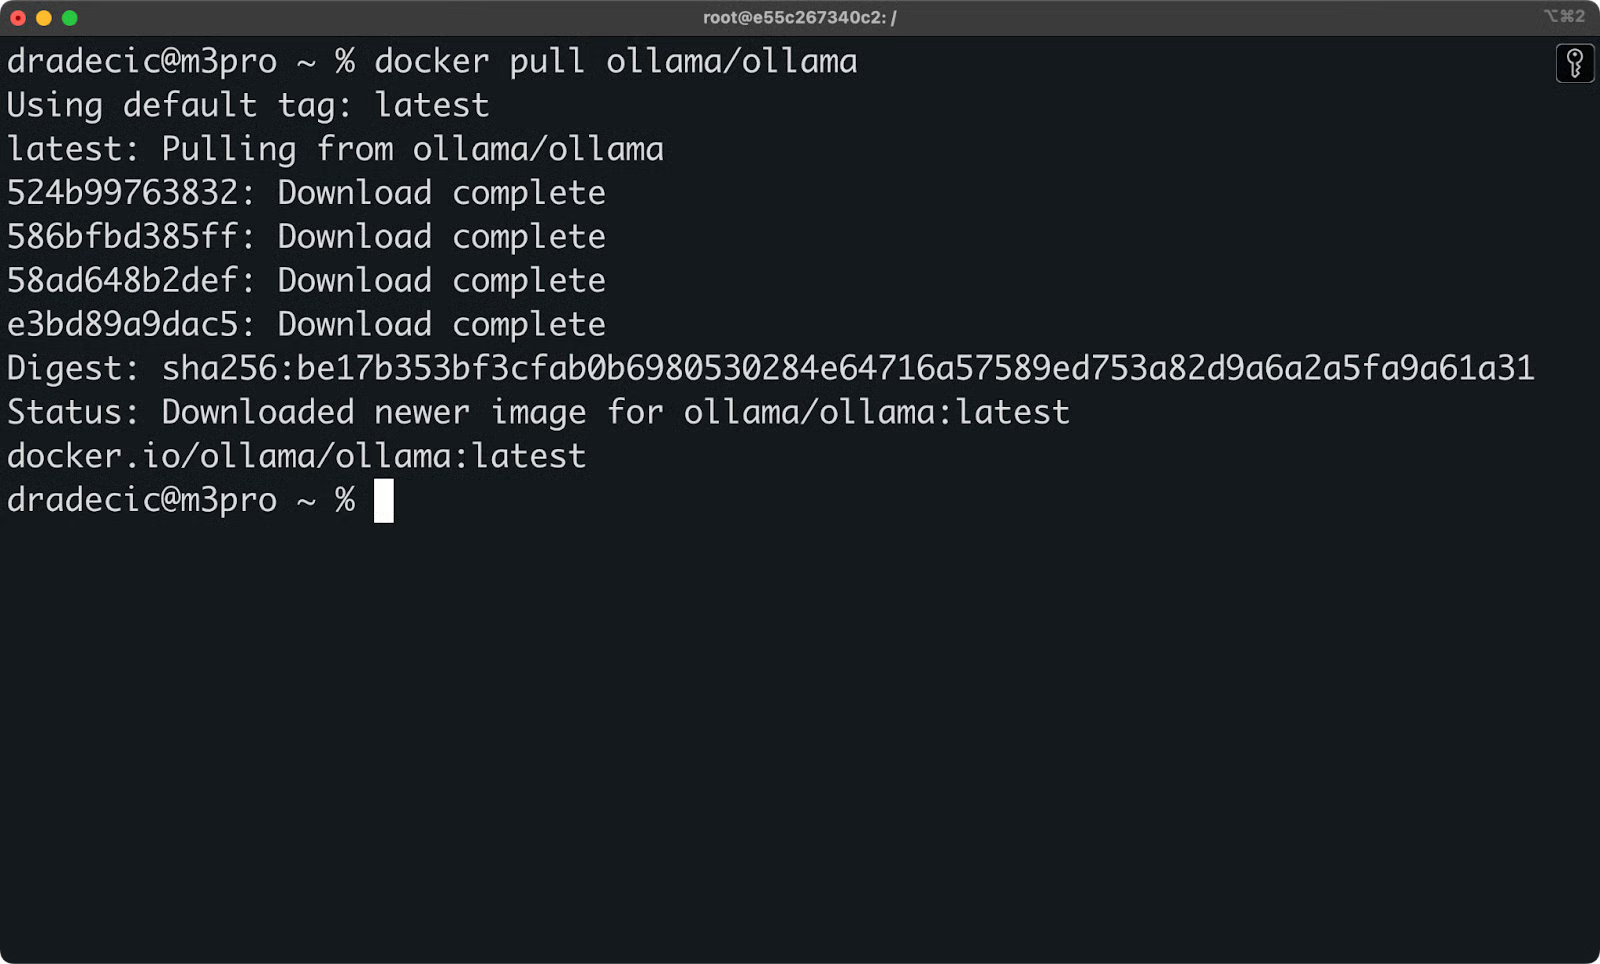
Fazendo pull da imagem do ollama
Em seguida, rode o contêiner com as portas e volumes corretos:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama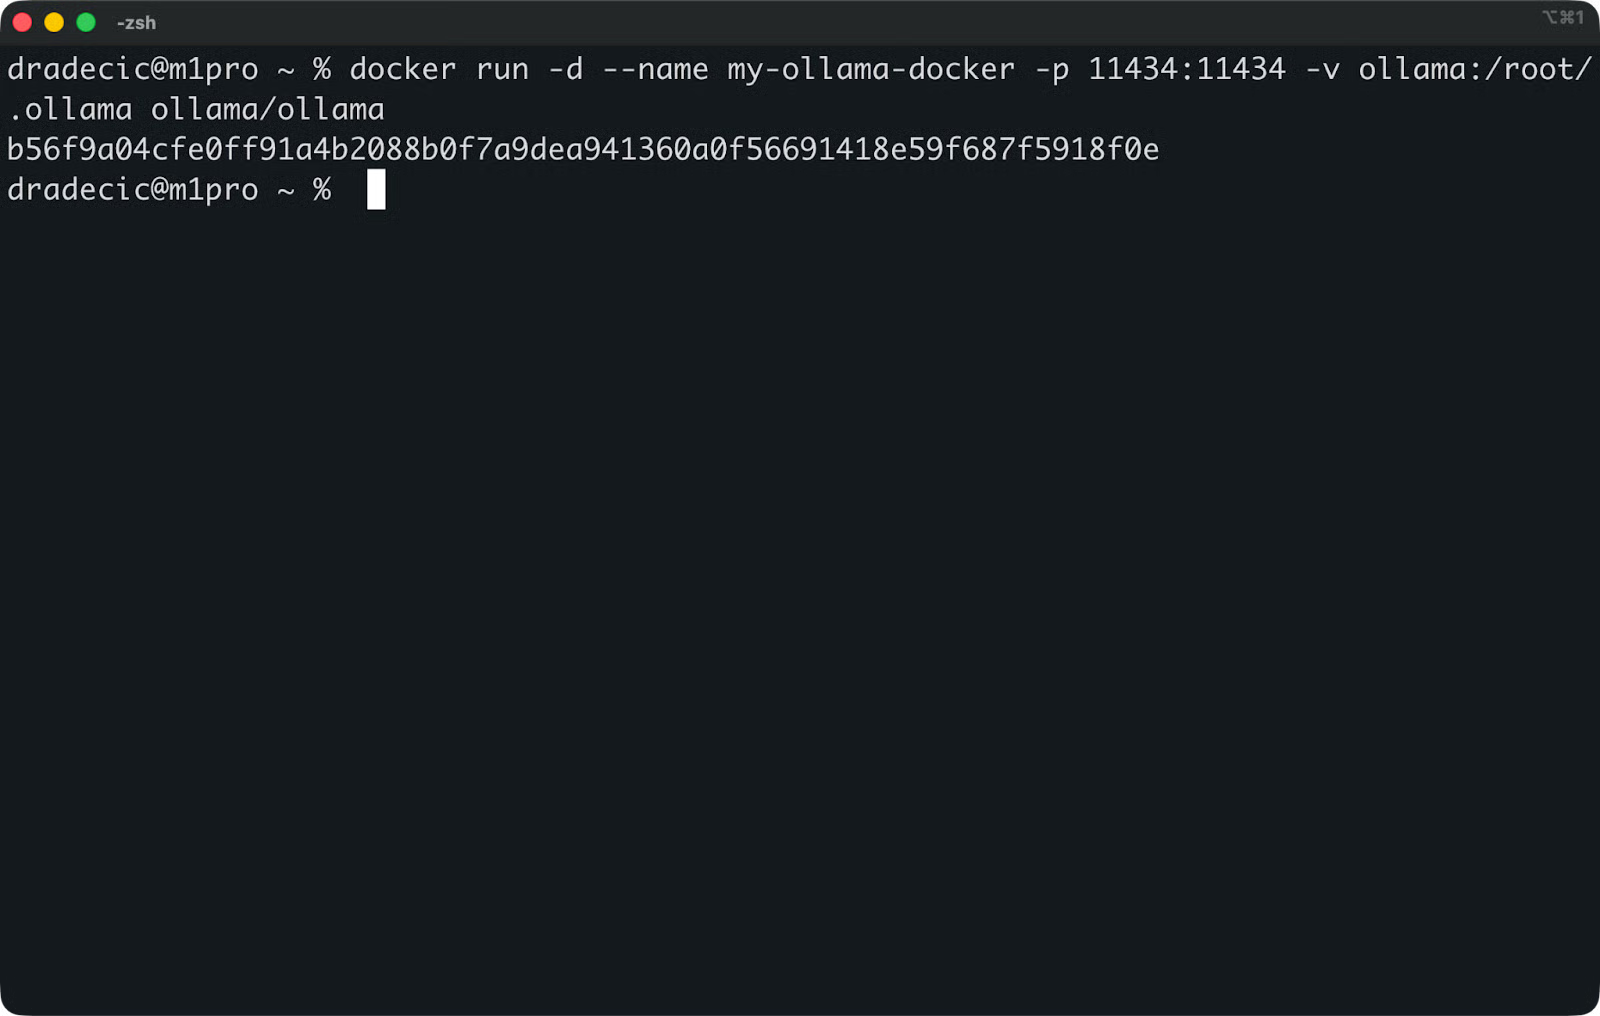
Rodando o ollama
Veja o que cada flag faz:
-d roda o contêiner em background--name my-ollama.docker dá um nome amigável ao contêiner-p 11434:11434 mapeia a porta padrão do Ollama para o host-v ollama:/root/.ollama cria um volume persistente para os modelos baixadosO contêiner inicia imediatamente e começa a escutar em http://localhost:11434.
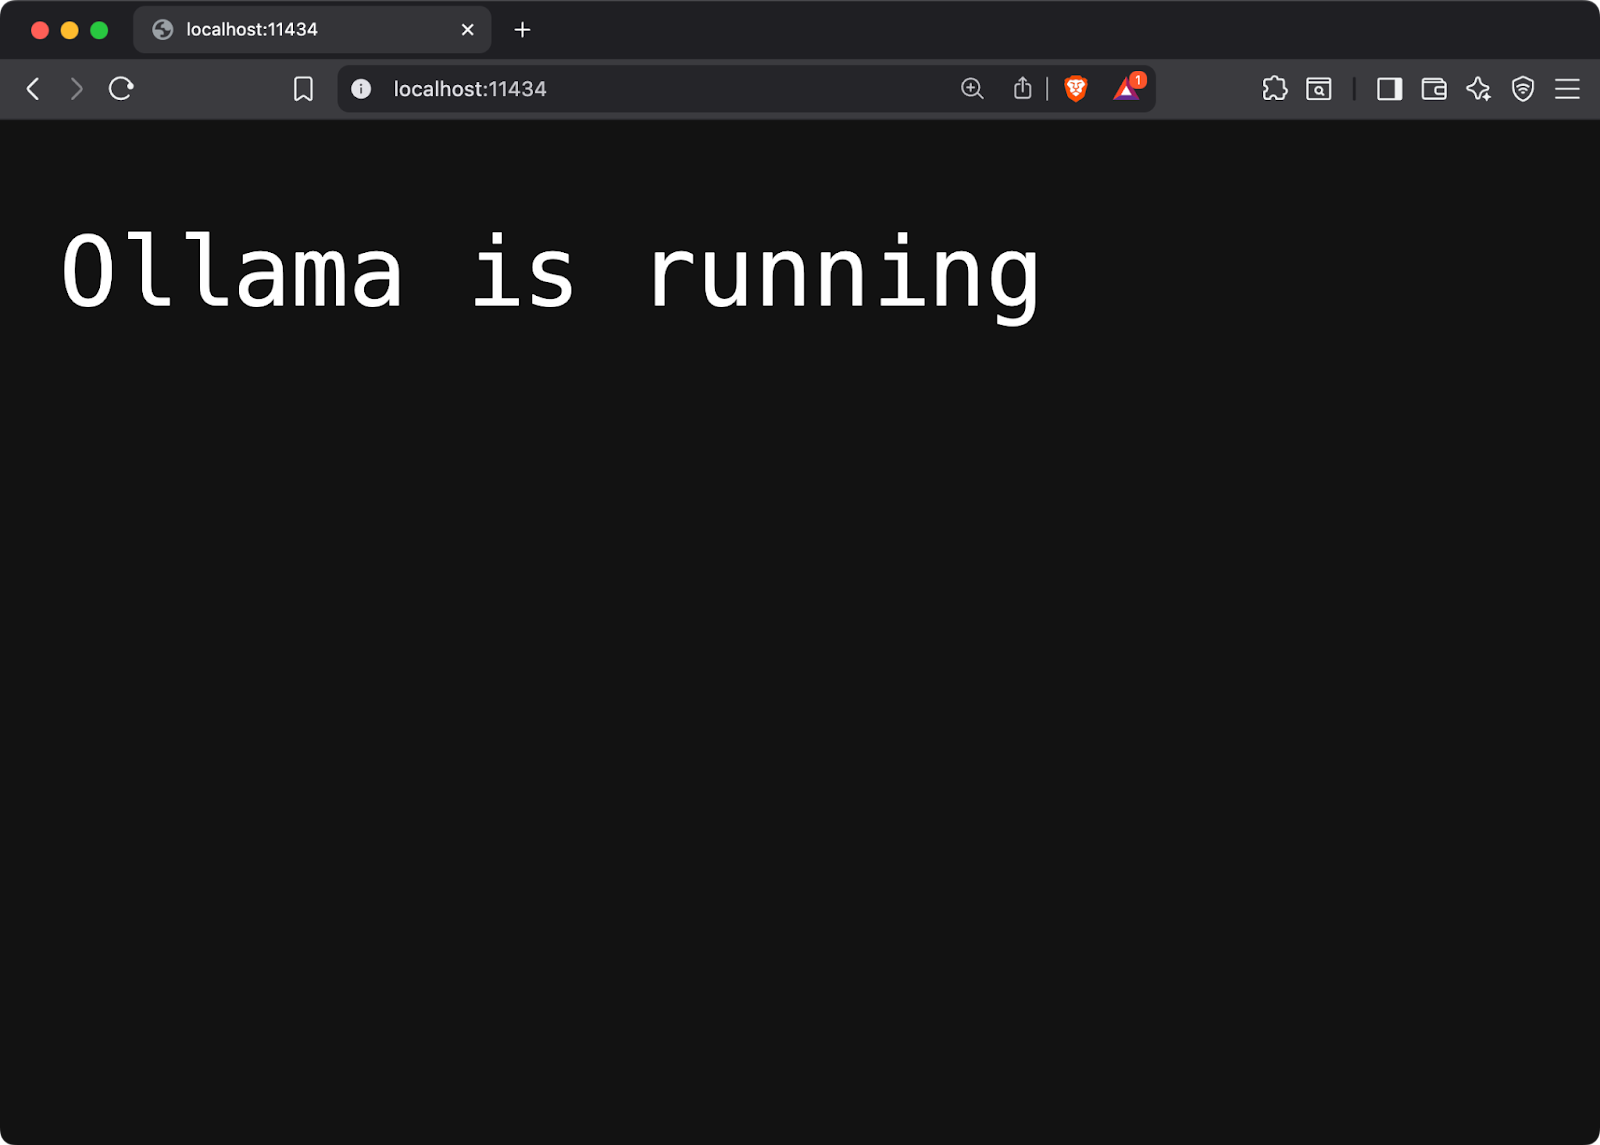
Ollama rodando localmente
Agora baixe um modelo para testar se está tudo certo:
docker exec -it my-ollama-docker ollama pull llama3.1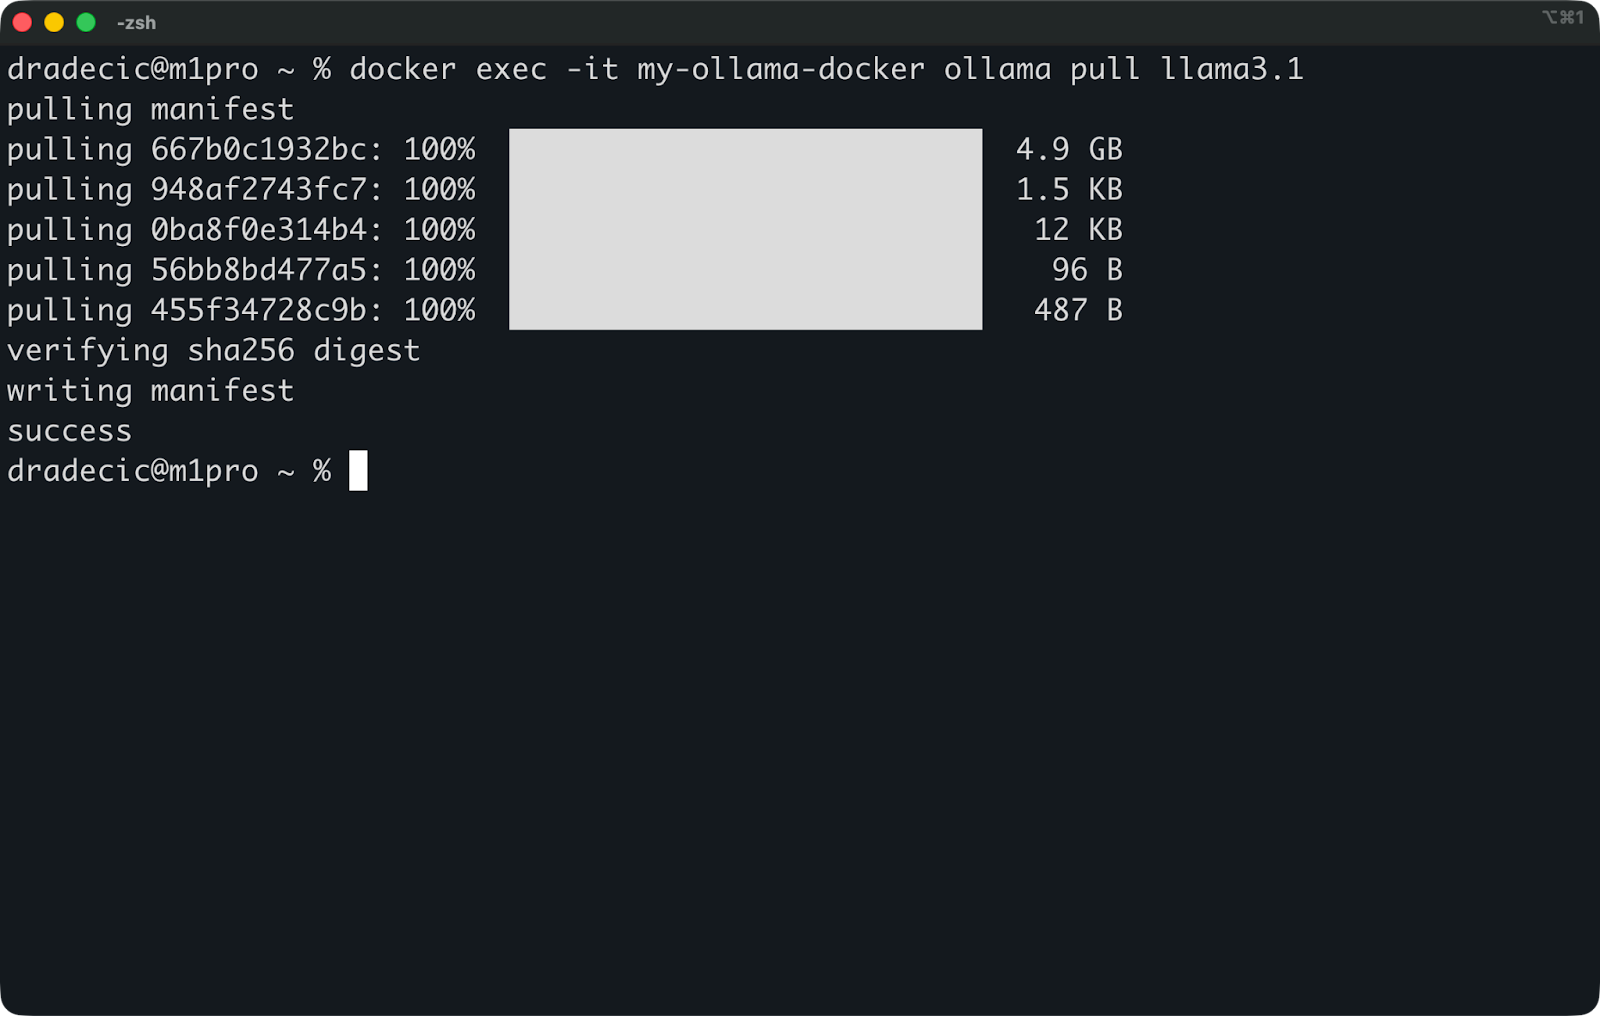
Fazendo pull do modelo Llama3.1
Isso baixa o modelo Llama 3.1 8B dentro do seu contêiner. O modelo tem cerca de 5 GB, então o download pode levar alguns minutos.
Você pode verificar a configuração listando os modelos disponíveis:
docker exec -it my-ollama-docker ollama list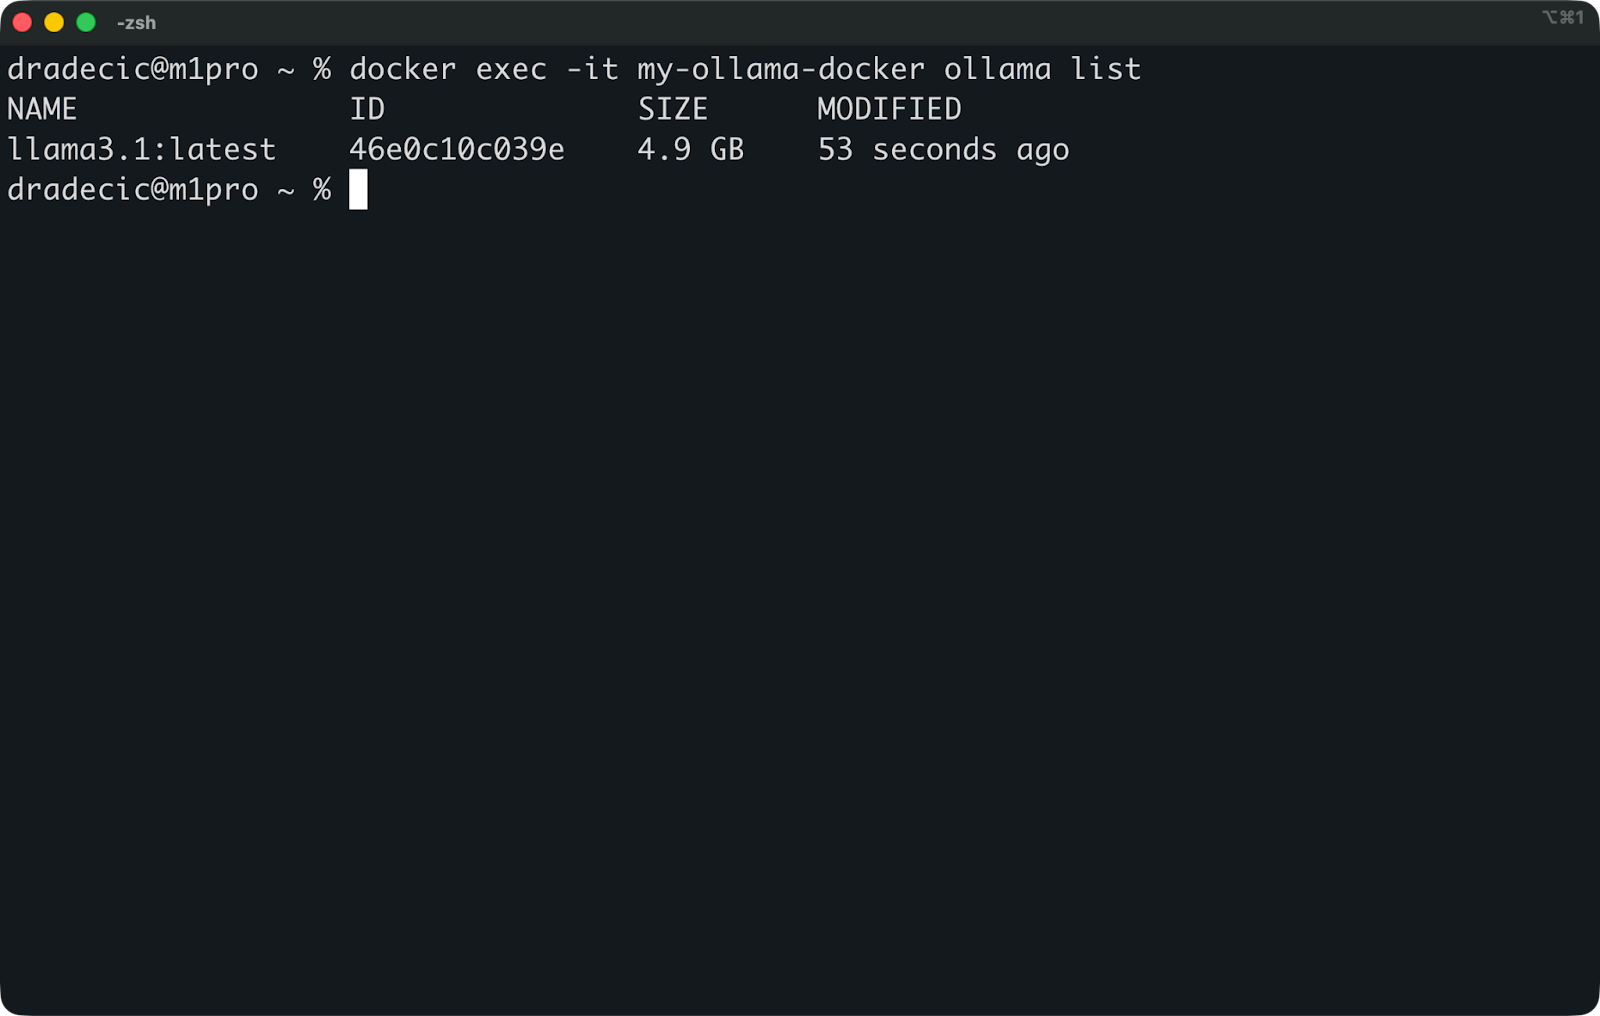
Listando os modelos disponíveis
O mapeamento do volume é essencial. Sem ele, você perde todos os modelos baixados quando o contêiner para. O volume ollama:/root/.ollama mantém seus modelos entre reinicializações e atualizações do contêiner.
Para ambientes de produção, pode ser interessante criar imagens personalizadas com modelos pré-carregados. Crie um Dockerfile que baixe os modelos durante o build:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
Isso incorpora o modelo na imagem, então os novos contêineres já iniciam prontos para uso.
Com o contêiner rodando, o Ollama funciona como qualquer REST API.
O serviço escuta em http://localhost:11434 e aceita requisições HTTP padrão. Você não precisa de clientes especiais ou SDKs — basta enviar JSON e receber a resposta.
Veja como gerar texto com um simples comando curl:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'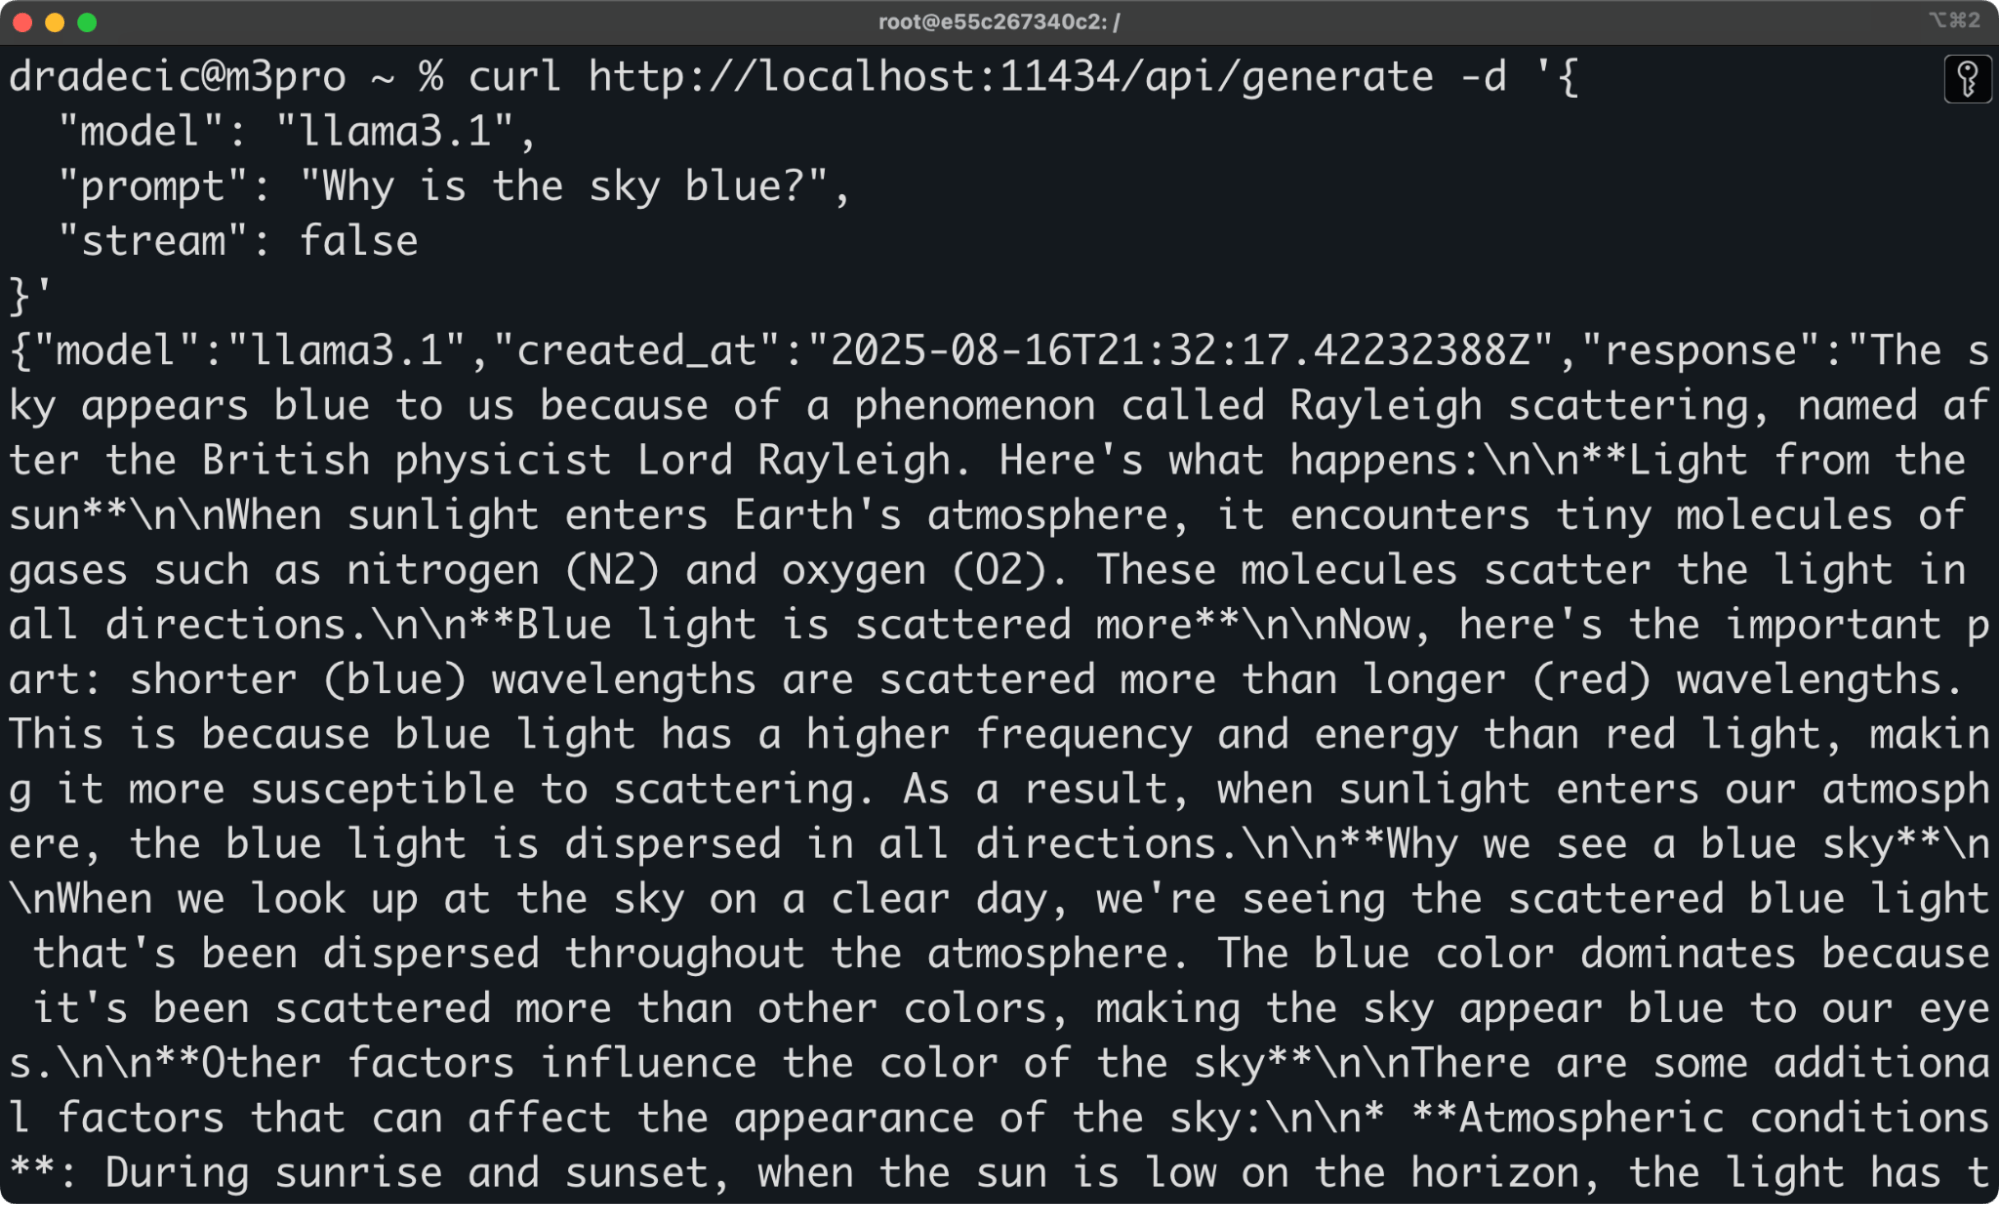
Acessando o ollama com curl
A API retorna um JSON com o texto gerado. Defina "stream": false para receber a resposta completa de uma vez, ou "stream": true para receber tokens conforme são gerados.
Integração com Python é tão simples quanto:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])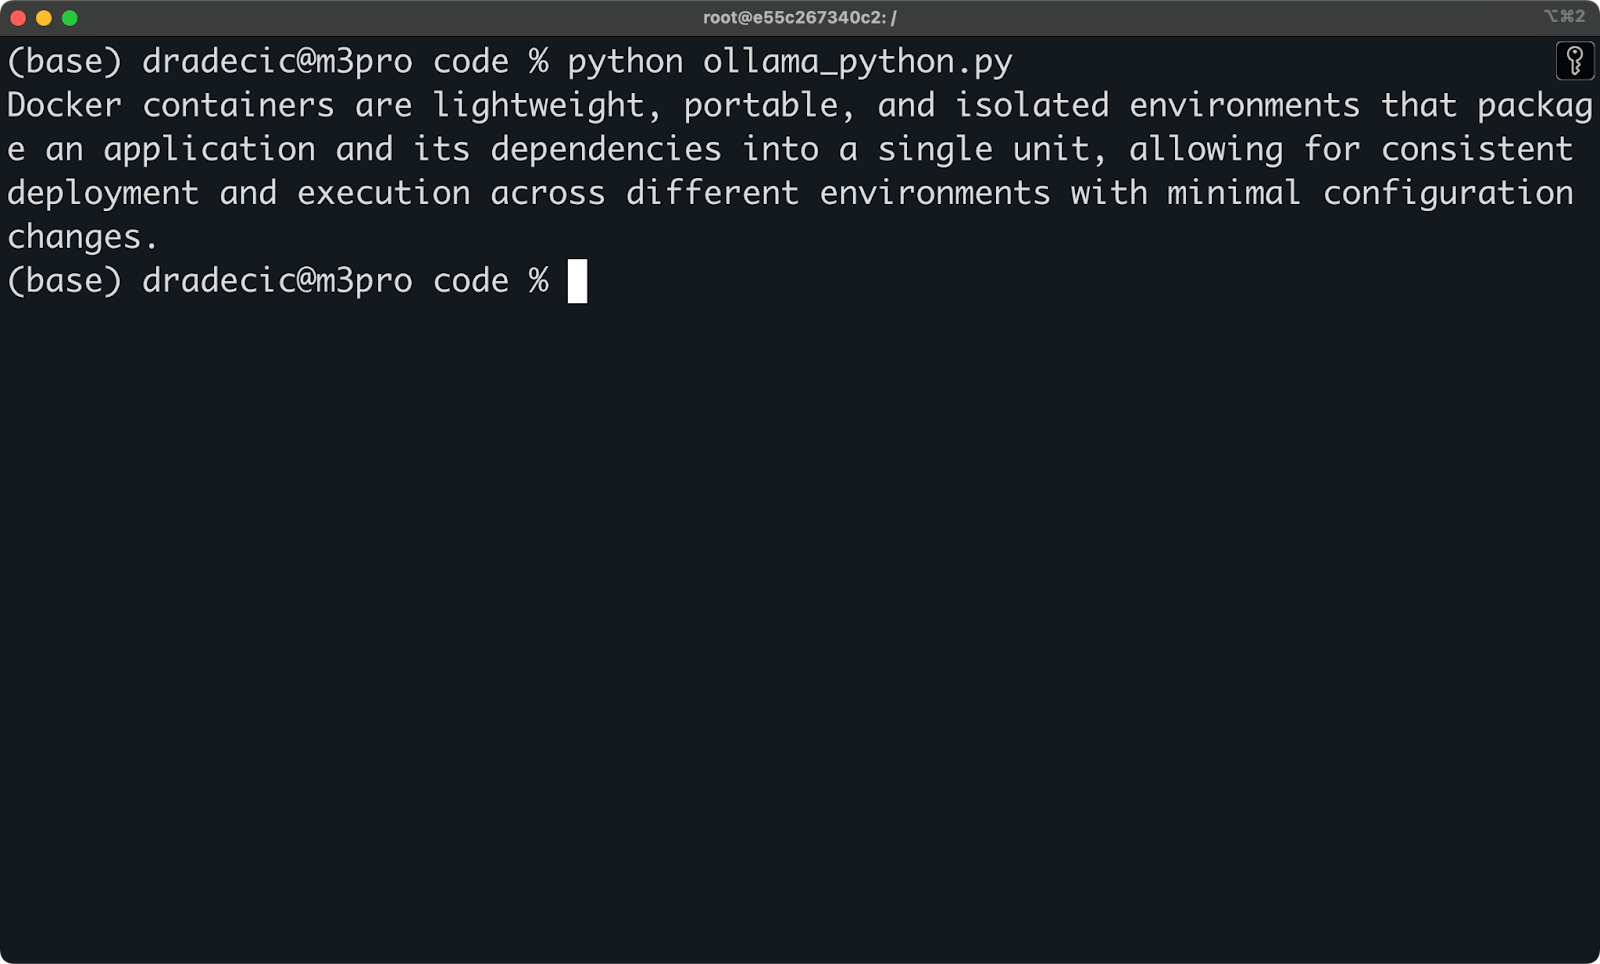
Acessando o ollama com Python
Isso torna o Ollama perfeito como backend para aplicações locais. Você pode construir interfaces de chat, ferramentas de autocompletar código ou sistemas de análise de documentos que conversam com seu LLM em contêiner, sem enviar dados para serviços externos.
Para fluxos mais complexos, a integração com LangChain funciona prontinha:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)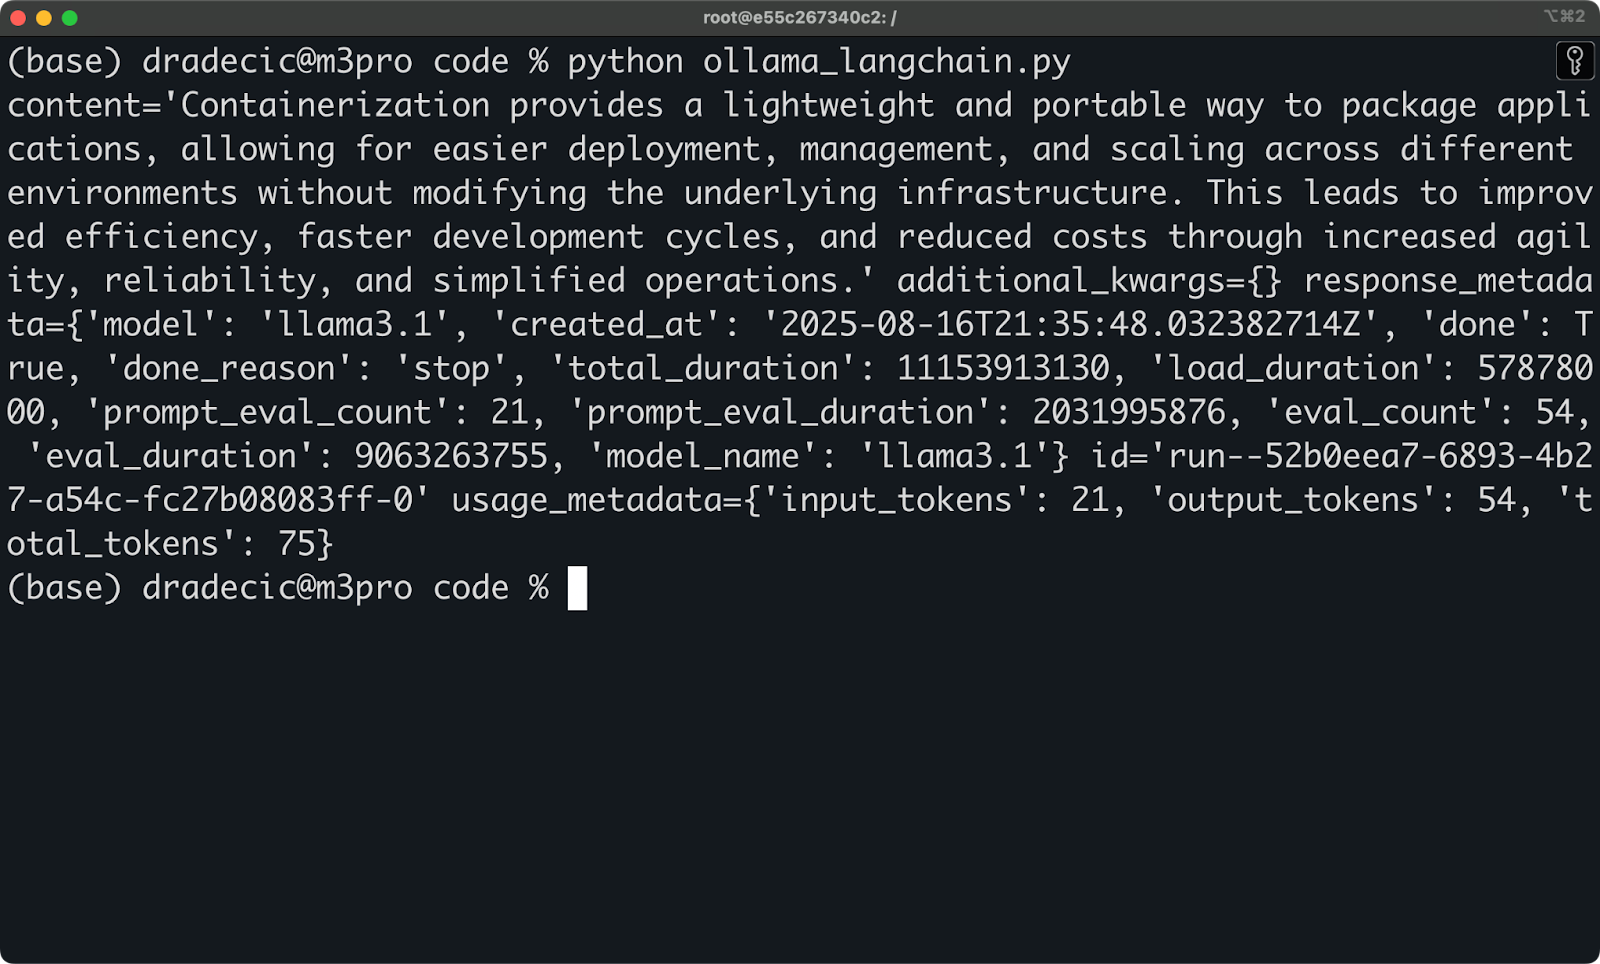
Acessando o ollama com LangChain
Você tem todo o poder dos LLMs locais com a simplicidade de requisições HTTP.
Já se perguntou como aplicações de LLM são implantadas? Leia nosso passo a passo sobre implantação de aplicações LLM usando Docker.
LLMs locais exigem hardware robusto para performar bem, e o Docker adiciona sua própria sobrecarga.
CPU vs. GPU faz muita diferença. O Ollama pode rodar só em CPU, mas a inferência será lenta — espere 30+ segundos para respostas simples. Com uma GPU moderna, a mesma consulta termina em menos de 5 segundos. GPUs NVIDIA entregam os melhores resultados, mas Macs com Apple Silicon também performam bem e podem ter melhor custo-benefício.
A necessidade de RAM escala com o tamanho do modelo. Modelos menores como Llama3.1 8B precisam de pelo menos 8 GB de RAM do sistema, enquanto versões maiores, de 70B, exigem 64 GB ou mais. O modelo fica carregado na memória durante o uso, então não dá para rodar um 13B em uma máquina com 8 GB de RAM.
Espaço em disco cresce rápido. Cada modelo consome gigabytes de armazenamento:
Várias versões e quantizações multiplicam rapidamente a necessidade de armazenamento. Se faltar espaço, você pode mover os modelos para um drive externo.
A sobrecarga do contêiner é mínima para computação, mas impacta o armazenamento. A imagem base do Ollama tem menos de 1 GB, mas os modelos persistem em volumes Docker. Se você criar imagens personalizadas com modelos pré-carregados, espere que cada imagem fique alguns gigabytes maior que a base.
Já a alocação de memória no Docker provavelmente vai exigir atenção. Por padrão, o Docker Desktop limita a memória dos contêineres. Para modelos maiores, aumente esses limites ou use a flag --memory ao executar os contêineres.
O gargalo de hardware normalmente é a RAM, não a CPU ou a velocidade do disco.
Docker + Ollama entrega recursos de IA que mantêm seus dados privados e deixam o custo de inferência de LLM exatamente em US$ 0 (sem contar eletricidade e manutenção).
Assistentes de IA locais são onde essa combinação brilha. Você cria ferramentas de autocompletar código, geradores de documentação ou assistentes de escrita que rodam totalmente na sua máquina. Sem custos de API, sem limites de taxa, sem dados saindo da sua rede. Basta apontar seu editor ou IDE para localhost:11434 e começar a construir.
Pipelines privados de RAG também ficam muito mais fáceis de implantar.
Você pode carregar documentos da sua empresa em um banco vetorial e usar o Ollama para responder perguntas sobre eles. Toda a base de conhecimento permanece interna, o que é essencial para informações legais, financeiras ou proprietárias que não podem passar por APIs externas.
Desenvolvimento de chatbots offline permite prototipar e testar IA conversacional sem depender de internet. É perfeito para borda, ambientes isolados ou cenários com conectividade instável. Seu bot funciona do mesmo jeito esteja você online ou a 10 mil metros de altitude.
Experimentação de modelos antes da nuvem economiza tempo e dinheiro. Você testa modelos, prompts e configurações localmente antes de se comprometer com inferência em nuvem. Dá para medir performance, ajustar parâmetros e validar saídas sem torrar créditos de API.
Times também usam essa configuração com Docker e Ollama para:
Você alcança recursos de IA nível enterprise sem a conta nível enterprise.
Existem alguns detalhes que podem te atrapalhar ao rodar o Ollama no Docker.
Suporte a GPU exige configuração extra. A imagem oficial do Ollama no Docker suporta GPUs NVIDIA, mas você precisa instalar o NVIDIA Container Toolkit antes e passar a flag --gpus all ao rodar o contêiner:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaSem isso, o Ollama cai no modo somente CPU, que funciona, mas é bem mais lento. Se você usa MacBook com Apple Silicon, isso não é um problema.
Problemas de permissão de arquivos podem causar dor de cabeça com volumes Docker. Se você montar um diretório do host em vez de usar um volume nomeado, o Ollama pode não conseguir gravar os arquivos de modelo por incompatibilidade de permissões. Volumes nomeados como -v ollama:/root/.ollama evitam completamente esse problema.
Cache de modelos entre reinícios funciona automaticamente com o volume correto. Seus modelos baixados persistem no volume Docker, então parar e iniciar contêineres não exige baixar tudo de novo. Mas, se você apagar o volume por engano ou esquecer a flag -v, vai perder todos os modelos.
Lembre destes ajustes rápidos:
O erro mais comum é esquecer de montar o volume e depois se perguntar por que os modelos sumiram.
O Docker deixa os LLMs locais simples, portáteis e limpos.
Você tem privacidade por design, seus dados nunca saem da sua máquina. Você tem custos previsíveis, sem sustos na fatura de API ou limites de uso. E você tem controle total sobre sua stack de IA, sem vendor lock-in ou dependência de internet.
A configuração leva poucos minutos.
Faça o pull da imagem, rode o contêiner, baixe um modelo e comece a construir. Não importa se você está prototipando um assistente de IA, rodando pipelines de RAG privados ou só experimentando modelos diferentes — essa combinação entrega recursos nível enterprise no seu notebook.
Teste agora. Escolha um modelo compatível com seu hardware, suba o contêiner do Ollama e comece a construir. A barreira de entrada simplesmente não existe.
Como próximo passo, recomendamos configurar e rodar o DeepSeek R1 localmente com o Ollama.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Abid Ali Awan
8 min
Tutorial
Ryan Ong
12 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
11 min
Tutorial
Zoumana Keita
8 min