
Corso
Docker intermedio
4 ore
10.3K
La maggior parte degli sviluppatori vuole provare gli LLM locali, ma non sa da dove iniziare.
L’ascesa di modelli open-source come Llama e Mistral ha reso l’AI locale più accessibile che mai. Non devi spendere un centesimo con OpenAI o Anthropic né preoccuparti di inviare i tuoi dati a terze parti. La difficoltà è che molte guide di setup prevedono la gestione di ambienti Python, driver CUDA e dipendenze che spesso si rompono quando ti sposti tra macchine diverse.
Ollama risolve il problema offrendo un modo semplice per eseguire LLM locali con un setup minimo. Se lo abbini a Docker, ottieni una soluzione pulita e portabile che funziona allo stesso modo su sistemi diversi.
In questa guida, ti mostro come configurare Ollama in Docker, scaricare il tuo primo modello e iniziare a eseguire LLM locali accessibili da qualsiasi applicazione.
Se sei completamente nuovo a Docker, ti consigliamo di iscriverti al nostro corso Introduction to Docker per apprendere le basi.
Pensa a Ollama come al modo più semplice per eseguire modelli linguistici di grandi dimensioni sull’hardware che già possiedi.
È un runtime leggero che si occupa di tutto il lavoro pesante per gli LLM locali. Non devi gestire ambienti Python, installare manualmente i driver CUDA o capire pesi dei modelli e tokenizer. Ollama si occupa di scaricare, caricare e servire modelli come LLaMA, Mistral e Gemma con un singolo comando.
La privacy è integrata. Le tue conversazioni non lasciano mai la tua macchina. Niente chiavi API, niente tracciamento d’uso, niente dati inviati a server esterni. È perfetto per lavori sensibili in cui non puoi rischiare di esporre codice proprietario o informazioni personali a servizi di terze parti.
Lo strumento è stato progettato innanzitutto per gli sviluppatori. Gira nativamente su macOS e Linux, offre una semplice API REST per l’integrazione e ora funziona anche dentro container Docker. Significa che puoi usare lo stesso setup in locale durante lo sviluppo e distribuirlo ovunque giri Docker.
Ottieni un server LLM pronto per la produzione che parte con un comando e funziona offline.
Ollama non è l’unico runtime per LLM: prova anche n8n e Qdrant.
La risposta è semplice: ottieni tutti i vantaggi di Ollama mantenendo il sistema pulito.
Eseguire Ollama direttamente sulla tua macchina va benissimo: è fornito come installer pacchettizzato (.exe per Windows, .dmg per Mac) che gestisce tutto per te. Ma Docker offre un vantaggio chiave: l’isolamento.
Con Docker, Ollama gira nel proprio container. Questo mantiene pulito l’host. Nessuna traccia d’installazione sul sistema principale, nessun file residuo quando hai finito di testare e rimozione facile quando vuoi cambiare versione o ripulire completamente.
Lo stesso setup funziona per tutti nel tuo team grazie alla riproducibilità. Condividi un comando Docker e chiunque può eseguire esattamente lo stesso ambiente Ollama, a prescindere che usi macOS, Linux o Windows.
Il deploy diventa semplice grazie al supporto cross-platform. Lo stesso container che gira sul tuo laptop funzionerà su un server cloud, in una pipeline CI o sulla macchina di un collega senza modifiche.
Puoi avviare Ollama in pochi secondi e rimuoverlo altrettanto in fretta con un setup e teardown semplificati. Niente script di disinstallazione, niente caccia ai file di configurazione, niente pulizia di sistema.
Questo rende Docker perfetto per:
In breve, ottieni tutti i vantaggi degli LLM locali senza i mal di testa del setup.
Cerchi risorse Docker pratiche? Queste 12 immagini di container Docker per machine learning e AI ti aiuteranno a iniziare.
Ti serviranno esattamente tre comandi per eseguire Ollama in Docker.
Per prima cosa, scarica l’immagine ufficiale di Ollama da Docker Hub:
docker pull ollama/ollama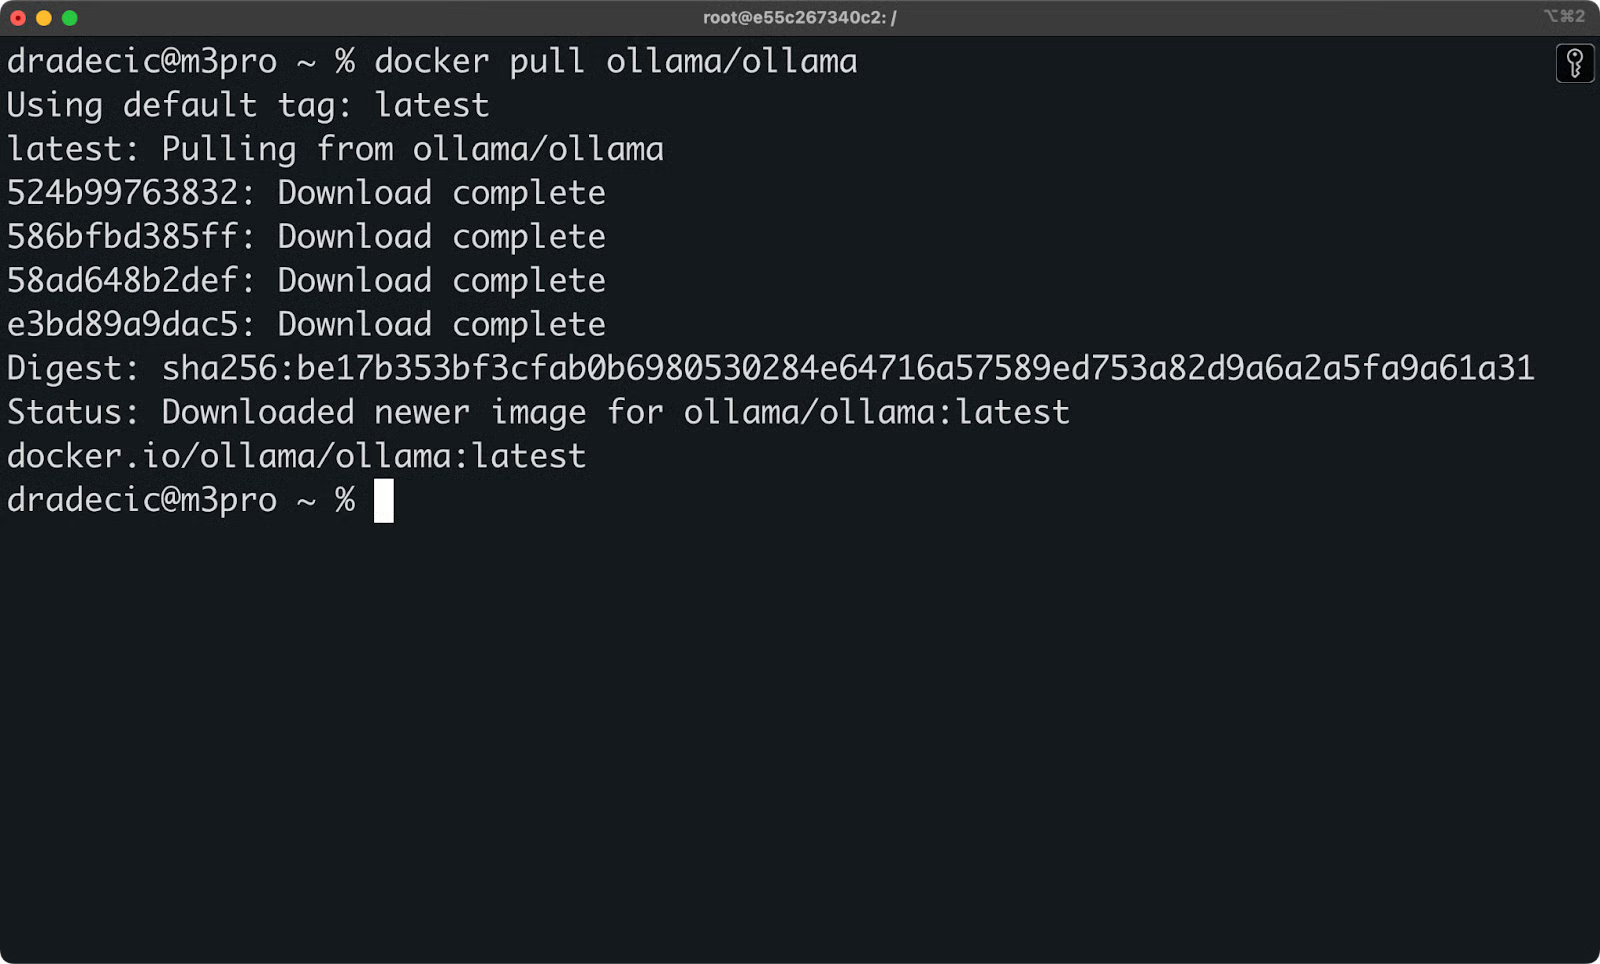
Download dell’immagine di Ollama
Poi avvia il container con il mapping corretto di porte e volumi:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama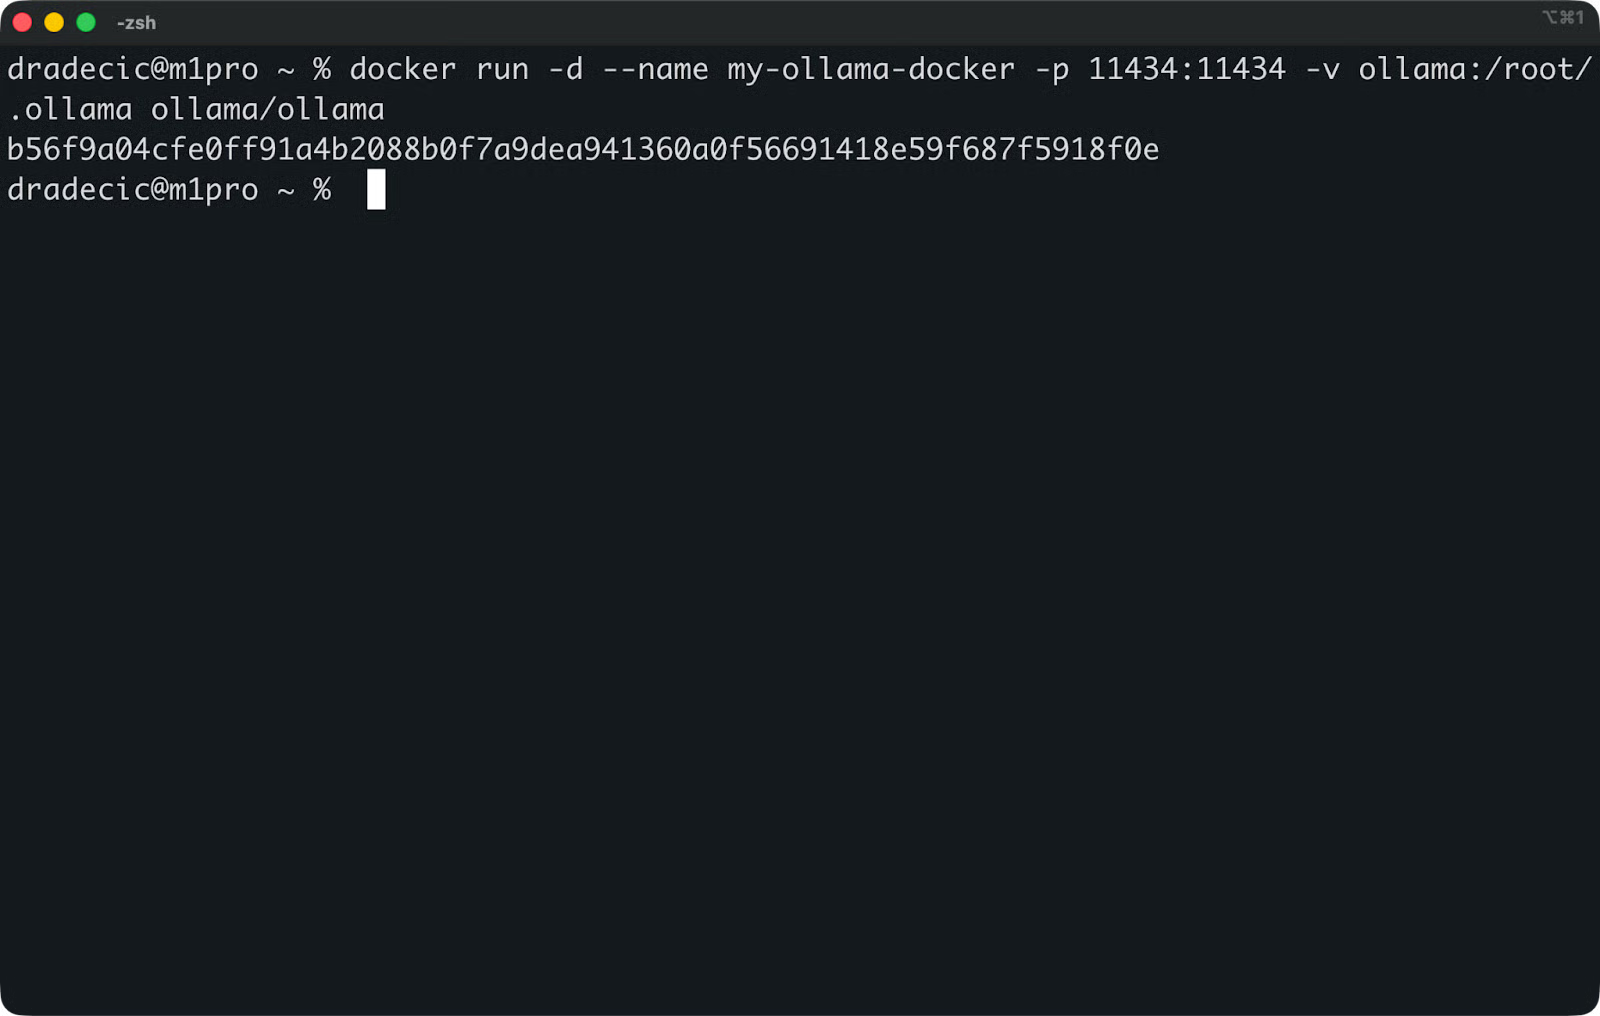
Esecuzione di Ollama
Ecco cosa fa ogni flag:
-d esegue il container in background--name my-ollama.docker assegna un nome facile da ricordare al container-p 11434:11434 mappa la porta predefinita di Ollama sulla tua macchina host-v ollama:/root/.ollama crea un volume persistente per i modelli scaricatiIl container parte subito e inizia ad ascoltare su http://localhost:11434.
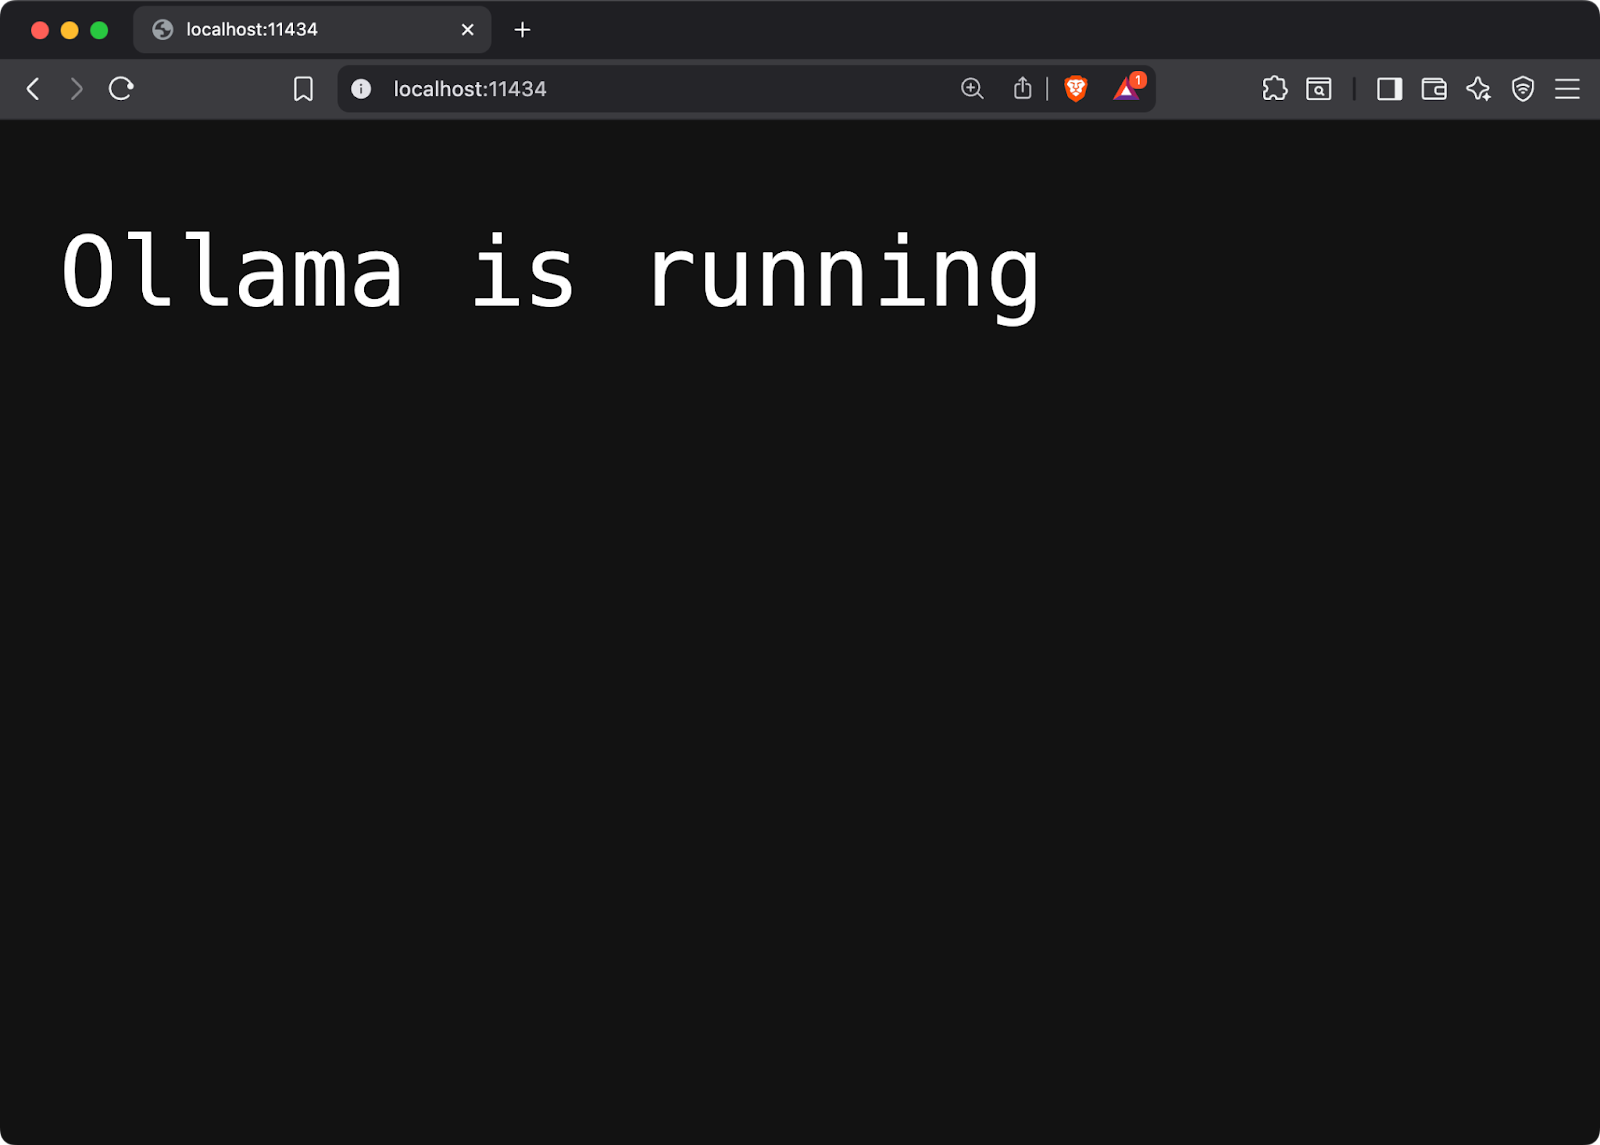
Ollama in esecuzione in locale
Ora scarica un modello per verificare che tutto funzioni:
docker exec -it my-ollama-docker ollama pull llama3.1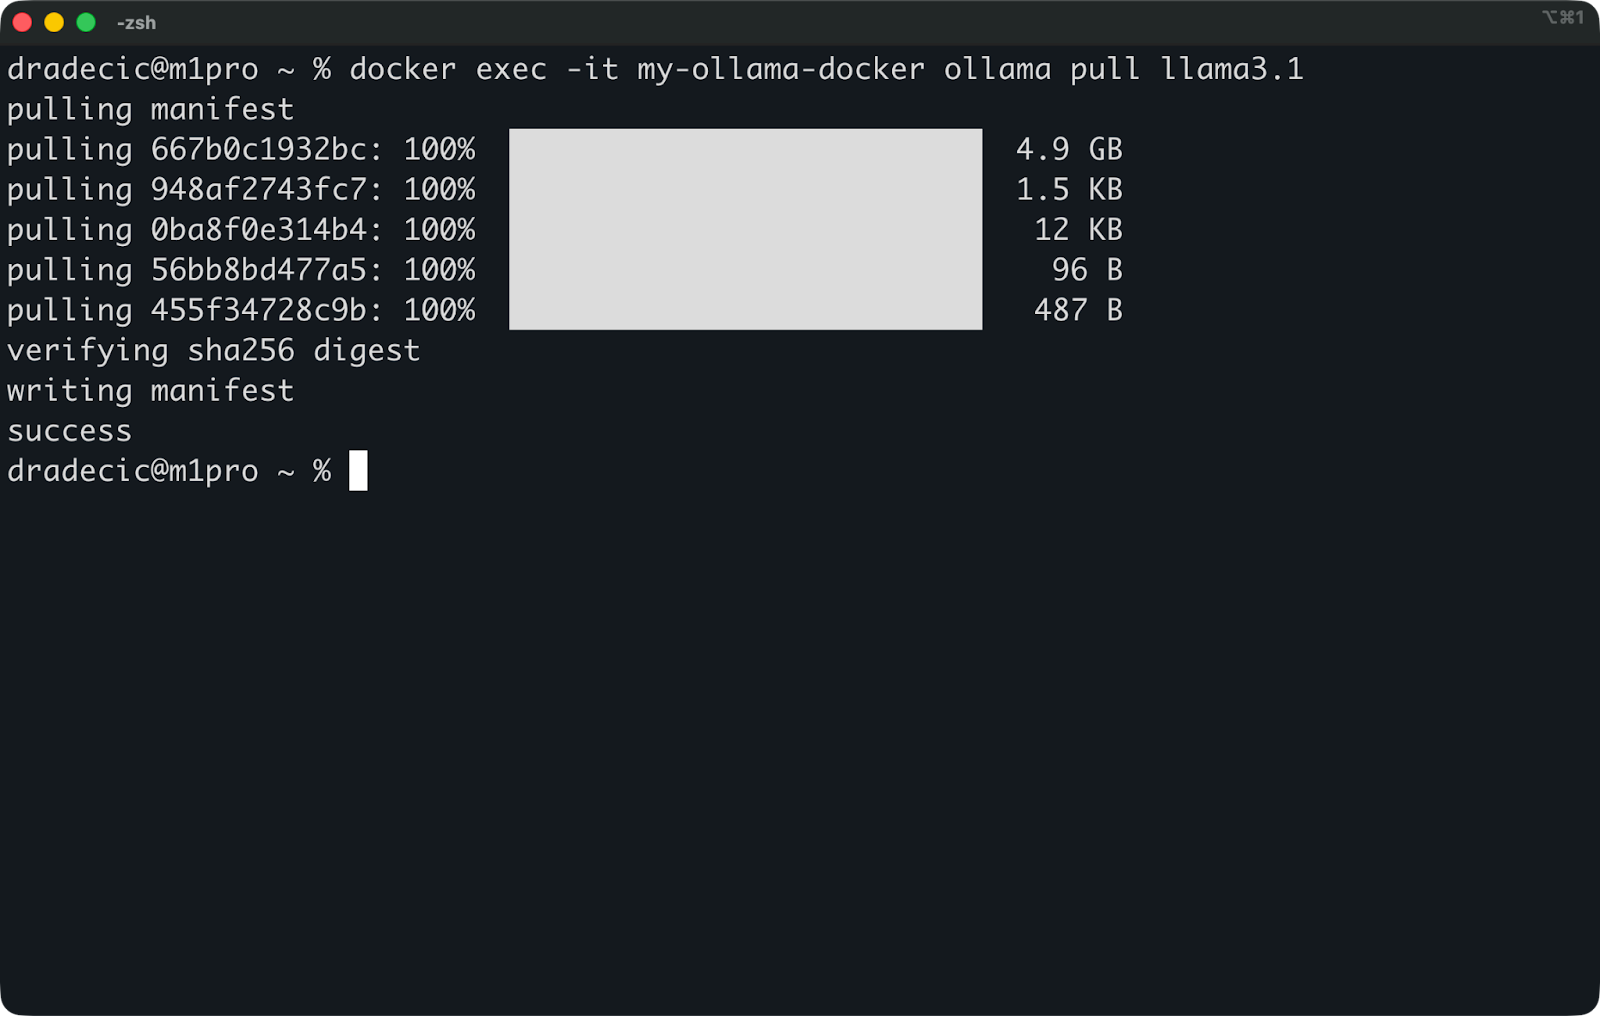
Download del modello Llama3.1
Questo scarica il modello Llama 3.1 8b dentro il container. Il modello è di circa 5 GB, quindi il download potrebbe richiedere un paio di minuti.
Puoi verificare il setup elencando i modelli disponibili:
docker exec -it my-ollama-docker ollama list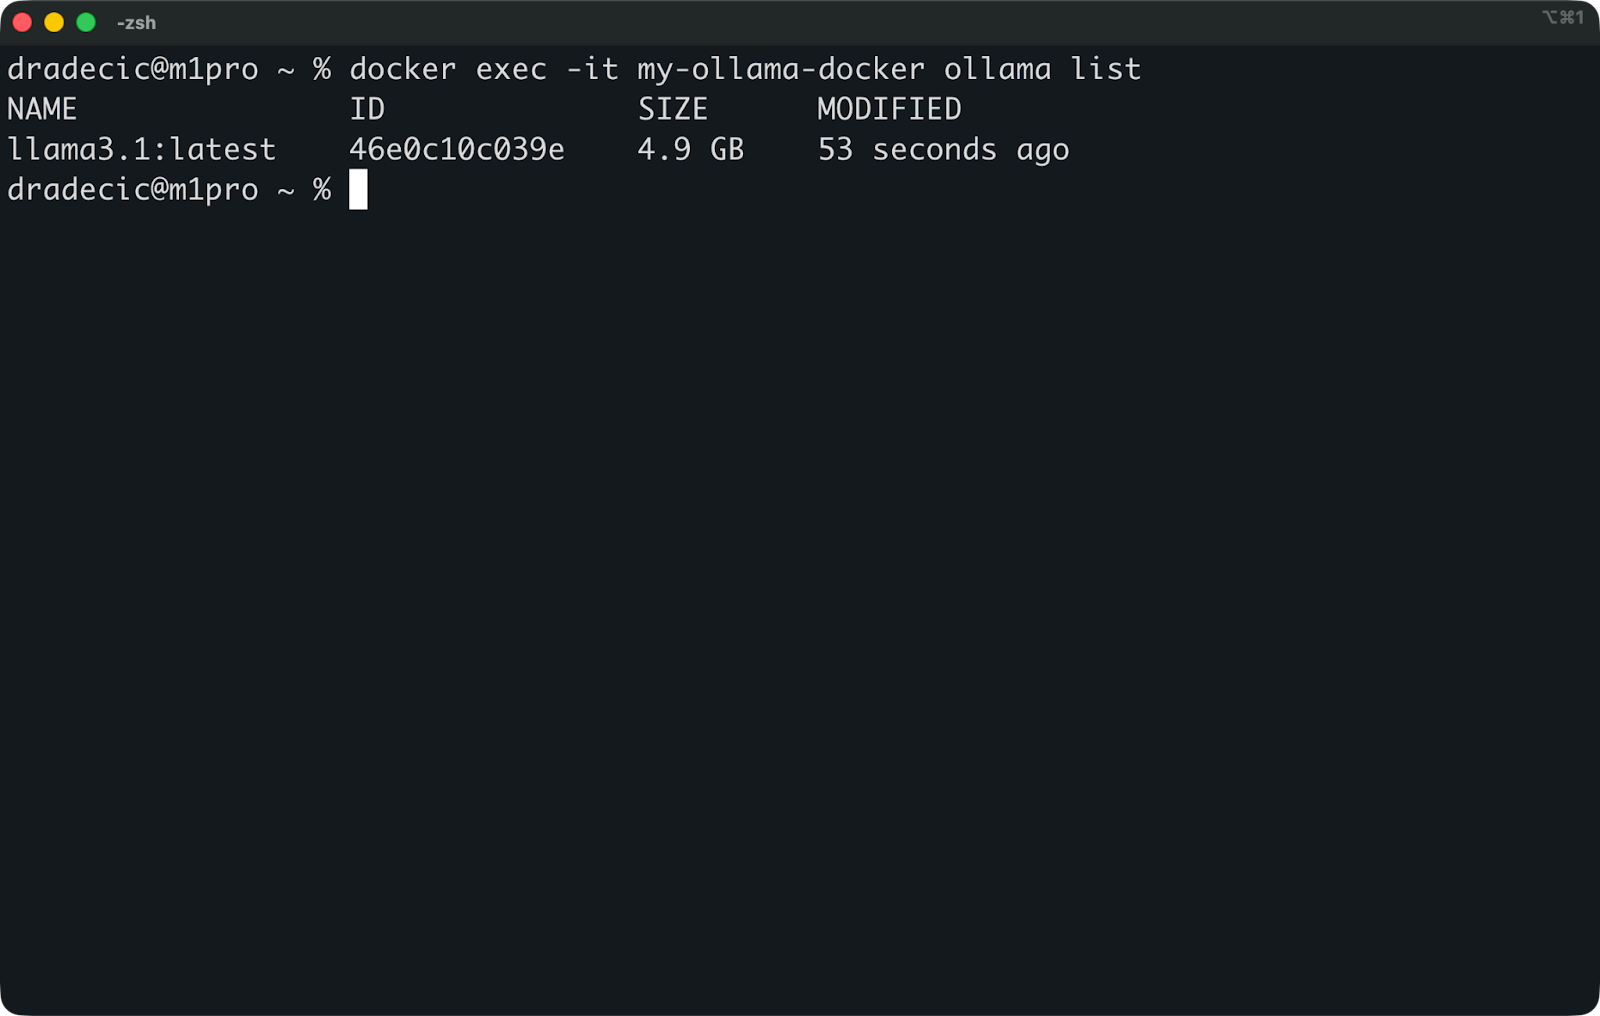
Elenco dei modelli disponibili
Il mapping del volume è importante. Senza di esso, perderai tutti i modelli scaricati quando il container si ferma. Il volume ollama:/root/.ollama mantiene i tuoi modelli tra riavvii e aggiornamenti del container.
Per setup di produzione, potresti voler costruire immagini personalizzate con modelli pre-caricati. Crea un Dockerfile che scarica i modelli durante il build:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
In questo modo il modello viene incorporato nell’immagine, così i nuovi container partono già pronti.
Una volta che il container è in esecuzione, Ollama funziona come qualsiasi altra API REST.
Il servizio ascolta su http://localhost:11434 e accetta richieste HTTP standard. Non servono client o SDK speciali — invii JSON e ricevi risposte.
Ecco come generare testo con un semplice comando curl:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'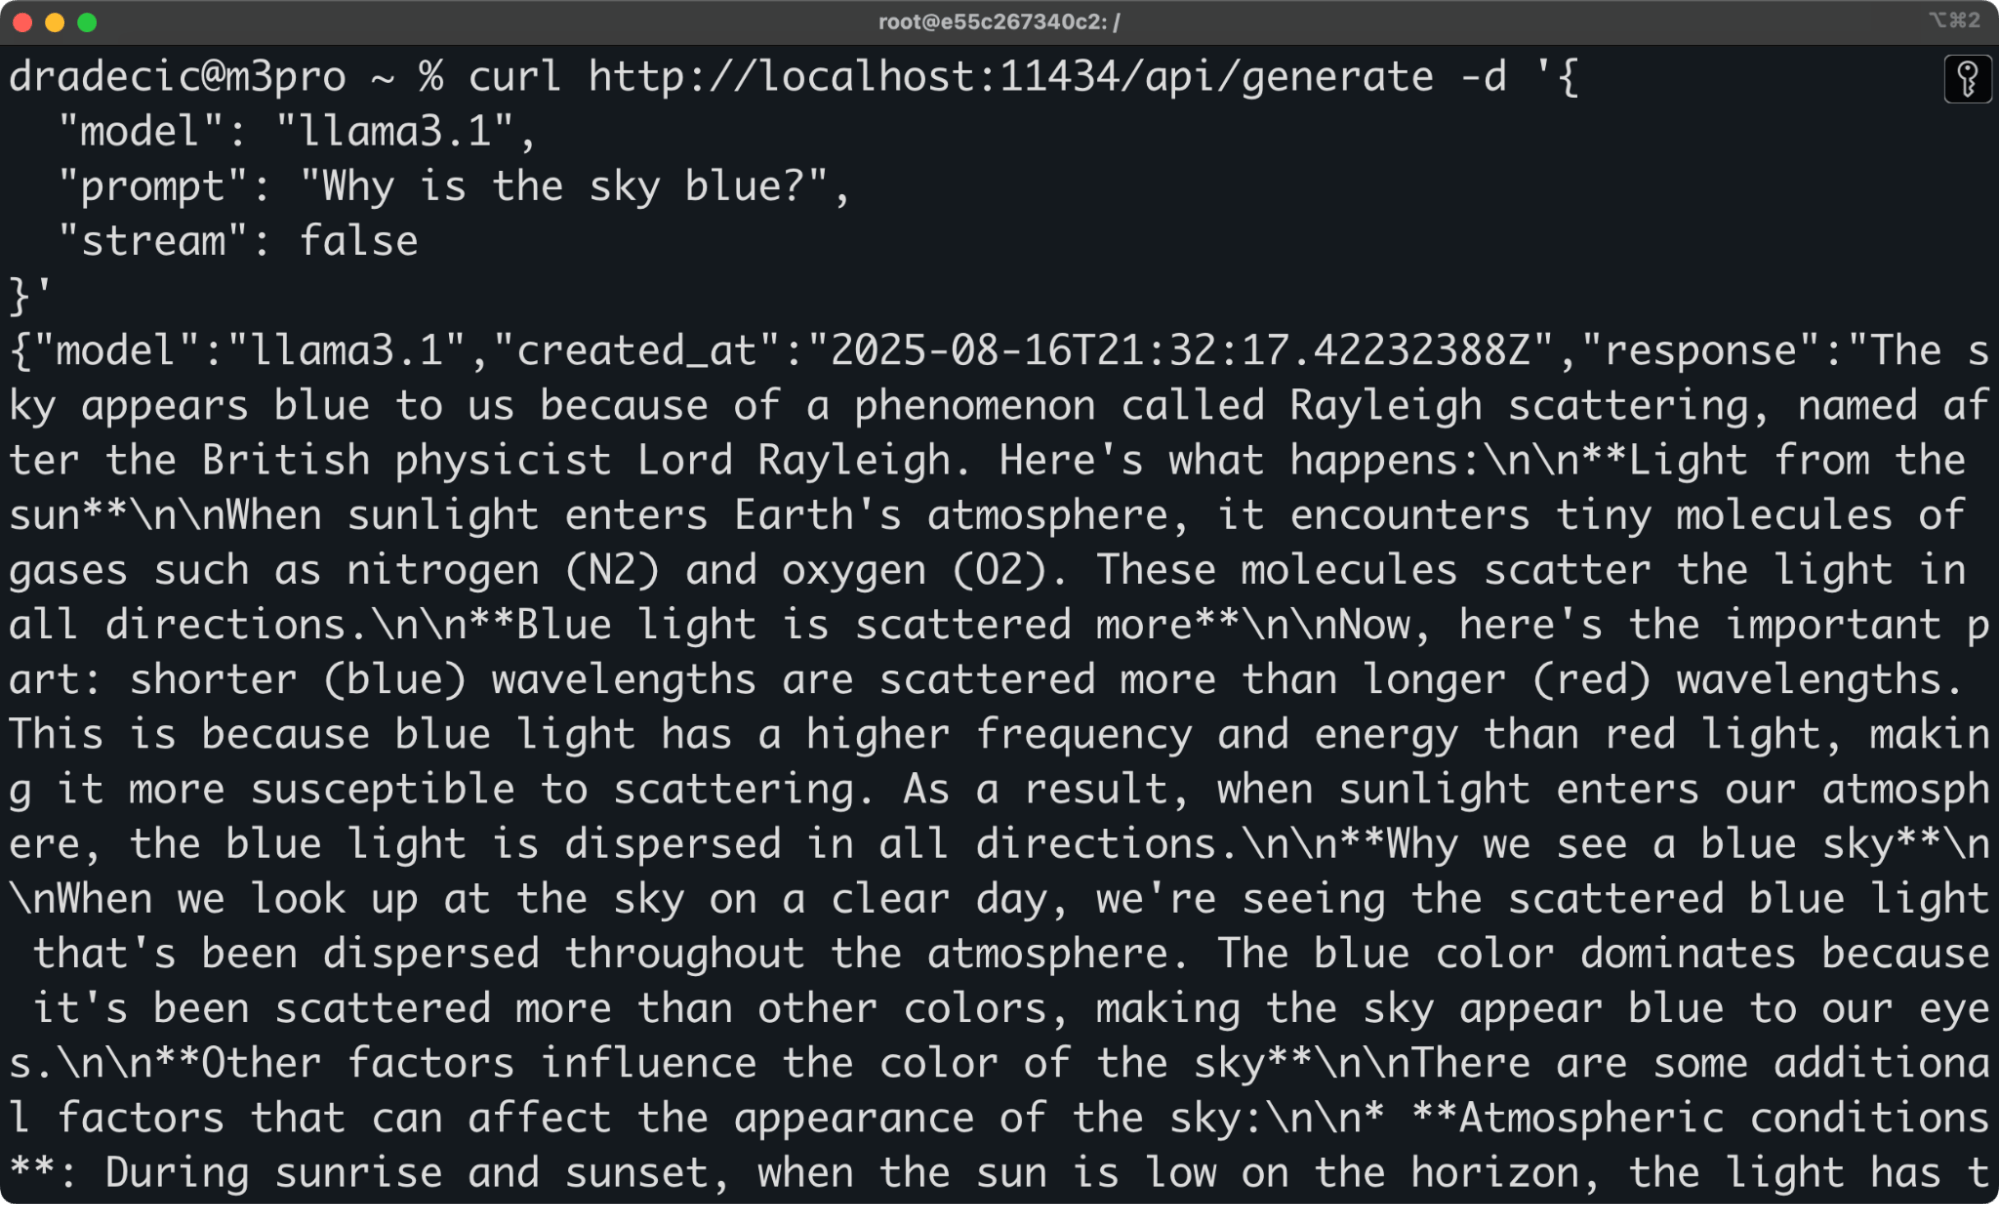
Accesso a Ollama con curl
L’API restituisce una risposta JSON con il testo generato. Imposta "stream": false per ottenere la risposta completa in una volta, oppure "stream": true per ricevere i token man mano che vengono generati.
L’integrazione con Python è altrettanto semplice:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])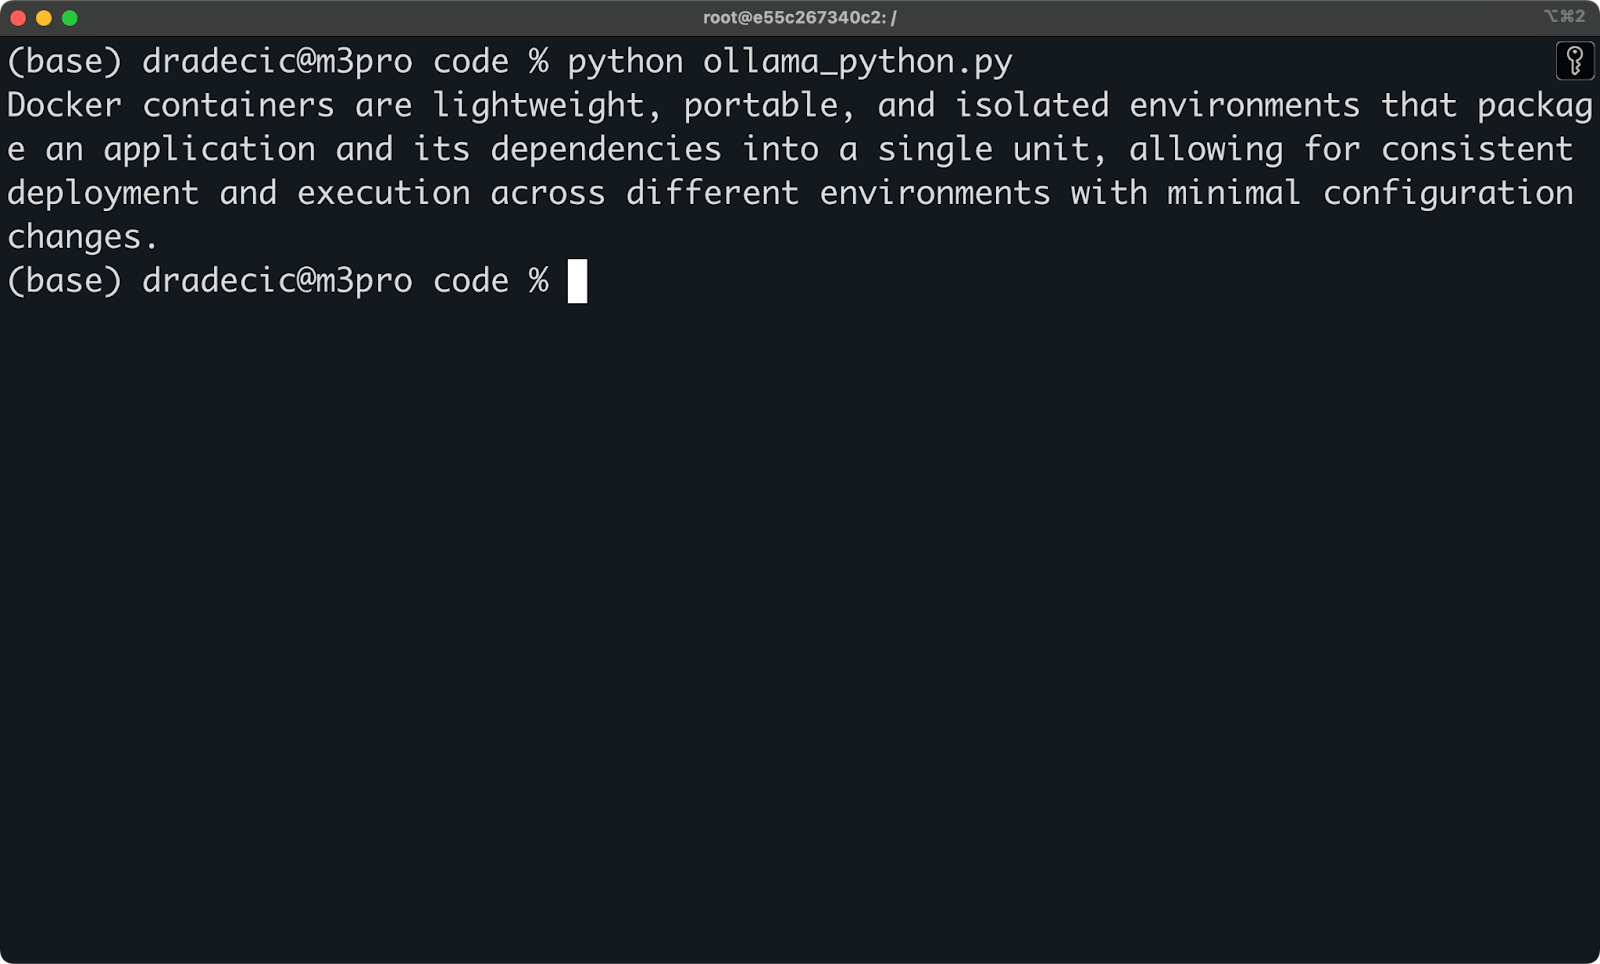
Accesso a Ollama con Python
Questo rende Ollama perfetto come backend per applicazioni locali. Puoi creare interfacce chat, strumenti di completamento del codice o sistemi di analisi documentale che dialogano con il tuo LLM containerizzato senza inviare dati a servizi esterni.
Per workflow più complessi, l’integrazione con LangChain funziona out of the box:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)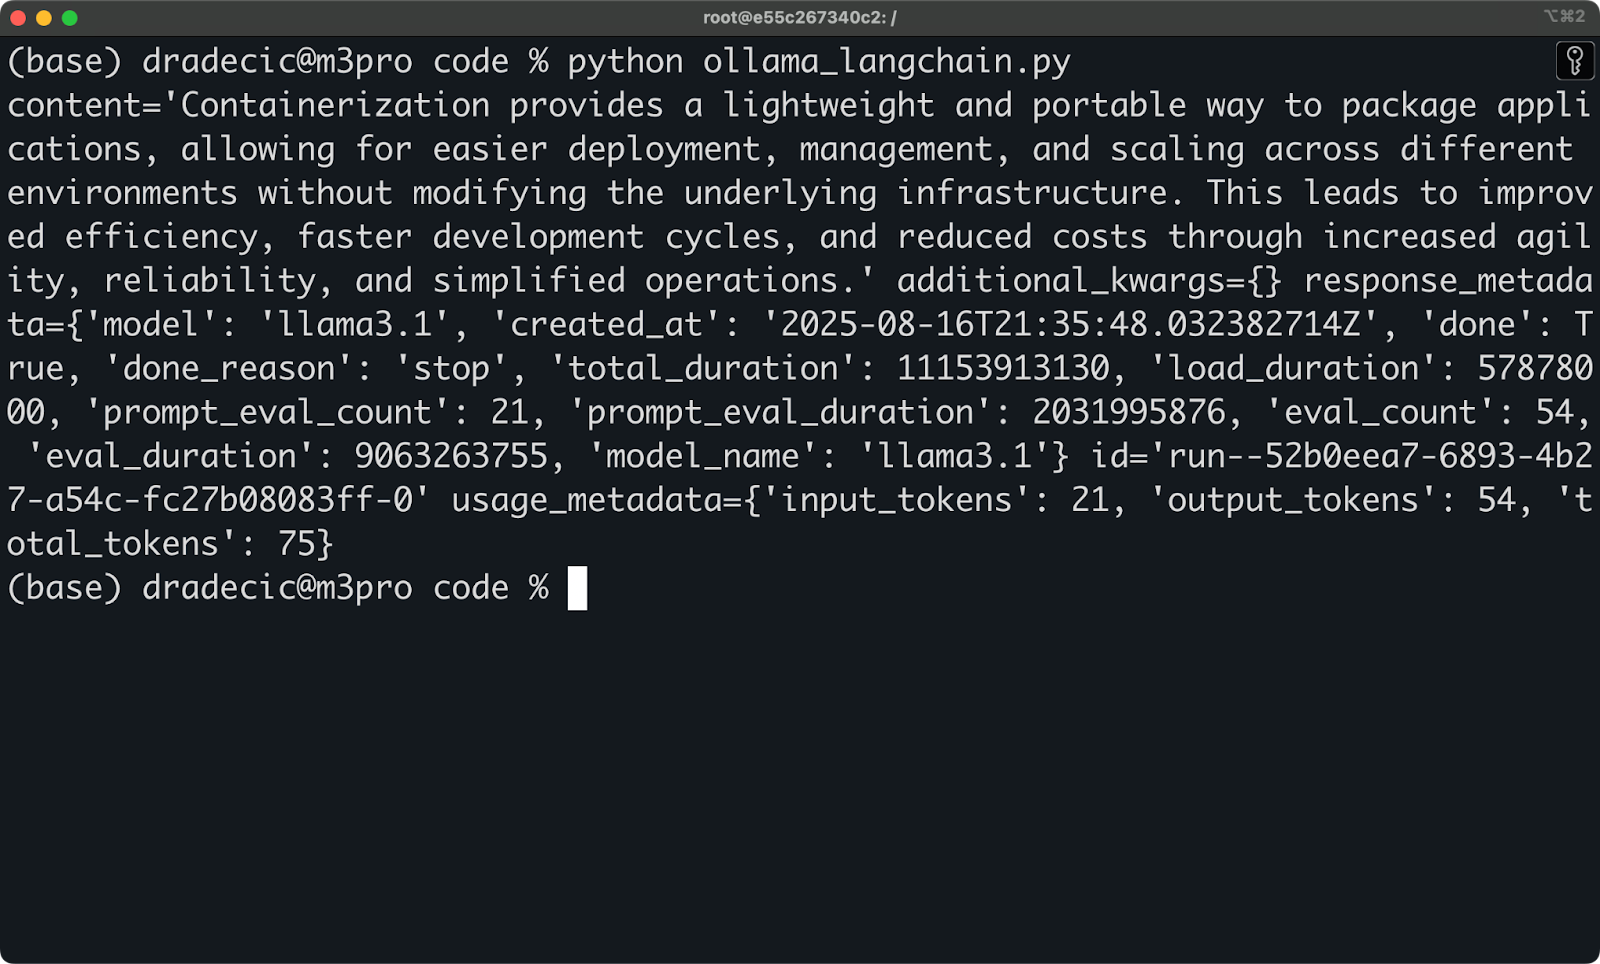
Accesso a Ollama con LangChain
Ottieni tutta la potenza degli LLM locali con la semplicità delle richieste HTTP.
Ti sei mai chiesto come vengono distribuite le applicazioni LLM? Leggi la nostra guida passo passo sul deployment di applicazioni LLM con Docker.
Gli LLM locali richiedono hardware serio per funzionare bene, e Docker aggiunge un po’ di overhead.
CPU vs GPU fa un’enorme differenza. Ollama può girare su sistemi solo CPU, ma l’inferenza sarà lenta: aspettati 30+ secondi per risposte semplici. Con una GPU moderna, la stessa query si completa in meno di 5 secondi. Le GPU NVIDIA funzionano al meglio, ma anche i Mac con Apple Silicon vanno bene e possono offrire un miglior rapporto qualità-prezzo.
I requisiti di RAM scalano con la dimensione del modello. Modelli piccoli come Llama3.1 8B richiedono almeno 8 GB di RAM di sistema, mentre versioni più grandi da 70B richiedono 64 GB o più. Il modello rimane caricato in memoria durante l’uso, quindi non puoi eseguire un 13B su una macchina con 8 GB di RAM.
Lo spazio su disco cresce in fretta. Ogni modello scarica gigabyte di spazio su disco:
Più versioni e quantizzazioni dei modelli fanno aumentare rapidamente le esigenze di storage. Se lo spazio è un problema, puoi spostare i modelli su un drive esterno.
L’overhead del container è minimo in termini di compute ma conta per lo storage. L’immagine base di Ollama è sotto 1 GB, ma i modelli persistono nei volumi Docker. Se crei immagini personalizzate con modelli pre-caricati, aspettati che ogni immagine sia diversi gigabyte più grande della base.
Tuttavia, l’allocazione della memoria in Docker probabilmente richiederà attenzione. Per impostazione predefinita, Docker Desktop limita la memoria dei container. Per modelli più grandi, dovrai aumentare questi limiti o usare il flag --memory quando avvii i container.
Il collo di bottiglia hardware di solito è la RAM, non la CPU o la velocità del disco.
Docker + Ollama ti offre capacità AI che mantengono i tuoi dati privati e il costo di inferenza degli LLM esattamente a 0 $ (escludendo elettricità e manutenzione).
Gli assistenti AI locali sono dove questo setup brilla. Puoi creare strumenti di completamento del codice, generatori di documentazione o assistant di scrittura che girano interamente sulla tua macchina. Niente costi API, niente limiti di frequenza, nessun dato che esce dalla tua rete. Basta puntare l’editor o l’IDE a localhost:11434 e iniziare a costruire.
Anche le pipeline RAG private diventano molto più facili da distribuire.
Puoi caricare i documenti aziendali in un database vettoriale e usare Ollama per rispondere alle domande su di essi. L’intera base di conoscenza rimane interna, cosa importante per informazioni legali, finanziarie o proprietarie che non possono passare da API esterne.
Lo sviluppo di chatbot offline ti permette di prototipare e testare AI conversazionali senza dipendere da Internet. È perfetto per deploy edge, ambienti air-gapped o situazioni con connettività inaffidabile. Il tuo bot funziona allo stesso modo che tu sia online o in volo a 30.000 piedi.
La sperimentazione sui modelli prima del deploy nel cloud fa risparmiare tempo e denaro. Puoi testare modelli, prompt e configurazioni in locale prima di impegnarti in inferenze cloud costose. Puoi fare benchmark delle prestazioni, regolare i parametri e validare gli output senza consumare crediti API.
I team usano anche questa combinazione Docker e Ollama per:
Ottieni capacità AI di livello enterprise senza i costi enterprise.
Ci sono un paio di insidie che possono metterti i bastoni tra le ruote quando esegui Ollama in Docker.
Il supporto GPU richiede configurazioni extra. L’immagine Docker ufficiale di Ollama supporta le GPU NVIDIA, ma devi prima installare l’NVIDIA Container Toolkit e passare il flag --gpus all quando avvii il container:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaSenza questo, Ollama torna alla modalità solo CPU, che funziona ma è molto più lenta. Se usi un Mac con Apple Silicon, questo non ti riguarda.
I problemi di permessi sui file possono creare grattacapi con i volumi Docker. Se monti una directory dell’host invece di usare un volume nominato, Ollama potrebbe non riuscire a scrivere i file dei modelli per via di permessi non allineati. Volumi nominati come -v ollama:/root/.ollama evitano del tutto il problema.
La cache dei modelli tra i riavvii funziona automaticamente con il montaggio corretto dei volumi. I modelli scaricati persistono nel volume Docker, quindi fermare e riavviare i container non richiederà di riscaricare tutto. Ma se elimini per errore il volume o dimentichi il flag -v, perderai tutti i modelli.
Ricorda questi fix rapidi:
Il problema più comune è dimenticare il volume e chiedersi perché i modelli spariscono.
Docker rende l’esecuzione di LLM locali semplice, portabile e pulita.
Ottieni la privacy by design, i tuoi dati non lasciano mai la macchina. Ottieni costi prevedibili, niente bollette API a sorpresa o rate limiting. E ottieni il controllo completo sul tuo stack AI senza lock-in del fornitore o dipendenza da Internet.
Il setup richiede pochi minuti.
Scarica l’immagine, avvia il container, scarica un modello e sei pronto per costruire. Che tu stia prototipando un assistant AI, eseguendo pipeline RAG private o semplicemente sperimentando modelli diversi, questa combinazione ti offre capacità di livello enterprise sul tuo laptop.
Provalo ora. Scegli un modello adatto al tuo hardware, avvia il container di Ollama e inizia a costruire qualcosa. La barriera d’ingresso non esiste.
Come passo successivo, ti consigliamo di configurare ed eseguire DeepSeek R1 in locale con Ollama.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min



