
Cursus
Docker voor gevorderden
4 uur
10.3K
De meeste developers willen lokale LLM’s uitproberen, maar weten niet waar te beginnen.
De opkomst van open-sourcemodellen zoals Llama en Mistral heeft lokale AI toegankelijker dan ooit gemaakt. Je hoeft geen cent uit te geven aan OpenAI of Anthropic en je hoeft je geen zorgen te maken over het versturen van gegevens naar derden. De uitdaging is dat de meeste setupgidsen het beheren van Python-omgevingen, CUDA-drivers en dependencies vereisen, die vaak stuklopen zodra je van machine wisselt.
Ollama lost dit op door een eenvoudige manier te bieden om lokale LLM’s te draaien met minimale setup. In combinatie met Docker krijg je een schone, draagbare oplossing die overal hetzelfde werkt.
In deze gids laat ik je zien hoe je Ollama in Docker instelt, je eerste model ophaalt en lokale LLM’s start die je vanuit elke applicatie kunt benaderen.
Ben je helemaal nieuw met Docker? Dan raden we je aan je in te schrijven voor onze Introduction to Docker-cursus om de basis te begrijpen.
Zie Ollama als de eenvoudigste manier om grote taalmodellen op je eigen hardware te draaien.
Het is een lichtgewicht runtime die al het zware werk voor lokale LLM’s uit handen neemt. Je hoeft geen Python-omgevingen te beheren, geen CUDA-drivers handmatig te installeren of uit te zoeken hoe het zit met modelgewichten en tokenizers. Ollama regelt het downloaden, laden en serven van modellen zoals LLaMA, Mistral en Gemma met één enkel commando.
Privacy is ingebouwd. Je gesprekken verlaten je machine niet. Geen API-sleutels, geen gebruikstracking, geen data naar externe servers. Perfect voor gevoelig werk waarbij je geen risico wilt lopen om eigen code of persoonsgegevens bloot te stellen aan diensten van derden.
De tool is in de eerste plaats voor developers ontworpen. Hij draait native op macOS en Linux, biedt een eenvoudige REST API voor integratie en werkt nu ook binnen Docker-containers. Dat betekent dat je lokaal tijdens development dezelfde setup kunt draaien en overal kunt uitrollen waar Docker draait.
Je krijgt een production-ready LLM-server die met één commando start en offline werkt.
Ollama is niet de enige LLM-runtime - probeer ook n8n en Qdrant.
Het antwoord is simpel: je profiteert volledig van Ollama, terwijl je systeem schoon blijft.
Ollama rechtstreeks op je machine draaien werkt prima — het komt als een verpakte installer (.exe voor Windows, .dmg voor Mac) die alles voor je regelt. Maar Docker biedt één belangrijk voordeel: isolatie.
Met Docker draait Ollama in zijn eigen container. Dat houdt je host-systeem schoon. Geen installatievoetafdruk op je hoofdsysteem, geen restbestanden na het testen en eenvoudig verwijderen wanneer je van versie wilt wisselen of volledig wilt opschonen.
Dezelfde setup werkt voor iedereen in je team dankzij reproduceerbaarheid. Deel een Docker-commando en iedereen kan exact dezelfde Ollama-omgeving draaien, ongeacht of ze op macOS, Linux of Windows werken.
Uitrollen wordt eenvoudig dankzij cross-platform ondersteuning. Dezelfde container die op je laptop draait, werkt zonder aanpassing op een cloudserver, in een CI-pipeline of op de machine van een collega.
Je kunt Ollama in seconden opstarten en net zo snel volledig verwijderen met een vereenvoudigde setup en teardown. Geen uninstall-scripts, geen configbestanden opsporen, geen systeemopschoning.
Dit maakt Docker perfect voor:
Kortom: je krijgt alle voordelen van lokale LLM’s zonder de setup-hoofdpijn.
Op zoek naar meer praktische Docker-bronnen? Deze 12 Docker-containerimages voor machine learning en AI helpen je op weg.
Met precies drie commando’s draai je Ollama in Docker.
Trek eerst de officiële Ollama-image van Docker Hub binnen:
docker pull ollama/ollama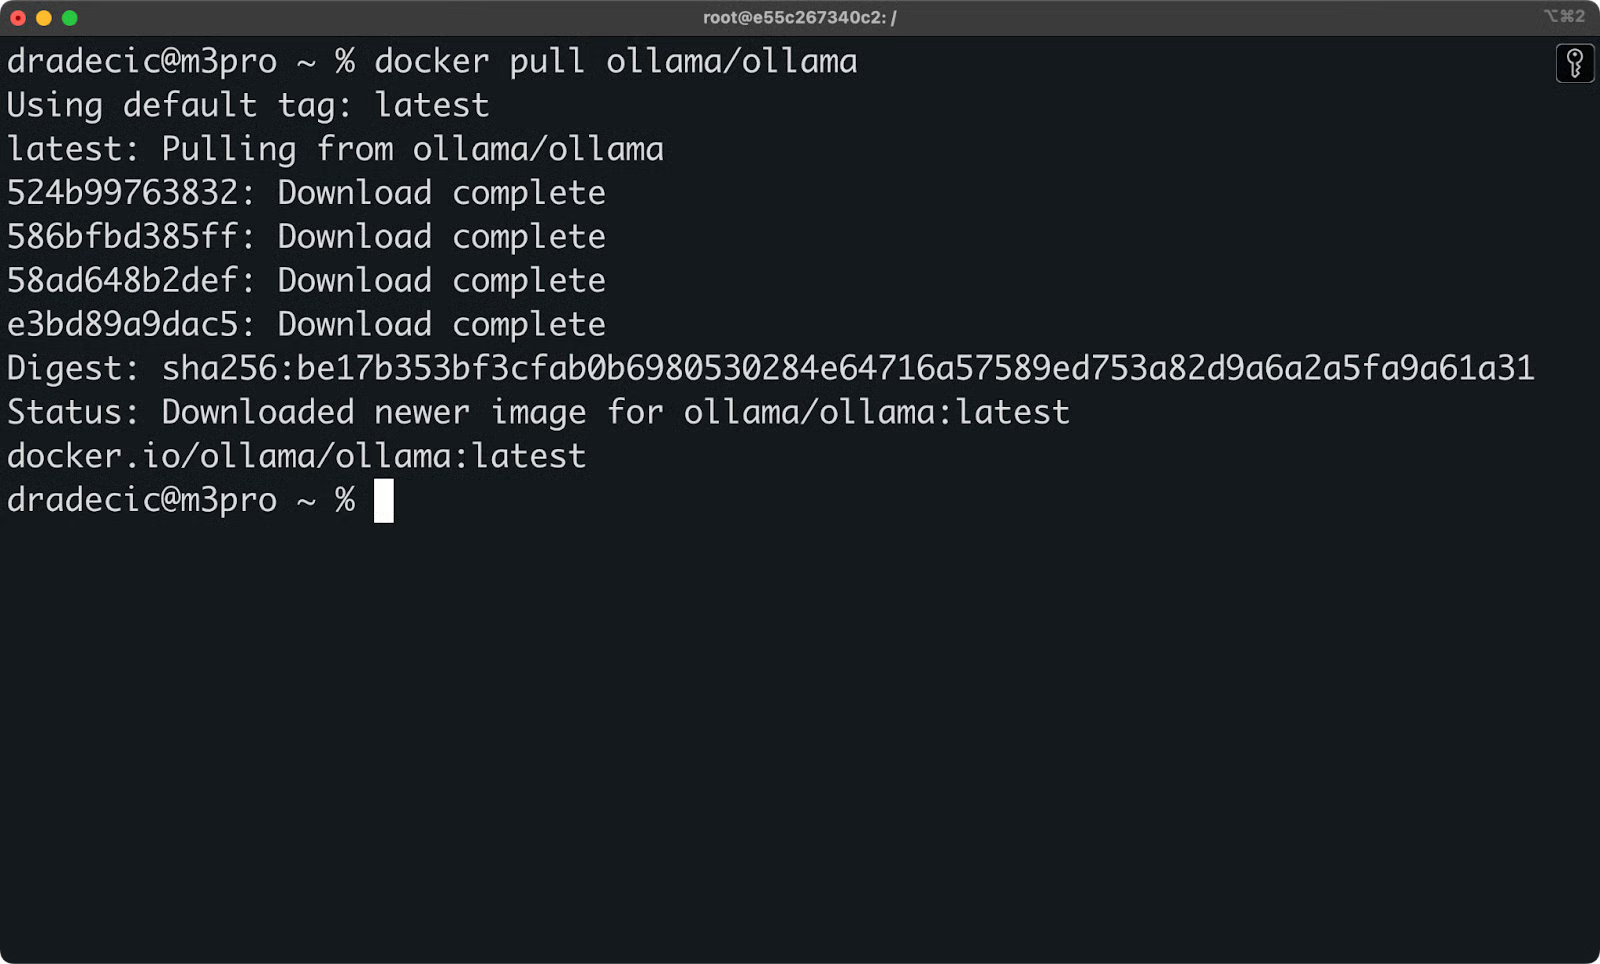
De ollama-image ophalen
Start vervolgens de container met de juiste poort- en volumekoppelingen:
docker run -d --name my-ollama-docker -p 11434:11434 -v ollama:/root/.ollama ollama/ollama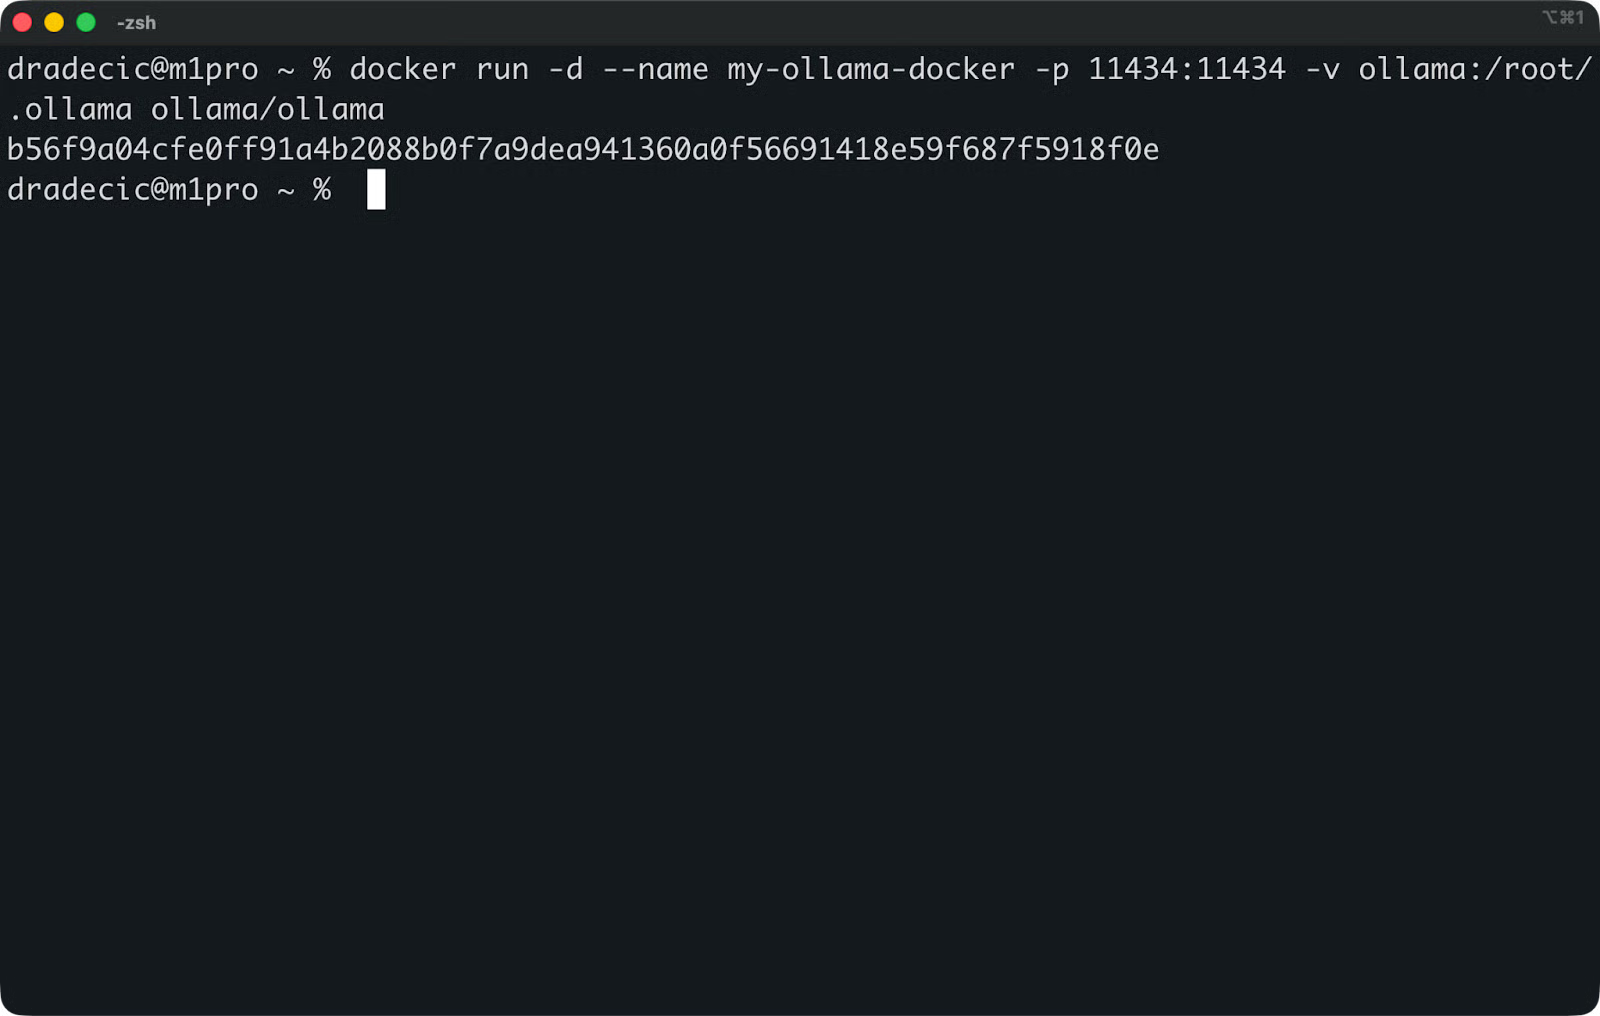
Ollama draaien
Dit doet elke flag:
-d draait de container op de achtergrond--name my-ollama.docker geeft je container een herkenbare naam-p 11434:11434 koppelt de standaardpoort van Ollama aan je hostmachine-v ollama:/root/.ollama maakt een persistent volume voor gedownloade modellenDe container start direct en luistert op http://localhost:11434.
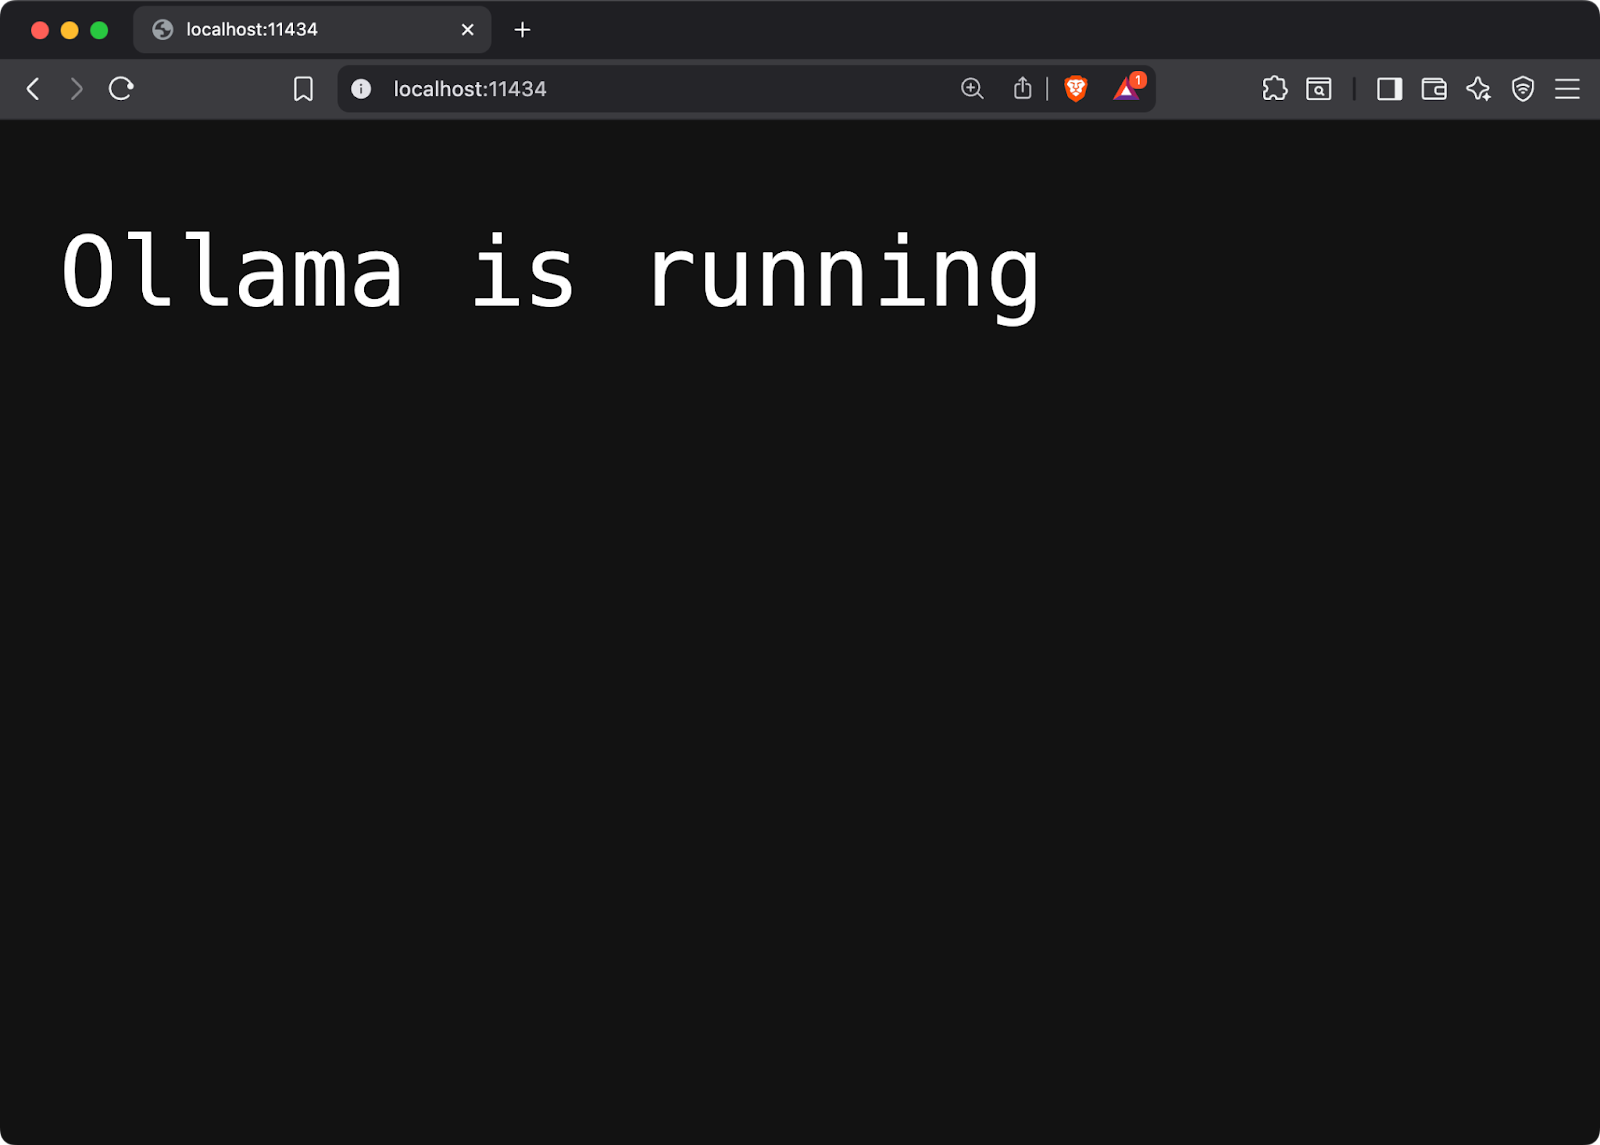
Ollama lokaal draaiend
Download nu een model om te testen of alles werkt:
docker exec -it my-ollama-docker ollama pull llama3.1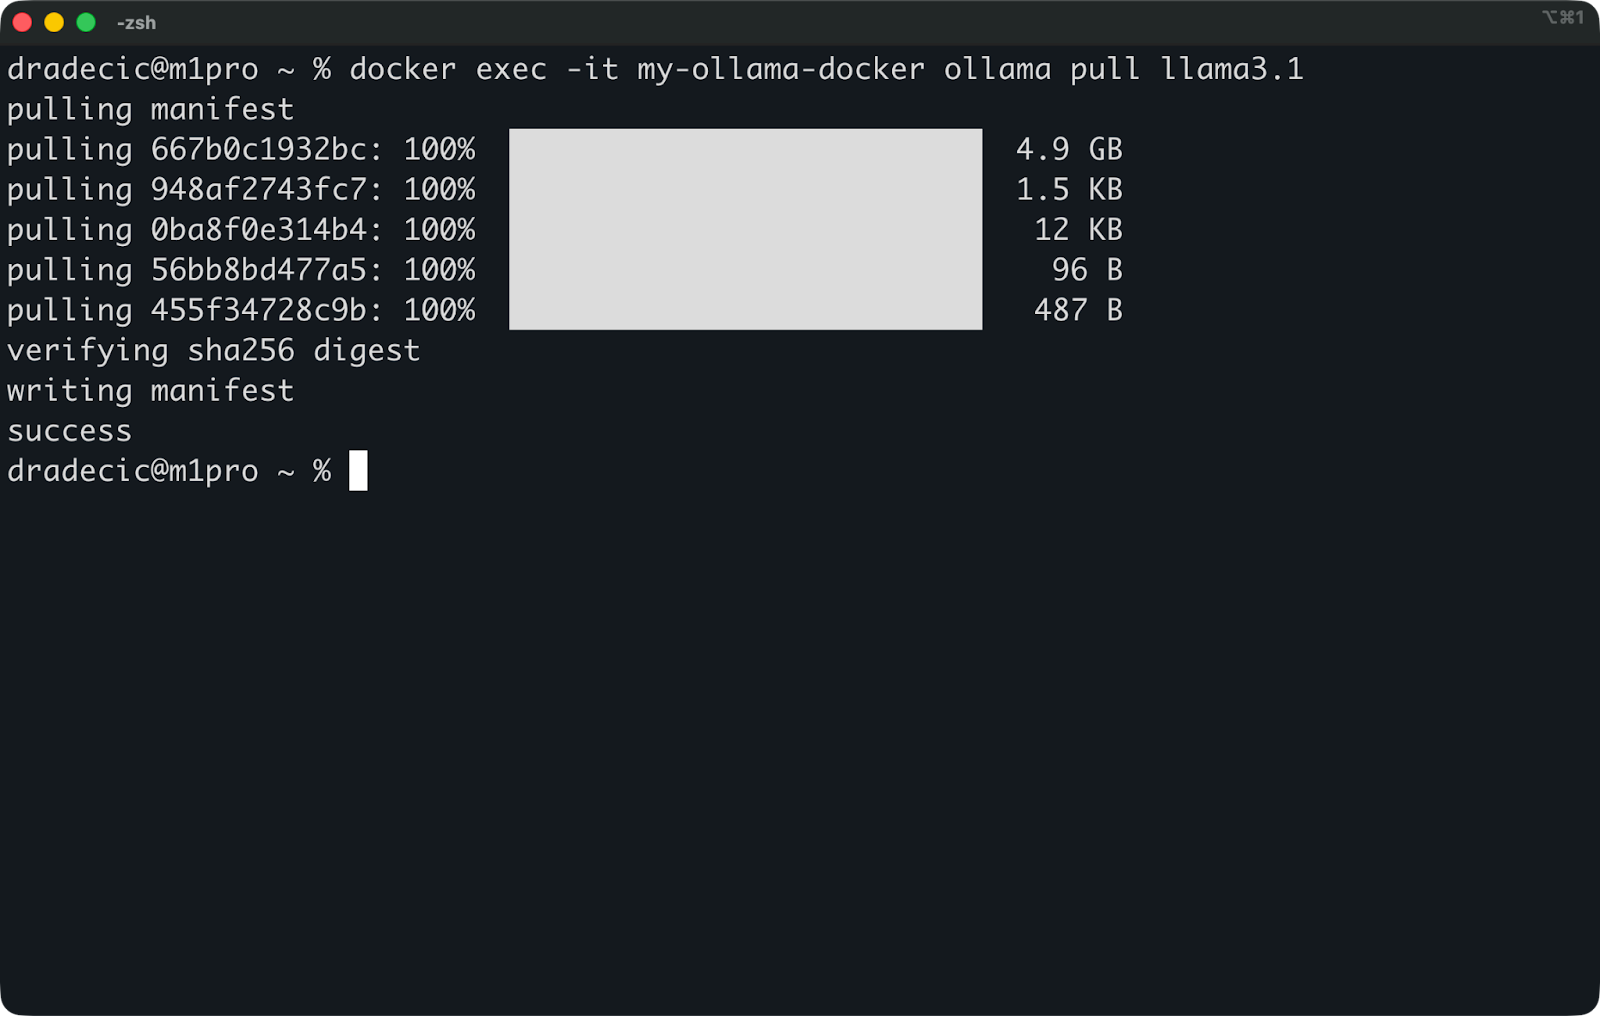
Het Llama3.1-model ophalen
Dit downloadt het Llama 3.1 8b-model in je container. Het model is ongeveer 5 GB, dus het downloaden kan een paar minuten duren.
Je kunt de setup verifiëren door beschikbare modellen op te sommen:
docker exec -it my-ollama-docker ollama list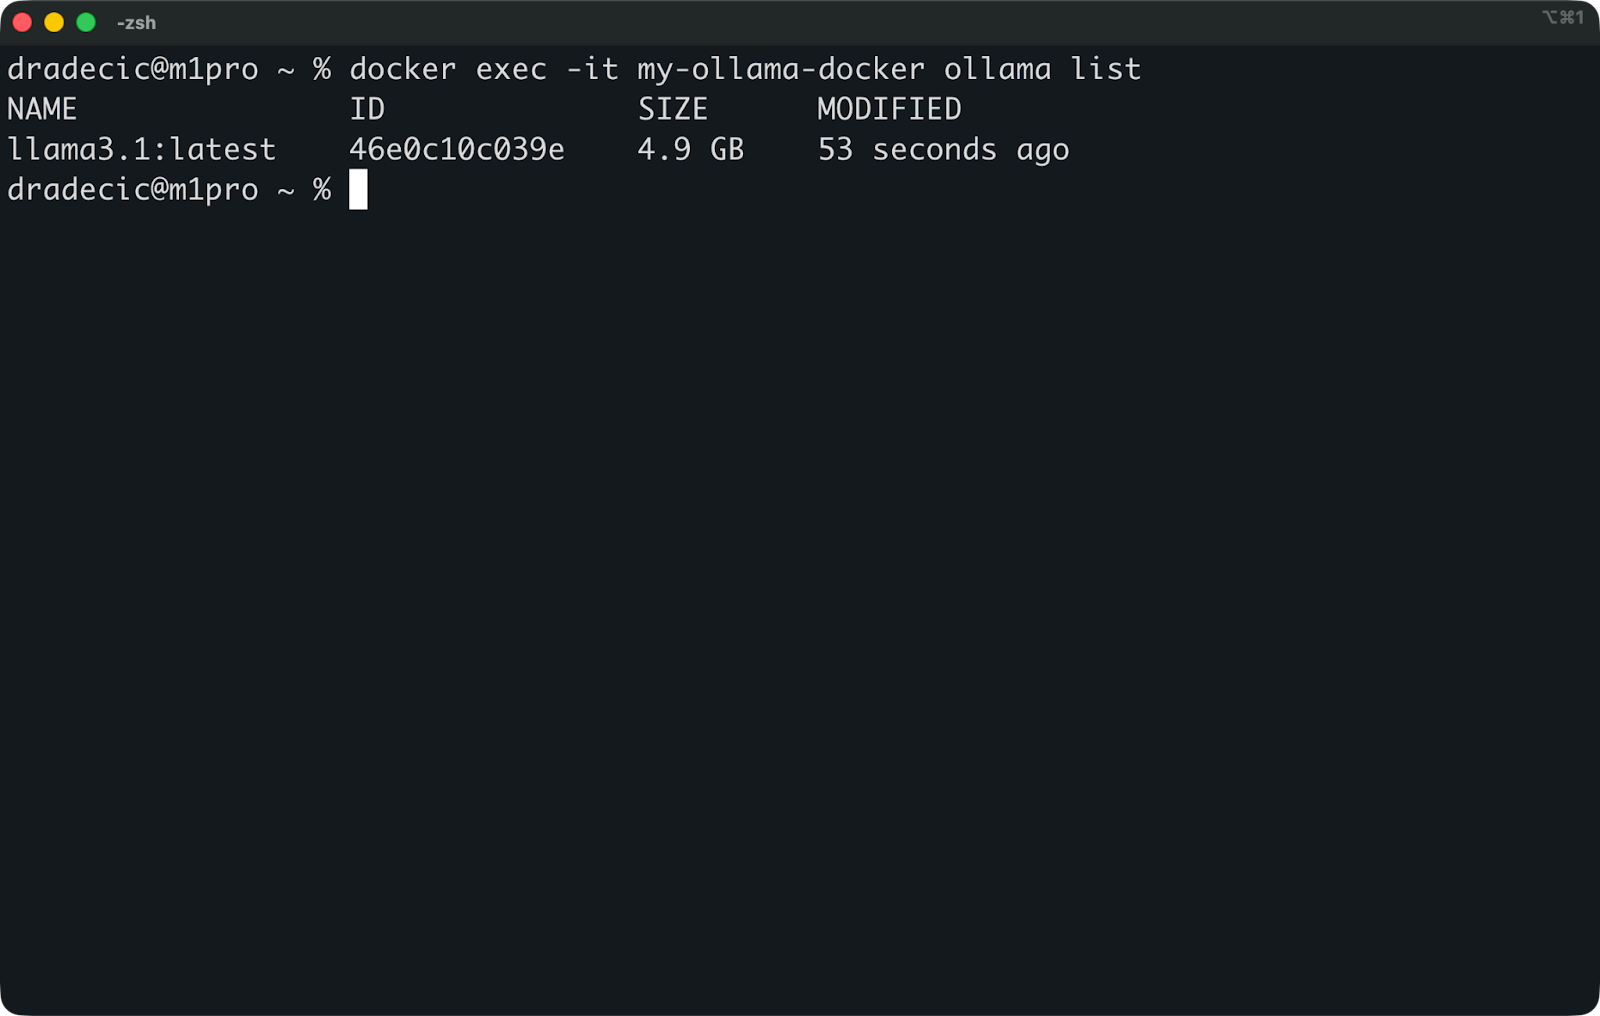
Beschikbare modellen tonen
De volumekoppeling is belangrijk. Zonder die koppeling verlies je alle gedownloade modellen zodra de container stopt. Het ollama:/root/.ollama-volume bewaart je modellen tussen container-restarts en updates.
Voor productieopstellingen wil je mogelijk custom images bouwen met vooringeladen modellen. Maak een Dockerfile die tijdens de buildfase modellen downloadt:
FROM ollama/ollama
RUN ollama serve & sleep 5 && ollama pull llama3.1 && pkill ollama
CMD ["ollama", "serve"]
Dit bakt het model in je image, zodat nieuwe containers meteen startklaar zijn.
Zodra je container draait, werkt Ollama als elke andere REST API.
De service luistert op http://localhost:11434 en accepteert standaard HTTP-verzoeken. Je hebt geen speciale clients of SDK’s nodig — stuur gewoon JSON en ontvang een response terug.
Zo genereer je tekst met een eenvoudig curl-commando:
curl http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Why is the sky blue?",
  "stream": false
}'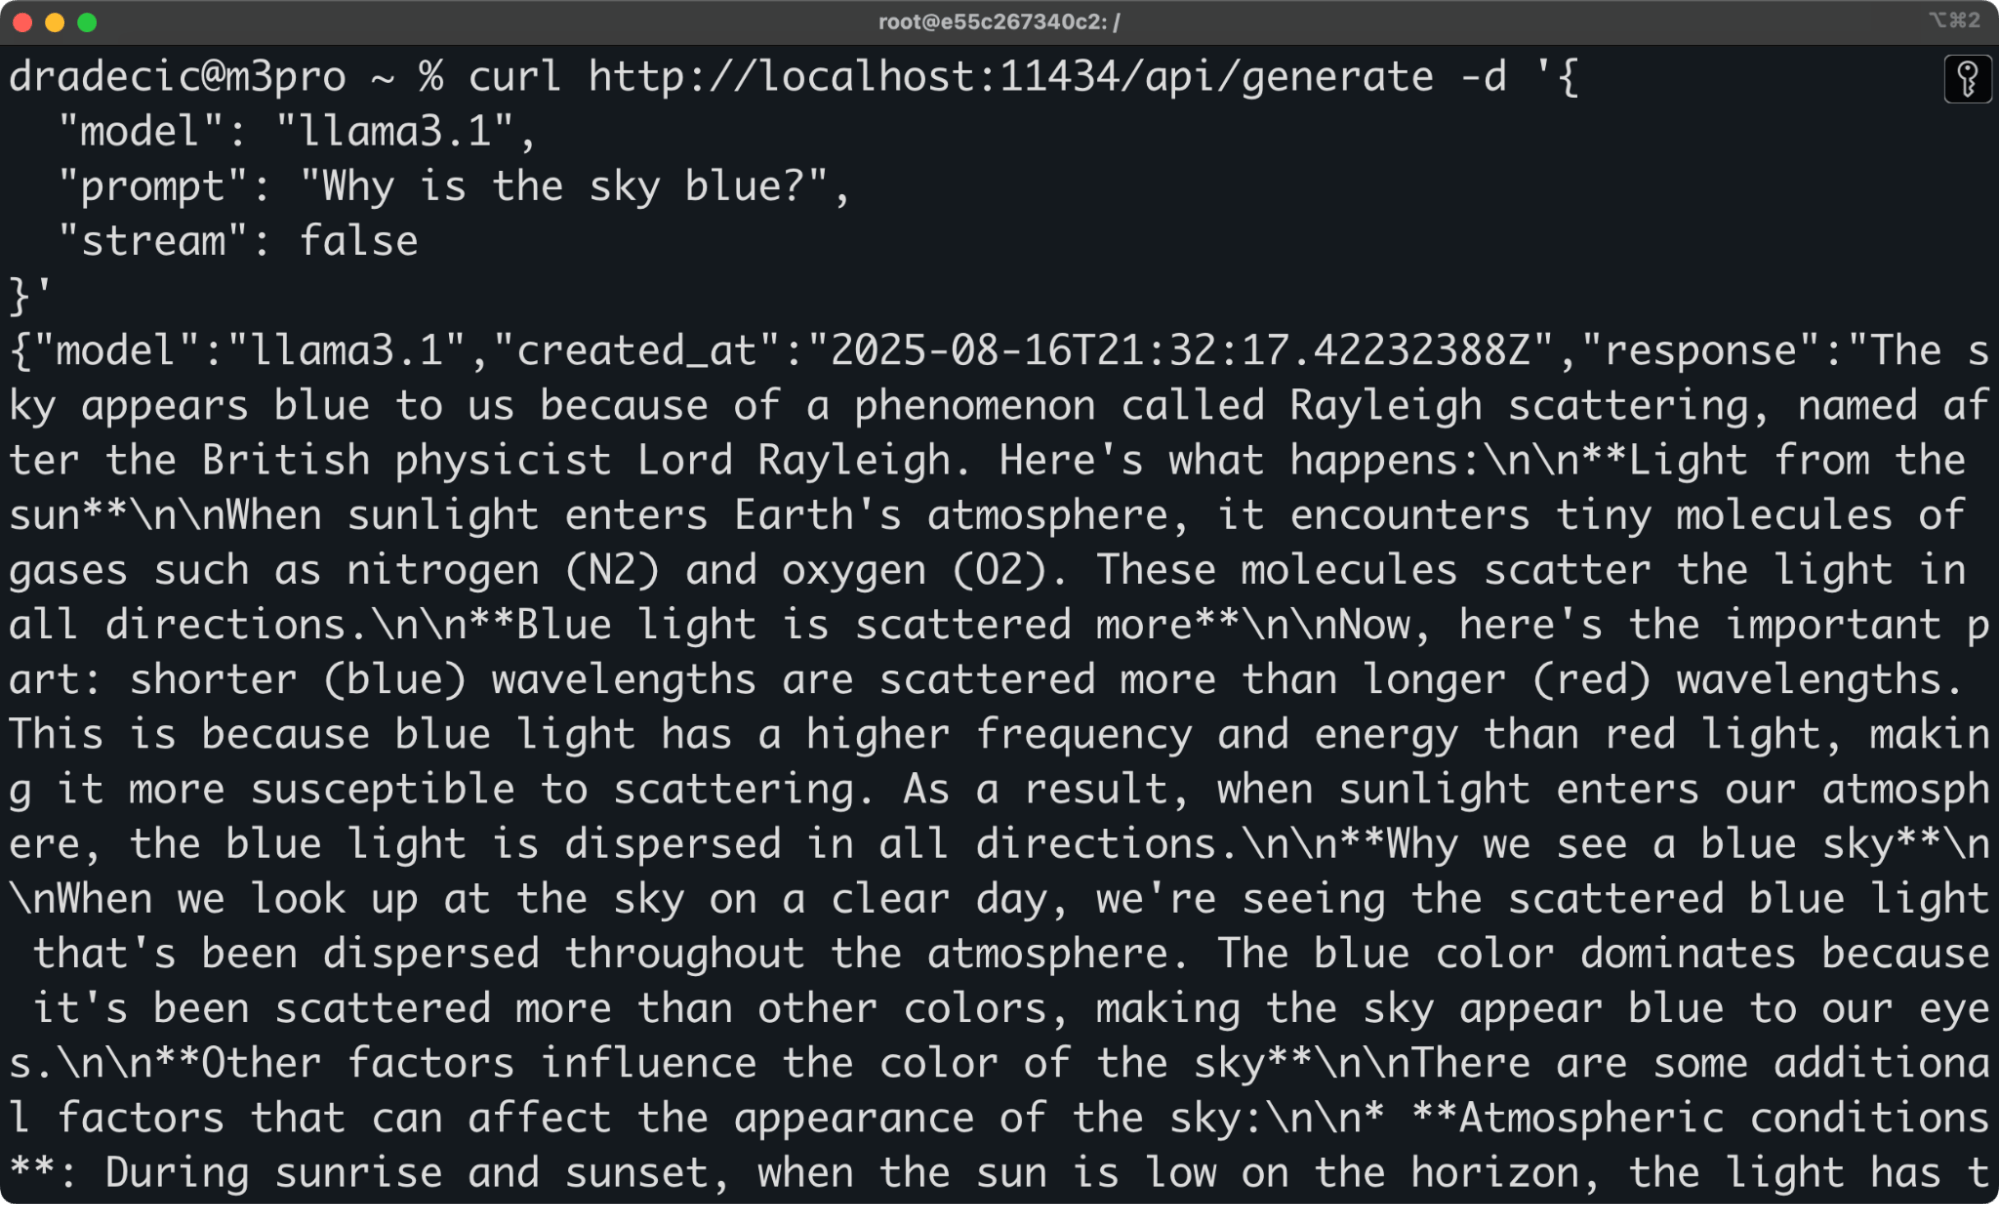
Ollama benaderen met curl
De API geeft een JSON-response terug met de gegenereerde tekst. Zet "stream": false om de volledige response in één keer te krijgen, of "stream": true om tokens te ontvangen zodra ze worden gegenereerd.
Python-integratie is net zo simpel:
import requests

response = requests.post(
    "http://localhost:11434/api/generate",
    json={
        "model": "llama3.1",
        "prompt": "Explain Docker containers in one sentence.",
        "stream": False,
    },
)

print(response.json()["response"])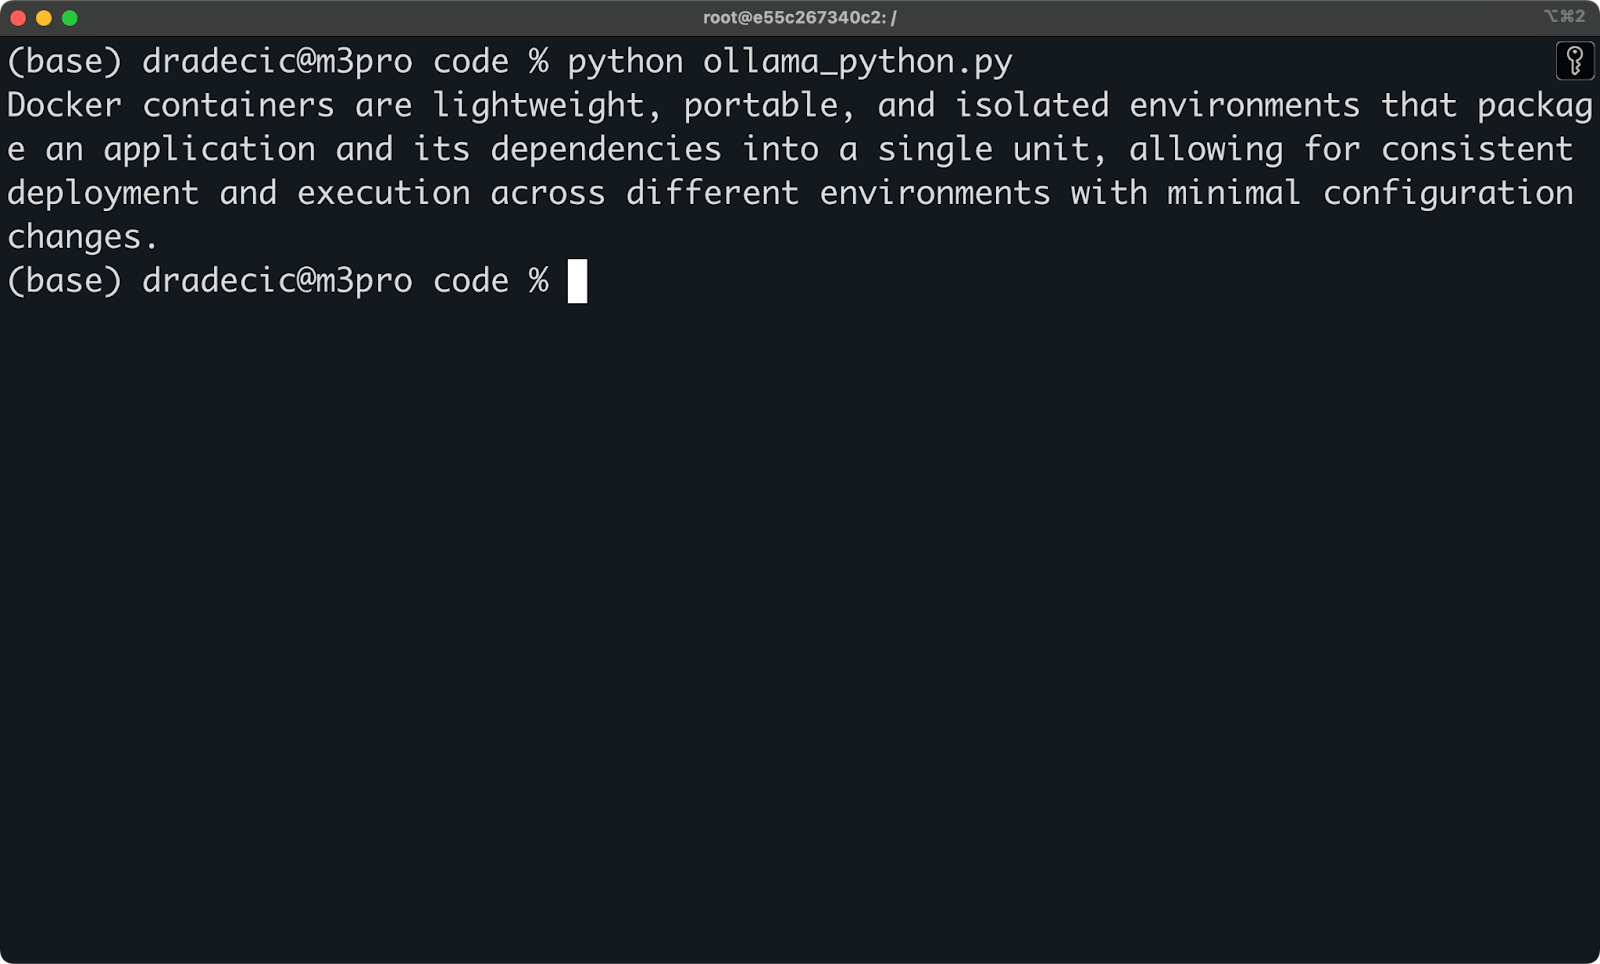
Ollama benaderen met Python
Dit maakt Ollama perfect als backend voor lokale applicaties. Je kunt chatinterfaces, code completion-tools of documentanalysesystemen bouwen die met je gecontaineriseerde LLM praten zonder data naar externe diensten te sturen.
Voor complexere workflows werkt LangChain-integratie out-of-the-box:
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.1", base_url="http://localhost:11434")
response = llm.invoke("Explain the benefits of containerization in 2 sentences")
print(response)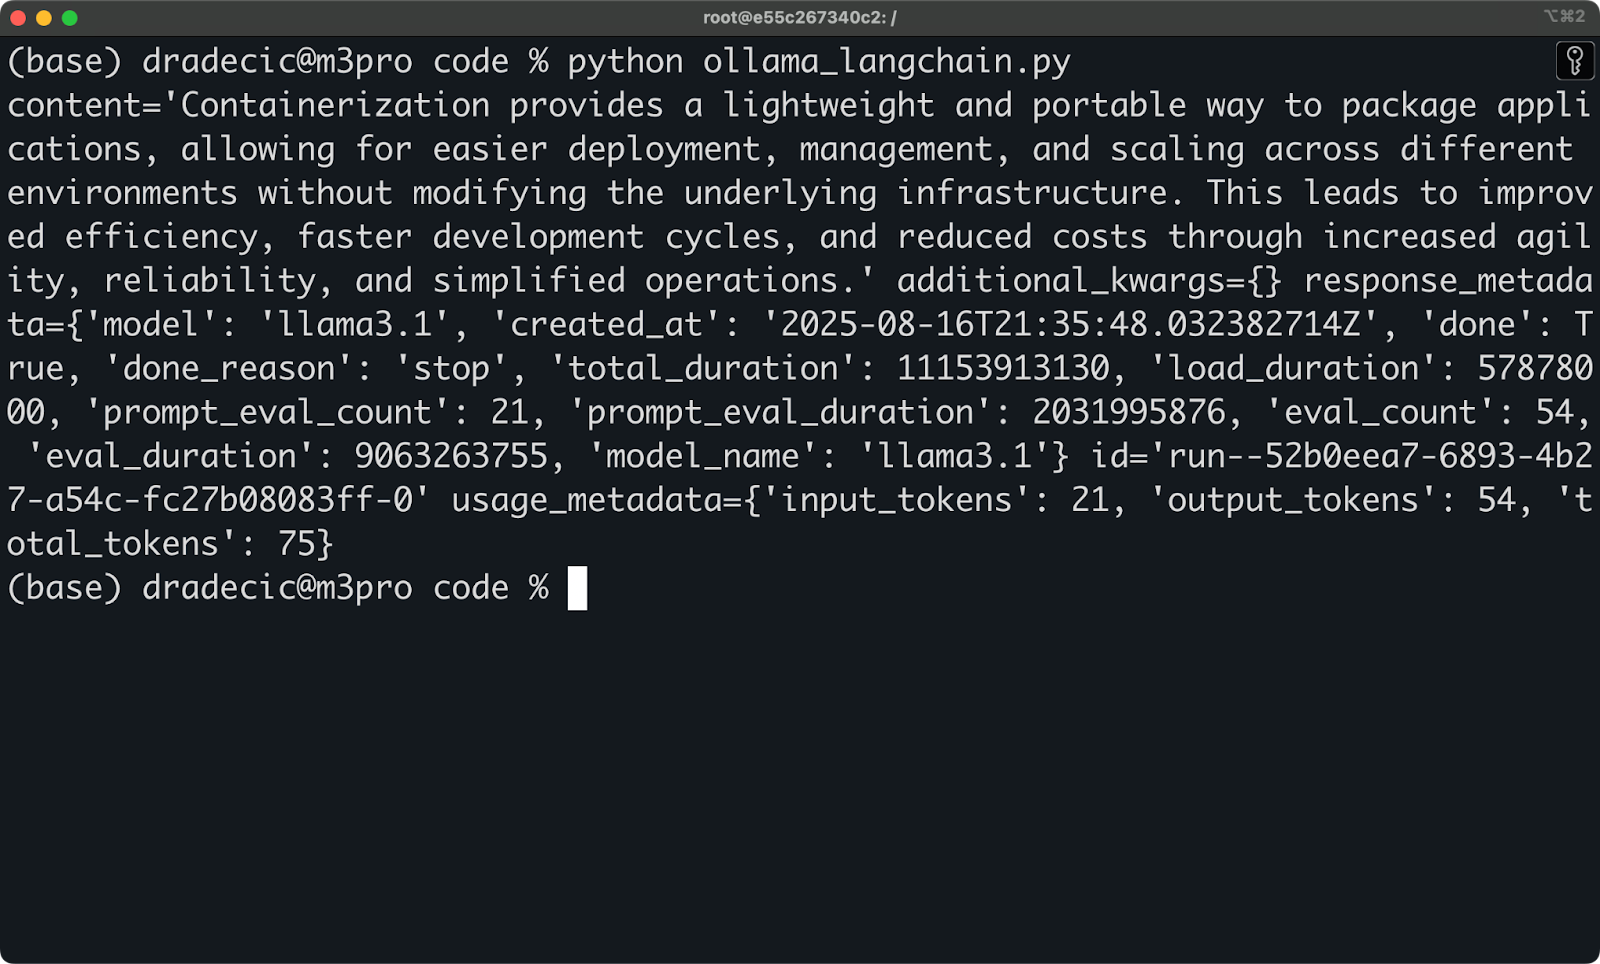
Ollama benaderen met LangChain
Je krijgt alle kracht van lokale LLM’s met de eenvoud van HTTP-verzoeken.
Heb je je ooit afgevraagd hoe LLM-applicaties worden uitgerold? Lees onze stapsgewijze gids voor LLM-applicaties uitrollen met Docker.
Lokale LLM’s vragen serieuze hardware, en Docker voegt een beetje overhead toe.
CPU vs GPU maakt een enorm verschil. Ollama kan op systemen met alleen CPU draaien, maar inference is dan traag — reken op 30+ seconden voor simpele antwoorden. Met een moderne GPU is dezelfde query in minder dan 5 seconden klaar. NVIDIA GPU’s werken het best, maar Apple Silicon Macs presteren ook goed en kunnen een betere prijs-kwaliteitverhouding bieden.
RAM-behoefte schaalt met modelgrootte. Kleine modellen zoals Llama3.1 8B hebben minstens 8GB systeemgeheugen nodig, terwijl grotere 70B-versies 64GB of meer vereisen. Het model blijft tijdens gebruik in het geheugen geladen, dus je kunt geen 13B-model draaien op een machine met 8GB RAM.
Schijfruimte tikt snel aan. Elk model vergt gigabytes aan schijfruimte:
Meerdere modelversies en quantizations laten de opslagbehoefte snel oplopen. Je kunt modellen naar een externe schijf verplaatsen als opslag een probleem is.
Container-overhead is minimaal voor compute maar telt voor opslag. De basisimage van Ollama is minder dan 1GB, maar modellen blijven bestaan in Docker-volumes. Als je custom images bouwt met vooringeladen modellen, reken er dan op dat elke image enkele gigabytes groter is dan de basis.
Wel zal je geheugenallocatie in Docker waarschijnlijk aandacht vergen. Standaard beperkt Docker Desktop het geheugen voor containers. Voor grotere modellen moet je deze limieten verhogen of de --memory-flag gebruiken bij het draaien van containers.
De hardwarebottleneck is meestal RAM, niet CPU of schijfsnelheid.
Docker + Ollama geeft je AI-mogelijkheden die je data privé houden en je LLM-inferencekosten exact op $0 zetten (los van elektriciteit en onderhoud).
Lokale AI-assistenten zijn waar deze setup in uitblinkt. Je kunt code completion-tools, documentatiegenerators of schrijfassistenten maken die volledig op je eigen machine draaien. Geen API-kosten, geen ratelimieten, geen data die je netwerk verlaat. Laat je editor of IDE gewoon wijzen naar localhost:11434 en ga bouwen.
Private RAG-pijplijnen worden ook veel eenvoudiger om uit te rollen.
Je kunt bedrijfsdocumenten in een vectordatabase laden en vervolgens Ollama gebruiken om er vragen over te beantwoorden. De volledige kennisbank blijft intern — cruciaal voor juridische, financiële of propriëtaire informatie die niet via externe API’s mag lopen.
Offline chatbotontwikkeling laat je conversationale AI prototypen en testen zonder internetafhankelijkheid. Perfect voor edge-deployments, air-gapped omgevingen of situaties met onbetrouwbare connectiviteit. Je bot werkt hetzelfde of je nu online bent of op 10 kilometer hoogte vliegt.
Modelexperimenten vóór clouduitrol besparen geld en tijd. Je kunt lokaal verschillende modellen, prompts en configuraties testen voordat je je vastlegt op dure cloud-inference. Je kunt prestaties benchmarken, parameters afstellen en outputs valideren zonder je API-credits te verbranden.
Teams gebruiken deze Docker- en Ollama-setup ook voor:
Je krijgt enterprise-grade AI-mogelijkheden zonder enterprise-grade rekeningen.
Er zijn een paar valkuilen waar je over kunt struikelen bij het draaien van Ollama in Docker.
GPU-ondersteuning vereist extra setup. De officiële Docker-image van Ollama ondersteunt NVIDIA GPU’s, maar je moet eerst de NVIDIA Container Toolkit installeren en de --gpus all-flag meegeven bij het starten van je container:
docker run -d --gpus all --name ollama -p 11434:11434 -v ollama:/root/.ollama ollama/ollamaZonder dit valt Ollama terug op CPU-only modus, wat werkt maar veel trager is. Als je een Apple Silicon MacBook hebt, is dit niet relevant voor jou.
Bestandsrechtenproblemen kunnen voor hoofdpijn zorgen met Docker-volumes. Als je een hostmap mount in plaats van een named volume te gebruiken, kan het zijn dat Ollama geen modelbestanden kan wegschrijven door rechtenmismatches. Named volumes zoals -v ollama:/root/.ollama voorkomen dit probleem volledig.
Modelcaching tussen restarts werkt automatisch met correcte volumemounting. Je gedownloade modellen blijven bestaan in het Docker-volume, dus stoppen en starten vereist geen herdownload. Maar als je per ongeluk het volume verwijdert of de -v-flag vergeet, verlies je al je modellen.
Onthoud deze snelle fixes:
Het meest voorkomende probleem is het volumemount vergeten en je afvragen waarom modellen verdwijnen.
Docker maakt het draaien van lokale LLM’s simpel, draagbaar en schoon.
Je krijgt privacy by design, je data verlaat je machine niet. Je krijgt voorspelbare kosten, geen onverwachte API-rekeningen of ratelimiting. En je krijgt volledige controle over je AI-stack zonder vendor lock-in of internetafhankelijkheid.
De setup kost minuten.
Pull de image, start de container, download een model en je bent klaar om te bouwen. Of je nu een AI-assistent prototype, private RAG-pijplijnen draait of gewoon met verschillende modellen experimenteert, deze combinatie geeft je enterprise-grade mogelijkheden op je laptop.
Probeer het nu. Kies een model dat bij je hardware past, start de Ollama-container en ga iets bouwen. De drempel bestaat niet.
Als volgende stap raden we je aan om DeepSeek R1 lokaal met Ollama op te zetten en te draaien.
Topcursussen bij DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

