
Kursus
Bekerja dengan OpenAI API
3 jam
178.4K
Saat bekerja dengan model OpenAI GPT di Python, memantau biaya itu penting. Di sinilah library tiktoken berguna—alat yang memudahkan Anda memperkirakan berapa banyak biaya panggilan API dengan mengonversi teks menjadi token, yaitu unit dasar yang digunakan GPT dan LLM lainnya untuk memahami dan menghasilkan teks.
Di sini, kita akan membahas apa itu tokenisasi dan mengapa hal itu penting bagi model bahasa, memperkenalkan Byte Pair Encoding (BPE), lalu menelusuri bagaimana library tiktoken dapat membantu Anda memprediksi biaya penggunaan GPT secara efektif.
Tokenisasi adalah proses inti dalam pengoperasian GPT atau model bahasa lainnya, berperan sebagai langkah pertama untuk menerjemahkan bahasa alami ke dalam format yang dapat dipahami dan diproses oleh sistem AI canggih ini.
Intinya, tokenisasi memecah teks menjadi bagian-bagian kecil yang mudah dikelola yang disebut token. Token ini bisa berupa kata, bagian kata, atau bahkan karakter individual, bergantung pada metode tokenisasi yang digunakan.
Tokenisasi yang efektif sangat penting karena secara langsung memengaruhi kemampuan model untuk menafsirkan teks masukan, menghasilkan respons yang koheren dan sesuai konteks, serta memperkirakan biaya komputasi dengan akurat.
Byte Pair Encoding (BPE) adalah metode tokenisasi khusus yang menonjol karena digunakan pada model GPT dan aplikasi pemrosesan bahasa alami (NLP) lainnya. BPE menyeimbangkan antara kehalusan tokenisasi tingkat karakter dan cakupan yang lebih luas dari tokenisasi tingkat kata.
BPE bekerja dengan terus-menerus menggabungkan pasangan byte (atau karakter) yang paling sering muncul dalam teks menjadi satu token baru. Proses ini berlanjut untuk jumlah iterasi yang telah ditentukan atau hingga ukuran kosakata yang diinginkan tercapai.
Signifikansi BPE pada LLM tidak bisa diremehkan. BPE memungkinkan model menangani beragam kosakata secara efisien, termasuk kata umum, kata langka, dan bahkan neologisme, tanpa memerlukan kosakata tetap yang sangat besar dan sulit dikelola.
Adaptabilitas ini dicapai dengan memecah kata-kata yang kurang umum menjadi sub-kata atau karakter yang kemungkinan muncul dalam konteks lain, sehingga memungkinkan model merangkai makna istilah yang tidak dikenal dari komponen yang sudah diketahui.
Beberapa karakteristik utama BPE adalah:
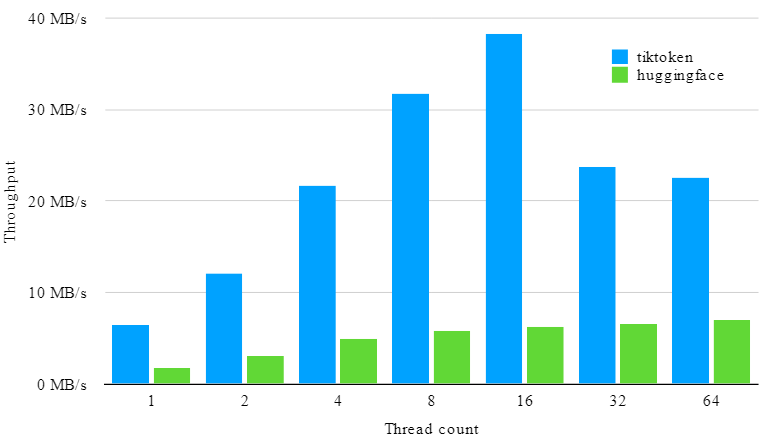
tiktoken adalah algoritma BPE yang cepat yang dikembangkan oleh OpenAI. Versi open-source dari algoritma ini tersedia di banyak library, termasuk Python. Menurut GitHub mereka, tiktoken 3–6x lebih cepat daripada tokenizer open-source sebanding.
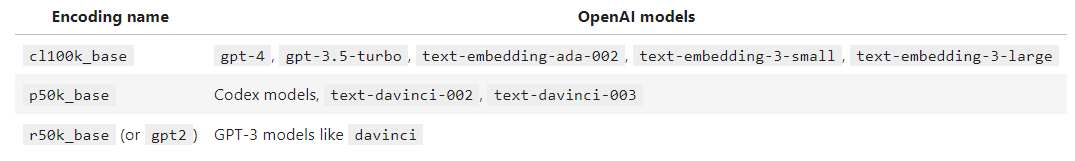
Library tiktoken mendukung tiga metode pengodean yang berbeda. Encoding menentukan metode mengubah teks menjadi token. Model yang berbeda menggunakan encoding yang berbeda.
Library tiktoken dapat mengodekan string teks menjadi token, dan karena kita mengetahui nama encoding untuk model yang digunakan, kita dapat memakai library ini untuk memperkirakan biaya panggilan API sebelum melakukan panggilan.
!pip install openai tiktokenMetode tiktoken.get_encoding mengembalikan encoding yang relevan
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Keluaran:
>>> <Encoding 'cl100k_base'>
Sebagai alternatif, Anda juga dapat memuatnya dari nama model dengan menggunakan metode tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Sekarang yang perlu Anda lakukan hanyalah meneruskan string ke metode encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Keluaran:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
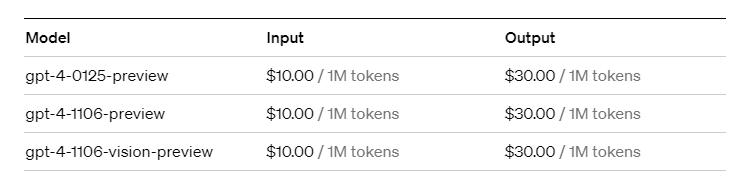
Anda cukup memanggil metode length untuk mengetahui berapa banyak token dalam string ini. Harga untuk model ini dapat ditemukan di situs web OpenAI.
Dalam contoh ini, kita memiliki 15 token masukan. Harga GPT-4 sebesar $10/1M token masukan berarti biaya untuk kueri ini adalah $0,00015 ($10 / 1.000.000 * 15).
Karena algoritma BPE sepenuhnya reversibel, Anda dapat menggunakan metode decode untuk kembali dari token ke string teks.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Keluaran:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Menavigasi biaya penggunaan model GPT di Python tidak perlu menjadi tebak-tebakan, berkat library tiktoken. Dengan memahami tokenisasi, khususnya metode Byte Pair Encoding (BPE), dan memanfaatkan tiktoken, Anda dapat memperkirakan biaya yang terkait dengan panggilan API GPT secara akurat. Panduan ini telah mengulas dasar-dasar tokenisasi, efisiensi BPE, dan proses sederhana menggunakan tiktoken untuk mengubah teks menjadi token—dan kembali lagi—sambil tetap cermat terhadap anggaran Anda.
Baik Anda sedang mengoptimalkan biaya, menguji ide baru, atau menskalakan aplikasi, memiliki pengetahuan dan alat ini memastikan Anda selalu terinformasi dan mengendalikan biaya penggunaan GPT. Ingat, mengelola biaya komputasi sama pentingnya dengan pekerjaan inovatif yang Anda lakukan dengan model GPT. Dengan tiktoken, Anda siap untuk membuat setiap token—dan setiap dolar—berharga.
Jika Anda tertarik mendalami embeddings dan membuka aplikasi AI tingkat lanjut seperti pencarian semantik dan mesin rekomendasi, lihat Introduction to Embeddings with the OpenAI API dari DataCamp.
Jika Anda pemula dan ingin mendapatkan panduan praktis langkah demi langkah untuk OpenAI API, lihat Working With The OpenAI API course kami dan A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices di Datacamp.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt



