Curso
Trabalhar com a API da OpenAI
3 h
172.6K
Ao trabalhar com modelos GPT da OpenAI em Python, ficar de olho nos custos é fundamental. É aí que entra a biblioteca tiktoken — uma ferramenta que facilita estimar quanto você vai gastar com chamadas à API, convertendo texto em tokens, que são os blocos básicos que o GPT e outros LLMs usam para entender e gerar texto.
Aqui, vamos explorar o que é tokenização e por que ela é importante para modelos de linguagem, apresentar o Byte Pair Encoding (BPE) e, em seguida, mostrar como a biblioteca tiktoken pode ajudar você a prever de forma eficiente os custos de uso do GPT.
Tokenização é um processo central no funcionamento do GPT e de outros modelos de linguagem, servindo como o primeiro passo para traduzir a linguagem natural em um formato que esses sistemas avançados de IA conseguem entender e processar.
Em essência, a tokenização divide o texto em partes menores e manejáveis chamadas tokens. Esses tokens podem ser palavras, partes de palavras ou até caracteres individuais, dependendo do método de tokenização utilizado.
Uma boa tokenização é crucial, pois influencia diretamente a capacidade do modelo de interpretar o texto de entrada, gerar respostas coerentes e contextualmente adequadas e estimar com precisão os custos computacionais.
Byte Pair Encoding (BPE) é um método específico de tokenização que ganhou destaque pelo uso em modelos GPT e outras aplicações de processamento de linguagem natural (PLN). O BPE equilibra a granularidade da tokenização em nível de caractere com o escopo mais amplo da tokenização em nível de palavra.
Ele funciona mesclando iterativamente o par de bytes (ou caracteres) mais frequente no texto em um único token novo. Esse processo continua por um número predefinido de iterações ou até atingir o tamanho de vocabulário desejado.
A importância do BPE em LLMs é enorme. O BPE permite que esses modelos lidem de forma eficiente com um vocabulário vasto — incluindo palavras comuns, raras e até neologismos — sem precisar de um vocabulário fixo excessivamente grande e difícil de gerenciar.
Essa adaptabilidade é alcançada ao decompor palavras menos comuns em subpalavras ou caracteres que provavelmente aparecem em outros contextos, permitindo ao modelo reconstruir o significado de termos desconhecidos a partir de componentes já conhecidos.
Algumas características-chave do BPE são:
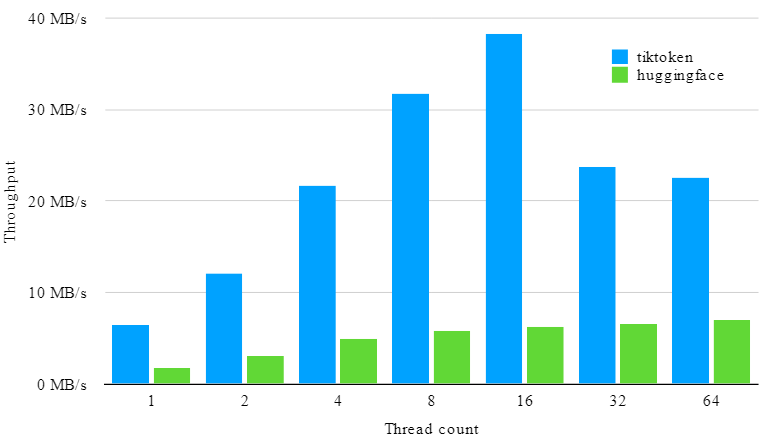
tiktoken é o algoritmo BPE rápido desenvolvido pela OpenAI. A versão open source do algoritmo está disponível em várias bibliotecas, incluindo Python. Segundo o GitHub, tiktoken é de 3 a 6 vezes mais rápido que um tokenizador open source comparável.
A biblioteca tiktoken oferece três métodos de codificação diferentes. As codificações determinam como o texto é transformado em tokens. Modelos diferentes usam codificações diferentes.
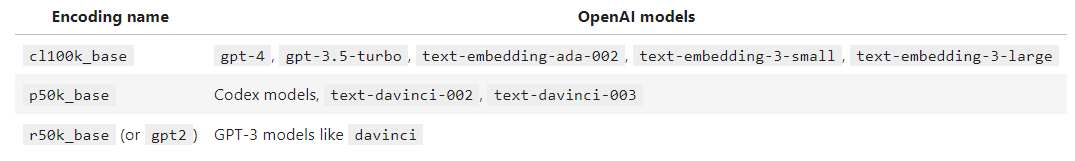
A biblioteca tiktoken pode codificar strings de texto em tokens e, como sabemos o nome da codificação do modelo que estamos usando, podemos utilizá-la para estimar o custo das chamadas à API antes de executá-las.
!pip install openai tiktokenO método tiktoken.get_encoding retorna a codificação relevante
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Saída:
>>> <Encoding 'cl100k_base'>
Como alternativa, você também pode carregá-la a partir do nome do modelo usando o método tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Agora, basta passar a string para o método encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Saída:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
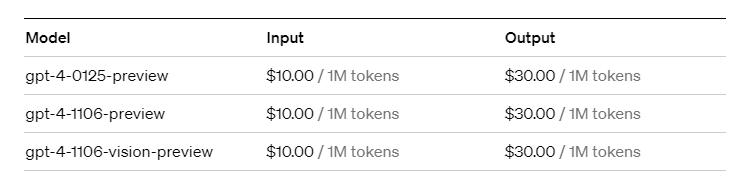
Você pode simplesmente chamar o método length para saber quantos tokens há nessa string. A precificação deste modelo pode ser encontrada no site da OpenAI.
Neste exemplo, temos 15 tokens de entrada. O preço do GPT-4 a US$ 10 por 1 milhão de tokens de entrada significa que o custo desta consulta será de US$ 0,00015 (US$ 10 / 1.000.000 * 15).
Como o algoritmo BPE é totalmente reversível, você pode usar o método decode para voltar de token para string de texto.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Saída:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Navegar pelos custos de uso de modelos GPT em Python não precisa ser um jogo de adivinhação, graças à biblioteca tiktoken. Ao entender a tokenização — em especial o método Byte Pair Encoding (BPE) — e usar o tiktoken, você consegue estimar com precisão os custos associados às suas chamadas à API do GPT. Este guia apresentou os essenciais da tokenização, a eficiência do BPE e o processo simples de usar o tiktoken para transformar texto em tokens — e voltar — enquanto você mantém o orçamento sob controle.
Seja para otimizar custos, testar novas ideias ou escalar suas aplicações, ter esse conhecimento e essa ferramenta à mão garante que você esteja sempre informado e no comando dos custos de uso do GPT. Lembre-se: gerenciar despesas computacionais é tão importante quanto o trabalho inovador que você está fazendo com modelos GPT. Com o tiktoken, você está bem equipado para fazer cada token — e cada dólar — valer a pena.
Se quiser se aprofundar em embeddings e destravar aplicações de IA mais avançadas, como busca semântica e mecanismos de recomendação, confira o curso Introduction to Embeddings with the OpenAI API da DataCamp.
Se você é iniciante e quer um guia prático, passo a passo, sobre a OpenAI API, confira nosso curso Working With The OpenAI API e nosso A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices na DataCamp.
Comece sua jornada em IA hoje mesmo!
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Nisha Arya Ahmed
10 min
Tutorial
Dimitri Didmanidze
5 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Moez Ali
13 min
Tutorial
Moez Ali
11 min