在 Python 中使用 OpenAI GPT 模型时,关注成本至关重要。这正是 tiktoken 库发挥作用的地方——它通过将文本转换为令牌(tokens)来帮助您直接估算 API 调用的花费;令牌是 GPT 和其他大语言模型(LLM)用来理解和生成文本的基本构件。
本文将介绍什么是分词及其对语言模型的重要性,带您了解字节对编码(Byte Pair Encoding,BPE),并进一步演示如何使用 tiktoken 库有效预测 GPT 的使用成本。
什么是分词(Tokenization)
分词是 GPT 或其他语言模型运行中的核心流程,是将自然语言转化为这些先进 AI 系统可以理解和处理的格式的第一步。
从本质上讲,分词会把文本拆分为更小、更易管理的片段,即“令牌”。根据所采用的分词方法,这些令牌可以是单词、词的一部分,甚至是单个字符。
高效的分词至关重要,它直接影响模型对输入文本的理解能力、生成连贯且符合语境的响应的能力,以及对计算成本的准确估算。
字节对编码(BPE)
字节对编码(BPE)是一种在 GPT 模型和其他自然语言处理(NLP)应用中广泛使用的特定分词方法。BPE 在字符级分词的细粒度与词级分词的广泛性之间取得了平衡。
其工作方式是迭代地将文本中出现频率最高的一对字节(或字符)合并为一个新的令牌。该过程会持续预设的迭代次数,或直到达到目标词表大小为止。
BPE 在大语言模型(LLM)中的重要性不言而喻。它使模型能够高效处理海量词汇,包括常见词、罕见词,甚至新词,而无需一个庞大笨重的固定词表。
这种适应性通过将不常见的词拆分为在其他语境中也可能出现的子词或字符来实现,从而让模型能够根据已知组成部分拼合出陌生词语的含义。
BPE 的一些关键特性包括:
- 它是可逆的,确保信息不丢失,能够从令牌完美还原原始文本。例如,如果“exciting”被转换为 [12 34 39 10 23],则该向量可以无损还原回“exciting”。
- BPE 可以处理任何文本,即使该文本不在模型的初始训练集中,因此非常通用。
- 该方法能有效压缩文本,分词后的长度通常短于原文。平均而言,每个令牌大约代表原文本的四个字节。
- BPE 还帮助模型识别并理解常见的词缀或词根。例如,英语中常见的“ing”,因此 BPE 会把“exciting”分成“excit”和“ing”。在不同语境下对“ing”等常见子词的反复接触,能增强模型对语法的把握和对语言模式的泛化能力。
tiktoken
tiktoken 是 OpenAI 开发的高速 BPE 算法。该算法的开源实现已集成到多个库中,包括 Python。根据其GitHub,tiktoken 比同类开源分词器快 3–6 倍。
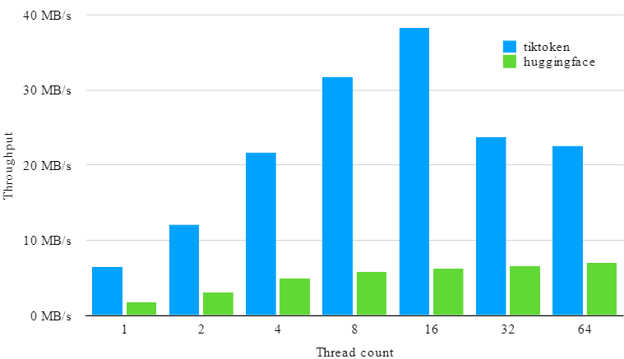
来源
tiktoken 库支持三种不同的编码方法。编码决定了文本被转换为令牌的方式。不同模型使用不同的编码。
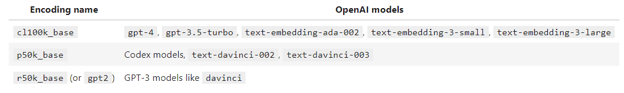
来源
在 Python 中使用 tiktoken 库估算 GPT 成本
tiktoken 库可以将文本字符串编码为令牌,而由于我们知道所用模型的编码名称,因此可以在发起调用之前,借助该库估算 API 调用的成本。
步骤 1. 安装 tiktoken
!pip install openai tiktoken技术支持
步骤 2. 加载一种编码
tiktoken.get_encoding 方法会返回相关的编码
encoding = tiktoken.get_encoding("cl100k_base")
encoding
技术支持
输出:
>>> <Encoding 'cl100k_base'>
或者,您也可以使用 tiktoken.encoding_for_model 方法通过模型名称来加载。
encoding = tiktoken.encoding_for_model("gpt-4")技术支持
步骤 3. 将文本转换为令牌
现在只需将字符串传入 encode 方法即可。
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")技术支持
输出:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
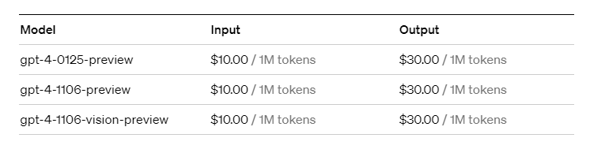
您可以直接调用 length 方法来查看此字符串包含多少个令牌。该模型的定价可在 OpenAI 官网查看。
在此示例中,我们有 15 个输入令牌。GPT-4 的价格为每 100 万个输入令牌 10 美元,这意味着本次查询的成本为 0.00015 美元(10 美元 / 1,000,000 × 15)。
由于 BPE 算法是完全可逆的,您可以使用 decode 方法将令牌还原为文本字符串。
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])技术支持
输出:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
结语
借助 tiktoken 库,在 Python 中使用 GPT 模型的成本不必再靠猜测。通过理解分词,尤其是字节对编码(BPE)方法,并结合 tiktoken,您可以准确估算与 GPT API 调用相关的费用。本文带您回顾了分词要点、BPE 的高效性,以及使用 tiktoken 将文本转换为令牌并可逆还原的简明流程,同时兼顾预算控制。
无论您是在优化成本、测试新想法,还是扩展应用,只要掌握这套知识与工具,您就能始终明晰并掌控 GPT 的使用成本。请记住,管理计算开销与您用 GPT 开展的创新工作同样重要。有了 tiktoken,您就能让每个令牌——以及每一美元——都物尽其用。
如果您希望深入研究向量嵌入并解锁更多高级 AI 应用(如语义搜索与推荐引擎),欢迎查看 DataCamp 的《使用 OpenAI API 的嵌入入门》课程。
如果您是初学者并希望获得关于 OpenAI API 的动手式、循序渐进指南,欢迎查看我们的《使用 OpenAI API》课程以及 Datacamp 上的《OpenAI API 新手指南:实践教程与最佳实践》。


在 Python 中使用 OpenAI GPT 模型时,关注成本至关重要。这正是 tiktoken 库发挥作用的地方——它通过将文本转换为令牌(tokens)来帮助您直接估算 API 调用的花费;令牌是 GPT 和其他大语言模型(LLM)用来理解和生成文本的基本构件。
本文将介绍什么是分词及其对语言模型的重要性,带您了解字节对编码(Byte Pair Encoding,BPE),并进一步演示如何使用 tiktoken 库有效预测 GPT 的使用成本。
什么是分词(Tokenization)
分词是 GPT 或其他语言模型运行中的核心流程,是将自然语言转化为这些先进 AI 系统可以理解和处理的格式的第一步。
从本质上讲,分词会把文本拆分为更小、更易管理的片段,即“令牌”。根据所采用的分词方法,这些令牌可以是单词、词的一部分,甚至是单个字符。
高效的分词至关重要,它直接影响模型对输入文本的理解能力、生成连贯且符合语境的响应的能力,以及对计算成本的准确估算。
字节对编码(BPE)
字节对编码(BPE)是一种在 GPT 模型和其他自然语言处理(NLP)应用中广泛使用的特定分词方法。BPE 在字符级分词的细粒度与词级分词的广泛性之间取得了平衡。
其工作方式是迭代地将文本中出现频率最高的一对字节(或字符)合并为一个新的令牌。该过程会持续预设的迭代次数,或直到达到目标词表大小为止。
BPE 在大语言模型(LLM)中的重要性不言而喻。它使模型能够高效处理海量词汇,包括常见词、罕见词,甚至新词,而无需一个庞大笨重的固定词表。
这种适应性通过将不常见的词拆分为在其他语境中也可能出现的子词或字符来实现,从而让模型能够根据已知组成部分拼合出陌生词语的含义。
BPE 的一些关键特性包括:
tiktoken
tiktoken 是 OpenAI 开发的高速 BPE 算法。该算法的开源实现已集成到多个库中,包括 Python。根据其GitHub,tiktoken 比同类开源分词器快 3–6 倍。
来源
tiktoken 库支持三种不同的编码方法。编码决定了文本被转换为令牌的方式。不同模型使用不同的编码。
来源
在 Python 中使用 tiktoken 库估算 GPT 成本
tiktoken 库可以将文本字符串编码为令牌,而由于我们知道所用模型的编码名称,因此可以在发起调用之前,借助该库估算 API 调用的成本。
步骤 1. 安装 tiktoken
步骤 2. 加载一种编码
tiktoken.get_encoding方法会返回相关的编码输出:
>>> <Encoding 'cl100k_base'>或者,您也可以使用
tiktoken.encoding_for_model方法通过模型名称来加载。步骤 3. 将文本转换为令牌
现在只需将字符串传入
encode方法即可。输出:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]您可以直接调用
length方法来查看此字符串包含多少个令牌。该模型的定价可在 OpenAI 官网查看。在此示例中,我们有 15 个输入令牌。GPT-4 的价格为每 100 万个输入令牌 10 美元,这意味着本次查询的成本为 0.00015 美元(10 美元 / 1,000,000 × 15)。
由于 BPE 算法是完全可逆的,您可以使用
decode方法将令牌还原为文本字符串。输出:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’结语
借助 tiktoken 库,在 Python 中使用 GPT 模型的成本不必再靠猜测。通过理解分词,尤其是字节对编码(BPE)方法,并结合 tiktoken,您可以准确估算与 GPT API 调用相关的费用。本文带您回顾了分词要点、BPE 的高效性,以及使用 tiktoken 将文本转换为令牌并可逆还原的简明流程,同时兼顾预算控制。
无论您是在优化成本、测试新想法,还是扩展应用,只要掌握这套知识与工具,您就能始终明晰并掌控 GPT 的使用成本。请记住,管理计算开销与您用 GPT 开展的创新工作同样重要。有了 tiktoken,您就能让每个令牌——以及每一美元——都物尽其用。
如果您希望深入研究向量嵌入并解锁更多高级 AI 应用(如语义搜索与推荐引擎),欢迎查看 DataCamp 的《使用 OpenAI API 的嵌入入门》课程。
如果您是初学者并希望获得关于 OpenAI API 的动手式、循序渐进指南,欢迎查看我们的《使用 OpenAI API》课程以及 Datacamp 上的《OpenAI API 新手指南:实践教程与最佳实践》。