
Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Wenn du in Python mit OpenAI-GPT-Modellen arbeitest, ist ein Blick auf die Kosten entscheidend. Genau hier kommt die Bibliothek tiktoken ins Spiel — sie hilft dir, Ausgaben für API-Aufrufe abzuschätzen, indem Text in Tokens umgewandelt wird. Tokens sind die Bausteine, mit denen GPT und andere LLMs Text verstehen und generieren.
Hier schauen wir uns an, was Tokenisierung ist und warum sie für Sprachmodelle wichtig ist, führen dich in Byte Pair Encoding (BPE) ein und zeigen anschließend, wie dir die tiktoken-Bibliothek hilft, die GPT-Nutzungskosten präzise vorherzusagen.
Tokenisierung ist ein Kernprozess beim Einsatz von GPT und anderen Sprachmodellen. Sie ist der erste Schritt, um natürliche Sprache in ein Format zu übersetzen, das diese KI-Systeme verstehen und verarbeiten können.
Im Kern zerlegt die Tokenisierung Text in kleinere, handhabbare Einheiten, sogenannte Tokens. Je nach Methode können das Wörter, Wortbestandteile oder sogar einzelne Zeichen sein.
Gute Tokenisierung ist entscheidend, denn sie beeinflusst direkt, wie gut ein Modell Eingabetext interpretiert, kohärente und kontextgerechte Antworten erzeugt und Rechenkosten zuverlässig abschätzt.
Byte Pair Encoding (BPE) ist eine spezielle Tokenisierungsmethode, die sich in GPT-Modellen und anderen NLP-Anwendungen etabliert hat. BPE findet einen Mittelweg zwischen feingranularer Zeichen-Tokenisierung und grober Wort-Tokenisierung.
Dabei werden iterativ die häufigsten Byte- (oder Zeichen-)Paare im Text zu einem neuen Token zusammengeführt. Dieser Prozess läuft für eine festgelegte Anzahl an Iterationen oder bis eine gewünschte Vokabulargröße erreicht ist.
Die Bedeutung von BPE für LLMs kann kaum überschätzt werden. BPE ermöglicht es, ein sehr breites Vokabular effizient zu handhaben — von häufigen über seltene Wörter bis hin zu Neologismen — ohne ein übergroßes, schwerfälliges Fixvokabular.
Diese Anpassungsfähigkeit entsteht, weil seltene Wörter in Subwörter oder Zeichen zerlegt werden, die auch in anderen Kontexten vorkommen. So kann das Modell die Bedeutung unbekannter Begriffe aus bekannten Bausteinen zusammensetzen.
Zu den wichtigsten Merkmalen von BPE zählen:
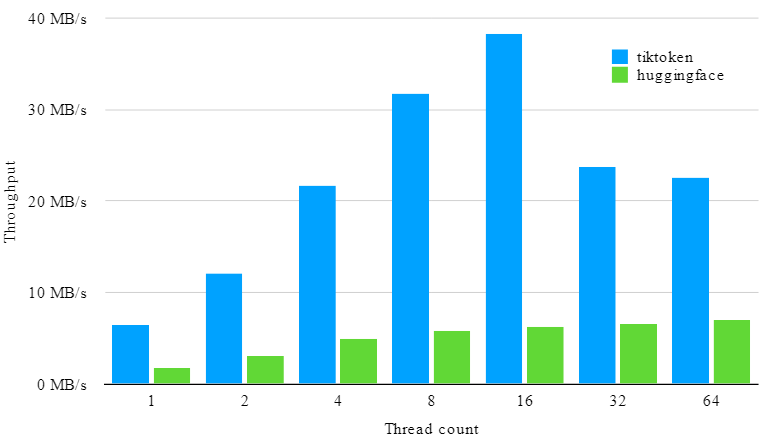
tiktoken ist der schnelle BPE-Algorithmus von OpenAI. Die Open-Source-Variante ist in vielen Bibliotheken verfügbar, unter anderem für Python. Laut GitHub ist tiktoken 3–6× schneller als vergleichbare Open-Source-Tokenizer.
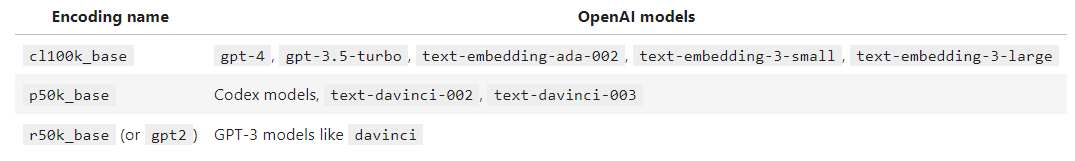
Die tiktoken-Bibliothek unterstützt drei unterschiedliche Encodings. Encodings legen fest, wie Text in Tokens umgewandelt wird. Verschiedene Modelle verwenden unterschiedliche Encodings.
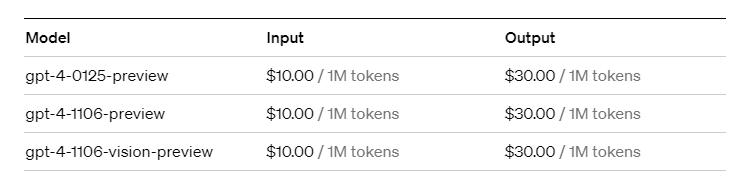
Mit tiktoken kannst du Textstrings in Tokens codieren. Da wir den Encodiernamen für das verwendete Modell kennen, können wir die Bibliothek nutzen, um die Kosten eines API-Aufrufs vorab abzuschätzen.
!pip install openai tiktokenDie Methode tiktoken.get_encoding liefert das passende Encoding.
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Ausgabe:
>>> <Encoding 'cl100k_base'>
Alternativ kannst du es auch über den Modellnamen mit der Methode tiktoken.encoding_for_model laden.
encoding = tiktoken.encoding_for_model("gpt-4")Jetzt übergibst du den String einfach an die Methode encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Ausgabe:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
Mit der Methode length erfährst du, wie viele Tokens der String enthält. Die Preise für das jeweilige Modell findest du auf der OpenAI-Website.
In diesem Beispiel haben wir 15 Eingabetokens. Der Preis für GPT-4 liegt bei 10 $ pro 1 Mio. Eingabetokens — die Kosten für diese Anfrage betragen also 0,00015 $ (10 $ / 1.000.000 * 15).
Da der BPE-Algorithmus vollständig reversibel ist, kannst du mit der Methode decode wieder von Tokens zum Textstring zurückkehren.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Ausgabe:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Die Kosten für die Nutzung von GPT-Modellen in Python müssen dank der tiktoken-Bibliothek kein Ratespiel sein. Wenn du Tokenisierung — insbesondere Byte Pair Encoding (BPE) — verstehst und tiktoken gezielt einsetzt, kannst du die Kosten deiner GPT-API-Aufrufe genau abschätzen. Diese Anleitung hat die Grundlagen der Tokenisierung, die Effizienz von BPE und den einfachen Prozess gezeigt, mit tiktoken Text in Tokens zu verwandeln — und wieder zurück — und dabei dein Budget im Blick zu behalten.
Egal ob du Kosten optimierst, neue Ideen testest oder Anwendungen skalierst: Mit diesem Wissen und Tool triffst du informierte Entscheidungen und behältst deine GPT-Nutzungskosten im Griff. Denk daran: Das Managen von Rechenkosten ist genauso wichtig wie die Innovationen, die du mit GPT ermöglichst. Mit tiktoken holst du aus jedem Token — und jedem Dollar — das Maximum heraus.
Wenn du tiefer in Embeddings einsteigen und fortgeschrittene KI-Anwendungen wie semantische Suche oder Empfehlungssysteme erschließen möchtest, schau dir DataCamps Introduction to Embeddings with the OpenAI API an.
Wenn du Anfänger bist und eine praxisnahe Schritt-für-Schritt-Einführung in die OpenAI API suchst, wirf einen Blick auf unseren Kurs Working With The OpenAI API und unser Tutorial A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices auf DataCamp.
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs