
Cours
Travailler avec l'API OpenAI
3 h
173.1K
Lorsque vous travaillez avec les modèles OpenAI GPT en Python, surveiller les coûts est essentiel. C’est là qu’intervient la bibliothèque tiktoken : un outil qui facilite l’estimation de vos dépenses d’appels d’API en convertissant le texte en jetons, les unités de base que GPT et d’autres LLM utilisent pour comprendre et générer du texte.
Nous allons ici expliquer ce qu’est la tokenisation et pourquoi elle est importante pour les modèles de langage, vous présenter le Byte Pair Encoding (BPE), puis voir comment la bibliothèque tiktoken peut vous aider à prévoir efficacement les coûts d’usage de GPT.
La tokenisation est un processus clé dans le fonctionnement de GPT et des autres modèles de langage, constituant la première étape pour traduire le langage naturel dans un format que ces systèmes d’IA avancés peuvent comprendre et traiter.
Concrètement, la tokenisation consiste à découper un texte en unités plus petites et gérables appelées jetons. Selon la méthode utilisée, ces jetons peuvent correspondre à des mots, des sous-mots ou même des caractères individuels.
Une tokenisation efficace est essentielle, car elle influe directement sur la capacité du modèle à interpréter les entrées, à générer des réponses cohérentes et contextuellement pertinentes, et à estimer précisément les coûts de calcul.
Le Byte Pair Encoding (BPE) est une méthode de tokenisation devenue incontournable dans les modèles GPT et d’autres applications de traitement automatique du langage (NLP). BPE trouve un juste équilibre entre la granularité de la tokenisation au niveau des caractères et l’ampleur de celle au niveau des mots.
Le principe : fusionner itérativement la paire de bytes (ou de caractères) la plus fréquente du texte en un nouveau jeton unique. Le processus se poursuit pendant un nombre d’itérations prédéfini ou jusqu’à atteindre la taille de vocabulaire souhaitée.
L’importance de BPE dans les LLM est majeure. BPE permet de gérer efficacement un vocabulaire très vaste — mots courants, rares, voire néologismes — sans recourir à un vocabulaire fixe, trop volumineux et peu maniable.
Cette adaptabilité repose sur la décomposition des mots moins fréquents en sous-mots ou en caractères susceptibles d’apparaître dans d’autres contextes, ce qui aide le modèle à reconstituer le sens de termes inconnus à partir d’éléments connus.
Voici quelques caractéristiques clés de BPE :
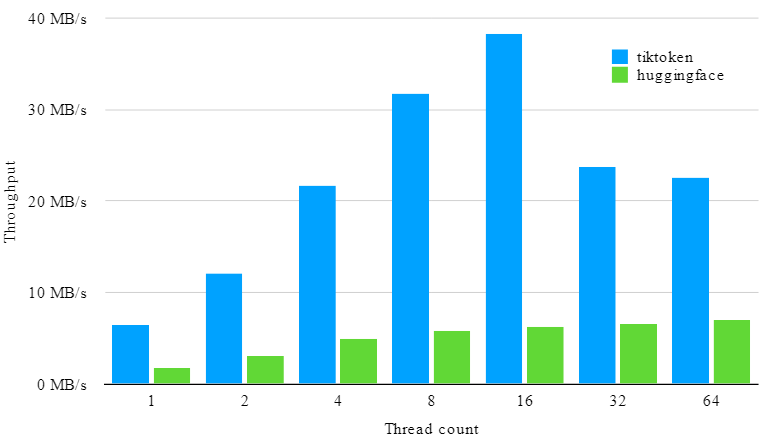
tiktoken est l’algorithme BPE rapide développé par OpenAI. Sa version open source est disponible dans de nombreuses bibliothèques, dont Python. D’après leur GitHub, tiktoken est 3 à 6 fois plus rapide qu’un tokenizer open source comparable.
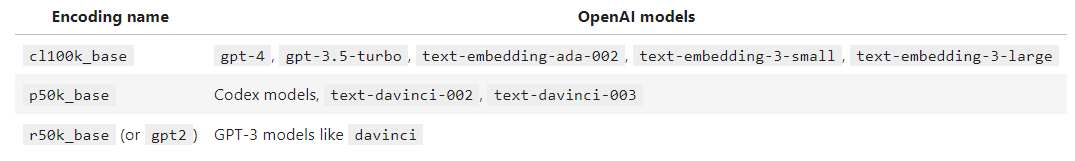
La bibliothèque tiktoken prend en charge trois méthodes d’encodage différentes. Les encodages déterminent la façon dont le texte est transformé en jetons. Différents modèles utilisent des encodages différents.
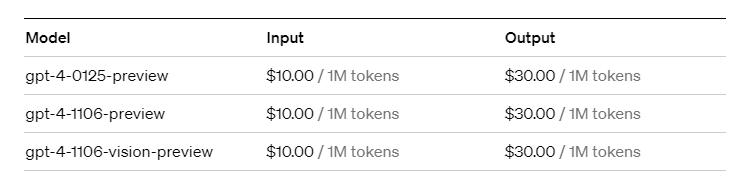
La bibliothèque tiktoken peut encoder des chaînes de texte en jetons et, puisque nous connaissons le nom d’encodage du modèle utilisé, nous pouvons l’employer pour estimer le coût des appels d’API avant de les exécuter.
!pip install openai tiktokenLa méthode tiktoken.get_encoding renvoie l’encodage approprié.
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Sortie :
>>> <Encoding 'cl100k_base'>
Vous pouvez aussi le charger à partir du nom du modèle avec la méthode tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Il vous suffit maintenant de passer la chaîne à la méthode encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Sortie :
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
Vous pouvez simplement utiliser la méthode length pour connaître le nombre de jetons dans cette chaîne. La tarification de ce modèle est disponible sur le site d’OpenAI.
Dans cet exemple, nous avons 15 jetons en entrée. Le prix de GPT-4 à 10 $ par million de jetons en entrée implique que le coût de cette requête sera de 0,00015 $ (10 $ / 1 000 000 × 15).
Comme l’algorithme BPE est entièrement réversible, vous pouvez utiliser la méthode decode pour revenir des jetons au texte.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Sortie :
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Grâce à la bibliothèque tiktoken, estimer le coût d’utilisation des modèles GPT en Python n’a rien d’hasardeux. En comprenant la tokenisation — et en particulier la méthode Byte Pair Encoding (BPE) — puis en exploitant tiktoken, vous pouvez évaluer avec précision les coûts associés à vos appels d’API GPT. Ce guide vous a présenté l’essentiel de la tokenisation, l’efficacité du BPE et la simplicité de tiktoken pour convertir un texte en jetons — et inversement — tout en gardant un œil sur votre budget.
Que vous optimisiez vos dépenses, testiez de nouvelles idées ou passiez à l’échelle, disposer de ces connaissances et de cet outil vous permet de rester informé et maître de vos coûts d’usage de GPT. N’oubliez pas : gérer les dépenses de calcul est aussi crucial que l’innovation que vous menez avec les modèles GPT. Avec tiktoken, vous avez tout ce qu’il faut pour faire compter chaque jeton — et chaque dollar.
Si vous souhaitez aller plus loin dans les embeddings et activer des applications d’IA avancées comme la recherche sémantique ou les moteurs de recommandation, découvrez le cours de DataCamp : Introduction to Embeddings with the OpenAI API.
Si vous débutez et voulez un guide pratique, pas à pas, sur l’API OpenAI, consultez notre cours Working With The OpenAI API ainsi que notre tutoriel A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices sur DataCamp.
Commencez votre parcours en IA dès aujourd’hui !
Cours
Cours
Cours