
Curso
Trabajar con la API de OpenAI
3 h
172.6K
Cuando trabajas con modelos OpenAI GPT en Python, vigilar los costes es clave. Ahí entra en juego la librería tiktoken: una herramienta que facilita estimar cuánto gastarás en llamadas a la API convirtiendo texto en tokens, las piezas básicas que GPT y otros LLM usan para comprender y generar texto.
Aquí veremos qué es la tokenización y por qué es importante para los modelos de lenguaje, te presentaremos Byte Pair Encoding (BPE) y luego entraremos en cómo la librería tiktoken puede ayudarte a prever de forma eficaz el coste de uso de GPT.
La tokenización es un proceso fundamental en el funcionamiento de GPT y otros modelos de lenguaje, y constituye el primer paso para traducir el lenguaje natural a un formato que estos avanzados sistemas de IA puedan entender y procesar.
En esencia, la tokenización consiste en descomponer el texto en unidades más pequeñas y manejables llamadas tokens. Estos tokens pueden ser palabras, partes de palabras o incluso caracteres individuales, según el método de tokenización empleado.
Una tokenización eficaz es crucial porque influye directamente en la capacidad del modelo para interpretar el texto de entrada, generar respuestas coherentes y adecuadas al contexto y estimar con precisión los costes computacionales.
Byte Pair Encoding (BPE) es un método de tokenización específico que ha ganado protagonismo por su uso en modelos GPT y otras aplicaciones de procesamiento del lenguaje natural (NLP). BPE logra un equilibrio entre la granularidad de la tokenización a nivel de carácter y el mayor alcance de la tokenización a nivel de palabra.
Funciona uniendo de forma iterativa el par de bytes (o caracteres) más frecuente del texto en un token nuevo. Este proceso continúa durante un número predefinido de iteraciones o hasta alcanzar el tamaño de vocabulario deseado.
La importancia de BPE en los LLM no puede subestimarse. BPE permite a estos modelos manejar con eficiencia un vocabulario amplísimo, que incluye palabras comunes, raras e incluso neologismos, sin necesitar un vocabulario fijo excesivamente grande y difícil de gestionar.
Esta adaptabilidad se consigue descomponiendo las palabras menos frecuentes en subpalabras o caracteres que probablemente aparezcan en otros contextos, lo que permite al modelo recomponer el significado de términos desconocidos a partir de componentes conocidos.
Algunas características clave de BPE son:
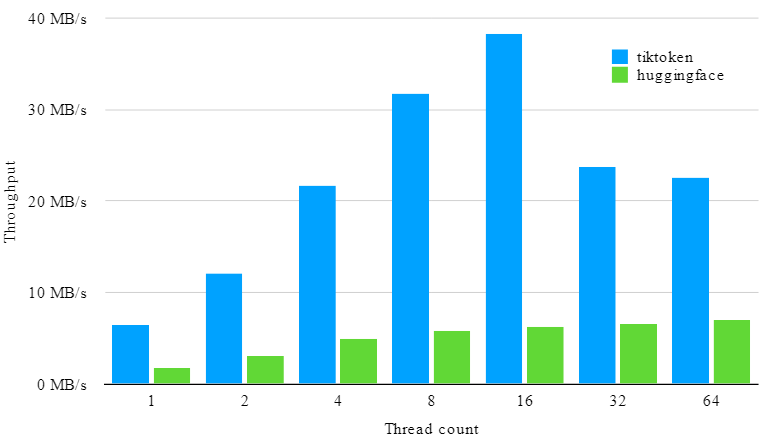
tiktoken es el algoritmo BPE rápido desarrollado por OpenAI. La versión de código abierto del algoritmo está disponible en muchas librerías, incluida Python. Según su GitHub, tiktoken es entre 3 y 6 veces más rápido que un tokenizador de código abierto comparable.
La librería tiktoken admite tres métodos de codificación diferentes. Las codificaciones determinan el modo en que el texto se transforma en tokens. Distintos modelos usan codificaciones distintas.
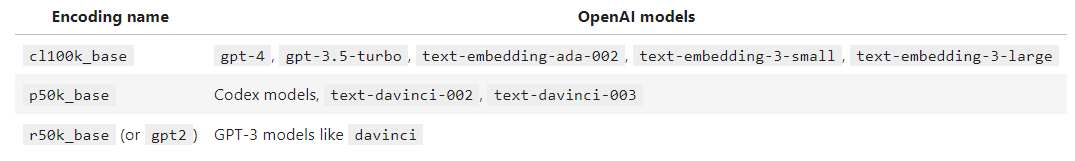
La librería tiktoken puede codificar cadenas de texto en tokens y, como conocemos el nombre de la codificación del modelo que estamos usando, podemos emplearla para estimar el coste de las llamadas a la API antes de realizarlas.
!pip install openai tiktokenEl método tiktoken.get_encoding devuelve la codificación correspondiente.
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Salida:
>>> <Encoding 'cl100k_base'>
Como alternativa, también puedes cargarla a partir del nombre del modelo usando el método tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Ahora solo tienes que pasar la cadena al método encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Salida:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
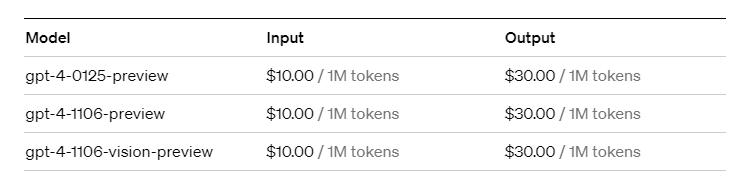
Puedes simplemente llamar al método length para saber cuántos tokens hay en esta cadena. El precio para este modelo puede consultarse en el sitio web de OpenAI.
En este ejemplo tenemos 15 tokens de entrada. El precio de GPT-4 a 10 $ por cada millón de tokens de entrada significa que el coste de esta consulta será de 0,00015 $ (10 $ / 1.000.000 * 15).
Como el algoritmo BPE es totalmente reversible, puedes usar el método decode para volver de los tokens a la cadena de texto.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Salida:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Calcular el coste de usar modelos GPT en Python no tiene por qué ser un juego de adivinanzas gracias a la librería tiktoken. Si entiendes la tokenización, en particular el método Byte Pair Encoding (BPE), y aprovechas tiktoken, podrás estimar con precisión los costes asociados a tus llamadas a la API de GPT. Esta guía te ha mostrado lo esencial de la tokenización, la eficiencia de BPE y el proceso sencillo para usar tiktoken y convertir texto en tokens —y viceversa— sin perder de vista tu presupuesto.
Tanto si optimizas costes, como si pruebas ideas nuevas o escalas tus aplicaciones, contar con este conocimiento y esta herramienta te asegura que siempre tendrás el control de tus gastos de uso de GPT. Recuerda: gestionar el gasto computacional es tan importante como el trabajo innovador que haces con los modelos GPT. Con tiktoken, estás listo para que cada token —y cada dólar— cuente.
Si te interesa profundizar en embeddings y desbloquear aplicaciones de IA más avanzadas como la búsqueda semántica y los motores de recomendación, echa un vistazo al curso de DataCamp Introduction to Embeddings with the OpenAI API.
Si estás empezando y quieres una guía práctica paso a paso sobre la API de OpenAI, consulta nuestro curso Working With The OpenAI API y nuestro tutorial A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices en DataCamp.
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
blog
Matt Crabtree
13 min
blog
Abid Ali Awan
9 min
Tutorial
Dimitri Didmanidze
5 min
Tutorial
Zoumana Keita
12 min
Tutorial
Richie Cotton
14 min
Tutorial
Moez Ali
11 min





