
Corso
Lavorare con l'API di OpenAI
3 ore
179.5K
Quando lavori con i modelli OpenAI GPT in Python, tenere d'occhio i costi è fondamentale. Qui entra in gioco la libreria tiktoken: è uno strumento che rende semplice stimare quanto spenderai per le chiamate API convertendo il testo in token, i mattoni di base che GPT e altri LLM usano per comprendere e generare testo.
Qui esploreremo cos'è la tokenizzazione e perché è importante per i modelli linguistici, ti presenteremo il Byte Pair Encoding (BPE) e poi vedremo come la libreria tiktoken può aiutarti a prevedere in modo efficace i costi di utilizzo di GPT.
La tokenizzazione è un processo fondamentale nel funzionamento di GPT e degli altri modelli linguistici, e rappresenta il primo passo per tradurre il linguaggio naturale in un formato che questi avanzati sistemi di IA possano comprendere ed elaborare.
In sostanza, la tokenizzazione consiste nel suddividere il testo in unità più piccole e gestibili chiamate token. A seconda del metodo utilizzato, questi token possono essere parole, parti di parole o anche singoli caratteri.
Una tokenizzazione efficace è cruciale, perché influisce direttamente sulla capacità del modello di interpretare il testo in input, generare risposte coerenti e contestualmente appropriate e stimare con precisione i costi computazionali.
Il Byte Pair Encoding (BPE) è uno specifico metodo di tokenizzazione che ha guadagnato importanza per il suo impiego nei modelli GPT e in altre applicazioni di elaborazione del linguaggio naturale (NLP). BPE trova un equilibrio tra la granularità della tokenizzazione a livello di carattere e l'ampiezza di quella a livello di parola.
Funziona unendo in modo iterativo la coppia di byte (o caratteri) più frequente nel testo in un singolo nuovo token. Questo processo continua per un numero predefinito di iterazioni o fino al raggiungimento di una dimensione del vocabolario desiderata.
L'importanza del BPE negli LLM non può essere sopravvalutata. BPE consente a questi modelli di gestire in modo efficiente un'ampia gamma di vocaboli, incluse parole comuni, rare e perfino neologismi, senza necessitare di un vocabolario fisso eccessivamente grande e ingombrante.
Questa adattabilità si ottiene scomponendo le parole meno comuni in sotto-parole o caratteri che è probabile compaiano in altri contesti, permettendo così al modello di ricostruire il significato di termini non familiari a partire da componenti noti.
Alcune delle caratteristiche chiave del BPE sono:
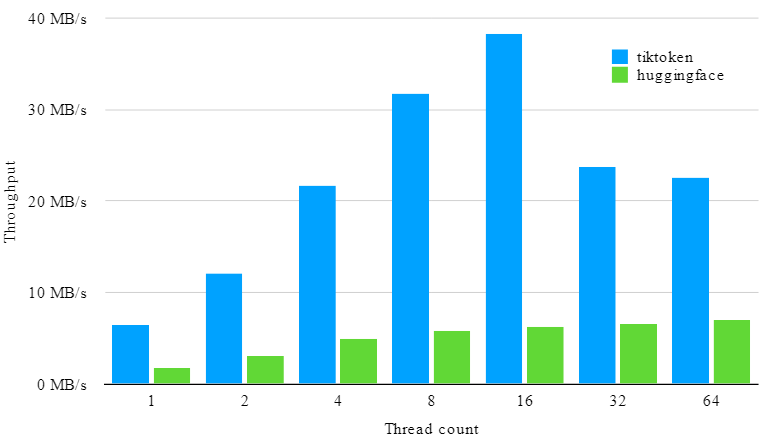
tiktoken è il rapido algoritmo BPE sviluppato da OpenAI. La versione open source dell'algoritmo è disponibile in molte librerie, incluso Python. Secondo il loro GitHub, tiktoken è da 3 a 6 volte più veloce di un tokenizer open source comparabile.
La libreria tiktoken supporta tre diversi metodi di codifica. Le codifiche determinano il modo in cui il testo viene trasformato in token. Modelli diversi usano codifiche diverse.
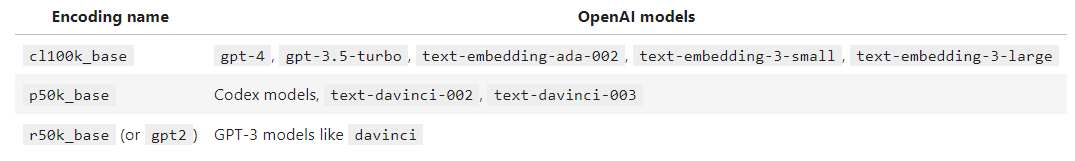
La libreria tiktoken può codificare stringhe di testo in token e, poiché conosciamo il nome della codifica per il modello che stiamo usando, possiamo utilizzarla per stimare il costo delle chiamate API prima di effettuarle.
!pip install openai tiktokenIl metodo tiktoken.get_encoding restituisce la codifica pertinente
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Output:
>>> <Encoding 'cl100k_base'>
In alternativa, puoi anche caricarla dal nome del modello usando il metodo tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Ora ti basta passare la stringa al metodo encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Output:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
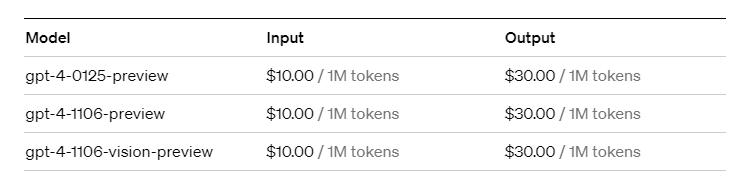
Puoi semplicemente chiamare il metodo length per scoprire quanti token ci sono in questa stringa. I prezzi per questo modello sono disponibili sul sito di OpenAI.
In questo esempio, abbiamo 15 token di input. Il prezzo di GPT-4 pari a $10/1M token di input significa che il costo per questa query sarà di $0,00015 ($10 / 1.000.000 * 15).
Poiché l'algoritmo BPE è completamente reversibile, puoi usare il metodo decode per tornare dai token alla stringa di testo.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Output:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
Orientarsi tra i costi di utilizzo dei modelli GPT in Python non deve essere un salto nel buio, grazie alla libreria tiktoken. Capendo la tokenizzazione, in particolare il metodo Byte Pair Encoding (BPE), e sfruttando tiktoken, puoi stimare accuratamente i costi associati alle tue chiamate API a GPT. Questa guida ti ha accompagnato attraverso le basi della tokenizzazione, l'efficienza del BPE e il processo lineare di utilizzo di tiktoken per trasformare il testo in token—e viceversa—tenendo sempre sotto controllo il budget.
Che tu stia ottimizzando i costi, testando nuove idee o scalando le tue applicazioni, avere queste conoscenze e questo strumento a disposizione ti assicura di essere sempre informato e in controllo dei costi di utilizzo di GPT. Ricorda: gestire le spese computazionali è importante quanto il lavoro innovativo che stai facendo con i modelli GPT. Con tiktoken hai tutto il necessario per far valere ogni token—e ogni dollaro.
Se vuoi approfondire gli embedding e sbloccare applicazioni di IA più avanzate come la ricerca semantica e i motori di raccomandazione, dai un'occhiata a Introduction to Embeddings with the OpenAI API di DataCamp.
Se sei alle prime armi e vuoi una guida pratica, passo dopo passo, all'API di OpenAI, scopri il nostro corso Working With The OpenAI API e la nostra guida A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices su Datacamp.
Inizia oggi il tuo percorso nell'IA!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



