
Last chance! 50% off DataCamp Premium
Sale ends in
जब आप Python में OpenAI GPT मॉडलों के साथ काम करते हैं, तो लागत पर नज़र रखना बेहद ज़रूरी होता है। यहीं tiktoken लाइब्रेरी काम आती है—यह एक ऐसा टूल है जो टेक्स्ट को टोकन में बदलकर API कॉल्स पर होने वाले खर्च का अनुमान लगाना आसान बनाता है। टोकन वे मौलिक इकाइयाँ हैं जिनका उपयोग GPT और अन्य LLM टेक्स्ट को समझने और जनरेट करने के लिए करते हैं।
यहाँ हम देखेंगे कि टोकनाइज़ेशन क्या है और यह भाषा मॉडलों के लिए क्यों महत्वपूर्ण है, आपको Byte Pair Encoding (BPE) से परिचित कराएँगे, और फिर समझेंगे कि tiktoken लाइब्रेरी GPT उपयोग की लागत का प्रभावी अनुमान लगाने में कैसे मदद करती है।
टोकनाइज़ेशन GPT या अन्य भाषा मॉडलों के संचालन की एक मूलभूत प्रक्रिया है, जो प्राकृतिक भाषा को ऐसे प्रारूप में बदलने का पहला कदम है जिसे ये उन्नत AI सिस्टम समझ और प्रोसेस कर सकें।
मूल रूप से, टोकनाइज़ेशन टेक्स्ट को छोटे, प्रबंधनीय हिस्सों यानी टोकन में तोड़ता है। प्रयुक्त विधि के आधार पर ये टोकन शब्द, उपशब्द या यहाँ तक कि एकल अक्षर भी हो सकते हैं।
प्रभावी टोकनाइज़ेशन अहम है, क्योंकि यह सीधे तौर पर मॉडल की इनपुट टेक्स्ट को समझने, सुसंगत और संदर्भानुकूल उत्तर जनरेट करने, और संगणनात्मक लागत का सटीक अनुमान लगाने की क्षमता को प्रभावित करता है।
Byte Pair Encoding (BPE) एक विशिष्ट टोकनाइज़ेशन विधि है, जो GPT मॉडलों और अन्य प्राकृतिक भाषा संसाधन (NLP) अनुप्रयोगों में व्यापक रूप से प्रयुक्त होती है। BPE, अक्षर-स्तरीय टोकनाइज़ेशन की सूक्ष्मता और शब्द-स्तरीय टोकनाइज़ेशन के व्यापक दायरे के बीच संतुलन बनाती है।
यह टेक्स्ट में सबसे अधिक बार साथ आने वाले बाइट (या अक्षर) युग्मों को बार-बार मिलाकर एक नया, एकल टोकन बनाती है। यह प्रक्रिया पूर्वनिर्धारित संख्या तक या वांछित शब्दावली आकार प्राप्त होने तक चलती है।
LLM में BPE का महत्व अत्यधिक है। BPE इन मॉडलों को सामान्य शब्दों, दुर्लभ शब्दों और यहाँ तक कि नवीन शब्दों सहित विशाल शब्दावली को कुशलतापूर्वक संभालने में सक्षम बनाती है, वह भी बिना अत्यधिक बड़ी और बोझिल स्थिर शब्दावली के।
यह अनुकूलनशीलता कम सामान्य शब्दों को ऐसे उपशब्दों या अक्षरों में तोड़कर हासिल होती है जो अन्य संदर्भों में दिखाई देने की संभावना रखते हैं, जिससे मॉडल परिचित घटकों से अपरिचित शब्दों का अर्थ समझ पाता है।
BPE की कुछ प्रमुख विशेषताएँ:
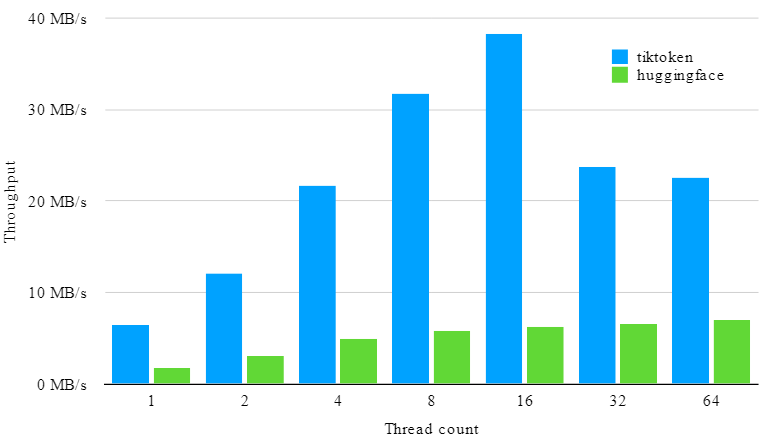
tiktoken OpenAI द्वारा विकसित तेज़ BPE एल्गोरिद्म है। इस एल्गोरिद्म का ओपन-सोर्स संस्करण कई लाइब्रेरीज़, जिनमें Python भी शामिल है, में उपलब्ध है। उनके GitHub के अनुसार, tiktoken समान ओपन-सोर्स टोकनाइज़र की तुलना में 3–6 गुना तेज़ है।
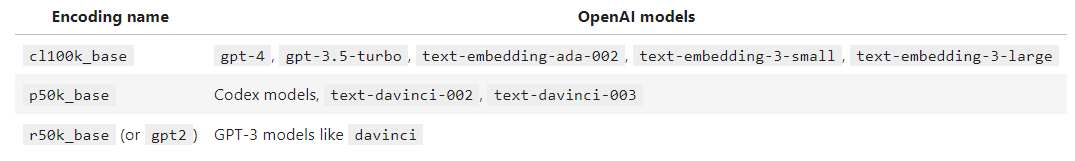
tiktoken लाइब्रेरी तीन अलग-अलग एन्कोडिंग विधियों का समर्थन करती है। एन्कोडिंग यह निर्धारित करती है कि टेक्स्ट को टोकन में कैसे बदला जाएगा। अलग-अलग मॉडल अलग-अलग एन्कोडिंग का उपयोग करते हैं।
tiktoken लाइब्रेरी टेक्स्ट स्ट्रिंग्स को टोकन में एन्कोड कर सकती है, और चूँकि हमें अपने उपयोग किए गए मॉडल के लिए एन्कोडिंग का नाम पता होता है, हम API कॉल करने से पहले ही इस लाइब्रेरी से उसकी लागत का अनुमान लगा सकते हैं।
!pip install openai tiktokentiktoken.get_encoding मेथड उपयुक्त एन्कोडिंग लौटाता है
encoding = tiktoken.get_encoding("cl100k_base")
encoding
आउटपुट:
>>> <Encoding 'cl100k_base'>
वैकल्पिक रूप से, आप tiktoken.encoding_for_model मेथड का उपयोग करके मॉडल नाम से भी इसे लोड कर सकते हैं।
encoding = tiktoken.encoding_for_model("gpt-4")अब आपको बस स्ट्रिंग को encode मेथड में पास करना है।
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")आउटपुट:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
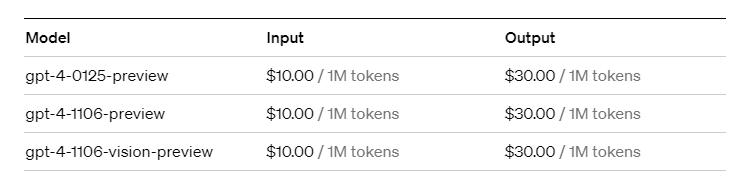
आप length मेथड को कॉल करके जान सकते हैं कि इस स्ट्रिंग में कितने टोकन हैं। इस मॉडल की कीमतें OpenAI वेबसाइट पर मिलेंगी।
इस उदाहरण में हमारे पास 15 इनपुट टोकन हैं। GPT-4 की कीमत $10/1M इनपुट टोकन होने पर, इस क्वेरी की लागत $0.00015 होगी ($10 / 1,000,000 * 15)।
चूँकि BPE एल्गोरिद्म पूर्णतः प्रतिवर्ती है, आप decode मेथड का उपयोग करके टोकन से वापस टेक्स्ट स्ट्रिंग में जा सकते हैं।
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])आउटपुट:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
tiktoken लाइब्रेरी की बदौलत Python में GPT मॉडलों के उपयोग की लागत का अनुमान लगाना अब अंदाज़े का खेल नहीं रहा। टोकनाइज़ेशन—खासकर Byte Pair Encoding (BPE) विधि—को समझकर और tiktoken का उपयोग करके, आप अपनी GPT API कॉल्स से जुड़ी लागत का सटीक अनुमान लगा सकते हैं। इस गाइड ने आपको टोकनाइज़ेशन की मूल बातें, BPE की दक्षता, और tiktoken की मदद से टेक्स्ट को टोकन में—और फिर वापस—बदलने की सीधी प्रक्रिया से परिचित कराया है, वह भी बजट पर पैनी नज़र रखते हुए।
चाहे आप लागत का अनुकूलन कर रहे हों, नए विचार आज़मा रहे हों, या अपने अनुप्रयोगों को स्केल कर रहे हों, यह ज्ञान और उपकरण आपके पास होने से आप GPT उपयोग-लागत पर हमेशा सूचित और नियंत्रण में रहेंगे। याद रखें, संगणनात्मक खर्चों का प्रबंधन उतना ही महत्वपूर्ण है जितना GPT मॉडलों के साथ किया जा रहा आपका नवोन्मेषी काम। tiktoken के साथ, आप हर टोकन—और हर डॉलर—का भरपूर मूल्य निकालने के लिए तैयार हैं।
यदि आप एम्बेडिंग्स में गहराई से जाना चाहते हैं और सेमांटिक सर्च तथा रिकमेंडेशन इंजन जैसे उन्नत AI अनुप्रयोग खोलना चाहते हैं, तो DataCamp का Introduction to Embeddings with the OpenAI API देखें।
यदि आप शुरुआती हैं और OpenAI API के लिए चरण-दर-चरण व्यावहारिक गाइड चाहते हैं, तो हमारा Working With The OpenAI API कोर्स और Datacamp पर A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices देखें।
आज ही अपनी AI यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स
