
Cursus
Werken met de OpenAI API
3 uur
179.5K
Als je in Python met OpenAI GPT-modellen werkt, is het cruciaal om de kosten in de gaten te houden. Daar komt de tiktoken-bibliotheek om de hoek kijken—een tool die het eenvoudig maakt om in te schatten hoeveel je aan API-calls uitgeeft door tekst om te zetten in tokens, de bouwstenen die GPT en andere LLM’s gebruiken om tekst te begrijpen en te genereren.
Hier bekijken we wat tokenization is en waarom het belangrijk is voor taalmodellen, introduceren we Byte Pair Encoding (BPE) en duiken we vervolgens in hoe de tiktoken-bibliotheek je kan helpen om GPT-gebruikskosten effectief te voorspellen.
Tokenization is een kernproces in de werking van GPT of andere taalmodellen en vormt de eerste stap in het vertalen van natuurlijke taal naar een formaat dat deze geavanceerde AI-systemen kunnen begrijpen en verwerken.
In de kern houdt tokenization in dat tekst wordt opgesplitst in kleinere, hanteerbare stukken die tokens worden genoemd. Afhankelijk van de gebruikte methode kunnen dit woorden, woorddelen of zelfs individuele tekens zijn.
Effectieve tokenization is cruciaal, omdat het direct de mogelijkheid van het model beïnvloedt om invoertekst te interpreteren, samenhangende en contextueel passende antwoorden te genereren en rekencosts nauwkeurig in te schatten.
Byte Pair Encoding (BPE) is een specifieke tokenization-methode die aan bekendheid heeft gewonnen door het gebruik in GPT-modellen en andere toepassingen voor natural language processing (NLP). BPE slaat een brug tussen de fijnmazigheid van tokenization op tekenniveau en de bredere scope van tokenization op woordniveau.
Het werkt door herhaaldelijk het meest voorkomende paar bytes (of tekens) in de tekst samen te voegen tot één nieuw token. Dit proces gaat door voor een vooraf bepaald aantal iteraties of totdat een gewenste woordenschatgrootte is bereikt.
Het belang van BPE in LLM’s kan moeilijk overschat worden. BPE stelt deze modellen in staat om efficiënt met een enorme woordenschat om te gaan, inclusief veelvoorkomende woorden, zeldzame woorden en zelfs neologismen, zonder een buitensporig grote en onhandelbare vaste woordenschat nodig te hebben.
Die flexibiliteit wordt bereikt door minder voorkomende woorden op te delen in subwoorden of tekens die waarschijnlijk ook in andere contexten voorkomen, zodat het model de betekenis van onbekende termen kan samenstellen uit bekende componenten.
Enkele belangrijke eigenschappen van BPE zijn:
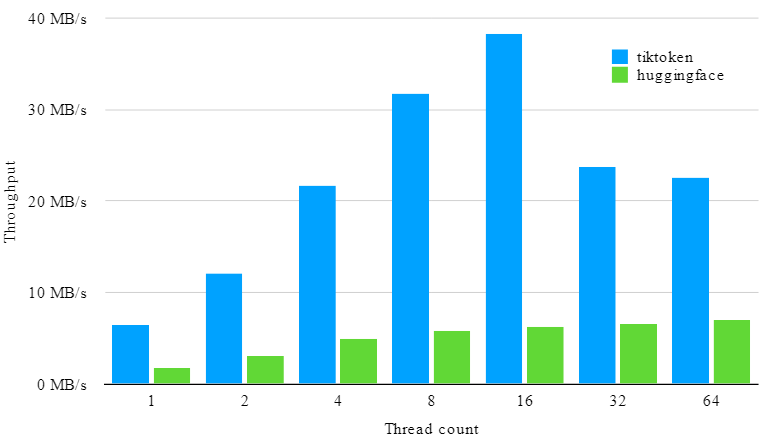
tiktoken is het snelle BPE-algoritme dat door OpenAI is ontwikkeld. De open-sourceversie van het algoritme is beschikbaar in veel bibliotheken, waaronder Python. Volgens hun GitHub is tiktoken 3-6x sneller dan een vergelijkbare open-source tokenizer.
De tiktoken-bibliotheek ondersteunt drie verschillende encodings. Encodings bepalen de manier waarop tekst wordt omgezet in tokens. Verschillende modellen gebruiken verschillende encodings.
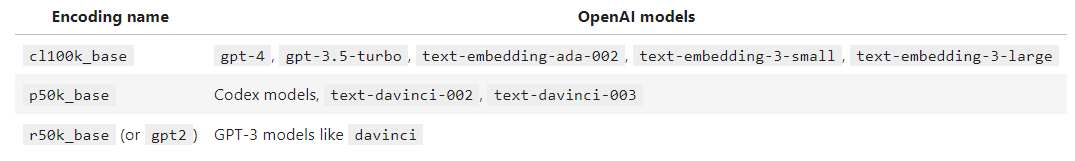
De tiktoken-bibliotheek kan tekststrings encoderen tot tokens, en omdat we de naam van de encoding van het door ons gebruikte model kennen, kunnen we deze bibliotheek gebruiken om de kosten van API-calls in te schatten voordat we de call doen.
!pip install openai tiktokenDe methode tiktoken.get_encoding geeft de relevante encoding terug
encoding = tiktoken.get_encoding("cl100k_base")
encoding
Uitvoer:
>>> <Encoding 'cl100k_base'>
Je kunt het ook laden op basis van de modelnaam met de methode tiktoken.encoding_for_model.
encoding = tiktoken.encoding_for_model("gpt-4")Alles wat je nu hoeft te doen, is de string doorgeven aan de methode encode.
encoding.encode("This blog shows how to use tiktoken for estimating cost of GPT models")Uitvoer:
>>> [2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211]
Je kunt simpelweg de methode length aanroepen om te zien hoeveel tokens er in deze string zitten. De prijzen voor dit model vind je op de OpenAI-website.
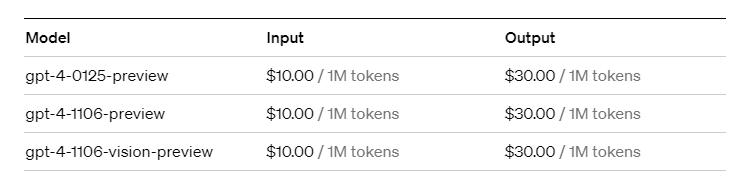
In dit voorbeeld hebben we 15 inputtokens. De prijs van GPT-4 is $10 per 1M inputtokens, wat betekent dat onze kosten voor deze query $0,00015 zullen zijn ($10 / 1.000.000 * 15).
Omdat het BPE-algoritme volledig omkeerbaar is, kun je met de methode decode teruggaan van token naar tekststring.
encoding.decode([2028, 5117, 5039, 1268, 311, 1005, 73842, 5963, 369, 77472, 2853, 315, 480, 2898, 4211])Uitvoer:
>>> ‘This blog shows how to use tiktoken for estimating cost of GPT models’
De kosten van GPT-modellen in Python hoeven geen gokwerk te zijn, dankzij de tiktoken-bibliotheek. Door tokenization te begrijpen, met name de Byte Pair Encoding (BPE)-methode, en tiktoken te benutten, kun je de kosten van je GPT API-calls nauwkeurig inschatten. Deze gids nam je mee langs de essentie van tokenization, de efficiëntie van BPE en het eenvoudige proces om met tiktoken tekst in tokens te veranderen—en weer terug—terwijl je je budget goed in de gaten houdt.
Of je nu optimaliseert voor kosten, nieuwe ideeën test of je applicaties opschaalt, met deze kennis en tool bij de hand ben je altijd goed geïnformeerd en houd je de controle over je GPT-gebruikskosten. Onthoud: het beheren van rekencosts is net zo belangrijk als het innovatieve werk dat je met GPT-modellen doet. Met tiktoken ben je goed uitgerust om elke token—en elke dollar—te laten tellen.
Wil je dieper duiken in embeddings en geavanceerdere AI-toepassingen zoals semantisch zoeken en aanbevelingssystemen ontgrendelen? Bekijk dan DataCamp’s Introduction to Embeddings with the OpenAI API.
Ben je beginner en wil je een praktische, stapsgewijze gids voor de OpenAI API? Bekijk dan onze cursus Working With The OpenAI API en onze A Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices op Datacamp.
Begin vandaag nog met je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

