Lanskap machine learning dan natural language processing (NLP) terus berkembang, dengan OpenAI secara konsisten memimpin jalan menuju inovasi.
Kehadiran model text-embedding-3-large dan text-embedding-3-small menandai era baru di bidang ini, siap mengubah cara developer dan praktisi AI mendekati analisis teks dan tugas embedding.
Dalam dunia kecerdasan buatan yang kompleks, embedding sangat penting untuk mengubah bahasa manusia yang rumit menjadi sesuatu yang dapat dipahami dan diproses mesin. Model baru dari OpenAI ini mewakili lompatan besar bagi developer dan calon praktisi data.
Artikel ini bertujuan menjelaskan model text-embedding-3-large dan text-embedding-3-small, memberikan wawasan tentang fungsi inti, berbagai penerapan, dan cara menggunakannya secara efektif.
Dengan menelusuri dasar-dasar text embedding serta menyoroti fitur dan kegunaan praktis model, artikel ini bermaksud memberikan informasi yang diperlukan agar pembaca dapat menggunakan alat canggih ini dalam proyek mereka.
Selain itu, artikel ini akan membahas dasar memulai dengan model, berbagi kiat untuk meningkatkan tugas embedding, dan mendiskusikan dampak luas kemajuan teknologi ini pada bidang NLP.
Memahami Text Embeddings
Sebelum membahas detail model baru, tinjauan singkat tentang text embedding akan membantu pemahaman yang lebih baik.
Text embedding adalah representasi numerik dari teks yang menangkap semantik, atau makna, dari kata, frasa, atau keseluruhan dokumen. Embedding menjadi dasar bagi banyak tugas NLP, seperti analisis sentimen, klasifikasi teks, dan lainnya.
Pengantar Text Embeddings dengan OpenAI API kami menyediakan panduan lengkap untuk menggunakan OpenAI API dalam membuat text embedding. Temukan penerapannya dalam klasifikasi teks, penelusuran informasi, dan deteksi kemiripan semantik.
Di bawah ini adalah ilustrasi dengan menggunakan model embedding:
- Dokumen yang akan direpresentasikan ada di sebelah kiri
- Model embedding di tengah, dan
- Embedding yang sesuai dari tiap dokumen ada di sebelah kanan
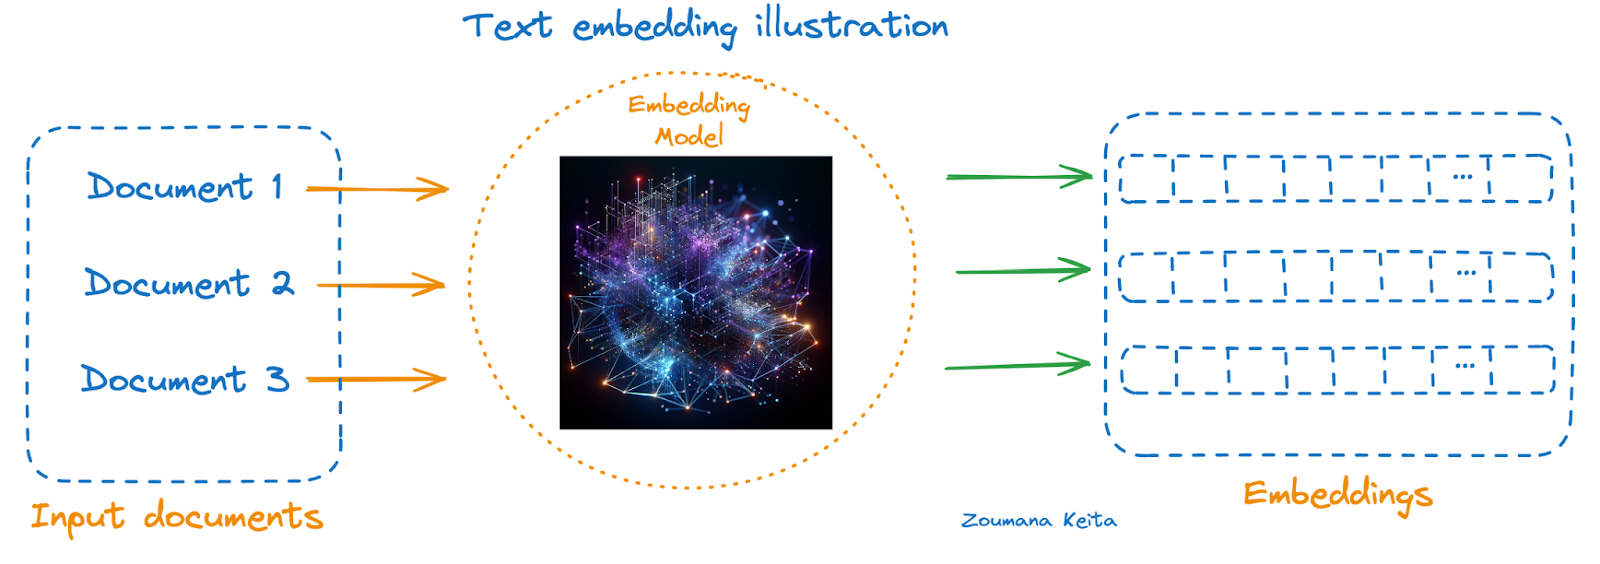
Ilustrasi text embedding
Bagi Anda yang baru dengan konsep ini, pertimbangkan untuk mempelajari kursus Introduction to Embeddings with the OpenAI API. Kursus ini menjelaskan cara memanfaatkan embedding OpenAI melalui OpenAI API untuk membuat embedding dari data tekstual dan mulai mengembangkan aplikasi dunia nyata.
Sekilas tentang Embeddings OpenAI Baru
Diumumkan pada 25 Januari 2024, model ini adalah model embedding terbaru dan terkuat yang dirancang untuk merepresentasikan teks dalam ruang berdimensi tinggi, sehingga memudahkan pemahaman teks yang lebih baik.
Model text-embedding-3-small dioptimalkan untuk latensi dan penyimpanan. Di sisi lain, text-embedding-3-large merupakan pilihan yang baik untuk akurasi lebih tinggi, dan kita juga dapat memanfaatkan parameter dimensions yang baru untuk menjaga embedding di 1536 alih-alih ukuran native 3072 tanpa memengaruhi kinerja keseluruhan.
Analisis benchmarking
Sebelum rilis, text-embedding-ada-2 berada di puncak papan peringkat semua model embedding OpenAI sebelumnya, dan tabel berikut memberikan gambaran cepat perbandingan benchmark antara ketiga model ini.
|
Model |
Dimensi |
Maks token |
Knowledge cutoff |
Harga ($/1k token) |
Rata-rata MIRACL |
Rata-rata MTEB |
|
ada v2 |
1536 |
8191 |
September 2021 |
0.0001 |
31.4 |
61.0 |
|
text-embedding-3-small |
0.00002 |
44.0 |
62.3 |
|||
|
text-embedding-3-large |
3072 |
0.00013 |
54.9 |
64.6 |
Dari metrik yang diberikan, kita dapat melihat peningkatan kinerja dari ada v2 (text-embedding-ada-002) ke text-embedding-3-large pada benchmark MIRACL dan MTEB. Ini menunjukkan bahwa text-embedding-3-large, dengan jumlah dimensi lebih banyak (3072), menawarkan kualitas embedding yang lebih baik dibanding dua lainnya, yang berkorelasi langsung dengan skor benchmark yang meningkat.
Kenaikan dimensi dari text-embedding-ada-002 dan text-embedding-3-small (keduanya 1536) ke text-embedding-3-large (3072) menunjukkan model yang lebih kompleks dan mampu menangkap himpunan fitur yang lebih kaya dalam embedding-nya. Namun, ini juga hadir dengan harga per 1.000 token yang lebih tinggi, yang mengindikasikan trade-off antara kinerja dan biaya.
Bergantung pada kebutuhan spesifik suatu tugas (misalnya kebutuhan kemampuan multibahasa, kompleksitas teks yang akan di-embed, atau keterbatasan anggaran), seseorang dapat memilih model yang berbeda.
Untuk tugas yang membutuhkan embedding berkualitas tinggi di banyak bahasa dan jenis tugas, text-embedding-3-large mungkin lebih disukai meskipun biayanya lebih tinggi. Sebaliknya, untuk aplikasi dengan keterbatasan anggaran yang ketat atau ketika presisi sangat tinggi tidak begitu krusial, text-embedding-ada-002 atau text-embedding-3-small bisa menjadi opsi yang lebih sesuai.
Aplikasi Text-Embedding-3-Large
Teknologi embedding terbukti sangat bermanfaat bagi banyak aplikasi pemrosesan dan pemahaman bahasa alami modern. Pilihan antara model yang lebih bertenaga seperti text-embedding-3-large dan opsi yang lebih ekonomis seperti text-embedding-3-small dapat memengaruhi kinerja dan efisiensi biaya aplikasi NLP.
Berikut tiga ilustrasi kasus penggunaan untuk kedua model, yang menunjukkan versatilitas dan dampaknya dalam skenario dunia nyata.
Aplikasi text-embedding-3-large
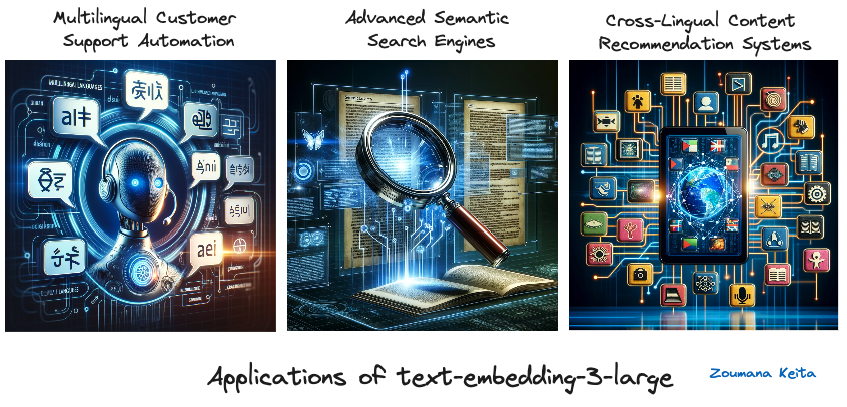
Aplikasi text-embedding-3-large (gambar dihasilkan menggunakan GPT-4)
Otomatisasi dukungan pelanggan multibahasa
Dengan kinerjanya yang unggul dalam memahami dan memproses 18 bahasa berbeda, text-embedding-3-large dapat menjalankan chatbot dukungan pelanggan dan sistem respons otomatis untuk perusahaan global, memastikan dukungan yang akurat dan kontekstual di berbagai latar bahasa.
Mesin pencari semantik tingkat lanjut
Dengan memanfaatkan embedding berdimensi tinggi, text-embedding-3-large dapat meningkatkan algoritma mesin pencari, memampukannya memahami nuansa kueri pencarian dengan lebih baik dan menampilkan hasil yang lebih relevan serta sesuai konteks, terutama di bidang spesialis seperti riset hukum atau medis.
Sistem rekomendasi konten lintas bahasa
Untuk platform dengan beragam konten multibahasa, seperti layanan streaming atau agregator berita, text-embedding-3-large dapat menganalisis preferensi pengguna dan konten dalam berbagai bahasa, merekomendasikan konten yang sangat relevan terlepas dari hambatan bahasa.
Aplikasi text-embedding-3-small
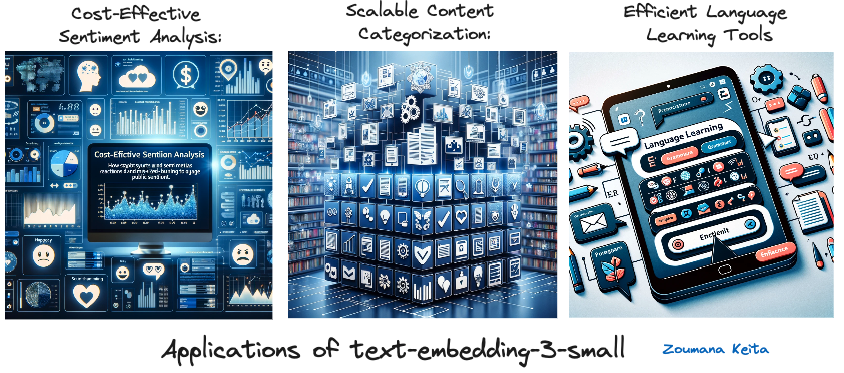
Aplikasi text-embedding-3-small (gambar dihasilkan menggunakan GPT-4)
Analisis sentimen yang hemat biaya
Bagi startup dan bisnis menengah yang ingin memahami sentimen pelanggan melalui pemantauan media sosial atau analisis umpan balik, text-embedding-3-small menawarkan solusi yang ramah anggaran namun efektif untuk mengukur opini publik dan kepuasan pelanggan.
Kategorisasi konten yang skalabel
Platform konten dengan volume data besar, seperti blog atau situs e-niaga, dapat memanfaatkan text-embedding-3-small untuk mengkategorikan konten atau produk secara otomatis. Efisiensi dan biaya yang lebih rendah menjadikannya ideal untuk menangani kumpulan data besar tanpa mengorbankan akurasi.
Perangkat belajar bahasa yang efisien
Aplikasi pendidikan yang membutuhkan solusi yang skalabel dan hemat biaya untuk menyediakan latihan belajar bahasa, seperti mencocokkan kata dengan makna atau pemeriksaan tata bahasa, dapat memanfaatkan text-embedding-3-small. Keseimbangan kinerja dan keterjangkauannya mendukung pengembangan konten pendidikan interaktif yang berfokus pada bahasa.
Aplikasi-aplikasi ini menunjukkan bagaimana text-embedding-3-large dan text-embedding-3-small dapat diterapkan secara optimal di berbagai sektor, menyelaraskan kekuatan masing-masing dengan kebutuhan spesifik setiap aplikasi untuk kinerja, pengalaman pengguna, dan efisiensi biaya yang lebih baik.
Panduan Langkah demi Langkah Menggunakan Embeddings OpenAI Terbaru
Kini kita memiliki semua alat yang dibutuhkan untuk melanjutkan implementasi text-embedding-3-large, text-embedding-3-small, dan ada-v2 dalam skenario kemiripan dokumen.
Seluruh kode dalam tutorial ini tersedia dalam sebuah workbook DataLab. Buat salinan workbook ini untuk menjalankan kode tanpa perlu menginstal apa pun di komputer Anda.
Tentang data
- Ini adalah himpunan data CORD-19, sumber yang berisi lebih dari 59.000 artikel ilmiah, termasuk lebih dari 48.000 dengan teks lengkap, tentang COVID-19, SARS-CoV-2, dan coronavirus terkait.
- Data ini telah disediakan secara bebas oleh Gedung Putih dan koalisi kelompok riset terkemuka untuk membantu riset global menghasilkan wawasan guna mendukung perjuangan melawan penyakit menular ini.
- Dapat diunduh dari halaman ini di Kaggle.
- Rincian lebih lanjut tentang dataset dapat ditemukan di halaman ini.
Sebelum melangkah lebih jauh, penting untuk memasang dan mengimpor pustaka berikut demi keberhasilan proyek ini.
Menggunakan pernyataan %%bash, kita dapat memasang beberapa pustaka tanpa menggunakan tanda seru (!).
%%bash
pip -q install tiktoken
pip -q install openai
Sekarang, pustaka dapat diimpor sebagai berikut:
import os
import tiktoken
import numpy as np
import pandas as pd
from openai import OpenAI
from sklearn.metrics.pairwise import cosine_similarity
Mari pahami peran tiap pustaka:
- os: Menyediakan cara untuk menggunakan fungsi yang bergantung pada sistem operasi seperti membaca atau menulis ke filesystem.
- tiktoken: Menangani tugas tokenisasi yang spesifik untuk pemrosesan dokumen ilmiah.
- numpy (np): Menambahkan dukungan untuk array dan matriks besar multi-dimensi, beserta koleksi besar fungsi matematis tingkat tinggi untuk beroperasi pada array ini, penting untuk komputasi ilmiah.
- pandas (pd): Menawarkan struktur data dan operasi untuk memanipulasi tabel numerik dan deret waktu, esensial untuk menangani dataset ilmiah.
- openai.OpenAI: Berfungsi sebagai antarmuka ke OpenAI API, memungkinkan interaksi dengan model machine learning untuk tugas seperti menghasilkan embedding untuk teks ilmiah.
- sklearn.metrics.pairwise.cosine_similarity: Menghitung cosine similarity antar vektor, berguna dalam analisis kemiripan dokumen ilmiah.
Eksplorasi Data
Dataframe asli berukuran lebih dari 1Gb, dan hanya sampel 1000 observasi acak yang dimuat demi kesederhanaan.
scientific_docs = pd.read_parquet("./data/cord19_df_sample.parquet")Dengan fungsi .head(), kita dapat melihat 2 baris pertama data, dan hasilnya ada pada animasi di bawah.
scientific_docs.head(2)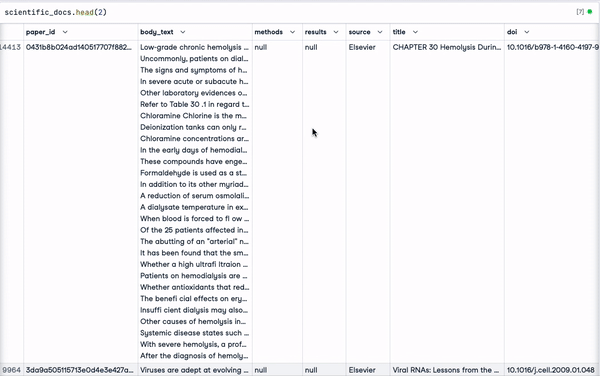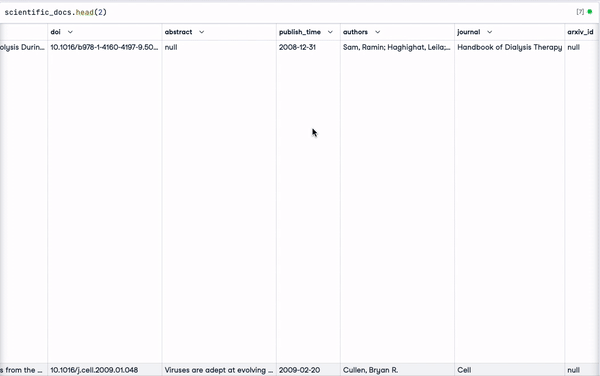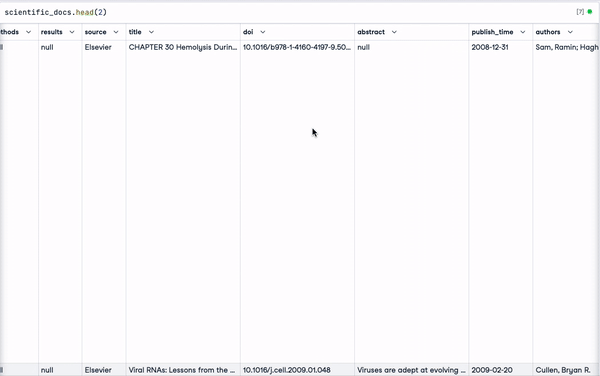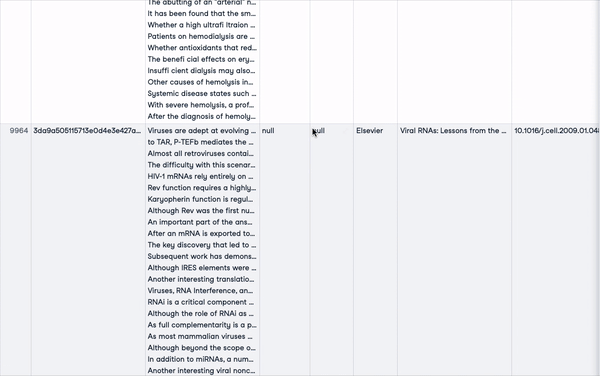
Dua baris pertama data
Isi, judul, dan abstrak dari suatu dokumen ilmiah sudah cukup untuk merepresentasikan dokumen tersebut. Ketiga atribut ini digabungkan untuk mendapatkan satu representasi tekstual untuk setiap dokumen.
Sebelum itu, mari lihat persentase nilai hilang pada masing-masing dari tiga kolom ini:
percent_missing = scientific_docs.isnull().sum() * 100 / len(scientific_docs)
percent_missing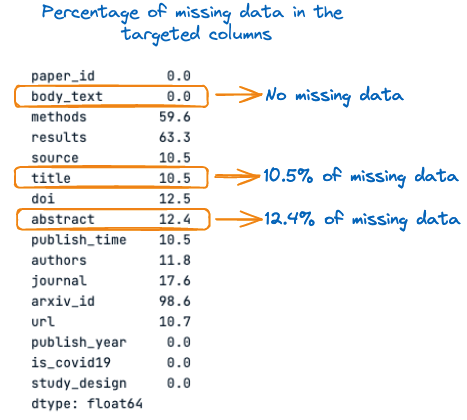
Persentase data hilang pada kolom target
Dari gambar di atas, kita dapat melihat bahwa judul dan abstrak memiliki nilai hilang, masing-masing 10,5% dan 12,4%. Karenanya, penting untuk mengisi nilai hilang tersebut dengan string kosong sebelum penggabungan untuk menghindari hilangnya informasi.
Proses keseluruhan pengisian nilai hilang dan penggabungan kolom dilakukan menggunakan fungsi berikut.
def concatenate_columns_with_null_handling(df, body_text_column,
                                       	abstract_column,
                                       	title_column,
                                       	new_col_name):

	df[new_col_name] = df[body_text_column].fillna('') + df[abstract_column].fillna('') + df[title_column].fillna('')

	return df
Setelah menjalankan fungsi penggabungan pada data asli dan memeriksa 3 baris pertama, kita dapat melihat bahwa penggabungan berhasil.
new_scientific_docs = concatenate_columns_with_null_handling(scientific_docs,
                                                         	"body_text",
                                                         	"abstract",
                                                         	"title",
"concatenated_text")new_scientific_docs.head(3)Kolom yang baru ditambahkan adalah concatenated_text.
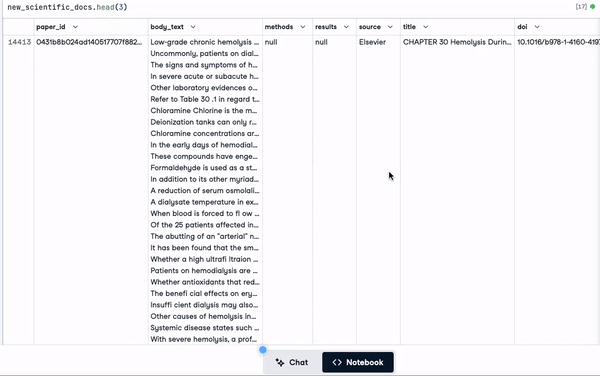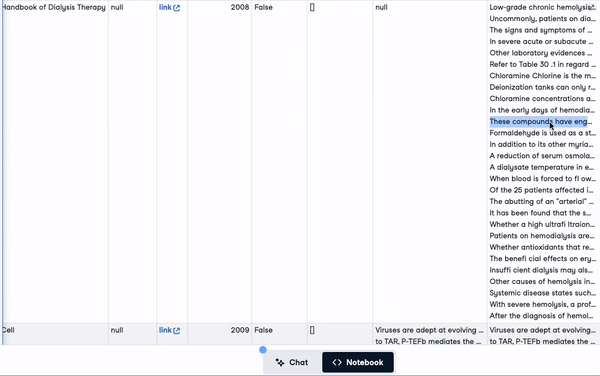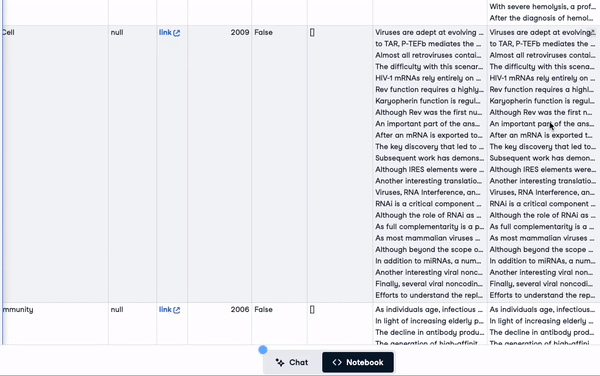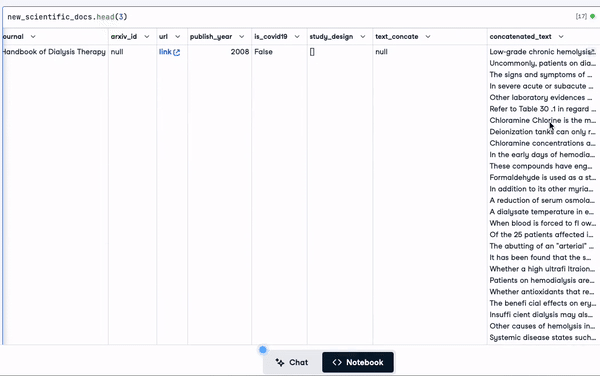
Tiga baris pertama dengan kolom baru yang ditambahkan
Langkah selanjutnya adalah menerapkan embedding pada kolom baru menggunakan berbagai model embedding yang disebutkan dalam artikel ini. Namun sebelum itu mari lihat distribusi panjang token.
Tujuan analisis ini adalah memeriksa batas maksimum token pada model terhadap jumlah token aktual dalam suatu dokumen.
Namun pertama-tama, kita perlu menghitung total jumlah token dalam setiap dokumen, dan itu dilakukan menggunakan fungsi bantu num_tokens_from_text dan encoder cl100k_base.
def num_tokens_from_text(text: str, encoding_name="cl100k_base"):
    	"""
    	Returns the number of tokens in a text string.
    	"""
    	encoding = tiktoken.get_encoding(encoding_name)
    	num_tokens = len(encoding.encode(text))
    	return num_tokens
Sebelum menerapkan fungsi pada keseluruhan dataset, mari lihat bagaimana fungsinya bekerja pada teks berikut: This article is about new OpenAI Embeddings.
text = "This article is about new OpenAI Embeddings"
num_tokens = num_tokens_from_text(text)
print(f"Number of tokens: {num_tokens}")
Setelah berhasil menjalankan kode di atas, kita dapat melihat bahwa teks tersebut memiliki 10 token.

Jumlah token dalam teks
Dengan yakin, kita dapat menerapkan fungsi tersebut ke seluruh teks dalam dataframe menggunakan ekspresi lambda sebagai berikut:
new_scientific_docs['num_tokens'] = new_scientific_docs["concatenated_text"].apply(lambda x: num_tokens_from_text(x))Kita dapat menghitung total jumlah dokumen yang memiliki lebih dari 8191 token dengan memfilter jumlah token dan memeriksa mana yang lebih tinggi dari batas token 8191.
smaller_tokens_docs = new_scientific_docs[new_scientific_docs['num_tokens'] <= 8191]
len(smaller_tokens_docs)
⇒ Output: 764
Artinya, 764 dokumen dari 1000 memenuhi persyaratan batas maksimum token, dan demi kesederhanaan kita menggunakan dokumen-dokumen ini.
Teknik tingkat lanjut dapat diterapkan untuk memproses sisa dokumen yang memiliki lebih dari 8191 token.
Salah satu teknik tersebut adalah mengambil rata-rata semua embedding dari satu dokumen. Teknik lain adalah mengambil 8191 token pertama dari dokumen. Pendekatan ini tidak efisien karena dapat menyebabkan hilangnya informasi.
Mari pastikan untuk me-reset indeks dataframe agar mulai dari nol.
smaller_tokens_docs_reset = smaller_tokens_docs.reset_index(drop=True)Menjalankan embedding
Semua prasyarat telah terpenuhi untuk memperoleh representasi embedding dari semua dokumen, dan ini dilakukan untuk setiap model embedding.
Langkah pertama adalah memperoleh kredensial OpenAI dan mengonfigurasi klien sebagai berikut:
os.environ["OPENAI_API_KEY"] = "YOUR KEY"
client = OpenAI()
Lalu, fungsi bantu berikut membantu menghasilkan embedding dengan memberikan model embedding dan teks yang akan di-embed.
def get_embedding(text_to_embbed, model_ID):

	text = text_to_embbed.replace("\n", " ")
	return client.embeddings.create(input = [text_to_embbed],
                                	model=model_ID).data[0].embedding
Sebuah dataframe baru kini dibuat dengan tiga kolom tambahan yang masing-masing berisi embedding dari ketiga model:
- text-embedding-3-small
- text-embedding-3-large
- text-embedding-ada-002
smaller_tokens_docs_reset['text-embedding-3-small'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-small"))

smaller_tokens_docs_reset['text-embedding-3-large'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-large"))

smaller_tokens_docs_reset['text-embedding-ada-002'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-ada-002"))
Setelah berhasil menjalankan kode di atas, kita dapat melihat bahwa kolom embedding yang relevan telah ditambahkan.
smaller_tokens_docs_reset.head(1)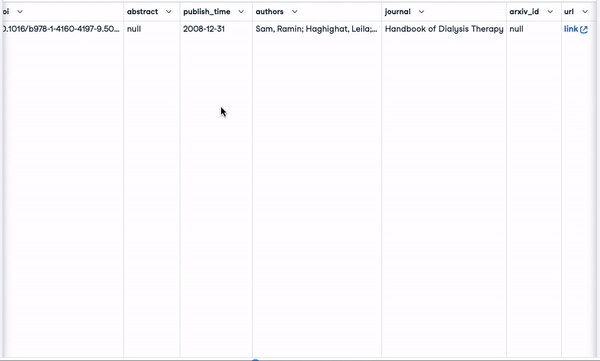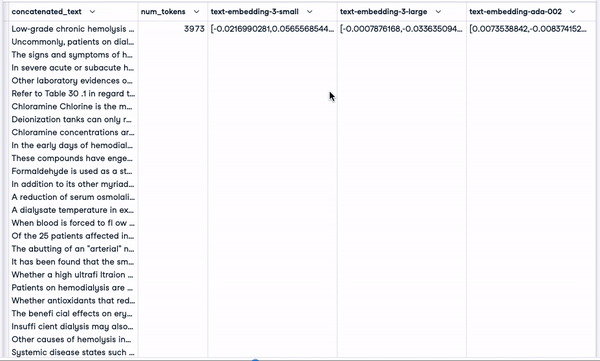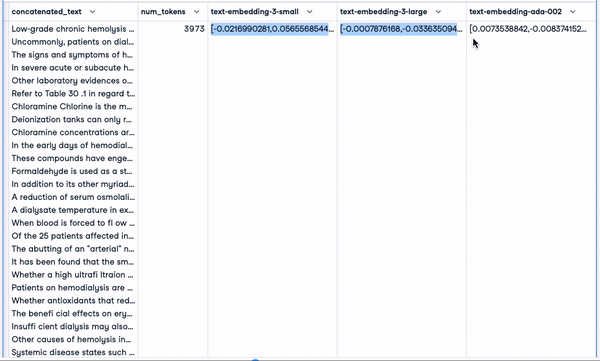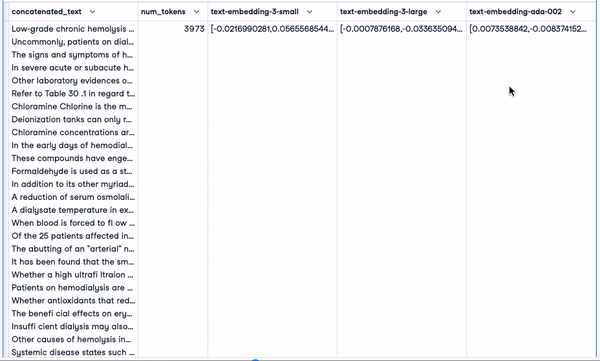
Dataframe baru dengan kolom embedding yang relevan
Pencarian kemiripan
Bagian ini menggunakan teknik cosine similarity pada masing-masing pendekatan embedding di atas untuk menemukan 3 dokumen paling mirip dengan dokumen tertentu.
Fungsi bantu berikut menerima empat parameter utama:
- Dataframe saat ini
- Indeks teks yang ingin kita cari dokumen paling miripnya
- Embedding spesifik yang akan digunakan
- Jumlah dokumen paling mirip yang diinginkan, default-nya 3.
def find_top_N_similar_documents(df, chosen_index,
                             	embedding_column_name,
                             	top_N=3):

	chosen_document_embedding = np.array(df.iloc[chosen_index][embedding_column_name]).reshape(1, -1)
	embedding_matrix = np.vstack(df[embedding_column_name])
	similarity_scores = cosine_similarity(chosen_document_embedding, embedding_matrix)[0]

	df_temp = df.copy()
	df_temp['similarity_to_chosen'] = similarity_scores
	similar_documents = df_temp.drop(index=chosen_index).sort_values(by='similarity_to_chosen', ascending=False)
	top_N_similar = similar_documents.head(top_N)

	return top_N_similar[[concatenated_text, 'similarity_to_chosen']]
Pada bagian berikut, kita mencari dokumen paling mirip dengan dokumen pertama (index=0)
Seperti inilah tampilan dokumen pertama:
chosen_index = 0

first_document_data = smaller_tokens_docs_reset.iloc[0]["concatenated_text"]
print(first_document_data)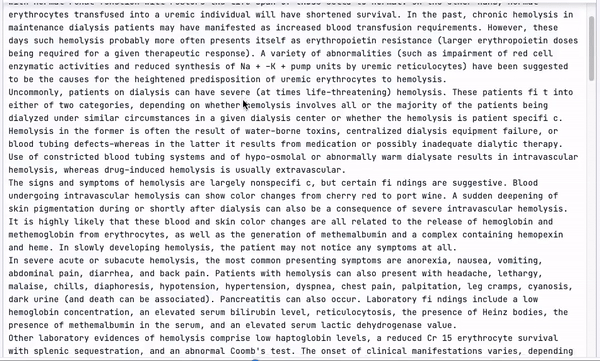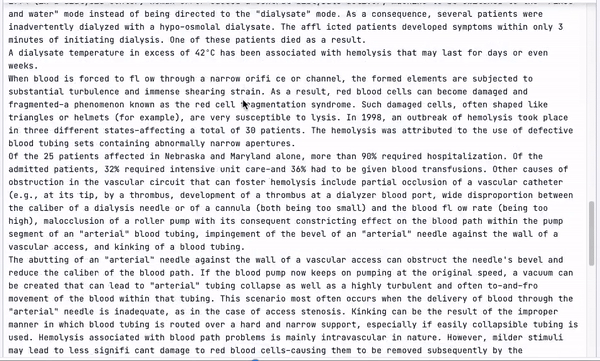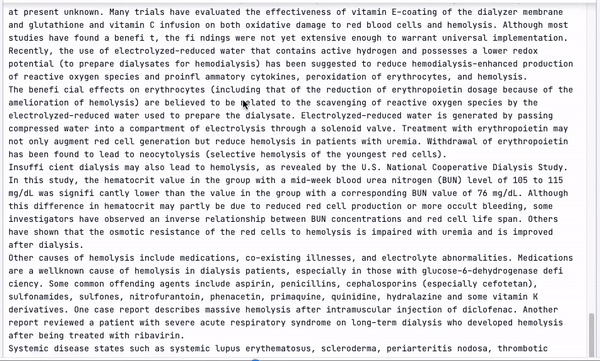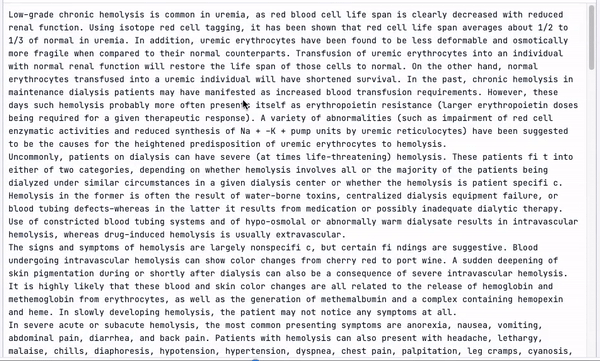
Konten dokumen pertama (versi gabungan)
Fungsi pencarian kemiripan dapat dijalankan sebagai berikut:
top_3_similar_3_small = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-small")

top_3_similar_3_large= find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-large")

top_3_similar_ada_002 = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-ada-002")
Setelah memproses tugas kemiripan, hasilnya dapat ditampilkan sebagai berikut:
print("Top 3 Similar Documents with :")
print("--> text-embedding-3-small")
print(top_3_similar_3_small)
print("\n")

print("--> text-embedding-3-large")
print(top_3_similar_3_large)
print("\n")

print("--> text-embedding-ada-002")
print(top_3_similar_ada_002)
print("\n")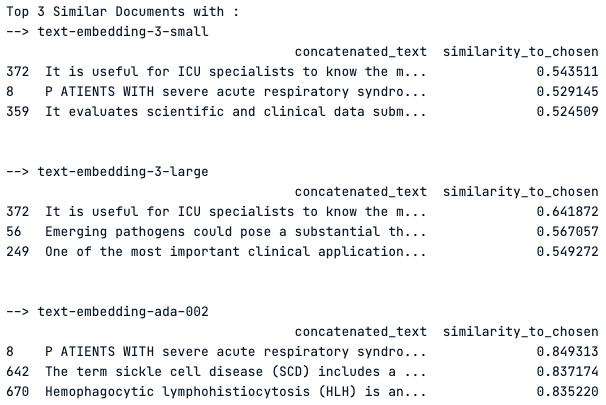
Tiga dokumen paling mirip teratas menggunakan setiap model embedding
Observasi hasil
Model "text-embedding-3-small" menunjukkan skor kemiripan sedang sekitar 0,54, sedangkan "text-embedding-3-large" sedikit lebih tinggi, yang menunjukkan penangkapan kemiripan yang lebih baik.
Model "text-embedding-ada-002" menunjukkan skor kemiripan yang jauh lebih tinggi, dengan skor teratas mendekati 0,85, yang menyiratkan kemiripan yang sangat kuat dengan dokumen yang dipilih.
Namun, Dokumen 372 adalah hasil teratas yang sama di semua model, yang mengisyaratkan relevansinya yang konsisten terhadap kueri. Perbedaan skor antar model menyoroti dampak pilihan model embedding terhadap hasil kemiripan.
Kesimpulan
Sebagai penutup, model text-embedding-3-large dan text-embedding-3-small terbaru dari OpenAI mewakili lompatan signifikan dalam ranah pemrosesan bahasa alami, menawarkan representasi data teks yang lebih bernuansa dan berdimensi tinggi.
Seperti ditunjukkan dalam artikel, pilihan antara model-model ini dapat berdampak besar pada hasil berbagai tugas NLP seperti kemiripan dokumen, analisis sentimen, dan sistem dukungan multibahasa. Sementara text-embedding-3-large memberikan akurasi lebih tinggi karena dimensinya yang meningkat, text-embedding-3-small menawarkan keseimbangan efisiensi dan kinerja untuk aplikasi yang sensitif terhadap biaya.
Analisis benchmarking mengungkapkan bahwa text-embedding-3-large melampaui pendahulunya, menetapkan standar baru di bidang ini. Penerapan dunia nyata untuk model-model ini sangat luas, mulai dari meningkatkan dukungan pelanggan hingga menggerakkan mesin pencari dan sistem rekomendasi konten yang canggih.
Dengan menavigasi panduan terperinci yang disediakan, para praktisi di bidang ini dibekali untuk membuat keputusan yang tepat tentang model mana yang akan digunakan berdasarkan kompleksitas tugas, batasan anggaran, dan kebutuhan kemampuan multibahasa.
Pada akhirnya, pilihan model harus selaras dengan tuntutan spesifik proyek yang dihadapi, dengan memanfaatkan kekuatan text-embedding-3-large untuk tugas yang membutuhkan ketelitian tinggi dan text-embedding-3-small untuk tujuan yang lebih umum. Kehadiran model-model ini menegaskan komitmen OpenAI untuk memajukan teknologi AI dan evolusi berkelanjutan alat-alat machine learning.
Ke mana melangkah selanjutnya?
Artikel kami, The OpenAI API in Python, adalah lembar contekan yang membantu Anda mempelajari dasar-dasar memanfaatkan salah satu API AI terkuat, yakni OpenAI API.
Sesi code along kami Fine-tuning GPT3.5 with OpenAI API menyediakan panduan menggunakan OpenAI API dan Python untuk mulai melakukan fine-tuning GPT3.5, membantu memahami kapan fine-tuning model bahasa besar bermanfaat, cara menggunakan alat fine-tuning di OpenAI API, dan akhirnya memahami alur kerja fine-tuning.




