Makine öğrenimi ve doğal dil işleme (NLP) alanı sürekli evrilirken, OpenAI yenilik konusunda istikrarlı biçimde öncülük ediyor.
text-embedding-3-large ve text-embedding-3-small modellerinin tanıtımı, geliştiricilerin ve yapay zeka uzmanlarının metin analizi ve gömme görevlerine yaklaşımını değiştirmeye aday, bu alanda yeni bir döneme işaret ediyor.
Yapay zekanın karmaşık dünyasında gömmeler, karmaşık insan dilini makinelerin anlayıp işleyebileceği bir biçime dönüştürmek için kritik öneme sahiptir. OpenAI’nin bu yeni modeli, geliştiriciler ve veri alanında ilerlemek isteyenler için önemli bir adımı temsil ediyor.
Bu makale, text-embedding-3-large ve text-embedding-3-small modellerini açıklamayı; temel işlevleri, çeşitli kullanım alanları ve bunların nasıl etkin şekilde kullanılacağına dair içgörüler sunmayı amaçlıyor.
Metin gömmelerinin temellerini inceleyerek ve modelin yeni özellikleri ile pratik kullanım alanlarını vurgulayarak, okuyuculara bu gelişmiş aracı projelerinde kullanmaları için gerekli bilgileri sağlamayı hedefliyor.
Ayrıca, modele başlarken bilinmesi gereken temel noktaları ele alacak, gömme görevlerini iyileştirmeye yönelik ipuçları paylaşacak ve bu teknolojik ilerlemenin NLP alanındaki geniş kapsamlı etkisini tartışacaktır.
Metin Gömme Mantığını Anlamak
Yeni modelin ayrıntılarına dalmadan önce, metin gömmelerine dair kısa bir genel bakış daha iyi bir kavrayış sağlayacaktır.
Metin gömmeleri, kelimelerin, ifadelerin veya tüm belgelerin anlamını (semantiğini) yakalayan sayısal temsillerdir. Duygu analizi, metin sınıflandırma ve daha fazlası gibi pek çok NLP görevinin temelini oluştururlar.
OpenAI API ile Metin Gömmeye Giriş yazımız, OpenAI API’sini kullanarak metin gömmeleri oluşturma konusunda kapsamlı bir rehber sunar. Metin sınıflandırma, bilgi getirme ve anlamsal benzerlik tespiti gibi uygulamalarını keşfedin.
Aşağıda bir gömme modeli kullanılarak yapılan bir görselleştirme yer alıyor:
- Temsil edilecek belgeler solda
- Gömme modeli ortada ve
- Her belgenin karşılık gelen gömmeleri sağda
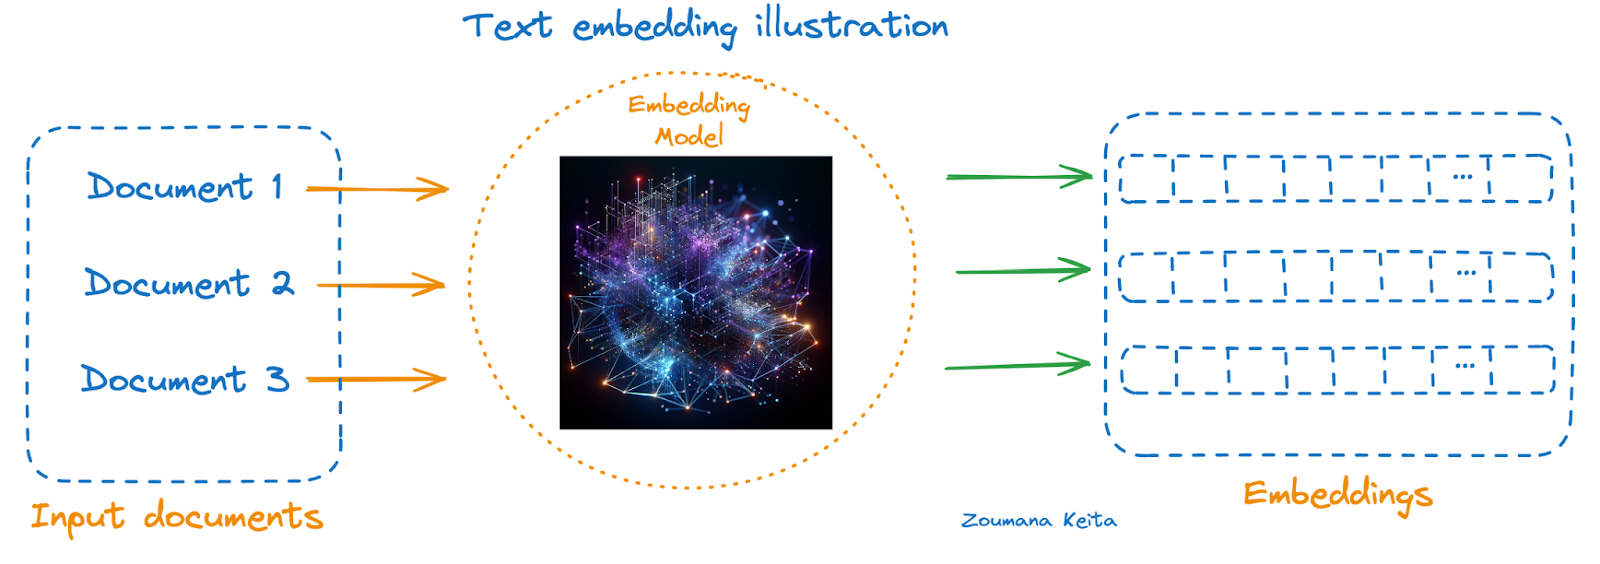
Metin gömmeleri görselleştirmesi
Bu kavrama yeni olanlar, OpenAI API ile Gömme Mantığına Giriş kursumuzu inceleyebilir. Bu kurs, OpenAI API aracılığıyla OpenAI gömmelerini kullanarak metinsel verilerden gömme üretmeyi ve gerçek dünyadan uygulamalar geliştirmeye başlamayı açıklar.
Yeni OpenAI Gömme Modellerine Genel Bakış
25 Ocak 2024’te duyurulan bu modeller, metni yüksek boyutlu uzayda temsil etmek üzere tasarlanmış, son ve en güçlü gömme modelleridir; metni daha iyi anlamayı kolaylaştırırlar.
text-embedding-3-small gecikme ve depolama için optimize edilmiştir. Öte yandan text-embedding-3-large daha yüksek doğruluk sunar ve yeni dimensions parametresinden yararlanarak kendi yerel boyutu 3072 olsa da gömme boyutunu 1536’da tutabilir, üstelik genel performansı etkilemeden.
Karşılaştırmalı değerlendirme
Yayınlanmadan önce, text-embedding-ada-2 önceki tüm OpenAI gömme modelleri arasında lider durumdaydı ve aşağıdaki tablo bu üç model arasındaki karşılaştırmayı hızlıca özetler.
|
Model |
Boyut |
Maksimum token |
Bilgi kesim tarihi |
Fiyatlandırma ($/1k token) |
MIRACL ort. |
MTEB ort. |
|
ada v2 |
1536 |
8191 |
Eylül 2021 |
0.0001 |
31.4 |
61.0 |
|
text-embedding-3-small |
0.00002 |
44.0 |
62.3 |
|||
|
text-embedding-3-large |
3072 |
0.00013 |
54.9 |
64.6 |
Verilen ölçütlerden, MIRACL ve MTEB karşılaştırmalarında ada v2 (text-embedding-ada-002) modelinden text-embedding-3-large modeline doğru bir performans artışı gözlemleniyor. Bu da 3072 boyuta sahip text-embedding-3-large’ın, diğer ikisine kıyasla daha iyi gömme kalitesi sunduğunu ve bunun doğrudan daha yüksek kıyaslama skorlarına yansıdığını gösterir.
text-embedding-ada-002 ve text-embedding-3-small (her ikisi de 1536) ile text-embedding-3-large (3072) arasındaki boyut artışı, gömmelerinde daha zengin özellik kümelerini yakalayabilen daha karmaşık bir modele işaret eder. Ancak bu durum, 1.000 token başına daha yüksek bir fiyatlamayı da beraberinde getirir; yani performans ile maliyet arasında bir denge söz konusudur.
Bir görevin özel gereksinimlerine (örneğin çok dilli yetenek ihtiyacı, gömülecek metnin karmaşıklığı veya bütçe kısıtları) bağlı olarak farklı bir model tercih edilebilir.
Birden çok dil ve görevde yüksek kaliteli gömmeler gerektiren işler için, daha yüksek maliyetine rağmen text-embedding-3-large tercih edilebilir. Buna karşılık, bütçe kısıtlarının daha sıkı olduğu ya da aşırı yüksek hassasiyetin kritik olmadığı uygulamalar için text-embedding-ada-002 veya text-embedding-3-small daha uygun seçenekler olabilir.
Text-Embedding-3-Large’ın Kullanım Alanları
Gömme teknolojileri, modern doğal dil işleme ve anlama uygulamalarının çoğuna son derece faydalı olmuştur. text-embedding-3-large gibi daha güçlü modellerle text-embedding-3-small gibi daha ekonomik seçenekler arasında yapılacak tercih, NLP uygulamalarının performansını ve maliyet etkinliğini etkileyebilir.
Aşağıda her iki model için de gerçek dünyadaki esnekliklerini ve etkilerini gösteren üçer kullanım örneği yer almaktadır.
text-embedding-3-large’ın kullanım alanları
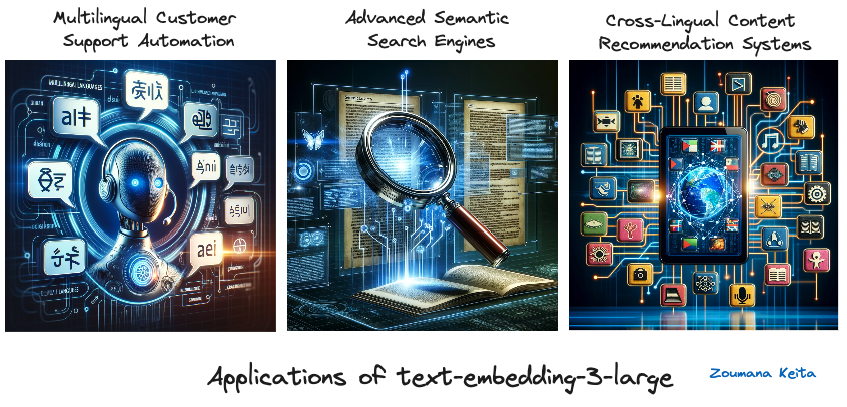
text-embedding-3-large uygulamaları (görseller GPT-4 ile üretildi)
Çok dilli müşteri destek otomasyonu
18 farklı dili anlama ve işleme konusundaki üstün performansıyla text-embedding-3-large, küresel şirketler için müşteri destek sohbet botlarını ve otomatik yanıt sistemlerini güçlendirerek farklı dilsel arka planlarda doğru ve bağlama duyarlı destek sağlar.
Gelişmiş anlamsal arama motorları
Yüksek boyutlu gömmelerinden yararlanarak text-embedding-3-large, arama motoru algoritmalarını iyileştirir; sorgulardaki nüansları daha iyi anlamalarını ve özellikle hukuk veya tıp araştırmaları gibi uzmanlık alanlarında daha ilgili, bağlamsal olarak uyumlu sonuçlar getirmelerini sağlar.
Diller arası içerik öneri sistemleri
Akış servisleri veya haber toplayıcıları gibi çok dilli içerik barındıran platformlar için text-embedding-3-large, kullanıcı tercihlerini ve içeriği birden çok dilde analiz ederek dil engellerinden bağımsız, son derece ilgili içerikleri önerebilir.
text-embedding-3-small’ın kullanım alanları
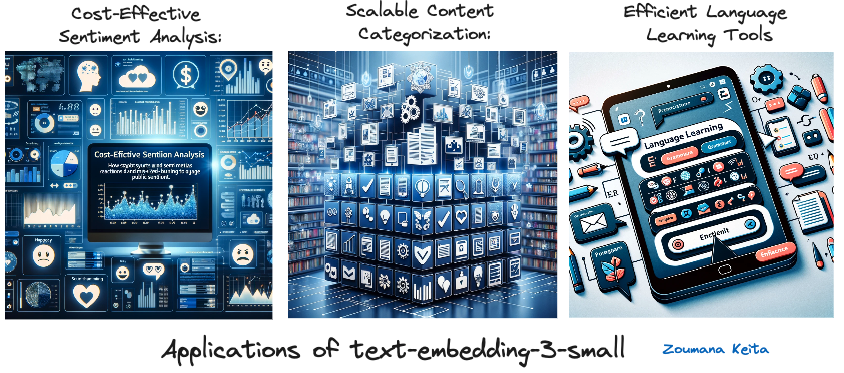
text-embedding-3-small uygulamaları (Görsel GPT-4 ile üretildi)
Uygun maliyetli duygu analizi
Sosyal medya takibi veya geri bildirim analizi yoluyla müşteri duyarlılığını anlamak isteyen girişimler ve orta ölçekli işletmeler için text-embedding-3-small, kamuoyu ve müşteri memnuniyetini ölçmede bütçe dostu fakat etkili bir çözüm sunar.
Ölçeklenebilir içerik kategorilendirme
Bloglar veya e-ticaret siteleri gibi büyük veri hacmine sahip platformlar, içerik veya ürünleri otomatik olarak kategorize etmek için text-embedding-3-small’ı kullanabilir. Verimliliği ve düşük maliyeti, doğruluktan ödün vermeden geniş veri kümelerini ele almak için idealdir.
Verimli dil öğrenme araçları
Kelimeleri anlamlarla eşleştirme veya dilbilgisi kontrolü gibi dil öğrenme egzersizleri sunmak için ölçeklenebilir ve uygun maliyetli çözümlere ihtiyaç duyan eğitim uygulamaları, text-embedding-3-small’dan faydalanabilir. Performans ve erişilebilirlik dengesi, etkileşimli ve dile odaklı eğitim içeriklerinin geliştirilmesini destekler.
Bu kullanım alanları, text-embedding-3-large ve text-embedding-3-small modellerinin farklı sektörlerde en uygun şekilde nasıl devreye alınabileceğini; her bir uygulamanın özel ihtiyaçlarıyla güçlü yönlerini hizalayarak performans, kullanıcı deneyimi ve maliyet etkinliğini nasıl artırabileceğini gösterir.
Yeni OpenAI Gömme Modellerini Kullanmak için Adım Adım Rehber
Belge benzerliği senaryosunda text-embedding-3-large, text-embedding-3-small ve ada-v2’nin uygulanmasına devam etmek için gerekli tüm araçlara sahibiz.
Bu eğiticideki tüm kodlar bir DataLab çalışma defterinde mevcuttur. Kodları bilgisayarınıza hiçbir şey kurmadan çalıştırmak için bu defterin bir kopyasını oluşturun.
Veri hakkında
- Bu, COVID-19, SARS-CoV-2 ve ilgili koronavirüsler hakkında 48.000’den fazlası tam metin olmak üzere 59.000’den fazla akademik makaleden oluşan CORD-19 veri kümesidir.
- Bu veri, Beyaz Saray ve önde gelen araştırma gruplarının bir koalisyonu tarafından, bu bulaşıcı hastalığa karşı devam eden mücadeleyi destekleyecek içgörüler üretmek için küresel araştırmaların kullanımına ücretsiz olarak sunulmuştur.
- Kaggle üzerindeki bu sayfadan indirilebilir.
- Veri kümesiyle ilgili daha fazla ayrıntı bu sayfada bulunabilir.
İlerlemeden önce, bu projenin başarıyla yürütülmesi için aşağıdaki kütüphanelerin kurulması ve içe aktarılması önemlidir.
%%bash ifadesini kullanarak ünlem (!) işaretine gerek olmadan birden fazla kütüphane kurabiliriz.
%%bash
pip -q install tiktoken
pip -q install openai
Şimdi, kütüphaneler aşağıdaki gibi içe aktarılabilir:
import os
import tiktoken
import numpy as np
import pandas as pd
from openai import OpenAI
from sklearn.metrics.pairwise import cosine_similarity
Her bir kütüphanenin rolünü anlayalım:
- os: Dosya sistemine okuma/yazma gibi işletim sistemine bağlı işlevleri kullanmanın bir yolunu sağlar.
- tiktoken: Bilimsel belgelerin işlenmesine özgü tokenleştirme görevlerini ele alır.
- numpy (np): Büyük, çok boyutlu diziler ve matrisler için destek sağlar; bu diziler üzerinde çalışan geniş bir üst düzey matematiksel fonksiyon koleksiyonuyla birlikte gelir; bilimsel hesaplamalar için kritik önemdedir.
- pandas (pd): Sayısal tablolar ve zaman serilerini işlemek için veri yapıları ve işlemler sunar; bilimsel veri kümeleriyle çalışmak için esastır.
- openai.OpenAI: OpenAI’nin API’sine arayüz görevi görür; bilimsel metinler için gömme üretme gibi görevlerde makine öğrenimi modelleriyle etkileşime olanak tanır.
- sklearn.metrics.pairwise.cosine_similarity: Vektörler arasındaki kosinüs benzerliğini hesaplar; bilimsel belge benzerliği analizinde kullanışlıdır.
Veri Keşfi
Orijinal veri çerçevesi 1 GB’tan büyüktür ve basitlik adına yalnızca 1000 rastgele gözlemden oluşan bir örnek yüklenmiştir.
scientific_docs = pd.read_parquet("./data/cord19_df_sample.parquet").head() fonksiyonunu kullanarak verinin ilk 2 satırını görebiliriz; sonuç aşağıdaki animasyonda yer alıyor.
scientific_docs.head(2)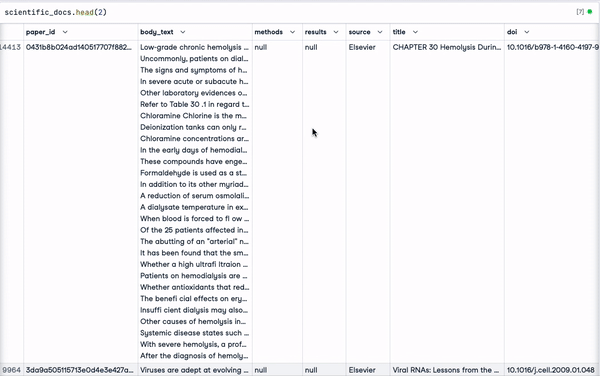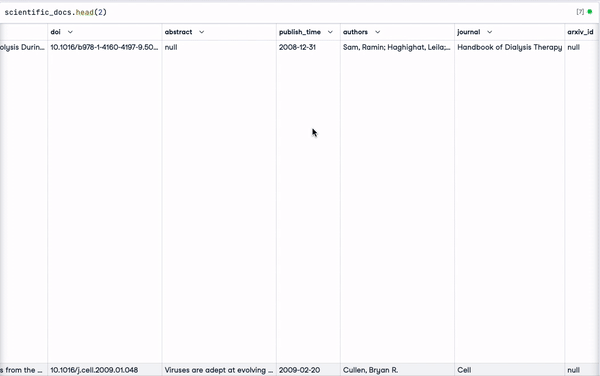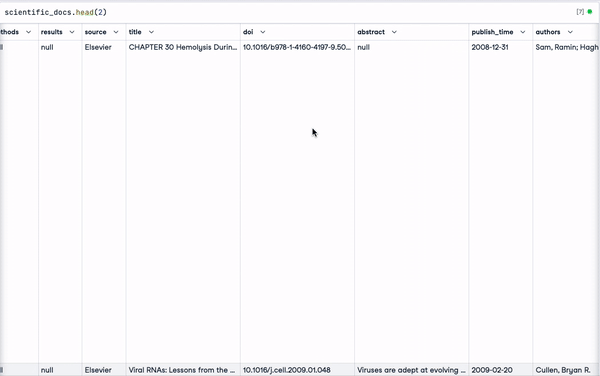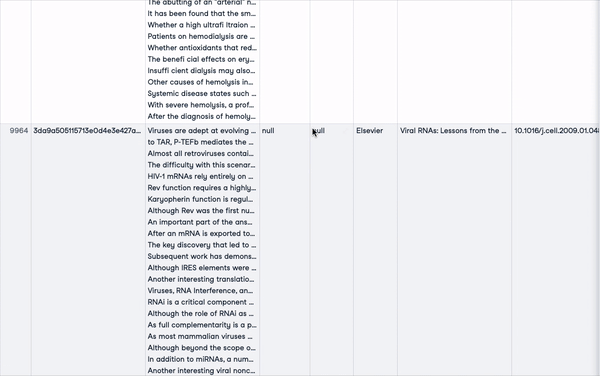
Verinin ilk iki satırı
Belirli bir bilimsel belgenin gövdesi, başlığı ve özeti o belgeyi temsil etmek için yeterli olabilir. Bu üç öznitelik, her belge için tek bir metinsel temsil elde etmek amacıyla birleştirilir.
Bundan önce, bu üç sütunun her birindeki eksik değerlerin yüzdesine bakalım:
percent_missing = scientific_docs.isnull().sum() * 100 / len(scientific_docs)
percent_missing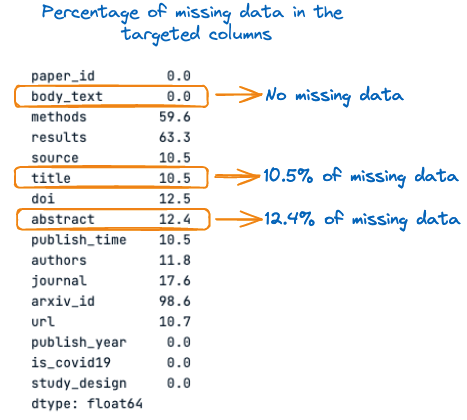
Hedeflenen sütunlardaki eksik veri yüzdesi
Yukarıdaki görselden, başlık ve özet sütunlarında sırasıyla %10,5 ve %12,4 oranında eksik değerler olduğunu görebiliriz. Bu nedenle, bilgi kaybını önlemek için birleştirme öncesinde bu eksik değerleri boş dizelerle doldurmak önemlidir.
Eksik değerleri doldurma ve sütunları birleştirme işleminin tamamı aşağıdaki fonksiyonla gerçekleştirilir.
def concatenate_columns_with_null_handling(df, body_text_column,
                                       	abstract_column,
                                       	title_column,
                                       	new_col_name):

	df[new_col_name] = df[body_text_column].fillna('') + df[abstract_column].fillna('') + df[title_column].fillna('')

	return df
Birleştirme fonksiyonunu orijinal veri üzerinde çalıştırıp ilk 3 satırı kontrol ettikten sonra, işlemin başarıyla tamamlandığını görebiliriz.
new_scientific_docs = concatenate_columns_with_null_handling(scientific_docs,
                                                         	"body_text",
                                                         	"abstract",
                                                         	"title",
"concatenated_text")new_scientific_docs.head(3)Yeni eklenen sütunun adı concatenated_text’tir.
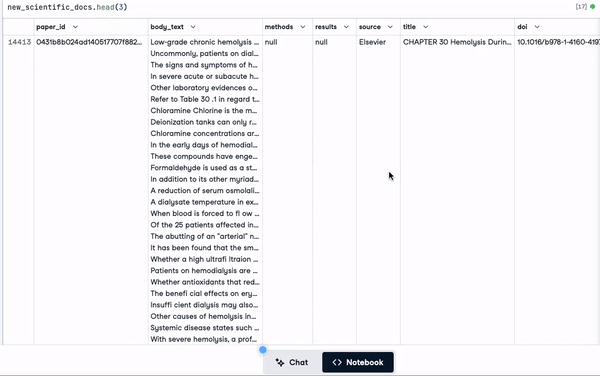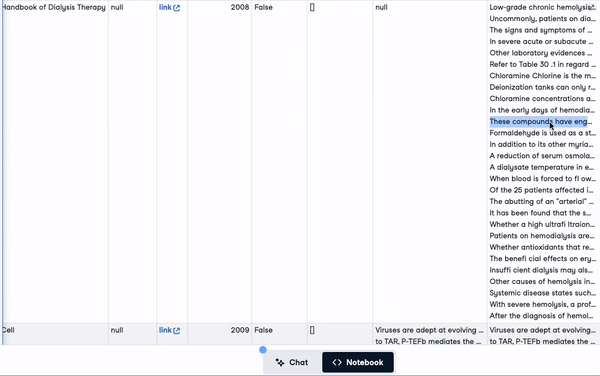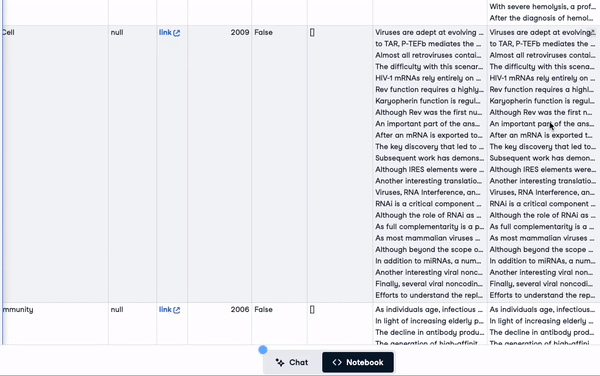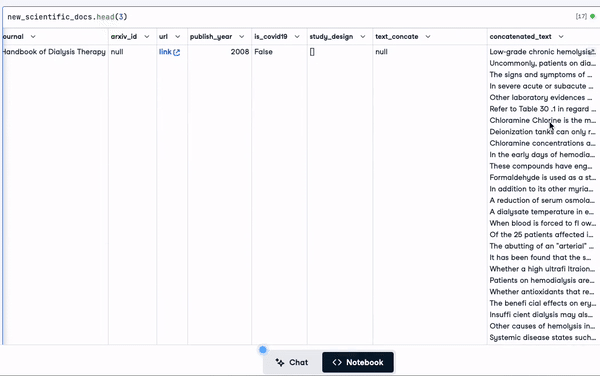
Yeni sütunla birlikte ilk 3 satır
Bir sonraki adım, bu makalede bahsedilen farklı gömme modellerini kullanarak yeni sütuna gömme uygulamaktır. Ancak ondan önce, token uzunluklarının dağılımına bakalım.
Bu analizin amacı, modelin maksimum token sınırlamasını belirli bir belgedeki gerçek token sayısıyla karşılaştırmaktır.
Öncelikle her belgedeki toplam token sayısını saymamız gerekir; bu da num_tokens_from_text yardımcı fonksiyonu ve cl100k_base kodlayıcısı kullanılarak yapılır.
def num_tokens_from_text(text: str, encoding_name="cl100k_base"):
    	"""
    	Returns the number of tokens in a text string.
    	"""
    	encoding = tiktoken.get_encoding(encoding_name)
    	num_tokens = len(encoding.encode(text))
    	return num_tokens
Fonksiyonu tüm veri kümesine uygulamadan önce, şu metin üzerinde nasıl çalıştığına bakalım: This article is about new OpenAI Embeddings.
text = "This article is about new OpenAI Embeddings"
num_tokens = num_tokens_from_text(text)
print(f"Number of tokens: {num_tokens}")
Yukarıdaki kodu başarıyla çalıştırdıktan sonra metnin 10 token içerdiğini görebiliriz.

Metindeki token sayısı
Artık güvenle, lambda ifadesiyle fonksiyonu veri çerçevesindeki tüm metne aşağıdaki şekilde uygulayabiliriz:
new_scientific_docs['num_tokens'] = new_scientific_docs["concatenated_text"].apply(lambda x: num_tokens_from_text(x))8191’den fazla tokena sahip belgelerin toplam sayısını, token sayılarını filtreleyip hangilerinin 8191 sınırını aştığını kontrol ederek belirleyebiliriz.
smaller_tokens_docs = new_scientific_docs[new_scientific_docs['num_tokens'] <= 8191]
len(smaller_tokens_docs)
⇒ Çıktı: 764
Bu, 1000 belgeden 764’ünün maksimum token sınırı gereksinimini karşıladığı anlamına gelir; basitlik adına bu belgeleri kullanıyoruz.
8191’den fazla token içeren kalan belgeleri işlemek için gelişmiş teknikler uygulanabilir.
Bu tekniklerden biri, tek bir belgenin tüm gömmelerinin ortalamasını almaktır. Bir diğer teknik, belgenin ilk 8191 tokenını almaktan ibarettir. Ancak bu yaklaşım verimli değildir; bilgi kaybına yol açabilir.
Veri çerçevesinin indeksini sıfırlayarak 0’dan başlamasını sağlayalım.
smaller_tokens_docs_reset = smaller_tokens_docs.reset_index(drop=True)Gömmeleri çalıştırma
Tüm gereksinimler, her bir model için tüm belgelerin gömme temsillerini elde etmek üzere karşılanmış durumda.
İlk adım, OpenAI kimlik bilgisini edinmek ve istemciyi aşağıdaki gibi yapılandırmaktır:
os.environ["OPENAI_API_KEY"] = "YOUR KEY"
client = OpenAI()
Ardından, aşağıdaki yardımcı fonksiyon, gömme modeli ve gömülecek metni sağlayarak gömme üretmeye yardımcı olur.
def get_embedding(text_to_embbed, model_ID):

	text = text_to_embbed.replace("\n", " ")
	return client.embeddings.create(input = [text_to_embbed],
                                	model=model_ID).data[0].embedding
Şimdi, üç modelin her birine karşılık gelen üç ek sütunun yer aldığı yeni bir veri çerçevesi oluşturuldu:
- text-embedding-3-small
- text-embedding-3-large
- text-embedding-ada-002
smaller_tokens_docs_reset['text-embedding-3-small'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-small"))

smaller_tokens_docs_reset['text-embedding-3-large'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-large"))

smaller_tokens_docs_reset['text-embedding-ada-002'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-ada-002"))
Yukarıdaki kod başarıyla çalıştırıldıktan sonra, ilgili gömme sütunlarının eklendiğini görebiliriz.
smaller_tokens_docs_reset.head(1)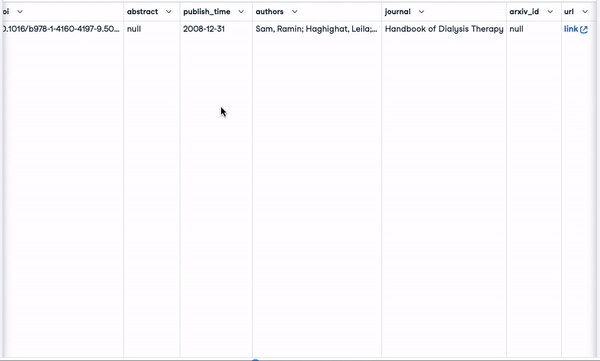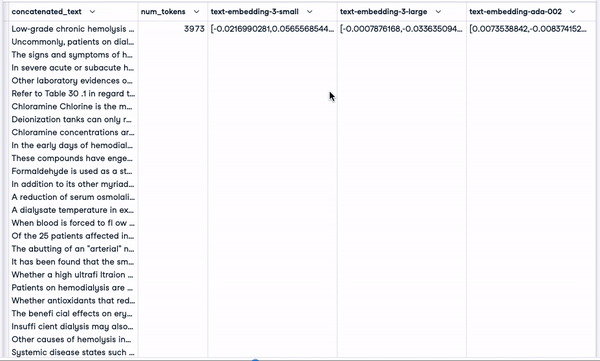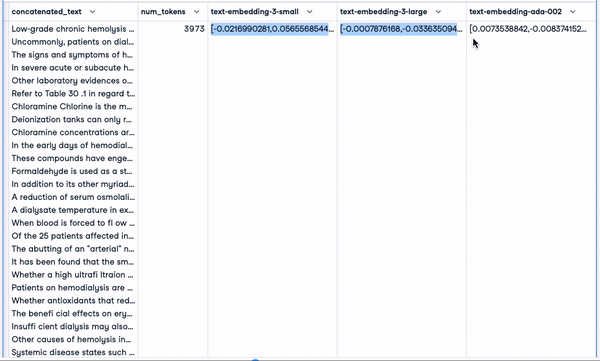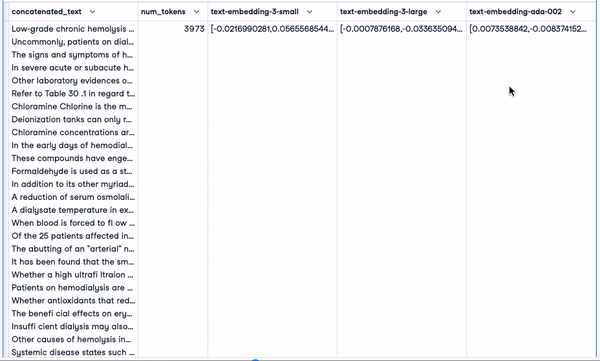
İlgili gömme sütunlarına sahip yeni veri çerçevesi
Benzerlik araması
Bu bölümde, yukarıdaki her bir gömme yaklaşımına karşı kosinüs benzerliği tekniği kullanılarak belirli bir belgeye en benzer ilk 3 belge bulunur.
Aşağıdaki yardımcı fonksiyon dört ana parametre alır:
- Geçerli veri çerçevesi
- En benzer belgelerini bulmak istediğimiz metnin indeksi
- Kullanılacak belirli gömme sütunu
- İstenen en benzer belge sayısı; varsayılan olarak 3’tür.
def find_top_N_similar_documents(df, chosen_index,
                             	embedding_column_name,
                             	top_N=3):

	chosen_document_embedding = np.array(df.iloc[chosen_index][embedding_column_name]).reshape(1, -1)
	embedding_matrix = np.vstack(df[embedding_column_name])
	similarity_scores = cosine_similarity(chosen_document_embedding, embedding_matrix)[0]

	df_temp = df.copy()
	df_temp['similarity_to_chosen'] = similarity_scores
	similar_documents = df_temp.drop(index=chosen_index).sort_values(by='similarity_to_chosen', ascending=False)
	top_N_similar = similar_documents.head(top_N)

	return top_N_similar[[concatenated_text, 'similarity_to_chosen']]
Aşağıdaki bölümde, ilk belgeye (index=0) en çok benzeyen belgeleri buluyoruz.
İlk belge şu şekilde görünüyor:
chosen_index = 0

first_document_data = smaller_tokens_docs_reset.iloc[0]["concatenated_text"]
print(first_document_data)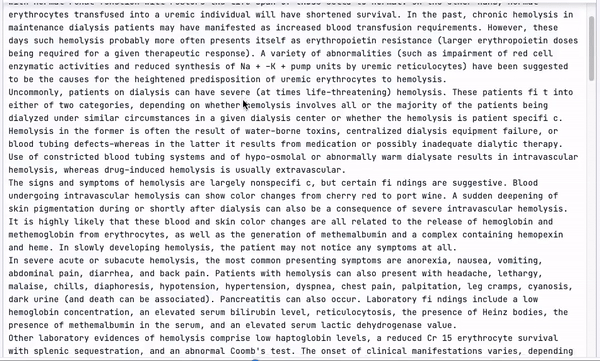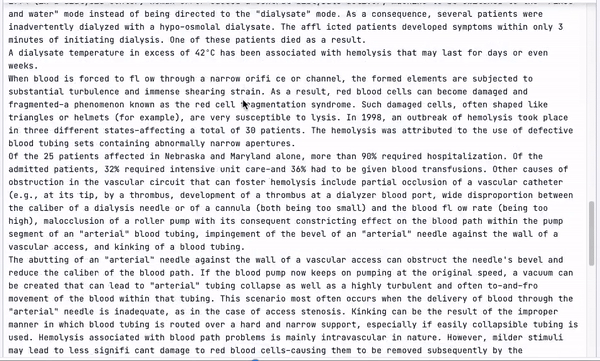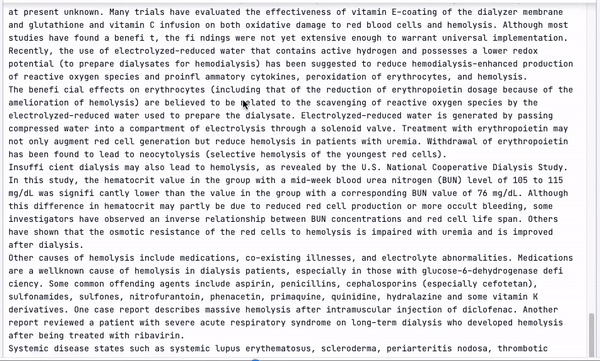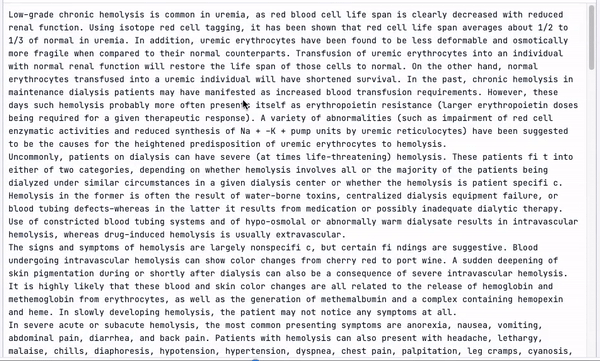
İlk belgenin içeriği (birleştirilmiş sürüm)
Benzerlik arama fonksiyonu aşağıdaki gibi çalıştırılabilir:
top_3_similar_3_small = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-small")

top_3_similar_3_large= find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-large")

top_3_similar_ada_002 = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-ada-002")
Benzerlik görevleri işlendiğinde, sonuçlar aşağıdaki gibi görüntülenebilir:
print("Top 3 Similar Documents with :")
print("--> text-embedding-3-small")
print(top_3_similar_3_small)
print("\n")

print("--> text-embedding-3-large")
print(top_3_similar_3_large)
print("\n")

print("--> text-embedding-ada-002")
print(top_3_similar_ada_002)
print("\n")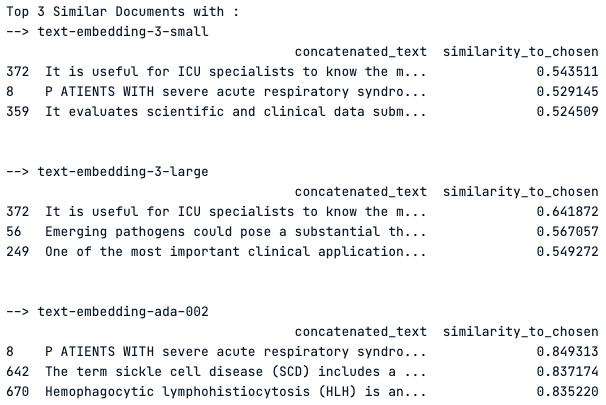
Her bir gömme modelini kullanarak en benzer 3 belge
Sonuçlara ilişkin gözlem
"text-embedding-3-small" modeli yaklaşık 0,54 civarında orta düzey benzerlik skorları gösterirken, "text-embedding-3-large" biraz daha yüksek skorlar sunarak benzerliği daha iyi yakaladığını işaret eder.
"text-embedding-ada-002" modeli ise belirgin biçimde daha yüksek benzerlik skorları üretir; en yüksek skorun 0,85’e yaklaşması, seçilen belgeyle çok güçlü bir benzerlik olduğunu düşündürür.
Bununla birlikte, 372 numaralı Belge tüm modellerde ortak bir üst sırada yer alır; bu da sorguyla tutarlı bir ilişkiye işaret eder. Modeller arasındaki skor farklılıkları, benzerlik sonuçları üzerinde seçilen gömme modelinin etkisini vurgular.
Sonuç
Sonuç olarak, OpenAI’nin yeni text-embedding-3-large ve text-embedding-3-small modelleri, metin verilerinin daha incelikli ve yüksek boyutlu bir temsilini sunarak doğal dil işleme alanında önemli bir sıçrama anlamına gelir.
Makalede gösterildiği gibi, bu modeller arasında yapılacak seçim; belge benzerliği, duygu analizi ve çok dilli destek sistemleri gibi çeşitli NLP görevlerinin sonuçlarını önemli ölçüde etkileyebilir. text-embedding-3-large, artan boyutları sayesinde daha yüksek doğruluk sunarken, text-embedding-3-small maliyete duyarlı uygulamalar için verimlilik ve performans arasında bir denge sağlar.
Karşılaştırmalı analiz, text-embedding-3-large’ın seleflerini geride bıraktığını ve alanda yeni bir standart belirlediğini ortaya koydu. Bu modellerin gerçek dünyadaki uygulamaları; müşteri desteğini iyileştirmekten sofistike arama motorlarını ve içerik öneri sistemlerini güçlendirmeye kadar geniş bir yelpazeye yayılıyor.
Sunulan ayrıntılı rehberi izleyerek, alandaki uygulayıcılar; görevin karmaşıklığı, bütçe kısıtları ve çok dilli yetenek ihtiyacına göre hangi modeli kullanacaklarına dair bilinçli kararlar alabilir.
Sonuçta, model seçimi eldeki projenin özel gereksinimleriyle uyumlu olmalı; yüksek sadakat gerektiren görevlerde text-embedding-3-large’ın, daha genel amaçlar içinse text-embedding-3-small’ın güçlü yönlerinden yararlanılmalıdır. Bu modellerin ortaya çıkışı, OpenAI’nin yapay zeka teknolojisini ilerletme konusundaki kararlılığını ve makine öğrenimi araçlarının sürekli evrimini vurgular.
Bundan sonra nereye?
Python’da OpenAI API’si başlıklı yazımız, en güçlü yapay zeka API’lerinden biri olan OpenAI API’den nasıl yararlanılacağını öğrenmenize yardımcı olacak bir cheat sheet’tir.
Kod eşliğinde oturumumuz OpenAI API ile GPT3.5’i İnce Ayarlama, OpenAI API ve Python’u kullanarak GPT3.5’i ince ayarlamaya başlamaya yönelik rehberler sunar; büyük dil modellerini ne zaman ince ayarlamanın faydalı olabileceğini, OpenAI API’deki ince ayar araçlarının nasıl kullanılacağını ve nihayetinde ince ayar iş akışını anlamayı sağlar.





