Het landschap van machine learning en natural language processing (NLP) blijft zich razendsnel ontwikkelen, en OpenAI loopt daarbij steevast voorop.
De introductie van de modellen text-embedding-3-large en text-embedding-3-small luidt een nieuw tijdperk in binnen het vakgebied en verandert hoe developers en AI-professionals tekstanalyse en embedding-taken benaderen.
In de complexe wereld van kunstmatige intelligentie zijn embeddings cruciaal om complexe menselijke taal om te zetten in iets wat machines kunnen begrijpen en verwerken. Dit nieuwe model van OpenAI betekent een belangrijke stap vooruit voor developers en aankomende data-professionals.
Dit artikel legt de text-embedding-3-large- en text-embedding-3-small-modellen uit en biedt inzicht in hun kernfuncties, uiteenlopende toepassingen en hoe je ze effectief inzet.
Door de basis van text embeddings te verkennen en de nieuwe functies en praktische toepassingen van het model uit te lichten, wil dit artikel je de informatie geven die je nodig hebt om dit geavanceerde hulpmiddel in je projecten te gebruiken.
Daarnaast behandelen we de basis om met het model aan de slag te gaan, delen we tips om embedding-taken te verbeteren en bespreken we de brede impact van deze technologische vooruitgang op het NLP-veld.
Text embeddings begrijpen
Voordat we inzoomen op de details van het nieuwe model, is een korte introductie van text embeddings handig voor een beter begrip.
Text embeddings zijn numerieke representaties van tekst die de semantiek, oftewel de betekenis, van woorden, zinnen of complete documenten vastleggen. Ze vormen de basis van veel NLP-taken, zoals sentimentanalyse, tekstclassificatie en meer.
Onze Introductie tot Text Embeddings met de OpenAI API biedt een complete gids voor het maken van text embeddings met de OpenAI API. Ontdek de toepassingen in tekstclassificatie, informatieopvraag en semantische gelijkenis.
Hieronder staat een illustratie met een embedding-model:
- Links staan de documenten die je wilt representeren
- In het midden het embedding-model, en
- Rechts de bijbehorende embeddings van elk document
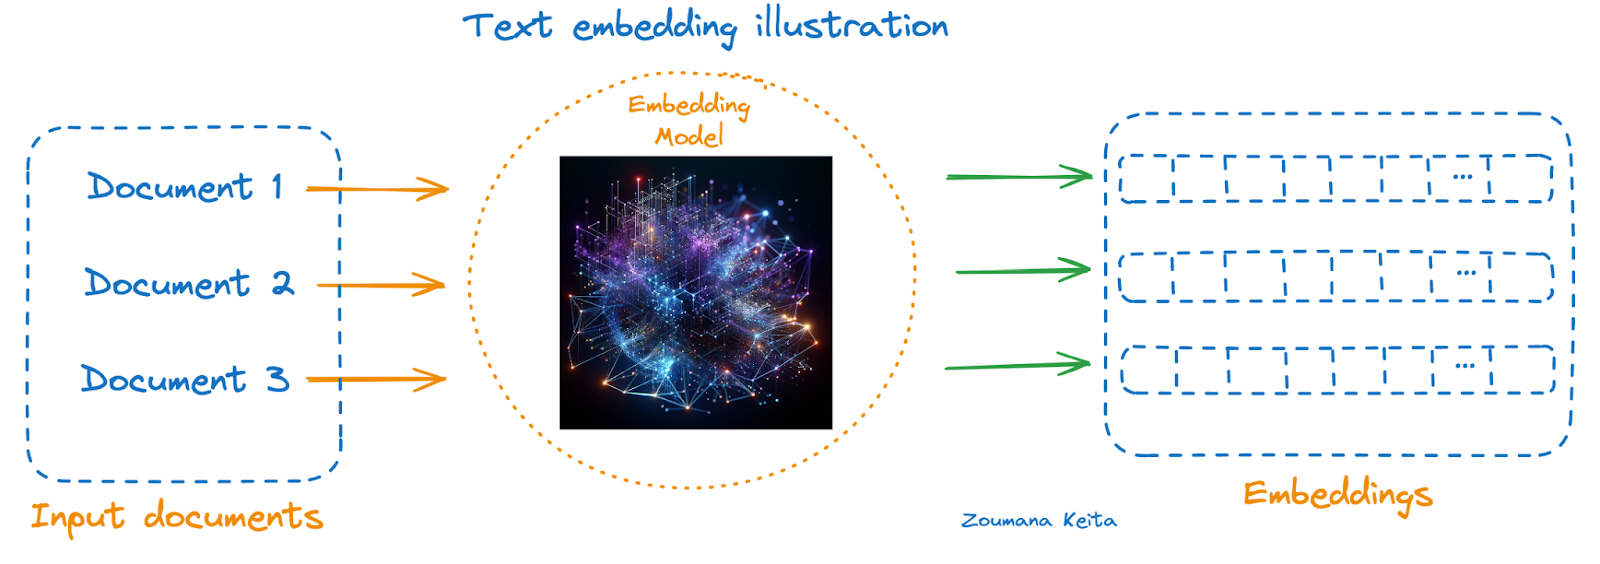
Illustratie van text embeddings
Als dit concept nieuw voor je is, bekijk dan onze cursus Introduction to Embeddings with the OpenAI API. Daarin leer je hoe je via de OpenAI API embeddings uit tekstuele data maakt en begint met het bouwen van realistische toepassingen.
Nieuwe OpenAI-embeddings in één oogopslag
Aangekondigd op 25 januari 2024, zijn dit de nieuwste en krachtigste embedding-modellen, ontworpen om tekst te representeren in een hoogdimensionale ruimte zodat tekst beter kan worden begrepen.
De text-embedding-3-small is geoptimaliseerd voor latency en opslag. Text-embedding-3-large is daarentegen een goede optie voor hogere nauwkeurigheid. We kunnen bovendien het nieuwe parameter dimensions benutten om de embedding op 1536 te houden in plaats van de native grootte van 3072, zonder de algehele performance te beïnvloeden.
Benchmarkanalyse
Voor de release stond de text-embedding-ada-2 bovenaan het klassement van eerdere OpenAI-embeddingmodellen. De onderstaande tabel geeft een snel overzicht van de benchmarkresultaten tussen deze drie modellen.
|
Model |
Dimension |
Max token |
Knowledge cutoff |
Pricing ($/1k tokens) |
MIRACL average |
MTEB average |
|
ada v2 |
1536 |
8191 |
September 2021 |
0.0001 |
31.4 |
61.0 |
|
text-embedding-3-small |
0.00002 |
44.0 |
62.3 |
|||
|
text-embedding-3-large |
3072 |
0.00013 |
54.9 |
64.6 |
Uit de opgegeven metrics zien we een prestatieverbetering van ada v2 (text-embedding-ada-002) naar text-embedding-3-large op zowel MIRACL- als MTEB-benchmarks. Dit suggereert dat text-embedding-3-large, met meer dimensies (3072), een betere embeddingkwaliteit levert dan de andere twee, wat direct samenhangt met verbeterde benchmarkscores.
De toename in dimensies van text-embedding-ada-002 en text-embedding-3-small (beide 1536) naar text-embedding-3-large (3072) wijst op een complexer model dat een rijkere set aan kenmerken kan vastleggen in embeddings. Dit gaat echter gepaard met een hogere prijs per 1.000 verwerkte tokens, wat duidt op een trade-off tussen performance en kosten.
Afhankelijk van de specifieke eisen van een taak (bijv. behoefte aan meertalige mogelijkheden, complexiteit van de te embedden tekst of budgetbeperkingen) kan een ander model de voorkeur krijgen.
Voor taken die hoogwaardige embeddings in meerdere talen en use-cases vereisen, kan text-embedding-3-large de voorkeur hebben ondanks de hogere kosten. Voor toepassingen met striktere budgetten of waar ultrahoge precisie minder kritisch is, kunnen text-embedding-ada-002 of text-embedding-3-small geschikter zijn.
Toepassingen van Text-Embedding-3-Large
Embeddingtechnologieën zijn bijzonder waardevol gebleken voor veel moderne NLP- en NLU-toepassingen. De keuze tussen krachtigere modellen zoals text-embedding-3-large en voordeligere opties zoals text-embedding-3-small beïnvloedt de performance en kostenefficiëntie van NLP-toepassingen.
Hieronder staan drie illustraties van use-cases voor beide modellen, die hun veelzijdigheid en impact in praktijksituaties laten zien.
Toepassingen van text-embedding-3-large
Toepassingen van text-embedding-3-large (afbeeldingen gegenereerd met GPT-4)
Meertalige automatisering van klantenservice
Dankzij de superieure prestaties in het begrijpen en verwerken van 18 verschillende talen kan text-embedding-3-large chatbots en geautomatiseerde reactiesystemen voor wereldwijde bedrijven aandrijven, met nauwkeurige, contextbewuste ondersteuning voor diverse taalkundige achtergronden.
Geavanceerde semantische zoekmachines
Door de hoogdimensionale embeddings te benutten, kan text-embedding-3-large zoekalgoritmes verbeteren, zodat ze de nuances van zoekopdrachten beter begrijpen en relevantere, contextueel passende resultaten terugvinden, vooral in specialistische domeinen zoals juridisch of medisch onderzoek.
Cross-linguale contentaanbevelingen
Voor platforms met een breed aanbod aan meertalige content, zoals streamingdiensten of nieuwsaggregators, kan text-embedding-3-large gebruikersvoorkeuren en content in meerdere talen analyseren en zeer relevante content aanbevelen, ongeacht taalbarrières.
Toepassingen van text-embedding-3-small
Toepassingen van text-embedding-3-small (afbeelding gegenereerd met GPT-4)
Kosteneffectieve sentimentanalyse
Voor startups en middelgrote bedrijven die klantgevoel willen begrijpen via social media monitoring of feedbackanalyse, biedt text-embedding-3-small een budgetvriendelijke maar effectieve oplossing om publieke opinie en klanttevredenheid te meten.
Schaalbare contentcategorisatie
Contentplatforms met grote datavolumes, zoals blogs of e-commerce-sites, kunnen text-embedding-3-small gebruiken om content of producten automatisch te categoriseren. De efficiëntie en lagere kosten maken het ideaal voor het verwerken van grote datasets zonder concessies aan nauwkeurigheid.
Efficiënte taalhulpmiddelen
Educatieve apps die schaalbare en voordelige oplossingen nodig hebben voor taalopdrachten, zoals woorden koppelen aan betekenissen of grammaticacontrole, profiteren van text-embedding-3-small. De balans tussen performance en betaalbaarheid ondersteunt de ontwikkeling van interactieve, taalfocus-educatieve content.
Deze toepassingen laten zien hoe text-embedding-3-large en text-embedding-3-small optimaal kunnen worden ingezet in verschillende sectoren, waarbij hun sterke punten worden afgestemd op de specifieke behoeften van elke toepassing voor betere prestaties, gebruikerservaring en kostenefficiëntie.
Stapsgewijze handleiding voor het gebruik van de nieuwe OpenAI-embeddings
We hebben nu alle tools om zowel text-embedding-3-large, text-embedding-3-small als ada-v2 te implementeren in een scenario voor documentsimilariteit.
Alle code in deze tutorial staat in een DataLab-workbook. Maak een kopie van dit workbook om de code te draaien zonder iets op je computer te installeren.
Over de data
- Dit is de CORD-19-dataset, een bron met meer dan 59.000 wetenschappelijke artikelen, waarvan meer dan 48.000 met volledige tekst, over COVID-19, SARS-CoV-2 en verwante coronavirussen.
- Deze data is gratis beschikbaar gesteld door het Witte Huis en een coalitie van toonaangevende onderzoeksgroepen om wereldwijd onderzoek te ondersteunen in de strijd tegen deze infectieziekte.
- Hij is te downloaden via deze pagina op Kaggle.
- Verdere details over de dataset zijn op deze pagina te vinden.
Voordat we verder gaan, is het belangrijk om de volgende libraries te installeren en te importeren voor het slagen van dit project.
Met de %%bash-instructie kunnen we meerdere libraries installeren zonder het uitroepteken (!) te gebruiken.
%%bash
pip -q install tiktoken
pip -q install openai
Nu kunnen de libraries als volgt worden geïmporteerd:
import os
import tiktoken
import numpy as np
import pandas as pd
from openai import OpenAI
from sklearn.metrics.pairwise import cosine_similarity
De rol van elke library:
- os: Biedt toegang tot functies van het besturingssysteem, zoals lezen en schrijven naar het bestandssysteem.
- tiktoken: Handelt tokenizatietaken af die specifiek zijn voor het verwerken van wetenschappelijke documenten.
- numpy (np): Ondersteunt grote, multidimensionale arrays en matrices, plus een grote verzameling wiskundige functies om daarop te opereren, cruciaal voor wetenschappelijke computing.
- pandas (pd): Biedt datastructuren en operaties voor het manipuleren van numerieke tabellen en tijdreeksen, essentieel voor het werken met wetenschappelijke datasets.
- openai.OpenAI: Dient als interface naar de OpenAI API om te werken met machine learning-modellen, bijvoorbeeld voor het genereren van embeddings voor wetenschappelijke teksten.
- sklearn.metrics.pairwise.cosine_similarity: Berekent de cosinusgelijkenis tussen vectoren, handig voor het analyseren van documentgelijkenis.
Data verkennen
De oorspronkelijke dataframe is groter dan 1 GB; voor de eenvoud laden we slechts een steekproef van 1000 willekeurige observaties.
scientific_docs = pd.read_parquet("./data/cord19_df_sample.parquet")Met de .head()-functie zien we de eerste 2 rijen van de data; het resultaat staat in de onderstaande animatie.
scientific_docs.head(2)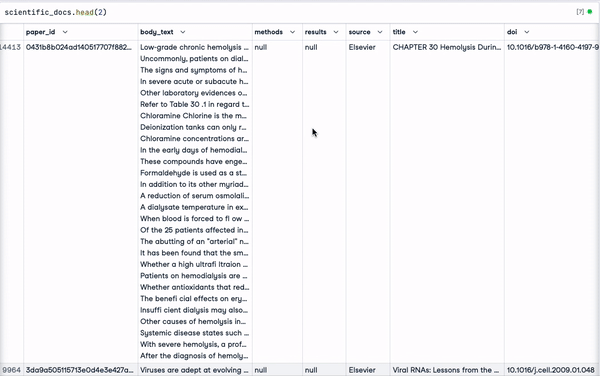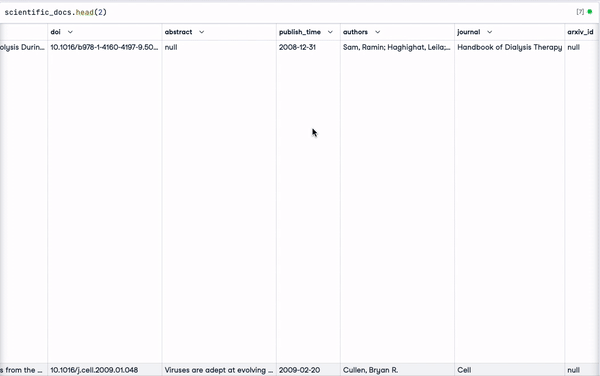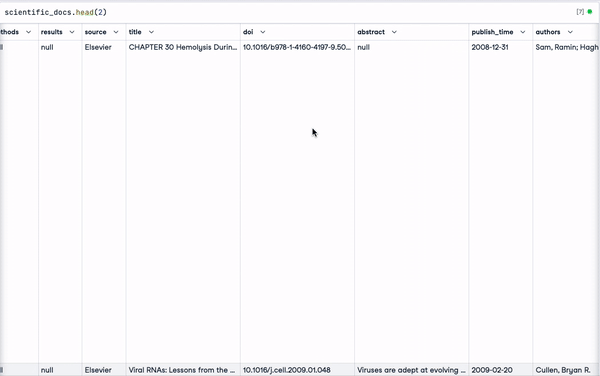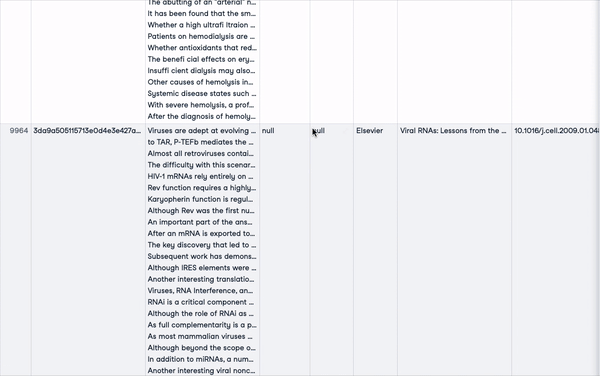
Eerste twee rijen van de data
De body, titel en samenvatting van een wetenschappelijk document zijn vaak genoeg om dat document te representeren. Deze drie velden worden samengevoegd tot één tekstuele representatie per document.
Maar eerst bekijken we het percentage missende waarden in elk van deze drie kolommen:
percent_missing = scientific_docs.isnull().sum() * 100 / len(scientific_docs)
percent_missing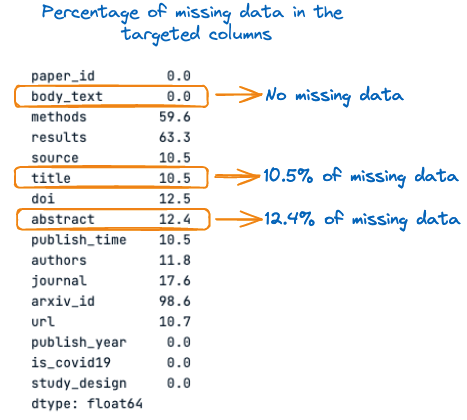
Percentage missende data in de geselecteerde kolommen
Uit de bovenstaande afbeelding blijkt dat titel en samenvatting missende waarden hebben, respectievelijk 10,5% en 12,4%. Daarom is het belangrijk om die missende waarden voor het samenvoegen op te vullen met lege strings om informatieverlies te voorkomen.
Het gehele proces van missende waarden opvullen en kolommen samenvoegen wordt uitgevoerd met de volgende functie.
def concatenate_columns_with_null_handling(df, body_text_column,
                                       	abstract_column,
                                       	title_column,
                                       	new_col_name):

	df[new_col_name] = df[body_text_column].fillna('') + df[abstract_column].fillna('') + df[title_column].fillna('')

	return df
Na het draaien van de samenvoegfunctie op de oorspronkelijke data en het controleren van de eerste 3 rijen zien we dat het samenvoegen is geslaagd.
new_scientific_docs = concatenate_columns_with_null_handling(scientific_docs,
                                                         	"body_text",
                                                         	"abstract",
                                                         	"title",
"concatenated_text")new_scientific_docs.head(3)De nieuw toegevoegde kolom heet concatenated_text.
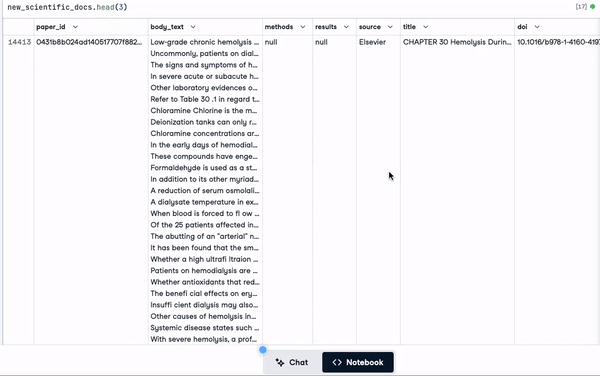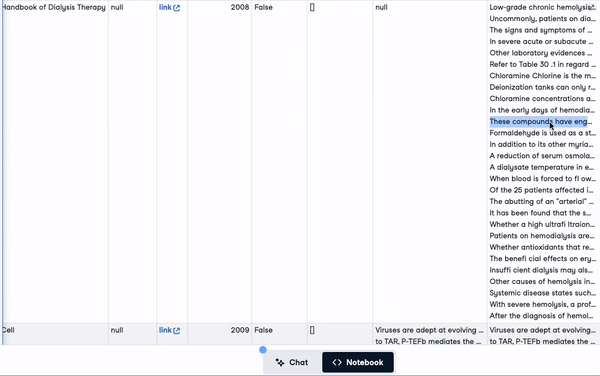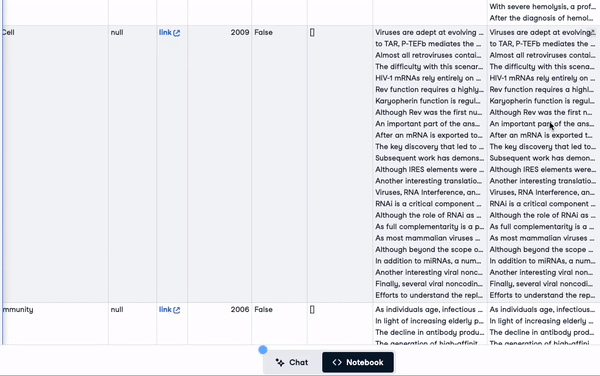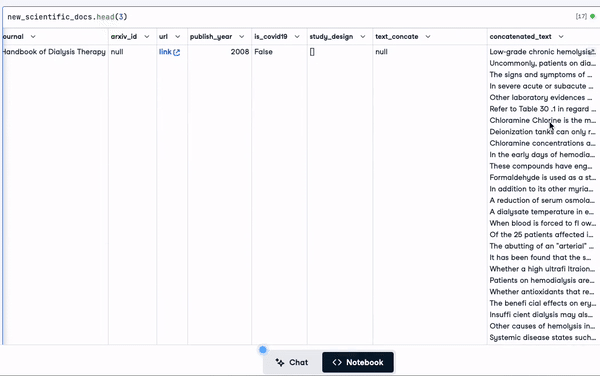
Eerste 3 rijen met de nieuw toegevoegde kolom
De volgende stap is om embeddings toe te passen op de nieuwe kolom met de verschillende embeddingmodellen die in dit artikel worden genoemd. Maar eerst bekijken we de verdeling van de lengte van de tokens.
Het doel van deze analyse is om de maximale tokenlimiet van het model te toetsen aan het daadwerkelijke aantal tokens binnen een document.
We moeten eerst het totale aantal tokens per document tellen. Dat doen we met de helperfunctie num_tokens_from_text en de cl100k_base-encoder.
def num_tokens_from_text(text: str, encoding_name="cl100k_base"):
    	"""
    	Returns the number of tokens in a text string.
    	"""
    	encoding = tiktoken.get_encoding(encoding_name)
    	num_tokens = len(encoding.encode(text))
    	return num_tokens
Voordat we de functie op de hele dataset toepassen, kijken we hoe hij werkt op de volgende tekst: This article is about new OpenAI Embeddings.
text = "This article is about new OpenAI Embeddings"
num_tokens = num_tokens_from_text(text)
print(f"Number of tokens: {num_tokens}")
Na succesvolle uitvoering zien we dat de tekst 10 tokens heeft.

Aantal tokens in de tekst
Met dit vertrouwen kunnen we de functie toepassen op alle tekst in de dataframe met de volgende lambda-expressie:
new_scientific_docs['num_tokens'] = new_scientific_docs["concatenated_text"].apply(lambda x: num_tokens_from_text(x))We kunnen het aantal documenten tellen met meer dan 8191 tokens door te filteren op het aantal tokens en te controleren welke boven de limiet van 8191 liggen.
smaller_tokens_docs = new_scientific_docs[new_scientific_docs['num_tokens'] <= 8191]
len(smaller_tokens_docs)
⇒ Output: 764
Dit betekent dat 764 documenten van de 1000 voldoen aan de maximale tokenlimiet. Voor de eenvoud gebruiken we die documenten.
Voor de overige documenten met meer dan 8191 tokens kun je geavanceerde technieken toepassen.
Een techniek is het gemiddelde nemen van alle embeddings van één document. Een andere techniek is de eerste 8191 tokens van het document nemen. Deze aanpak is niet efficiënt omdat die tot informatieverlies kan leiden.
Laten we de index van de dataframe resetten zodat die weer bij nul begint.
smaller_tokens_docs_reset = smaller_tokens_docs.reset_index(drop=True)Embeddings uitvoeren
Alle voorwaarden zijn vervuld om de embeddingrepresentatie van alle documenten te verkrijgen, en dit doen we voor elk embeddingmodel.
De eerste stap is het ophalen van de OpenAI-credentials en de client als volgt configureren:
os.environ["OPENAI_API_KEY"] = "YOUR KEY"
client = OpenAI()
Vervolgens helpt de onderstaande helperfunctie om de embedding te genereren door het embeddingmodel en de te embedden tekst op te geven.
def get_embedding(text_to_embbed, model_ID):

	text = text_to_embbed.replace("\n", " ")
	return client.embeddings.create(input = [text_to_embbed],
                                	model=model_ID).data[0].embedding
We maken nu een nieuwe dataframe met drie extra kolommen die overeenkomen met de embedding van elk van de drie modellen:
- text-embedding-3-small
- text-embedding-3-large
- text-embedding-ada-002
smaller_tokens_docs_reset['text-embedding-3-small'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-small"))

smaller_tokens_docs_reset['text-embedding-3-large'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-3-large"))

smaller_tokens_docs_reset['text-embedding-ada-002'] = smaller_tokens_docs_reset["concatenated_text"].apply(lambda x: get_embedding(x, "text-embedding-ada-002"))
Na succesvolle uitvoering zien we dat de relevante embeddingkolommen zijn toegevoegd.
smaller_tokens_docs_reset.head(1)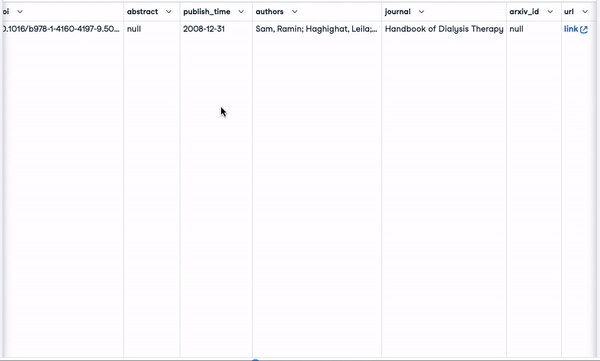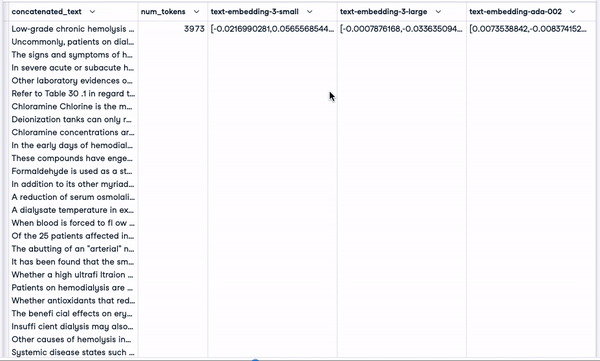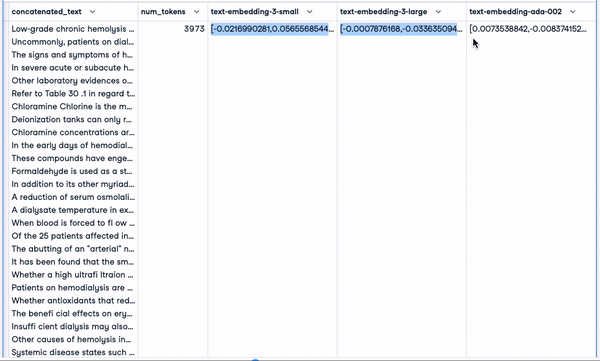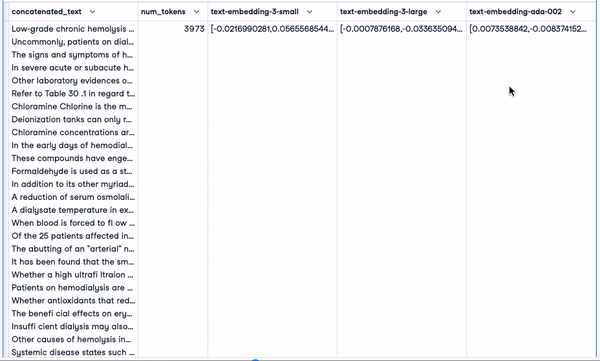
Nieuwe dataframe met relevante embeddingkolommen
Zoeken op gelijkenis
In deze sectie gebruiken we de cosinusgelijkenis op elk van de bovenstaande embeddingbenaderingen om de 3 meest vergelijkbare documenten bij een specifiek document te vinden.
De volgende helperfunctie neemt vier hoofdparameters:
- De huidige dataframe
- De index van de tekst waarvoor we de meest vergelijkbare documenten willen vinden
- De specifieke embedding die we gebruiken
- Het gewenste aantal meest vergelijkbare documenten, standaard 3.
def find_top_N_similar_documents(df, chosen_index,
                             	embedding_column_name,
                             	top_N=3):

	chosen_document_embedding = np.array(df.iloc[chosen_index][embedding_column_name]).reshape(1, -1)
	embedding_matrix = np.vstack(df[embedding_column_name])
	similarity_scores = cosine_similarity(chosen_document_embedding, embedding_matrix)[0]

	df_temp = df.copy()
	df_temp['similarity_to_chosen'] = similarity_scores
	similar_documents = df_temp.drop(index=chosen_index).sort_values(by='similarity_to_chosen', ascending=False)
	top_N_similar = similar_documents.head(top_N)

	return top_N_similar[[concatenated_text, 'similarity_to_chosen']]
In de volgende sectie zoeken we de meest vergelijkbare documenten bij het eerste document (index=0).
Zo ziet het eerste document eruit:
chosen_index = 0

first_document_data = smaller_tokens_docs_reset.iloc[0]["concatenated_text"]
print(first_document_data)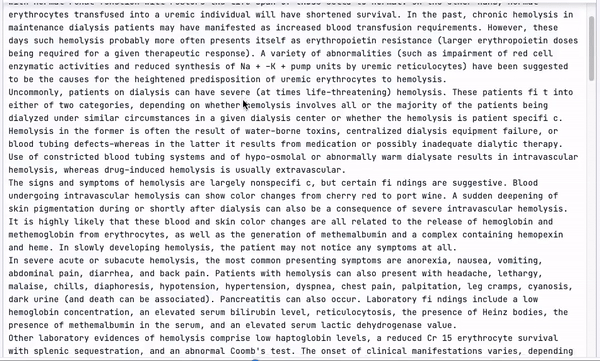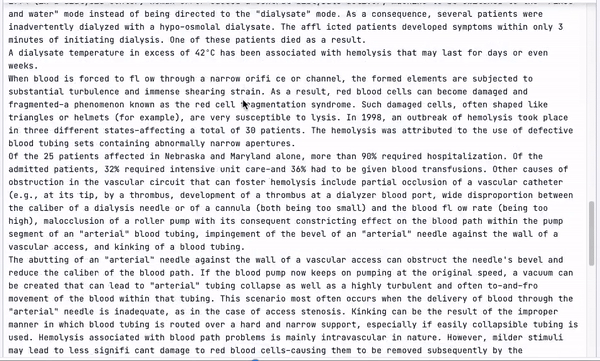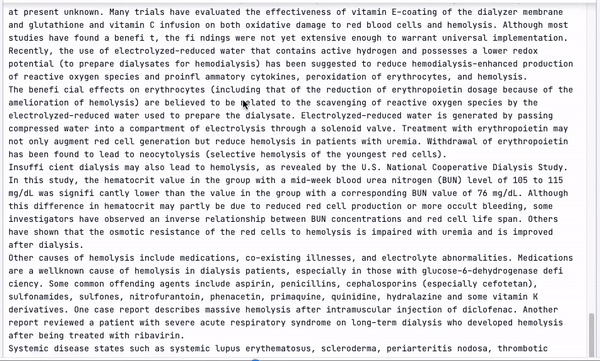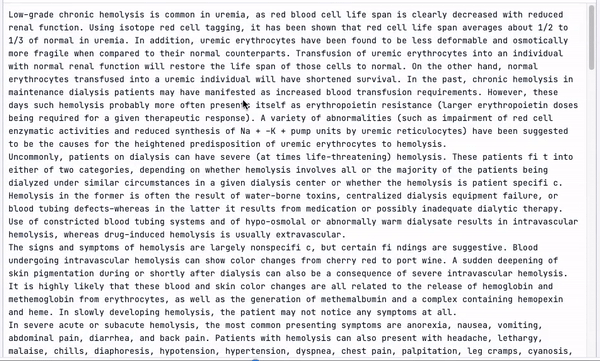
Inhoud van het eerste document (samengevoegde versie)
De functie voor gelijkeniszoeken kun je als volgt uitvoeren:
top_3_similar_3_small = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-small")

top_3_similar_3_large= find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-3-large")

top_3_similar_ada_002 = find_top_N_similar_documents(smaller_tokens_docs_reset,
                                                 	chosen_index,
                                                 	"text-embedding-ada-002")
Na het verwerken van de gelijkenistaken kun je het resultaat als volgt weergeven:
print("Top 3 Similar Documents with :")
print("--> text-embedding-3-small")
print(top_3_similar_3_small)
print("\n")

print("--> text-embedding-3-large")
print(top_3_similar_3_large)
print("\n")

print("--> text-embedding-ada-002")
print(top_3_similar_ada_002)
print("\n")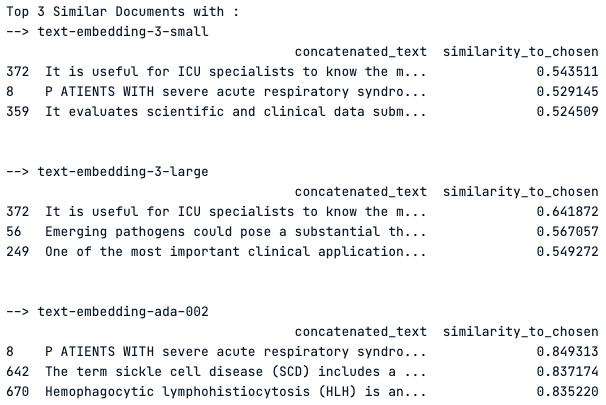
Top 3 meest vergelijkbare documenten met elk embeddingmodel
Observatie van het resultaat
Het model "text-embedding-3-small" toont gematigde gelijkenisscores rond 0,54, terwijl "text-embedding-3-large" iets hogere scores heeft, wat duidt op een betere vastlegging van gelijkenis.
Het model "text-embedding-ada-002" toont aanzienlijk hogere gelijkenisscores, met de hoogste score rond 0,85, wat wijst op een zeer sterke gelijkenis met het gekozen document.
Document 372 is echter een gemeenschappelijk topresultaat voor alle modellen, wat duidt op consistente relevantie voor de query. De variërende scores tussen modellen benadrukken de impact van de modelkeuze op de gelijkenisresultaten.
Conclusie
Kortom, OpenAI’s nieuwe modellen text-embedding-3-large en text-embedding-3-small betekenen een grote sprong voorwaarts in NLP, met een meer genuanceerde en hoogdimensionale representatie van tekstdata.
Zoals in het artikel gedemonstreerd, kan de keuze tussen deze modellen de uitkomst van uiteenlopende NLP-taken sterk beïnvloeden, zoals documentsimilariteit, sentimentanalyse en meertalige supportsystemen. Terwijl text-embedding-3-large hogere nauwkeurigheid biedt dankzij het grotere aantal dimensies, levert text-embedding-3-small een balans tussen efficiëntie en prestaties voor kostengevoelige toepassingen.
Benchmarkanalyse liet zien dat text-embedding-3-large zijn voorgangers overtreft en een nieuwe standaard zet. De toepassingen in de praktijk zijn groot, van betere klantenondersteuning tot het aandrijven van geavanceerde zoekmachines en aanbevelingssystemen.
Met de gedetailleerde handleiding kunnen professionals weloverwogen beslissen welk model te gebruiken, afhankelijk van de complexiteit van de taak, budgetbeperkingen en de behoefte aan meertaligheid.
Uiteindelijk moet de keuze voor een model aansluiten op de specifieke eisen van het project: benut de kracht van text-embedding-3-large voor taken die hoge precisie vereisen en kies text-embedding-3-small voor algemenere doeleinden. De komst van deze modellen onderstreept OpenAI’s inzet voor de vooruitgang van AI-technologie en de voortdurende evolutie van machine learning-tools.
Waar ga je nu heen?
Ons artikel The OpenAI API in Python is een cheatsheet waarmee je de basis leert om een van de krachtigste AI-API’s te benutten: de OpenAI API.
Onze code-alongsessie Fine-tuning GPT3.5 with OpenAI API biedt richtlijnen om met de OpenAI API en Python aan de slag te gaan met het fine-tunen van GPT3.5. Je leert wanneer fine-tunen van large language models nuttig kan zijn, hoe je de fine-tuningtools in de OpenAI API gebruikt en hoe de workflow van fine-tuning eruitziet.


