GPT-3, Generative Pre-trained Transformer generasi ketiga, adalah model deep learning jaringan saraf mutakhir yang dibuat oleh OpenAI. Dengan memanfaatkan sejumlah besar data internet, GPT-3 dapat menghasilkan beragam teks buatan mesin yang kuat dengan masukan minimal. GPT-3 memiliki beragam penerapan dan tidak terbatas pada peringkasan teks, penerjemahan, pengembangan chatbot, dan pembuatan konten.
Terlepas dari ketangguhannya, kinerja GPT-3 masih dapat ditingkatkan melalui fine-tuning pada kasus penggunaan tertentu.
Namun, apa yang dimaksud dengan fine-tuning?
Ini adalah proses melatih GPT-3 yang telah dipra-latih pada dataset kasus penggunaan kustom. Ini memungkinkan model beradaptasi lebih baik dengan nuansa kasus penggunaan atau domain tersebut, sehingga menghasilkan hasil yang lebih akurat.
Prasyarat untuk berhasil melakukan fine-tuning adalah (1) pemahaman dasar pemrograman Python dan (2) keakraban dengan machine learning dan pemrosesan bahasa alami.
Artikel Klasifikasi dalam Machine Learning: Sebuah Pengantar kami membantu Anda mempelajari tentang klasifikasi dalam machine learning, mencakup apa itu, bagaimana digunakan, dan beberapa contoh algoritma klasifikasi.
Kami akan menggunakan paket Python openai yang disediakan oleh OpenAI untuk memudahkan penggunaan API mereka dan mengakses kapabilitas GPT-3.
Artikel ini akan membahas proses fine-tuning model GPT-3 menggunakan Python pada data milik pengguna, mencakup semua langkah, mulai dari mendapatkan kredensial API hingga menyiapkan data, melatih model, dan memvalidasinya.
Model GPT Mana yang Dapat Di-Fine-Tune?
Model GPT yang dapat di-fine-tune mencakup Ada, Babbage, Curie, dan Davinci. Model-model ini termasuk dalam keluarga GPT-3. Selain itu, penting untuk dicatat bahwa fine-tuning saat ini tidak tersedia untuk model GPT-3.5-turbo yang lebih baru atau GPT-4 lainnya.
Baca panduan pemula untuk GPT-3 kami untuk informasi lebih lanjut tentang model tersebut.
Apa Saja Kasus Penggunaan yang Baik untuk Fine-Tuning GPT?
Klasifikasi dan generasi kondisional adalah dua jenis permasalahan yang dapat memperoleh manfaat dari fine-tuning model bahasa seperti GPT-3. Mari kita bahas singkat masing-masing.
Klasifikasi
Untuk permasalahan klasifikasi, setiap masukan pada prompt ditetapkan ke salah satu kelas yang telah ditentukan, dan beberapa kasus diilustrasikan di bawah ini:
- Memastikan pernyataan yang benar: Jika sebuah perusahaan ingin memverifikasi bahwa iklan di situs web mereka menyebutkan produk dan perusahaan yang benar, sebuah pengklasifikasi dapat di-fine-tune untuk menyaring iklan yang tidak benar, memastikan model tidak mengada-ada.
- Analisis sentimen: Ini melibatkan pengklasifikasian teks berdasarkan sentimen, seperti positif, negatif, atau netral.
- Kategorisasi triase email: Untuk memilah email masuk ke salah satu dari banyak kategori yang telah ditentukan, kategori tersebut dapat diubah menjadi angka, yang bekerja baik hingga sekitar 500 kategori.
Generasi kondisional
Permasalahan dalam kategori ini melibatkan pembuatan konten berdasarkan masukan yang diberikan. Aplikasinya mencakup parafrase, peringkasan, ekstraksi entitas, penulisan deskripsi produk, asisten virtual (chatbot), dan lainnya. Contohnya meliputi:
- Menciptakan iklan yang menarik dari artikel Wikipedia. Dalam kasus penggunaan generatif ini, pastikan contoh yang disediakan berkualitas tinggi, karena model yang di-fine-tune akan mencoba meniru gaya (dan kesalahan) dari contoh.
- Ekstraksi entitas. Tugas ini mirip dengan permasalahan transformasi bahasa. Tingkatkan kinerja dengan mengurutkan entitas yang diekstraksi secara alfabetis atau sesuai urutan kemunculannya dalam teks asli.
- Chatbot dukungan pelanggan. Chatbot biasanya menyertakan konteks relevan tentang percakapan (detail pesanan), ringkasan percakapan sejauh ini, dan pesan terbaru.
- Deskripsi produk berdasarkan sifat teknis. Ubah data masukan menjadi bahasa alami untuk mencapai kinerja yang lebih baik dalam konteks ini.
Implementasi Langkah demi Langkah Fine-Tuning GPT-3
Membuat akun pengembang OpenAI wajib dilakukan untuk mengakses kunci API, dan langkah-langkahnya disediakan di bawah ini:
Pertama, buat akun dari situs resmi OpenAI.
Lalu, pilih ikon profil pengguna di sudut kanan atas dan klik “View API Keys” untuk mengakses halaman pembuatan kunci API baru atau menggunakan yang sudah ada.

Buat kunci rahasia baru dari tab “Create new secret key” dengan memberikan nama yang bermakna (GPT3_fine_tuning_key dalam kasus ini), lalu kunci API akan dibuat secara otomatis.


Jika Anda mengalami kendala atau kesulitan, pastikan untuk melihat DataLab workbook dengan seluruh kode.
Dataset
Dalam kasus penggunaan ini, kita akan melakukan fine-tuning model GPT-3 untuk skenario tanya jawab, yang terdiri dari pola tanya jawab terstruktur yang dirancang untuk membantu model memahami tugas yang perlu dilakukan. Format yang konsisten dipertahankan untuk setiap pasangan pertanyaan dan jawaban di seluruh data pelatihan dan pengujian.
Satu instance dalam dataset tanya jawab memiliki format berikut:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- “prompt” adalah teks masukan yang dibaca dan diproses oleh model. Pemisah utama adalah tanda panah (->) untuk membatasi prompt dari respons yang diharapkan.
- “completion” adalah respons yang diharapkan terhadap prompt. Tanda backslash “\n” digunakan sebagai urutan berhenti untuk menandai akhir jawaban.
Dengan pemahaman tentang format dataset ini, kita dapat menghasilkan dataset pelatihan dan validasi, seperti yang ditunjukkan di bawah. Prompt dan completion ini dibuat menggunakan ChatGPT.
ChatGPT Cheat Sheet untuk Data Science kami menyediakan akses ke lebih dari 60 prompt untuk tugas Data Science.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Penyiapan
Sebelum masuk ke proses implementasi, kita perlu menyiapkan lingkungan kerja dengan memasang pustaka yang diperlukan, khususnya pustaka OpenAI untuk Python, seperti di bawah ini:
pip install --upgrade openaiSekarang kita dapat mengimpor pustaka tersebut.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Menyiapkan dataset
Bekerja dengan format daftar, seperti di atas, mungkin nyaman untuk dataset kecil. Namun, ada beberapa manfaat menyimpan data dalam format JSONL (JSON Lines). Manfaatnya mencakup skalabilitas, interoperabilitas, kesederhanaan, serta kompatibilitas dengan OpenAI API, yang memerlukan data dalam format JSONL saat membuat pekerjaan fine-tuning.
Kode berikut memanfaatkan fungsi pembantu prepare_data untuk membuat data pelatihan dan validasi dalam format JSONL:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Terakhir, kita mengunggah kedua dataset ke akun pengembang OpenAI sebagai berikut:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Eksekusi kode sebelumnya yang berhasil akan menampilkan pengenal unik untuk data pelatihan dan validasi seperti di bawah.
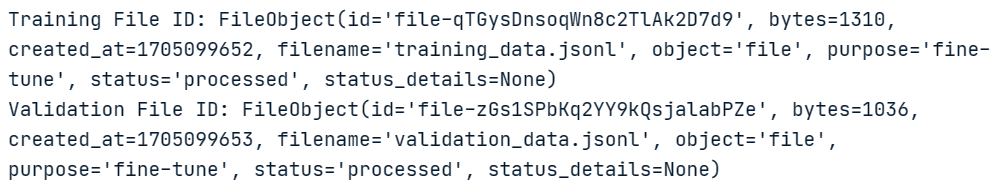
Pada tahap ini kita memiliki semua informasi untuk melanjutkan fine-tuning.
Membuat pekerjaan fine-tuning
Proses fine-tuning ini sangat terinspirasi oleh openai-cookbook yang melakukan fine-tuning di Microsoft Azure.
Untuk melakukan fine-tuning kita akan menggunakan dua langkah berikut: (1) mendefinisikan hiperparameter, dan (2) memicu fine-tuning.
Kita akan melakukan fine-tuning model davinci dan menjalankannya selama 15 epoch menggunakan ukuran batch 3 dan pengali laju pembelajaran 0,3 menggunakan dataset pelatihan dan validasi.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
Kode di atas menghasilkan informasi berikut untuk jobID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), respons pelatihan, dan status pelatihan (pending).
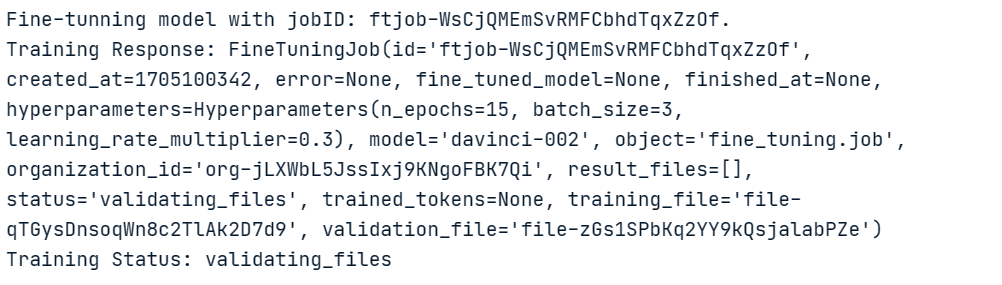
Status pending ini tidak memberikan informasi yang relevan. Namun, kita dapat memperoleh lebih banyak wawasan tentang proses pelatihan dengan menjalankan kode berikut:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
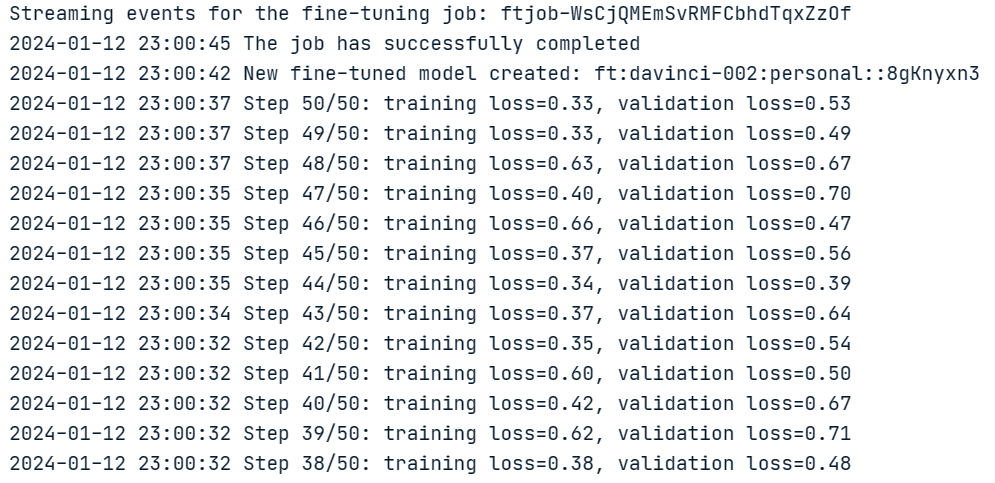
Semua epoch ditampilkan di bawah, bersama dengan status fine-tuning, yaitu succeeded.
Memeriksa status pekerjaan fine-tuning
Mari verifikasi bahwa operasi kita berhasil, dan selain itu, kita dapat meninjau semua operasi fine-tuning dengan menggunakan operasi daftar.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Hasil eksekusinya diberikan di bawah ini:
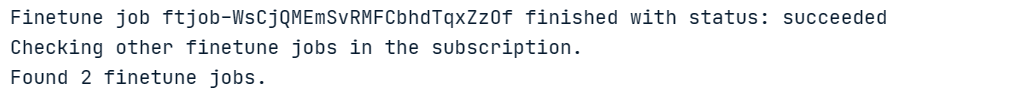
Terdapat total 2 pekerjaan fine-tune.
Validasi model
Terakhir, model yang di-fine-tune dapat diambil dari atribut “fine_tuned_model”. Pernyataan print berikut menunjukkan bahwa nama model final adalah: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Dengan model ini, kita dapat menjalankan kueri untuk memvalidasi hasilnya dengan memberikan prompt, nama model, dan membuat kueri dengan fungsi openai.Completion.create(). Hasilnya diambil dari kamus jawaban sebagai berikut:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Meskipun prompt tidak ditulis persis sama seperti pada dataset validasi, model tetap berhasil memetakannya ke jawaban yang benar. Jawaban untuk permintaan sebelumnya ditunjukkan di bawah.

Dengan sangat sedikit sampel pelatihan, kita berhasil memperoleh model fine-tune yang cukup baik. Hasil yang lebih baik dapat dicapai dengan ukuran pelatihan yang lebih besar.
Kesimpulan
Dalam artikel ini, kami telah mengeksplorasi potensi GPT-3, dan membahas proses fine-tuning model untuk meningkatkan kinerjanya pada kasus penggunaan tertentu. Kami telah menguraikan prasyarat untuk berhasil melakukan fine-tuning GPT-3, termasuk pemahaman dasar pemrograman Python dan keakraban dengan machine learning serta pemrosesan bahasa alami.
Selain itu, kami telah memperkenalkan paket Python openai, yang digunakan untuk menyederhanakan proses mengakses kapabilitas GPT-3 melalui API OpenAI. Artikel ini telah mencakup semua langkah yang terlibat dalam fine-tuning model GPT-3 menggunakan Python dan dataset kustom, mulai dari memperoleh kredensial API hingga menyiapkan data, melatih model, dan memvalidasinya.
Dengan menyoroti manfaat fine-tuning dan menyediakan panduan komprehensif atas prosesnya, artikel ini bertujuan membantu data scientist, pengembang, dan pemangku kepentingan lainnya dengan perangkat dan pengetahuan yang diperlukan untuk membuat model GPT-3 yang lebih akurat dan efisien, disesuaikan dengan kebutuhan dan persyaratan spesifik mereka.
Kami memiliki artikel yang membahas Apa itu GPT-4 dan Mengapa Penting? serta tutorial Pengantar Menggunakan Transformers dan Hugging Face. Pastikan untuk membacanya guna meningkatkan pengetahuan Anda ke tingkat berikutnya.




