GPT-3, il Generative Pre-trained Transformer di terza generazione, è un modello di deep learning all’avanguardia creato da OpenAI. Grazie all’uso di enormi quantità di dati dal web, GPT-3 può generare testi vari e solidi con input minimi. GPT-3 ha un’ampia gamma di applicazioni, tra cui sintesi di testi, traduzione, sviluppo di chatbot e generazione di contenuti.
Nonostante la sua robustezza, le prestazioni di GPT-3 possono essere ulteriormente migliorate con il fine-tuning su uno specifico caso d’uso.
Ma cosa intendiamo per fine-tuning?
È il processo di addestramento del GPT-3 pre-addestrato su un dataset personalizzato relativo a un caso d’uso. Questo consente al modello di adattarsi meglio alle sfumature di quello specifico dominio, ottenendo risultati più accurati.
I prerequisiti per eseguire con successo il fine-tuning sono: (1) una comprensione di base della programmazione in Python e (2) familiarità con il machine learning e l’elaborazione del linguaggio naturale.
Il nostro articolo Classification in Machine Learning: An Introduction ti aiuta a capire cos’è la classificazione nel machine learning, come viene utilizzata e include alcuni esempi di algoritmi di classificazione.
Useremo il pacchetto Python openai fornito da OpenAI per rendere più comodo l’utilizzo della loro API e accedere alle funzionalità di GPT-3.
Questo articolo illustra passo dopo passo il processo di fine-tuning del modello GPT-3 con Python sui tuoi dati, coprendo tutte le fasi: dal recupero delle credenziali API alla preparazione dei dati, l’addestramento del modello e la sua validazione.
Quali modelli GPT possono essere sottoposti a fine-tuning?
I modelli GPT che possono essere fine-tuned includono Ada, Babbage, Curie e Davinci. Questi modelli appartengono alla famiglia GPT-3. È inoltre importante notare che il fine-tuning non è attualmente disponibile per i modelli più recenti GPT-3.5-turbo o altri GPT-4.
Leggi la nostra guida per principianti a GPT-3 per maggiori informazioni sul modello.
Quali sono buoni casi d’uso per il fine-tuning di GPT?
Classificazione e generazione condizionale sono i due tipi di problemi che possono trarre beneficio dal fine-tuning di un modello linguistico come GPT-3. Vediamoli brevemente.
Classificazione
Per i problemi di classificazione, a ciascun input nel prompt viene assegnata una delle classi predefinite, e alcuni casi sono illustrati di seguito:
- Garantire affermazioni veritiere: se un’azienda vuole verificare che gli annunci sul proprio sito citino il prodotto e l’azienda corretti, si può fare il fine-tuning di un classificatore per filtrare gli annunci errati, assicurando che il modello non inventi informazioni.
- Analisi del sentiment: consiste nel classificare il testo in base al sentimento, ad esempio positivo, negativo o neutro.
- Smistamento delle email: per ordinare le email in arrivo in una delle molte categorie predefinite, è possibile convertire queste categorie in numeri, il che funziona bene fino a circa 500 categorie.
Generazione condizionale
I problemi in questa categoria riguardano la generazione di contenuti a partire da un input dato. Le applicazioni includono parafrasi, sintesi, estrazione di entità, redazione di descrizioni di prodotto, assistenti virtuali (chatbot) e altro. Esempi:
- Creare annunci coinvolgenti a partire da articoli di Wikipedia. In questo caso generativo, assicurati che i campioni forniti siano di alta qualità, perché il modello fine-tuned tenterà di imitare lo stile (e gli errori) degli esempi.
- Estrazione di entità. Questo compito è simile a un problema di trasformazione del linguaggio. Migliora le prestazioni ordinando le entità estratte in ordine alfabetico o nello stesso ordine in cui compaiono nel testo originale.
- Chatbot di assistenza clienti. Un chatbot in genere include contesto rilevante sulla conversazione (dettagli dell’ordine), un riepilogo della conversazione finora e i messaggi più recenti.
- Descrizione di prodotto basata su proprietà tecniche. Converti i dati di input in linguaggio naturale per ottenere prestazioni superiori in questo contesto.
Implementazione passo passo del fine-tuning di GPT-3
È necessario creare un account sviluppatore OpenAI per accedere alla chiave API; i passaggi sono riportati di seguito:
Per prima cosa, crea un account dal sito ufficiale di OpenAI.
Poi, seleziona l’icona del profilo utente in alto a destra e fai clic su “View API Keys” per accedere alla pagina da cui creare una nuova chiave API o usarne una esistente.

Crea una nuova chiave segreta dalla scheda “Create new secret key” fornendo un nome significativo (in questo caso GPT3_fine_tuning_key), dopodiché la chiave API verrà generata automaticamente.


Se rimani bloccato o incontri difficoltà, dai un’occhiata al DataLab workbook con tutto il codice.
Dataset
In questo caso d’uso, effettueremo il fine-tuning del modello GPT-3 per uno scenario di domanda-risposta, composto da uno schema strutturato di Q&A pensato per aiutare il modello a capire il compito da svolgere. Per ogni coppia di domanda e risposta, viene mantenuto un formato coerente in tutti i dati di training e di test.
Un’istanza del dataset di domanda-risposta ha il seguente formato:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- “prompt” è il testo di input letto ed elaborato dal modello. Il separatore principale è la freccia (->) per delimitare il prompt dalla risposta attesa.
- “completion” è la risposta attesa al prompt. Il carattere barra rovesciata “\n” è usato come sequenza di stop per indicare la fine della risposta.
Capito il formato del dataset, possiamo generare sia il dataset di training sia quello di validazione, come mostrato sotto. Questi prompt e queste completion sono stati generati con ChatGPT.
La nostra ChatGPT Cheat Sheet per Data Science offre oltre 60 prompt per attività di Data Science.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Setup
Prima di entrare nell’implementazione, dobbiamo preparare l’ambiente di lavoro installando le librerie necessarie, in particolare la libreria Python di OpenAI, come mostrato di seguito:
pip install --upgrade openaiOra possiamo importare la libreria.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Preparare il dataset
Gestire i dati in formato lista, come mostrato sopra, può essere comodo per dataset piccoli. Tuttavia, salvare i dati in formato JSONL (JSON Lines) ha diversi vantaggi: scalabilità, interoperabilità, semplicità e compatibilità con l’API di OpenAI, che richiede dati in formato JSONL per creare job di fine-tuning.
Il seguente codice utilizza la funzione di supporto prepare_data per creare sia i dati di training sia quelli di validazione in formato JSONL:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Infine, carichiamo i due dataset sull’account sviluppatore OpenAI come segue:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
L’esecuzione corretta del codice precedente mostra di seguito l’identificatore univoco dei dati di training e di validazione.
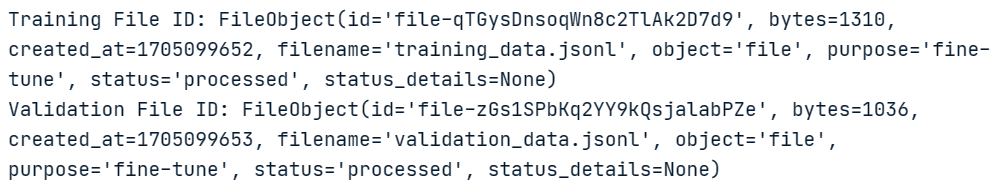
A questo punto abbiamo tutte le informazioni per procedere con il fine-tuning.
Creare un job di fine-tuning
Questo processo di fine-tuning è fortemente ispirato all’openai-cookbook che esegue il fine-tuning su Microsoft Azure.
Per effettuare il fine-tuning useremo due passaggi: (1) definire gli iperparametri e (2) avviare il fine-tuning.
Effettueremo il fine-tuning del modello davinci per 15 epoche utilizzando una batch size di 3 e un learning rate multiplier di 0,3, servendoci dei dataset di training e validazione.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
Il codice sopra genera le seguenti informazioni: l’ID del job (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), la risposta dell’addestramento e lo stato dell’addestramento (pending).
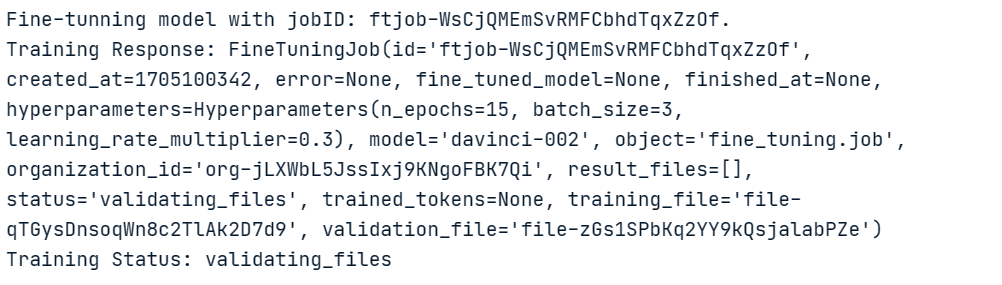
Questo stato pending non fornisce informazioni rilevanti. Possiamo però ottenere maggiori dettagli sul processo di training eseguendo il seguente codice:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
Di seguito vengono mostrate tutte le epoche insieme allo stato del fine-tuning, che risulta succeeded.
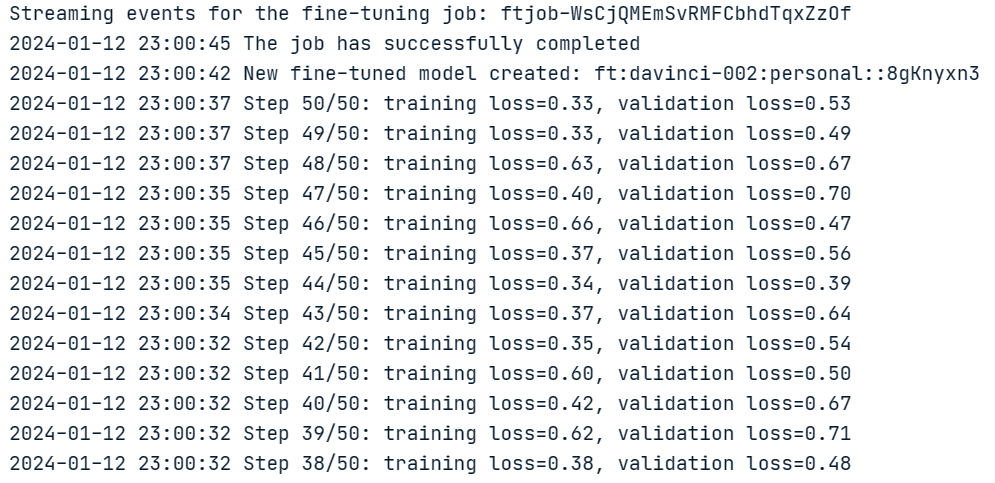
Verificare lo stato del job di fine-tuning
Verifichiamo che l’operazione sia andata a buon fine; inoltre, possiamo esaminare tutte le operazioni di fine-tuning usando un’operazione di listing.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Il risultato dell’esecuzione è riportato di seguito:
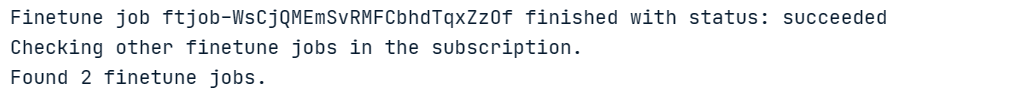
In totale ci sono 2 job di fine-tuning.
Validazione del modello
Infine, il modello fine-tuned può essere recuperato dall’attributo “fine_tuned_model”. La seguente istruzione di stampa mostra che il nome del modello finale è: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Con questo modello possiamo eseguire query per validarne i risultati fornendo un prompt, il nome del modello e creando una richiesta con la funzione openai.Completion.create(). Il risultato viene recuperato dal dizionario della risposta come segue:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Anche se i prompt non sono scritti esattamente come nel dataset di validazione, il modello è comunque riuscito a ricondurli alle risposte corrette. Le risposte alle richieste precedenti sono mostrate di seguito.

Con pochissimi esempi di training, siamo riusciti a ottenere un modello fine-tuned discreto. Si possono ottenere risultati migliori con un training set più ampio.
Conclusione
In questo articolo abbiamo esplorato il potenziale di GPT-3 e discusso il processo di fine-tuning del modello per migliorarne le prestazioni in casi d’uso specifici. Abbiamo delineato i prerequisiti per eseguire con successo il fine-tuning di GPT-3, tra cui una conoscenza di base della programmazione in Python e familiarità con il machine learning e l’elaborazione del linguaggio naturale.
Inoltre, abbiamo introdotto il pacchetto Python openai, utilizzato per semplificare l’accesso alle funzionalità di GPT-3 tramite l’API di OpenAI. L’articolo ha coperto tutti i passaggi coinvolti nel fine-tuning del modello GPT-3 con Python e dataset personalizzati, dall’ottenimento delle credenziali API alla preparazione dei dati, l’addestramento del modello e la sua validazione.
Evidenziando i vantaggi del fine-tuning e fornendo una guida completa al processo, questo articolo mira ad aiutare data scientist, sviluppatori e altri stakeholder a disporre degli strumenti e delle conoscenze necessari per creare modelli GPT-3 più accurati ed efficienti, su misura per le loro esigenze specifiche.
Abbiamo un articolo su Che cos’è GPT-4 e perché è importante? e anche il tutorial Introduzione all’uso dei Transformer e di Hugging Face. Assicurati di leggerli per portare le tue conoscenze al livello successivo.




