GPT-3, o Generative Pre-trained Transformer de terceira geração, é um modelo de deep learning de rede neural de última geração criado pela OpenAI. Usando grandes volumes de dados da internet, o GPT-3 consegue gerar textos diversos e robustos a partir de entradas mínimas. O GPT-3 tem uma ampla gama de aplicações, que incluem (entre outras) sumarização, tradução, criação de chatbots e geração de conteúdo.
Apesar de sua robustez, o desempenho do GPT-3 pode ser ainda melhor ao aplicar fine-tuning para um caso de uso específico.
Mas o que significa fine-tuning?
É o processo de treinar o GPT-3 pré-treinado em um conjunto de dados personalizado para um caso de uso. Isso permite que o modelo se adapte melhor às nuances daquele domínio ou tarefa, gerando resultados mais precisos.
Os pré-requisitos para realizar o fine-tuning com sucesso são: (1) entendimento básico de programação em Python e (2) familiaridade com machine learning e processamento de linguagem natural.
Nosso artigo Classificação em machine learning: uma introdução ajuda você a entender o que é classificação, como é utilizada e apresenta exemplos de algoritmos.
Vamos usar o pacote openai para Python, fornecido pela OpenAI, para facilitar o uso da API e acessar os recursos do GPT-3.
Este artigo percorre o processo de fine-tuning do modelo GPT-3 em Python com seus próprios dados, cobrindo todas as etapas: da obtenção das credenciais da API à preparação dos dados, treinamento do modelo e validação.
Quais modelos GPT podem receber fine-tuning?
Os modelos GPT que podem ser ajustados por fine-tuning incluem Ada, Babbage, Curie e Davinci. Esses modelos pertencem à família GPT-3. Vale destacar que, no momento, o fine-tuning não está disponível para os modelos mais recentes GPT-3.5-turbo nem para o GPT-4.
Leia nosso guia para iniciantes em GPT-3 para saber mais sobre o modelo.
Quais são bons casos de uso para fazer fine-tuning no GPT?
Classificação e geração condicional são dois tipos de problemas que se beneficiam do fine-tuning em um modelo de linguagem como o GPT-3. Vamos ver rapidamente cada um.
Classificação
Em problemas de classificação, cada entrada no prompt é associada a uma das classes pré-definidas. Alguns exemplos:
- Garantir veracidade de afirmações: se uma empresa quer checar se anúncios no site mencionam o produto e a marca corretos, é possível ajustar um classificador para filtrar anúncios incorretos, evitando que o modelo "invente" informações.
- Análise de sentimento: classificar textos por sentimento, como positivo, negativo ou neutro.
- Triagem de e-mails por categoria: para classificar e-mails recebidos em muitas categorias pré-definidas, essas categorias podem ser convertidas em números, funcionando bem até cerca de 500 categorias.
Geração condicional
Aqui o objetivo é gerar conteúdo com base em uma entrada. As aplicações incluem paráfrase, sumarização, extração de entidades, redação de descrição de produtos, assistentes virtuais (chatbots) e mais. Exemplos:
- Criar anúncios envolventes a partir de artigos da Wikipedia. Neste caso gerativo, garanta que os exemplos fornecidos sejam de alta qualidade, pois o modelo ajustado vai imitar o estilo (e até os erros) desses exemplos.
- Extração de entidades. Essa tarefa é semelhante a uma transformação de linguagem. Melhore o desempenho ordenando as entidades extraídas em ordem alfabética ou na mesma ordem em que aparecem no texto original.
- Chatbot de suporte ao cliente. Normalmente inclui contexto relevante sobre a conversa (detalhes do pedido), um resumo do que já foi discutido e as mensagens mais recentes.
- Descrição de produto com base em propriedades técnicas. Converta os dados de entrada em linguagem natural para obter desempenho superior.
Implementação passo a passo do fine-tuning no GPT-3
É obrigatório criar uma conta de desenvolvedor na OpenAI para acessar a chave de API. Veja os passos abaixo:
Primeiro, crie uma conta no site oficial da OpenAI.
Depois, clique no ícone do perfil no canto superior direito e selecione “View API Keys” para acessar a página onde você pode criar uma nova chave de API ou reutilizar uma existente.

Crie uma nova chave secreta em “Create new secret key”, dando um nome significativo (neste caso, GPT3_fine_tuning_key). A chave será gerada automaticamente.


Se você ficar travado ou tiver dificuldades, confira o workbook no DataLab com todo o código.
Conjunto de dados
Neste caso de uso, vamos ajustar o GPT-3 para um cenário de perguntas e respostas, com um padrão estruturado de Q&A para ajudar o modelo a entender a tarefa a ser executada. Mantemos um formato consistente para cada par de pergunta e resposta em todo o conjunto de treinamento e teste.
Um exemplo no dataset de perguntas e respostas tem o seguinte formato:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- “prompt” é o texto de entrada lido e processado pelo modelo. O principal separador é a seta (->) para delimitar o prompt da resposta esperada.
- “completion” é a resposta esperada para o prompt. Um “\n” (quebra de linha) é usado como sequência de parada para indicar o fim da resposta.
Entendido o formato, podemos gerar os conjuntos de treinamento e validação, como mostrado abaixo. Esses prompts e respostas foram gerados com o ChatGPT.
Nosso Guia rápido do ChatGPT para Data Science traz mais de 60 prompts para tarefas de ciência de dados.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Configuração
Antes de partir para a implementação, precisamos preparar o ambiente instalando as bibliotecas necessárias, especialmente a biblioteca OpenAI para Python, como abaixo:
pip install --upgrade openaiAgora podemos importar a biblioteca.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Preparar o dataset
Trabalhar com listas, como mostrado acima, pode ser prático para conjuntos pequenos. Porém, salvar os dados em JSONL (JSON Lines) traz várias vantagens: escalabilidade, interoperabilidade, simplicidade e compatibilidade com a API da OpenAI, que exige JSONL para criar jobs de fine-tuning.
O código a seguir usa a função auxiliar prepare_data para criar os arquivos de treinamento e validação em JSONL:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Por fim, fazemos o upload dos dois datasets para a conta de desenvolvedor da OpenAI assim:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Se o código anterior rodar com sucesso, serão exibidos os identificadores únicos dos arquivos de treinamento e validação.
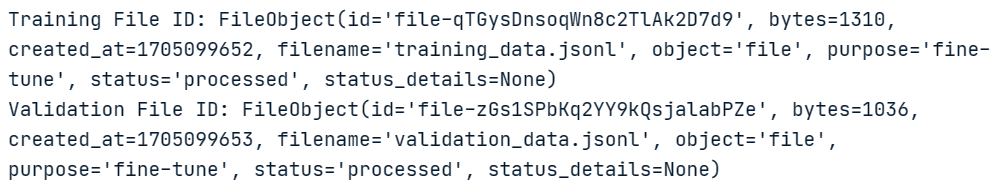
Com isso, já temos o necessário para avançar para o fine-tuning.
Criar um job de fine-tuning
Este fluxo de fine-tuning foi fortemente inspirado no openai-cookbook que realiza fine-tuning no Microsoft Azure.
Para realizar o fine-tuning, seguiremos dois passos: (1) definir hiperparâmetros e (2) iniciar o fine-tuning.
Vamos ajustar o modelo davinci por 15 épocas, com batch size de 3 e learning rate multiplier de 0,3, usando os datasets de treinamento e validação.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
O código acima gera informações como o jobID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), a resposta do treinamento e o status do treinamento (pending).
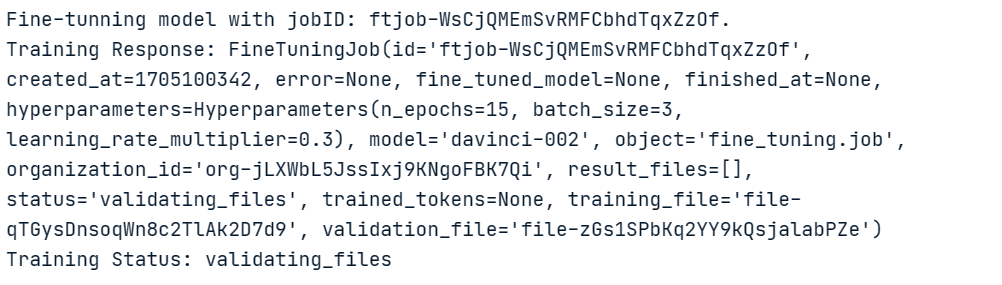
O status pending não traz muitos detalhes. Para mais visibilidade do processo de treinamento, execute o código a seguir:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
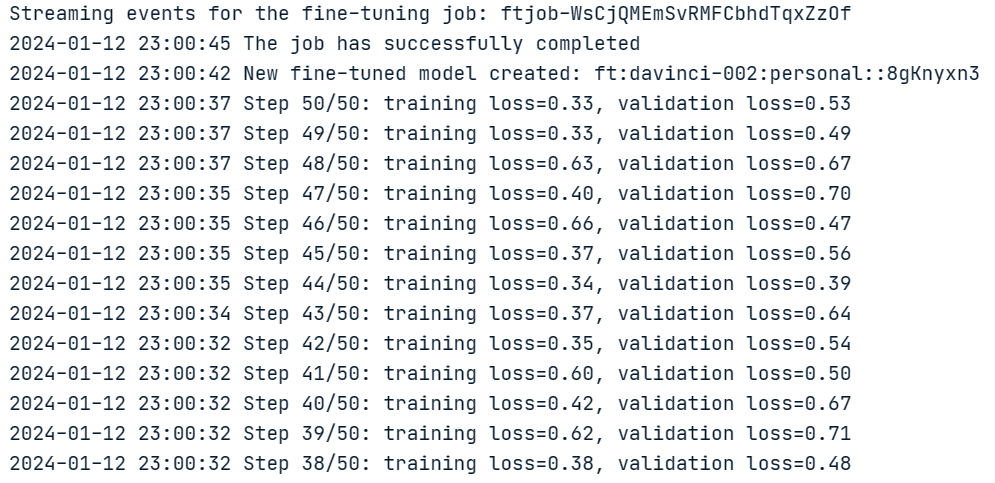
Abaixo, são exibidas todas as épocas, junto com o status do fine-tuning, que aparece como succeeded.
Checar o status do job de fine-tuning
Vamos verificar se tudo correu bem e, além disso, inspecionar todas as operações de fine-tuning com uma listagem.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
O resultado da execução é mostrado abaixo:
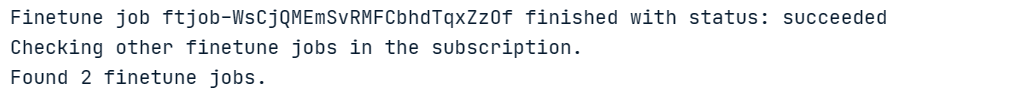
Há um total de 2 jobs de fine-tuning.
Validação do modelo
Por fim, o modelo ajustado pode ser obtido no atributo “fine_tuned_model”. A instrução abaixo mostra que o nome do modelo final é: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Com esse modelo, podemos executar consultas para validar os resultados, fornecendo um prompt, o nome do modelo e criando a consulta com a função openai.Completion.create(). O resultado é obtido do dicionário de resposta assim:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Mesmo que os prompts não estejam escritos exatamente como no dataset de validação, o modelo conseguiu mapeá-los para as respostas corretas. As respostas para as solicitações anteriores estão abaixo.

Com pouquíssimos exemplos de treinamento, conseguimos um modelo ajustado com desempenho razoável. Com um conjunto maior, os resultados tendem a melhorar.
Conclusão
Neste artigo, exploramos o potencial do GPT-3 e mostramos como fazer fine-tuning para melhorar o desempenho do modelo em casos de uso específicos. Apresentamos os pré-requisitos para ajustar o GPT-3 com sucesso, incluindo conhecimentos básicos de Python e familiaridade com machine learning e processamento de linguagem natural.
Também apresentamos o pacote openai para Python, usado para simplificar o acesso aos recursos do GPT-3 via API da OpenAI. O artigo cobriu todas as etapas do processo de fine-tuning do GPT-3 com Python e datasets personalizados: da obtenção das credenciais à preparação dos dados, treinamento do modelo e validação.
Ao destacar os benefícios do fine-tuning e oferecer um guia completo do processo, este conteúdo busca ajudar cientistas de dados, desenvolvedores e outras pessoas da área a criar modelos GPT-3 mais precisos e eficientes, sob medida para suas necessidades.
Temos um artigo sobre o que é o GPT-4 e por que ele importa e também um tutorial de introdução ao uso de Transformers e Hugging Face. Vale a pena conferir para levar seu conhecimento ao próximo nível.
Curso de Introdução ao ChatGPT
Comece a usar o ChatGPT