GPT-3, der Generative Pre-trained Transformer der dritten Generation, ist ein hochmodernes Deep-Learning-Modell von OpenAI. Mit Hilfe riesiger Mengen an Internetdaten kann GPT-3 mit minimalem Input vielfältige und robuste, maschinell generierte Texte erzeugen. GPT-3 deckt zahlreiche Anwendungsfälle ab, darunter Textzusammenfassung, Übersetzung, Chatbot-Entwicklung und Content-Erstellung.
Trotz seiner Stärke lässt sich die Leistung von GPT-3 durch Fine-Tuning auf einen spezifischen Anwendungsfall weiter steigern.
Aber was genau bedeutet Fine-Tuning?
Dabei wird das vortrainierte GPT-3 auf einem maßgeschneiderten Datensatz zu deinem Use Case weitertrainiert. So passt sich das Modell besser an die Besonderheiten dieses Anwendungsfalls oder Fachgebiets an und liefert präzisere Ergebnisse.
Voraussetzungen für erfolgreiches Fine-Tuning sind (1) grundlegende Python-Kenntnisse und (2) Vertrautheit mit Machine Learning und Natural Language Processing.
Unser Artikel Classification in Machine Learning: An Introduction hilft dir, Klassifikation im Machine Learning zu verstehen: was sie ist, wofür sie genutzt wird und Beispiele für Klassifikationsalgorithmen.
Wir verwenden das openai Python-Paket von OpenAI, um deren API komfortabel zu nutzen und auf die Fähigkeiten von GPT-3 zuzugreifen.
Dieser Artikel führt dich Schritt für Schritt durch das Fine-Tuning von GPT-3 mit Python auf deinen eigenen Daten – von API-Zugang über Datenaufbereitung und Training bis zur Validierung.
Welche GPT-Modelle lassen sich feinabstimmen?
Feinabstimmbar sind die GPT-Modelle Ada, Babbage, Curie und Davinci. Diese Modelle gehören zur GPT-3-Familie. Außerdem ist wichtig: Fine-Tuning ist derzeit nicht für neuere GPT-3.5-turbo-Modelle oder andere GPT-4-Modelle verfügbar.
Lies unseren Einsteigerleitfaden zu GPT-3 für weitere Informationen zum Modell.
Welche Use Cases eignen sich gut für das Fine-Tuning von GPT?
Klassifikation und bedingte Textgenerierung sind zwei Problemtypen, die besonders von Fine-Tuning eines Sprachmodells wie GPT-3 profitieren. Schauen wir uns beide kurz an.
Klassifikation
Bei Klassifikationsproblemen wird jedem Eingabetext im Prompt eine vordefinierte Klasse zugewiesen. Beispiele sind:
- Wahrheitsgehalt sicherstellen: Möchte ein Unternehmen prüfen, ob Anzeigen auf der Website das richtige Produkt und die richtige Firma nennen, kann ein Klassifikator feinabgestimmt werden, um falsche Anzeigen auszufiltern – so wird Halluzinationen vorgebeugt.
- Sentiment-Analyse: Texte werden nach Stimmung eingeordnet, etwa positiv, negativ oder neutral.
- E-Mail-Triage und Kategorisierung: Eingehende E-Mails in viele vordefinierte Kategorien sortieren, indem man diese Kategorien in Zahlen abbildet; das funktioniert gut bis etwa 500 Kategorien.
Bedingte Textgenerierung
Hier geht es darum, Inhalte auf Basis einer Vorgabe zu erzeugen. Anwendungen sind Paraphrasierung, Zusammenfassung, Entitätsextraktion, Produktbeschreibungen, virtuelle Assistenten (Chatbots) und mehr. Beispiele:
- Aus Wikipedia-Artikeln ansprechende Anzeigen erstellen. In diesem generativen Use Case sollten die Beispiele hochwertig sein, da das feinabgestimmte Modell Stil und Fehler der Beispiele nachahmt.
- Entitätsextraktion. Diese Aufgabe ähnelt einer Sprachtransformation. Die Leistung steigt, wenn extrahierte Entitäten alphabetisch oder in der Originalreihenfolge sortiert werden.
- Kundenservice-Chatbot. Ein Chatbot enthält in der Regel relevanten Kontext zur Unterhaltung (Bestelldetails), eine Zusammenfassung des bisherigen Gesprächs und die jüngsten Nachrichten.
- Produktbeschreibung auf Basis technischer Eigenschaften. Wandle Eingabedaten in natürliche Sprache um, um hier die beste Performance zu erzielen.
Schritt-für-Schritt-Implementierung des Fine-Tunings für GPT-3
Ein OpenAI-Developer-Account ist Pflicht, um den API-Schlüssel zu erhalten. So gehst du vor:
Lege zuerst ein Konto auf der offiziellen OpenAI-Website an.
Klicke dann oben rechts auf das Profil-Icon und wähle „View API Keys“, um eine neue API-Key-Seite zu öffnen oder einen bestehenden Schlüssel zu verwenden.

Erstelle unter „Create new secret key“ einen neuen geheimen Schlüssel, gib ihm einen aussagekräftigen Namen (hier GPT3_fine_tuning_key) – der API-Schlüssel wird anschließend automatisch generiert.


Wenn du festhängst oder Schwierigkeiten hast, schau dir unbedingt das DataLab-Workbook mit dem kompletten Code an.
Datensatz
In diesem Beispiel stimmen wir GPT-3 für ein Frage-Antwort-Szenario ab. Es besteht aus einem strukturierten Frage-Antwort-Muster, damit das Modell die Aufgabe klar erkennt. Für alle Fragen-Antwort-Paare im Trainings- und Testdatensatz wird ein einheitliches Format verwendet.
Ein Eintrag im Frage-Antwort-Datensatz hat folgendes Format:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- „prompt“ ist der Eingabetext, den das Modell liest und verarbeitet. Der Haupttrenner ist der Pfeil (->), um Prompt und erwartete Antwort zu trennen.
- „completion“ ist die erwartete Antwort auf den Prompt. Ein Backslash „\n“ dient als Stoppsequenz und markiert das Ende der Antwort.
Mit diesem Format können wir wie unten gezeigt Trainings- und Validierungsdaten erzeugen. Diese Prompts und Completions wurden mit ChatGPT generiert.
Unser ChatGPT-Cheatsheet für Data Science bietet über 60 Prompts für Data-Science-Aufgaben.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Setup
Bevor wir in die Implementierung einsteigen, richten wir die Arbeitsumgebung ein und installieren die nötigen Bibliotheken, insbesondere die OpenAI-Python-Bibliothek:
pip install --upgrade openaiJetzt können wir die Bibliothek importieren.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Datensatz vorbereiten
Eine Listenstruktur wie oben ist für kleine Datensätze bequem. Es lohnt sich jedoch, die Daten im JSONL-Format (JSON Lines) zu speichern. Vorteile sind Skalierbarkeit, Interoperabilität, Einfachheit und die Kompatibilität mit der OpenAI API, die beim Erstellen von Fine-Tuning-Jobs JSONL erwartet.
Der folgende Code nutzt die Helper-Funktion prepare_data, um Trainings- und Validierungsdaten im JSONL-Format zu erstellen:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Zum Schluss laden wir beide Datensätze in den OpenAI-Developer-Account hoch:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Bei erfolgreicher Ausführung werden unten die eindeutigen Kennungen für Trainings- und Validierungsdaten angezeigt.
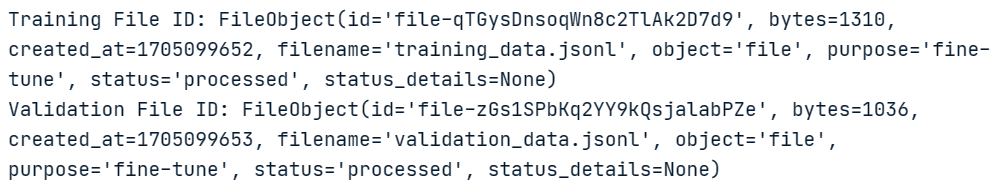
Damit haben wir alle Informationen, um mit dem Fine-Tuning fortzufahren.
Einen Fine-Tuning-Job erstellen
Dieser Fine-Tuning-Prozess ist stark vom openai-cookbook inspiriert, das Fine-Tuning auf Microsoft Azure durchführt.
Für das Fine-Tuning nutzen wir zwei Schritte: (1) Hyperparameter definieren und (2) das Fine-Tuning starten.
Wir stimmen das davinci-Modell ab und lassen 15 Epochen laufen, mit einer Batchgröße von 3 und einem Learning-Rate-Multiplikator von 0,3 – basierend auf den Trainings- und Validierungsdatensätzen.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
Der obige Code liefert Informationen zur Job-ID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), zur Trainingsantwort und zum Trainingsstatus (pending).
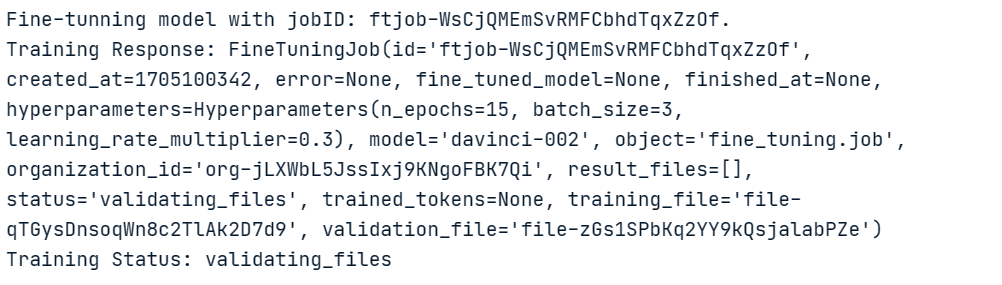
Der Status „pending“ ist zunächst wenig aussagekräftig. Mehr Einblick in den Trainingsprozess erhältst du mit folgendem Code:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


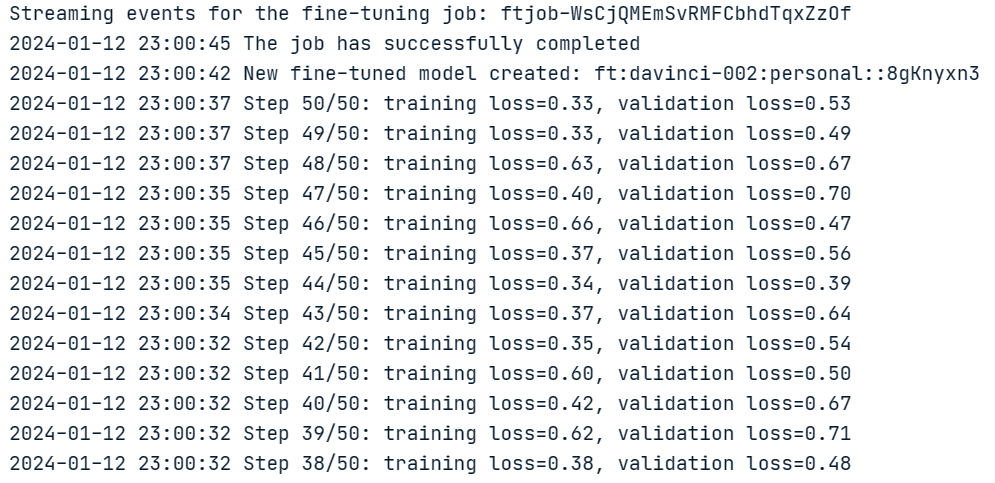
print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
Alle Epochen werden unten aufgeführt, zusammen mit dem Fine-Tuning-Status „succeeded“.
Status des Fine-Tuning-Jobs prüfen
Lass uns prüfen, ob der Vorgang erfolgreich war. Zusätzlich können wir alle Fine-Tuning-Aktivitäten per Listenabfrage einsehen.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Das Ergebnis der Ausführung siehst du unten:
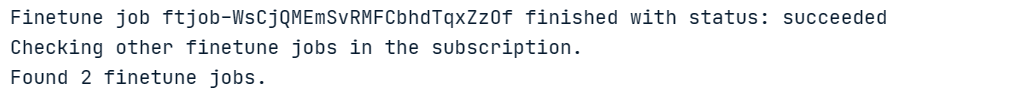
Insgesamt gibt es 2 Fine-Tuning-Jobs.
Validierung des Modells
Abschließend lässt sich das feinabgestimmte Modell über das Attribut „fine_tuned_model“ abrufen. Die folgende Ausgabe zeigt, dass der endgültige Modellname lautet: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Mit diesem Modell können wir Anfragen zur Validierung stellen, indem wir einen Prompt und den Modellnamen übergeben und eine Abfrage mit der Funktion openai.Completion.create() erstellen. Das Ergebnis holen wir wie folgt aus dem Antwortobjekt:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Auch wenn die Prompts nicht exakt wie im Validierungsdatensatz formuliert sind, konnte das Modell die richtigen Antworten zuordnen. Die Ergebnisse der obigen Anfragen siehst du hier:

Schon mit sehr wenigen Trainingsbeispielen haben wir ein ordentliches feinabgestimmtes Modell erhalten. Mit größeren Trainingsmengen lassen sich noch bessere Resultate erzielen.
Fazit
In diesem Artikel haben wir das Potenzial von GPT-3 beleuchtet und gezeigt, wie sich das Modell per Fine-Tuning für spezifische Anwendungsfälle optimieren lässt. Wir haben die Voraussetzungen für erfolgreiches Fine-Tuning skizziert, darunter grundlegendes Python-Wissen sowie Erfahrung mit Machine Learning und Natural Language Processing.
Außerdem haben wir das openai Python-Paket vorgestellt, das den Zugriff auf die Fähigkeiten von GPT-3 über die OpenAI-API vereinfacht. Der Artikel deckt alle Schritte für das Fine-Tuning von GPT-3 mit Python und eigenen Datensätzen ab – vom Beschaffen der API-Zugangsdaten über die Datenaufbereitung und das Training bis hin zur Validierung.
Mit dem Fokus auf die Vorteile des Fine-Tunings und einer praxisnahen Anleitung möchte dieser Artikel Data Scientists, Entwicklerinnen und Entwickler sowie weitere Stakeholder dabei unterstützen, genauere und effizientere GPT-3-Modelle zu erstellen – passgenau für ihre Anforderungen.
Wir haben außerdem Artikel zu Was ist GPT-4 und warum ist es wichtig? und das Tutorial An Introduction to Using Transformers and Hugging Face. Lies sie, um dein Wissen auf das nächste Level zu heben.
Einführung in den ChatGPT-Kurs
Beginne mit ChatGPT