GPT-3, thế hệ thứ ba của Generative Pre-trained Transformer, là một mô hình học sâu mạng nơ-ron tiên tiến do OpenAI tạo ra. Bằng cách sử dụng lượng lớn dữ liệu trên internet, GPT-3 có thể tạo ra văn bản do máy sinh ra đa dạng và mạnh mẽ chỉ từ đầu vào tối thiểu. GPT-3 có phạm vi ứng dụng phong phú, không chỉ giới hạn ở tóm tắt văn bản, dịch thuật, phát triển chatbot và tạo nội dung.
Mặc dù mạnh mẽ, hiệu năng của GPT-3 vẫn có thể được cải thiện hơn nữa bằng cách tinh chỉnh cho một trường hợp sử dụng cụ thể.
Vậy “tinh chỉnh” nghĩa là gì?
Đó là quá trình huấn luyện GPT-3 đã được tiền huấn luyện trên một tập dữ liệu dành riêng cho trường hợp sử dụng của bạn. Cách này giúp mô hình thích nghi tốt hơn với các sắc thái của lĩnh vực hay bài toán cụ thể, từ đó cho kết quả chính xác hơn.
Điều kiện tiên quyết để tinh chỉnh thành công gồm (1) hiểu biết cơ bản về lập trình Python và (2) quen thuộc với máy học và xử lý ngôn ngữ tự nhiên.
Bài viết Phân loại trong Máy học: Giới thiệu của chúng tôi giúp bạn tìm hiểu về phân loại trong máy học: khái niệm, cách ứng dụng và một số thuật toán tiêu biểu.
Chúng ta sẽ dùng gói Python openai do OpenAI cung cấp để thuận tiện gọi API và truy cập các khả năng của GPT-3.
Bài viết này sẽ hướng dẫn từng bước quy trình tinh chỉnh mô hình GPT-3 bằng Python trên dữ liệu của chính bạn, bao gồm toàn bộ các bước từ lấy thông tin xác thực API đến chuẩn bị dữ liệu, huấn luyện và kiểm định mô hình.
Những mô hình GPT nào có thể tinh chỉnh?
Các mô hình GPT có thể tinh chỉnh gồm Ada, Babbage, Curie và Davinci. Đây là các mô hình thuộc họ GPT-3. Cũng lưu ý rằng hiện tại tinh chỉnh chưa khả dụng cho các mô hình GPT-3.5-turbo mới hơn hoặc các mô hình GPT-4 khác.
Đọc hướng dẫn cho người mới bắt đầu về GPT-3 để biết thêm thông tin về mô hình.
Những trường hợp sử dụng phù hợp để tinh chỉnh GPT?
Phân loại và sinh có điều kiện là hai nhóm bài toán có thể hưởng lợi từ việc tinh chỉnh một mô hình ngôn ngữ như GPT-3. Hãy điểm qua ngắn gọn từng nhóm.
Phân loại
Với các bài toán phân loại, mỗi đầu vào trong lời nhắc sẽ được gán vào một trong các lớp được xác định trước. Một vài trường hợp điển hình:
- Đảm bảo tính xác thực của phát biểu: Nếu một công ty muốn xác minh rằng quảng cáo trên website nêu đúng sản phẩm và công ty, có thể tinh chỉnh một bộ phân loại để lọc quảng cáo sai, bảo đảm mô hình không bịa đặt.
- Phân tích cảm xúc: Phân loại văn bản theo cảm xúc như tích cực, tiêu cực hoặc trung tính.
- Phân loại ưu tiên email: Để sắp xếp email đến vào nhiều danh mục xác định trước, có thể chuyển các danh mục đó thành số; cách này hoạt động tốt cho đến khoảng 500 danh mục.
Sinh có điều kiện
Nhóm này liên quan đến việc tạo nội dung dựa trên đầu vào cho trước. Ứng dụng gồm diễn đạt lại, tóm tắt, trích xuất thực thể, viết mô tả sản phẩm, trợ lý ảo (chatbot), và hơn thế nữa. Ví dụ:
- Tạo quảng cáo hấp dẫn từ các bài Wikipedia. Với bài toán sinh, hãy đảm bảo mẫu cung cấp có chất lượng cao, vì mô hình tinh chỉnh sẽ cố gắng bắt chước phong cách (và cả lỗi) của ví dụ.
- Trích xuất thực thể. Nhiệm vụ này tương tự một bài toán chuyển đổi ngôn ngữ. Cải thiện hiệu năng bằng cách sắp xếp các thực thể được trích xuất theo thứ tự bảng chữ cái hoặc theo đúng thứ tự xuất hiện trong văn bản gốc.
- Chatbot hỗ trợ khách hàng. Một chatbot thường bao gồm ngữ cảnh liên quan đến cuộc hội thoại (chi tiết đơn hàng), tóm tắt cuộc trò chuyện cho đến thời điểm hiện tại, và các tin nhắn gần nhất.
- Mô tả sản phẩm dựa trên thuộc tính kỹ thuật. Chuyển đổi dữ liệu đầu vào sang ngôn ngữ tự nhiên để đạt hiệu quả vượt trội trong bối cảnh này.
Triển khai tinh chỉnh GPT-3 theo từng bước
Bạn cần tạo tài khoản nhà phát triển OpenAI để lấy khóa API; các bước như sau:
Trước hết, tạo tài khoản từ trang web chính thức của OpenAI.
Sau đó, chọn biểu tượng hồ sơ người dùng ở góc trên bên phải và nhấp “View API Keys” để vào trang tạo khóa API mới hoặc dùng khóa hiện có.

Tạo khóa bí mật mới từ thẻ “Create new secret key” bằng cách đặt một tên có ý nghĩa (trong ví dụ này là GPT3_fine_tuning_key), sau đó khóa API sẽ được tạo tự động.


Nếu bạn gặp khó khăn, hãy xem sổ tay DataLab chứa toàn bộ mã.
Tập dữ liệu
Trong trường hợp này, chúng ta sẽ tinh chỉnh GPT-3 cho bài toán hỏi đáp, gồm một mẫu cấu trúc hỏi–đáp được thiết kế để giúp mô hình hiểu nhiệm vụ cần thực hiện. Một định dạng nhất quán được duy trì cho mỗi cặp hỏi–đáp trên toàn bộ dữ liệu huấn luyện và kiểm định.
Một bản ghi trong tập dữ liệu hỏi–đáp có định dạng sau:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- “prompt” là văn bản đầu vào mà mô hình đọc và xử lý. Dấu mũi tên (->) là bộ phân tách chính, dùng để tách phần prompt khỏi phản hồi kỳ vọng.
- “completion” là phản hồi mong đợi cho prompt. Ký tự “\n” được dùng làm chuỗi dừng để chỉ ra kết thúc câu trả lời.
Với hiểu biết về định dạng này, chúng ta có thể tạo cả tập dữ liệu huấn luyện và kiểm định như dưới đây. Các prompt và completion này được tạo bằng ChatGPT.
Tài liệu ChatGPT Cheat Sheet cho Khoa học Dữ liệu cung cấp hơn 60 prompt phục vụ các tác vụ Data Science.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Thiết lập
Trước khi bắt tay vào triển khai, chúng ta cần chuẩn bị môi trường làm việc bằng cách cài các thư viện cần thiết, đặc biệt là thư viện OpenAI cho Python như sau:
pip install --upgrade openaiGiờ chúng ta có thể import thư viện.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Chuẩn bị tập dữ liệu
Làm việc với định dạng danh sách như trên có thể tiện cho các tập dữ liệu nhỏ. Tuy nhiên, lưu dữ liệu ở định dạng JSONL (JSON Lines) có nhiều lợi ích như khả năng mở rộng, khả năng tương tác, sự đơn giản và tương thích với OpenAI API, vốn yêu cầu dữ liệu JSONL khi tạo tác vụ tinh chỉnh.
Đoạn mã sau sử dụng hàm hỗ trợ prepare_data để tạo dữ liệu huấn luyện và kiểm định ở định dạng JSONL:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Cuối cùng, chúng ta tải hai tập dữ liệu lên tài khoản nhà phát triển OpenAI như sau:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Thực thi thành công đoạn mã trên sẽ hiển thị định danh duy nhất của dữ liệu huấn luyện và kiểm định như dưới đây.
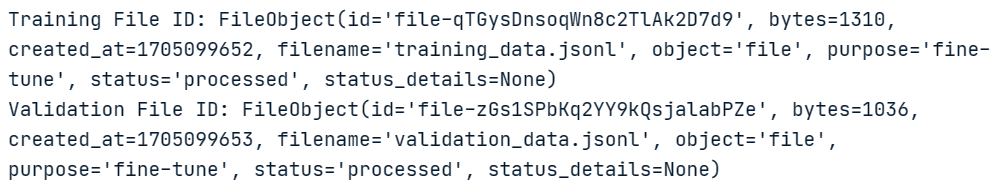
Đến thời điểm này, chúng ta đã có đủ thông tin để bắt đầu tinh chỉnh.
Tạo tác vụ tinh chỉnh
Quy trình tinh chỉnh này được lấy cảm hứng nhiều từ openai-cookbook khi thực hiện tinh chỉnh trên Microsoft Azure.
Để tiến hành tinh chỉnh, chúng ta sẽ thực hiện hai bước: (1) xác định siêu tham số, và (2) kích hoạt quá trình tinh chỉnh.
Chúng ta sẽ tinh chỉnh mô hình davinci và chạy 15 epoch với batch size bằng 3 và hệ số nhân tốc độ học là 0,3, sử dụng các tập dữ liệu huấn luyện và kiểm định.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
Đoạn mã trên tạo ra thông tin cho jobID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), phản hồi huấn luyện, và trạng thái huấn luyện (đang chờ).
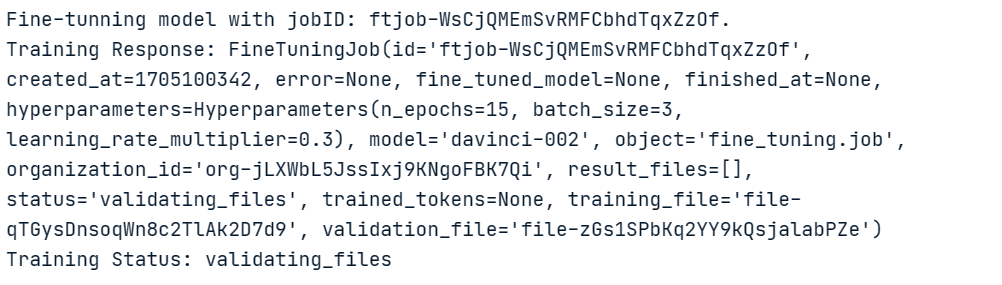
Trạng thái “đang chờ” này không cung cấp nhiều thông tin. Tuy nhiên, chúng ta có thể hiểu rõ hơn quá trình huấn luyện bằng cách chạy đoạn mã sau:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
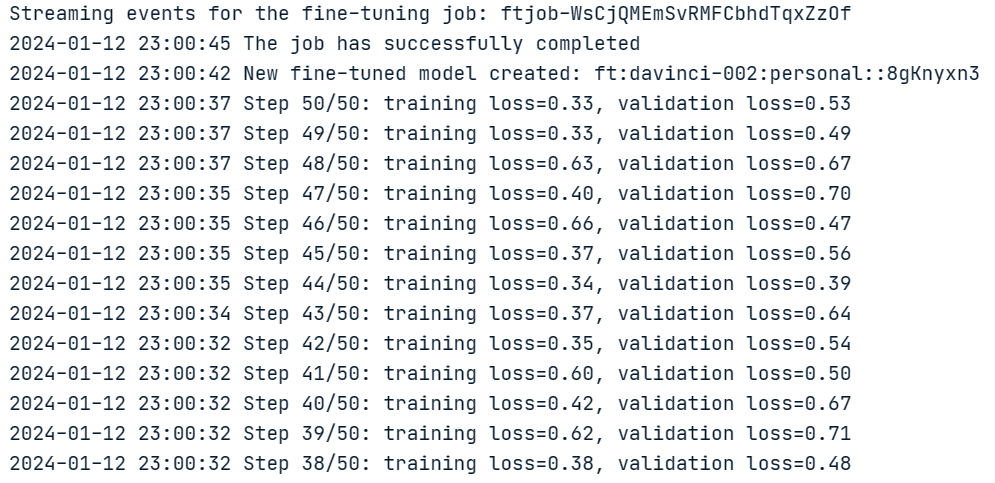
Tất cả các epoch sẽ được hiển thị kèm theo trạng thái tinh chỉnh là “succeeded”.
Kiểm tra trạng thái tác vụ tinh chỉnh
Hãy xác minh rằng thao tác đã thành công; ngoài ra, chúng ta có thể xem tất cả các lần tinh chỉnh bằng thao tác liệt kê.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Kết quả thực thi như dưới đây:
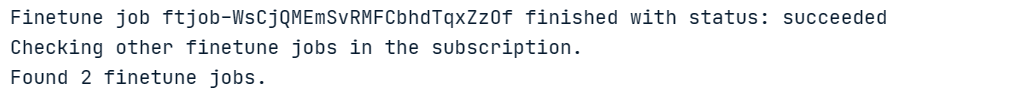
Tổng cộng có 2 tác vụ tinh chỉnh.
Kiểm định mô hình
Cuối cùng, mô hình đã tinh chỉnh có thể được lấy từ thuộc tính “fine_tuned_model”. Lệnh in dưới đây cho thấy tên mô hình cuối cùng là: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Với mô hình này, chúng ta có thể chạy truy vấn để kiểm định kết quả bằng cách cung cấp một prompt, tên mô hình và tạo truy vấn với hàm openai.Completion.create(). Kết quả được lấy từ dictionary answer như sau:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Dù các prompt không được viết y hệt như trong tập kiểm định, mô hình vẫn ánh xạ được tới câu trả lời chính xác. Kết quả cho các yêu cầu trên được hiển thị bên dưới.

Chỉ với rất ít mẫu huấn luyện, chúng ta đã có một mô hình tinh chỉnh ở mức khá. Có thể đạt kết quả tốt hơn với tập huấn luyện lớn hơn.
Kết luận
Trong bài viết này, chúng tôi đã khám phá tiềm năng của GPT-3 và thảo luận quy trình tinh chỉnh mô hình để cải thiện hiệu năng cho các trường hợp sử dụng cụ thể. Chúng tôi đã nêu các điều kiện tiên quyết để tinh chỉnh GPT-3 thành công, bao gồm hiểu biết cơ bản về Python và sự quen thuộc với máy học và xử lý ngôn ngữ tự nhiên.
Bên cạnh đó, chúng tôi đã giới thiệu gói Python openai, giúp đơn giản hóa việc truy cập các khả năng của GPT-3 thông qua API của OpenAI. Bài viết đã bao quát toàn bộ các bước tinh chỉnh mô hình GPT-3 bằng Python và tập dữ liệu tùy chỉnh, từ lấy thông tin xác thực API đến chuẩn bị dữ liệu, huấn luyện và kiểm định mô hình.
Bằng cách nhấn mạnh lợi ích của tinh chỉnh và cung cấp hướng dẫn toàn diện, bài viết này nhằm hỗ trợ các nhà khoa học dữ liệu, nhà phát triển và những bên liên quan khác với các công cụ và kiến thức cần thiết để tạo ra các mô hình GPT-3 chính xác và hiệu quả hơn, phù hợp với nhu cầu cụ thể của họ.
Chúng tôi có bài viết về GPT-4 là gì và vì sao nó quan trọng? và cả hướng dẫn Giới thiệu về cách sử dụng Transformers và Hugging Face. Hãy đọc để nâng tầm kiến thức của bạn.

