GPT-3, pour Generative Pre-trained Transformer de troisième génération, est un modèle de deep learning de pointe créé par OpenAI. En s’appuyant sur d’immenses volumes de données issues d’internet, GPT-3 peut produire des textes variés et solides avec très peu d’entrées. GPT-3 couvre un large éventail d’applications, parmi lesquelles la synthèse de texte, la traduction, le développement de chatbots et la génération de contenu.
Malgré sa robustesse, les performances de GPT-3 peuvent être améliorées en le spécialisant (fine-tuning) sur un cas d’usage précis.
Mais que signifie exactement fine-tuning ?
Il s’agit d’entraîner le modèle GPT-3 pré-entraîné sur un jeu de données propre à votre cas d’usage. Le modèle s’adapte ainsi mieux aux nuances du domaine visé, ce qui conduit à des résultats plus précis.
Pour réussir cette opération, il est recommandé d’avoir (1) des bases en programmation Python et (2) des notions de machine learning et de traitement du langage naturel.
Notre article Classification en machine learning : introduction vous aide à comprendre la classification en apprentissage automatique, ses usages et quelques exemples d’algorithmes.
Nous utiliserons le package Python openai fourni par OpenAI pour faciliter l’usage de leur API et accéder aux capacités de GPT-3.
Cet article vous guide pas à pas dans le processus de fine-tuning du modèle GPT-3 avec Python sur vos propres données, de l’obtention des identifiants API à la préparation des données, l’entraînement du modèle et sa validation.
Quels modèles GPT peuvent être ajustés ?
Les modèles GPT pouvant faire l’objet d’un fine-tuning sont Ada, Babbage, Curie et Davinci. Ils appartiennent à la famille GPT-3. Notez également que le fine-tuning n’est actuellement pas disponible pour les modèles plus récents GPT-3.5-turbo ni pour GPT-4.
Consultez notre guide pour débutants sur GPT-3 pour en savoir plus sur le modèle.
Quels sont les bons cas d’usage pour le fine-tuning de GPT ?
Deux catégories de problèmes tirent particulièrement parti du fine-tuning d’un modèle de langue comme GPT-3 : la classification et la génération conditionnelle. Passons-les brièvement en revue.
Classification
Pour les tâches de classification, chaque entrée du prompt est associée à l’une des classes prédéfinies. Exemples :
- Garantie de véracité : si une entreprise veut vérifier que les publicités sur son site mentionnent le bon produit et la bonne marque, on peut ajuster un classifieur pour filtrer les annonces erronées et éviter que le modèle n’invente des informations.
- Analyse de sentiment : classer un texte selon le sentiment qu’il exprime (positif, négatif ou neutre).
- Tri et catégorisation d’e-mails : pour classer les messages entrants dans un grand nombre de catégories prédéfinies, on peut convertir ces catégories en identifiants numériques, ce qui fonctionne bien jusqu’à environ 500 catégories.
Génération conditionnelle
Ces problèmes consistent à générer du contenu à partir d’une entrée donnée. Les applications incluent la reformulation, le résumé, l’extraction d’entités, la rédaction de fiches produit, les assistants virtuels (chatbots), etc. Exemples :
- Créer des publicités percutantes à partir d’articles Wikipedia. Dans ce cas d’usage génératif, veillez à fournir des exemples de haute qualité, car le modèle ajusté imitera le style (et les erreurs) des échantillons.
- Extraction d’entités. Cette tâche s’apparente à une transformation linguistique. Améliorez les performances en triant les entités extraites par ordre alphabétique ou selon leur ordre d’apparition dans le texte source.
- Chatbot de support client. Un chatbot inclut généralement le contexte pertinent (détails de commande), un résumé de l’échange et les derniers messages.
- Description produit à partir de propriétés techniques. Convertissez les données d’entrée en langage naturel pour de meilleurs résultats.
Mise en œuvre pas à pas du fine-tuning de GPT-3
Il est nécessaire de créer un compte développeur OpenAI pour obtenir une clé API. Voici les étapes :
Commencez par créer un compte sur le site officiel d’OpenAI.
Puis, cliquez sur l’icône de profil en haut à droite et choisissez « View API Keys » pour accéder à la page de création d’une nouvelle clé API ou réutiliser une clé existante.

Créez une nouvelle clé secrète depuis l’onglet « Create new secret key », donnez-lui un nom explicite (GPT3_fine_tuning_key dans notre exemple) et la clé API sera générée automatiquement.


Si vous êtes bloqué ou rencontrez des difficultés, consultez le workbook DataLab avec tout le code.
Jeu de données
Dans cet exemple, nous allons ajuster GPT-3 pour un scénario de questions-réponses, avec un format structuré question-réponse permettant au modèle de bien comprendre la tâche à effectuer. Le même format est respecté pour chaque paire question-réponse dans toutes les données d’entraînement et de test.
Un enregistrement du jeu de données questions-réponses suit le format suivant :
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- « prompt » correspond au texte d’entrée lu et traité par le modèle. Le séparateur principal est la flèche (->) pour distinguer le prompt de la réponse attendue.
- « completion » est la réponse attendue au prompt. Le symbole barre oblique « \n » sert de séquence d’arrêt pour indiquer la fin de la réponse.
Avec ce format en tête, nous pouvons générer les jeux d’entraînement et de validation, comme ci-dessous. Ces prompts et réponses ont été créés avec ChatGPT.
Notre antisèche ChatGPT pour la data science propose plus de 60 prompts dédiés aux tâches Data Science.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Configuration
Avant de passer à l’implémentation, préparons l’environnement de travail en installant les bibliothèques nécessaires, notamment la librairie Python OpenAI, comme suit :
pip install --upgrade openaiNous pouvons maintenant l’importer.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
Préparer le jeu de données
Le format liste montré plus haut est pratique pour de petits jeux de données. Cependant, enregistrer les données au format JSONL (JSON Lines) présente plusieurs avantages : passage à l’échelle, interopérabilité, simplicité, et compatibilité avec l’API OpenAI, qui exige du JSONL pour créer des tâches de fine-tuning.
Le code ci-dessous utilise la fonction utilitaire prepare_data pour créer les jeux d’entraînement et de validation au format JSONL :
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Enfin, nous téléchargeons les deux jeux de données sur le compte développeur OpenAI comme suit :
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Si l’exécution se passe bien, les identifiants uniques des fichiers d’entraînement et de validation s’affichent ci-dessous.
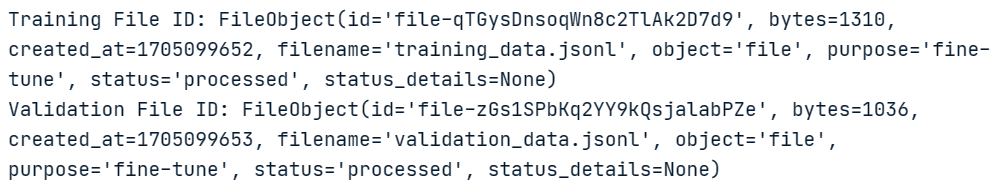
À ce stade, nous avons tout le nécessaire pour lancer le fine-tuning.
Créer une tâche de fine-tuning
Ce processus s’inspire fortement de l’openai-cookbook qui illustre le fine-tuning sur Microsoft Azure.
Pour réaliser le fine-tuning, nous allons : (1) définir les hyperparamètres et (2) déclencher l’entraînement.
Nous allons ajuster le modèle davinci et l’entraîner pendant 15 époques avec une taille de lot de 3 et un multiplicateur de taux d’apprentissage de 0,3, en utilisant nos jeux d’entraînement et de validation.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
Le code ci-dessus renvoie un jobID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), ainsi que la réponse d’entraînement et le statut (pending).
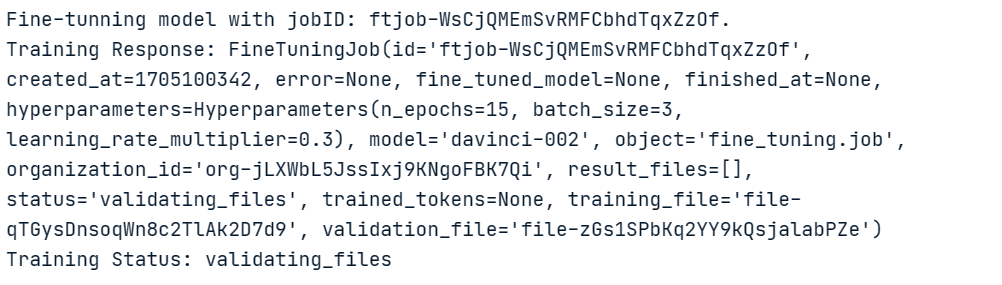
Le statut « pending » n’apporte pas d’informations utiles. Pour suivre l’entraînement plus finement, exécutez le code suivant :
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
Toutes les époques s’affichent, ainsi que le statut final du fine-tuning, qui est « succeeded ».
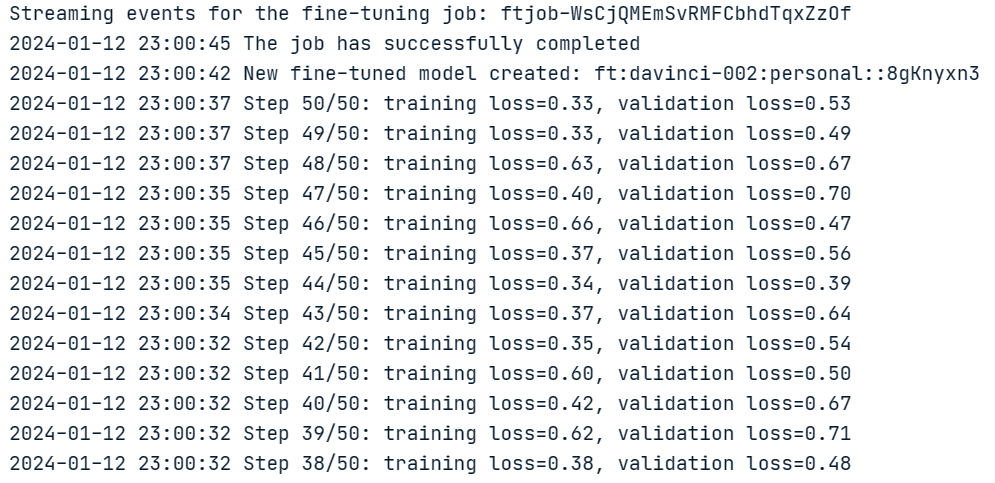
Vérifier le statut de la tâche
Vérifions que l’opération a bien abouti et listons, au passage, toutes les opérations de fine-tuning.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Le résultat de l’exécution est donné ci-dessous :
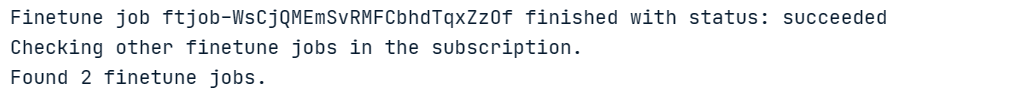
On compte au total 2 tâches de fine-tuning.
Validation du modèle
Enfin, le modèle ajusté peut être récupéré via l’attribut « fine_tuned_model ». L’instruction ci-dessous montre que le nom du modèle final est : ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Avec ce modèle, nous pouvons exécuter des requêtes pour valider ses résultats en fournissant un prompt, le nom du modèle et en créant une requête avec la fonction openai.Completion.create(). Le résultat est récupéré depuis le dictionnaire de réponse comme suit :
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Même si les prompts ne sont pas rédigés exactement comme dans le jeu de validation, le modèle parvient à retrouver les bonnes réponses. Les sorties correspondantes sont présentées ci-dessous.

Avec très peu d’exemples d’entraînement, nous obtenons déjà un modèle ajusté de qualité correcte. Des jeux de données plus conséquents permettront d’améliorer encore les performances.
Conclusion
Dans cet article, nous avons exploré le potentiel de GPT-3 et détaillé le processus de fine-tuning pour améliorer ses performances sur des cas d’usage spécifiques. Nous avons rappelé les prérequis pour réussir, notamment des bases en Python et une familiarité avec le machine learning et le traitement du langage naturel.
Nous avons également présenté le package Python openai, qui simplifie l’accès aux capacités de GPT-3 via l’API d’OpenAI. L’article couvre toutes les étapes du fine-tuning de GPT-3 avec Python et des jeux de données personnalisés : obtention des identifiants API, préparation des données, entraînement et validation.
En mettant en avant les bénéfices du fine-tuning et en proposant un guide complet, cet article vise à donner aux data scientists, développeurs et autres parties prenantes les clés pour créer des modèles GPT-3 plus précis et efficaces, adaptés à leurs besoins.
Nous proposons aussi un article sur Qu’est-ce que GPT-4 et pourquoi c’est important ? ainsi qu’un tutoriel Introduction à l’usage des Transformers et de Hugging Face. Lisez-les pour aller plus loin.
Introduction au cours ChatGPT
Commencez avec ChatGPT
