GPT-3, de derde generatie Generative Pre-trained Transformer, is een geavanceerd deep-learningmodel met neurale netwerken, ontwikkeld door OpenAI. Met enorme hoeveelheden internetdata kan GPT-3 diverse en robuuste door machines gegenereerde tekst produceren met minimale input. GPT-3 kent een breed scala aan toepassingen, zoals samenvatten van tekst, vertalen, chatbotontwikkeling en contentcreatie.
Ondanks zijn robuustheid kan de performance van GPT-3 verder verbeterd worden door het model te fine-tunen op een specifieke usecase.
Maar wat bedoelen we met fine-tuning?
Dat is het proces waarbij de voorgetrainde GPT-3 verder wordt getraind op een datasets voor een maatwerk-usecase. Hierdoor kan het model zich beter aanpassen aan de nuances van die specifieke usecase of domein, wat leidt tot nauwkeurigere resultaten.
De vereisten om fine-tuning succesvol uit te voeren zijn (1) basiskennis van programmeren in Python en (2) bekendheid met machine learning en natural language processing.
Ons artikel Classificatie in machine learning: een introductie helpt je meer te leren over classificatie in machine learning: wat het is, hoe het wordt gebruikt en enkele voorbeelden van classificatie-algoritmen.
We gebruiken het openai Python-pakket van OpenAI om hun API eenvoudiger te gebruiken en toegang te krijgen tot de mogelijkheden van GPT-3.
Dit artikel leidt je stap voor stap door het fine-tuningproces van het GPT-3-model met Python op je eigen data, met alle stappen: van het verkrijgen van API-gegevens tot het voorbereiden van data, het trainen van het model en het valideren ervan.
Welke GPT-modellen kun je fine-tunen?
De GPT-modellen die je kunt fine-tunen zijn Ada, Babbage, Curie en Davinci. Deze modellen behoren tot de GPT-3-familie. Let ook op dat fine-tuning momenteel niet beschikbaar is voor de recentere GPT-3.5-turbo-modellen of andere GPT-4-modellen.
Lees onze beginnersgids voor GPT-3 voor meer informatie over het model.
Wat zijn goede usecases voor het fine-tunen van GPT?
Classificatie en conditionele generatie zijn de twee typen problemen die kunnen profiteren van het fine-tunen van een taalmodel zoals GPT-3. Laten we ze kort bekijken.
Classificatie
Bij classificatieproblemen wordt elke input in de prompt toegewezen aan een van de vooraf gedefinieerde klassen. Enkele voorbeelden:
- Zeker weten dat uitspraken kloppen: als een bedrijf wil controleren of advertenties op hun website het juiste product en bedrijf noemen, kan een classifier worden gefine-tuned om onjuiste advertenties eruit te filteren, zodat het model niets verzint.
- Sentimentanalyse: hierbij wordt tekst geclassificeerd op sentiment, zoals positief, negatief of neutraal.
- Indelen van e-mails: om binnenkomende e-mails in een van de vele vooraf gedefinieerde categorieën te sorteren, kunnen die categorieën worden omgezet in nummers; dat werkt goed tot ongeveer 500 categorieën.
Conditionele generatie
De problemen in deze categorie draaien om het genereren van content op basis van een gegeven input. Toepassingen zijn onder andere parafraseren, samenvatten, entiteitsextractie, productbeschrijvingen schrijven, virtuele assistenten (chatbots) en meer. Voorbeelden:
- Het maken van pakkende advertenties op basis van Wikipedia-artikelen. Zorg er bij dit generatieve gebruiksscenario voor dat de aangeleverde voorbeelden van hoge kwaliteit zijn, omdat het gefine-tunede model de stijl (én fouten) van de voorbeelden zal proberen te imiteren.
- Entiteitsextractie. Deze taak lijkt op een taaltransformatieprobleem. Verbeter de prestaties door geëxtraheerde entiteiten alfabetisch te sorteren of in dezelfde volgorde als in de oorspronkelijke tekst.
- Klantenservicechatbot. Een chatbot bevat doorgaans relevante context over het gesprek (bestelgegevens), een samenvatting tot nu toe en de meest recente berichten.
- Productbeschrijving op basis van technische eigenschappen. Zet inputdata om naar natuurlijke taal om in deze context betere prestaties te behalen.
Een stapsgewijze implementatie van fine-tuning voor GPT-3
Een OpenAI-ontwikkelaarsaccount is verplicht om toegang te krijgen tot de API-sleutel. De stappen staan hieronder:
Maak eerst een account aan via de officiële website van OpenAI.
Selecteer vervolgens het gebruikersprofielpictogram rechtsboven en klik op “View API Keys” om naar de pagina te gaan waar je een nieuwe API-sleutel kunt aanmaken of een bestaande kunt gebruiken.

Maak een nieuwe geheime sleutel aan via het tabblad “Create new secret key” door een betekenisvolle naam op te geven (in dit geval GPT3_fine_tuning_key); de API-sleutel wordt daarna automatisch gegenereerd.


Loop je vast of heb je problemen? Bekijk dan zeker de DataLab-werkmap met alle code.
Dataset
In deze usecase fine-tunen we het GPT-3-model voor een vraag-en-antwoordscenario, bestaande uit een gestructureerd vraag-antwoordpatroon dat is bedoeld om het model te helpen begrijpen welke taak het moet uitvoeren. Voor elk paar vragen en antwoorden wordt in de volledige trainings- en testdata een consistent formaat gehanteerd.
Een voorbeeld in de vraag-en-antwoordsdataset heeft het volgende formaat:
{
"prompt": "my prompt ->",
"completion": "the answer of the prompt. \n"
}- “prompt” is de invoertekst die door het model wordt gelezen en verwerkt. De hoofdseparator is het pijlteken (->) om de prompt te scheiden van de verwachte reactie.
- “completion” is de verwachte reactie op de prompt. Een backslash “\n” wordt gebruikt als stopsequentie om het einde van het antwoord aan te geven.
Met dit begrip van het datasetformaat kunnen we zowel de trainings- als de validatieset genereren, zoals hieronder getoond. Deze prompts en completions zijn gegenereerd met ChatGPT.
Onze ChatGPT-cheatsheet voor data science biedt toegang tot meer dan 60 prompts voor data science-taken.
training_data = [
	{
    	"prompt": "What is the capital of France?->",
    	"completion": """ The capital of France is Paris.\n"""
	},
	{
    	"prompt": "What is the primary function of the heart?->",
    	"completion": """ The primary function of the heart is to pump blood throughout the body.\n"""
	},
	{
    	"prompt": "What is photosynthesis?->",
    	"completion": """ Photosynthesis is the process by which green plants and some other organisms convert sunlight into chemical energy stored in the form of glucose.\n"""
	},
	{
    	"prompt": "Who wrote the play 'Romeo and Juliet'?->",
    	"completion": """ William Shakespeare wrote the play 'Romeo and Juliet'.\n"""
	},
	{
    	"prompt": "Which element has the atomic number 1?->",
    	"completion": """ Hydrogen has the atomic number 1.\n"""
	},
	{
    	"prompt": "What is the largest planet in our solar system?->",
    	"completion": """ Jupiter is the largest planet in our solar system.\n"""
	},
	{
    	"prompt": "What is the freezing point of water in Celsius?->",
    	"completion": """ The freezing point of water in Celsius is 0 degrees.\n"""
	},
	{
    	"prompt": "What is the square root of 144?->",
    	"completion": """ The square root of 144 is 12.\n"""
	},
	{
    	"prompt": "Who is the author of 'To Kill a Mockingbird'?->",
    	"completion": """ The author of 'To Kill a Mockingbird' is Harper Lee.\n"""
	},
	{
    	"prompt": "What is the smallest unit of life?->",
    	"completion": """ The smallest unit of life is the cell.\n"""
	}
]

validation_data = [
	{
    	"prompt": "Which gas do plants use for photosynthesis?->",
    	"completion": """ Plants use carbon dioxide for photosynthesis.\n"""
	},
	{
    	"prompt": "What are the three primary colors of light?->",
    	"completion": """ The three primary colors of light are red, green, and blue.\n"""
	},
	{
    	"prompt": "Who discovered penicillin?->",
    	"completion": """ Sir Alexander Fleming discovered penicillin.\n"""
	},
	{
    	"prompt": "What is the chemical formula for water?->",
    	"completion": """ The chemical formula for water is H2O.\n"""
	},
	{
    	"prompt": "What is the largest country by land area?->",
    	"completion": """ Russia is the largest country by land area.\n"""
	},
	{
    	"prompt": "What is the speed of light in a vacuum?->",
    	"completion": """ The speed of light in a vacuum is approximately 299,792 kilometers per second.\n"""
	},
	{
    	"prompt": "What is the currency of Japan?->",
    	"completion": """ The currency of Japan is the Japanese Yen.\n"""
	},
	{
    	"prompt": "What is the smallest bone in the human body?->",
    	"completion": """ The stapes, located in the middle ear, is the smallest bone in the human body.\n"""
	}
]
Setup
Voordat we met de implementatie beginnen, richten we de werkomgeving in door de noodzakelijke libraries te installeren, met name de OpenAI Python-library, zoals hieronder:
pip install --upgrade openaiNu kunnen we de library importeren.
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ['OPENAI_API_KEY'],
)
De dataset voorbereiden
Werken met een lijstformaat, zoals hierboven, kan handig zijn voor kleine datasets. Maar er zijn verschillende voordelen aan het opslaan van data in JSONL (JSON Lines). Denk aan schaalbaarheid, interoperabiliteit, eenvoud en compatibiliteit met de OpenAI API, die JSONL vereist bij het aanmaken van fine-tuningjobs.
De onderstaande code gebruikt de helperfunctie prepare_data om zowel de trainings- als de validatiedata in JSONL-formaat te maken:
import json

training_file_name = "training_data.jsonl"
validation_file_name = "validation_data.jsonl"

def prepare_data(dictionary_data, final_file_name):
    with open(final_file_name, 'w') as outfile:
        for entry in dictionary_data:
        	json.dump(entry, outfile)
        	outfile.write('\n')

prepare_data(training_data, "training_data.jsonl")
prepare_data(validation_data, "validation_data.jsonl")
Tot slot uploaden we de twee datasets naar het OpenAI-ontwikkelaarsaccount als volgt:
training_file_id = client.files.create(
  file=open(training_file_name, "rb"),
  purpose="fine-tune"
)

validation_file_id = client.files.create(
  file=open(validation_file_name, "rb"),
  purpose="fine-tune"
)

print(f"Training File ID: {training_file_id}")
print(f"Validation File ID: {validation_file_id}")
Een succesvolle uitvoering van de vorige code toont hieronder de unieke identifier van de trainings- en validatiedata.
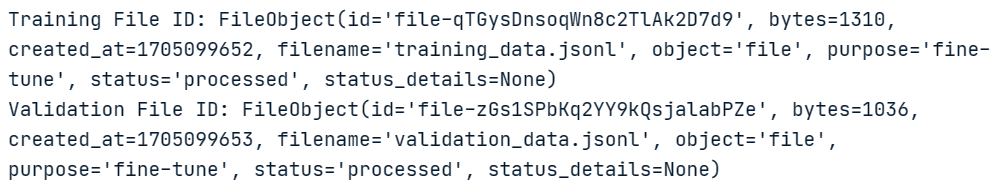
Op dit punt hebben we alle informatie om door te gaan met het fine-tunen.
Een fine-tuningjob aanmaken
Dit fine-tuningproces is sterk geïnspireerd op de openai-cookbook die fine-tuning uitvoert op Microsoft Azure.
Voor de fine-tuning gebruiken we twee stappen: (1) hyperparameters definiëren en (2) de fine-tuning starten.
We fine-tunen het davinci-model en draaien het 15 epochs met een batchgrootte van 3 en een learning rate multiplier van 0,3, met gebruik van de trainings- en validatiedatasets.
response = client.fine_tuning.jobs.create(
  training_file=training_file_id.id,
  validation_file=validation_file_id.id,
  model="davinci-002",
  hyperparameters={
    "n_epochs": 15,
	"batch_size": 3,
	"learning_rate_multiplier": 0.3
  }
)
job_id = response.id
status = response.status

print(f'Fine-tunning model with jobID: {job_id}.')
print(f"Training Response: {response}")
print(f"Training Status: {status}")
De bovenstaande code levert de volgende informatie op voor de jobID (ftjob-WsCjQMEmSvRMFCbhdTqxZzOf), de training response en de trainingsstatus (pending).
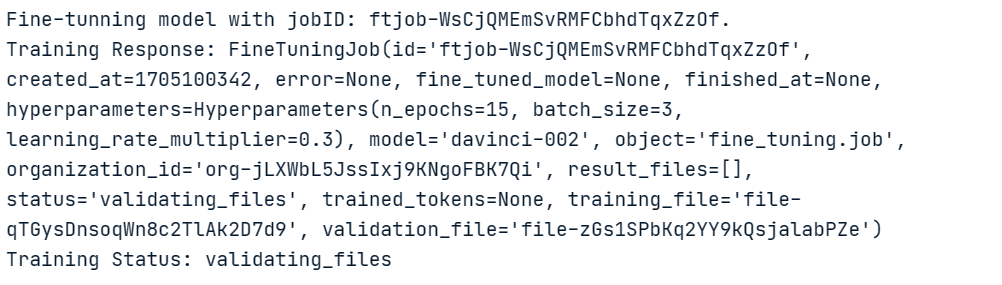
Deze pending-status geeft geen relevante informatie. We kunnen echter meer inzicht krijgen in het trainingsproces door de volgende code uit te voeren:
import signal
import datetime


def signal_handler(sig, frame):
    status = client.fine_tuning.jobs.retrieve(job_id).status
    print(f"Stream interrupted. Job is still {status}.")
    return


print(f"Streaming events for the fine-tuning job: {job_id}")

signal.signal(signal.SIGINT, signal_handler)

events = client.fine_tuning.jobs.list_events(fine_tuning_job_id=job_id)
try:
    for event in events:
        print(
            f'{datetime.datetime.fromtimestamp(event.created_at)} {event.message}'
        )
except Exception:
    print("Stream interrupted (client disconnected).")
Alle epochs worden hieronder weergegeven, samen met de status van de fine-tuning, die is geslaagd.
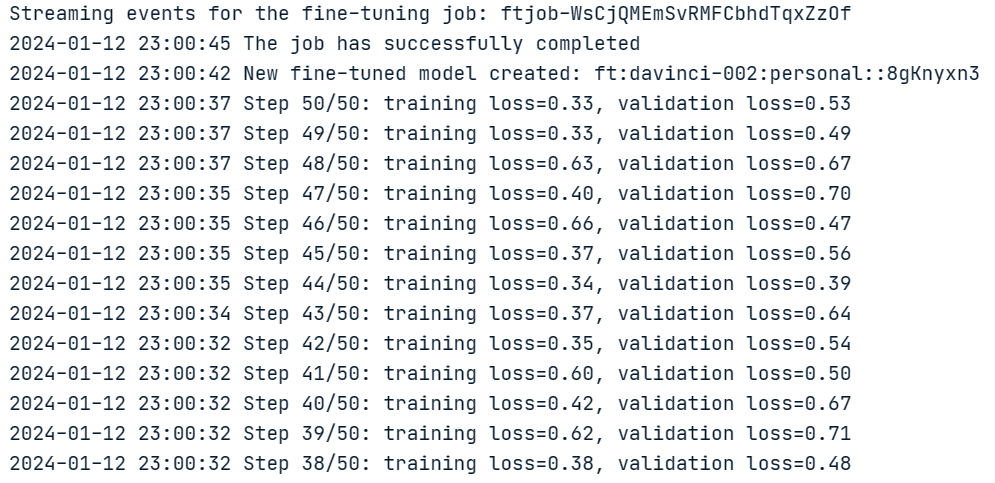
De status van de fine-tuningjob controleren
Laten we verifiëren dat onze operatie is geslaagd. Daarnaast kunnen we alle fine-tuningoperaties bekijken met een list-operatie.
import time

status = client.fine_tuning.jobs.retrieve(job_id).status
if status not in ["succeeded", "failed"]:
    print(f"Job not in terminal status: {status}. Waiting.")
    while status not in ["succeeded", "failed"]:
        time.sleep(2)
        status = client.fine_tuning.jobs.retrieve(job_id).status
        print(f"Status: {status}")
else:
    print(f"Finetune job {job_id} finished with status: {status}")
print("Checking other finetune jobs in the subscription.")
result = client.fine_tuning.jobs.list()
print(f"Found {len(result.data)} finetune jobs.")
Het resultaat van de uitvoering staat hieronder:
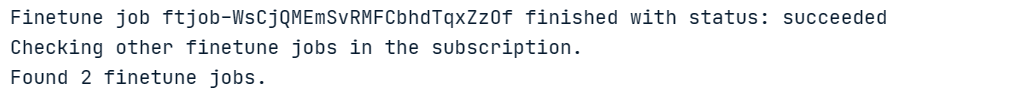
Er zijn in totaal 2 fine-tuningjobs.
Validatie van het model
Het gefine-tunede model kan ten slotte worden opgehaald via het attribuut “fine_tuned_model”. De volgende printopdracht laat zien dat de naam van het definitieve model is: ft:davinci-002:personal::8gKnyxn3
# Retrieve the finetuned model
fine_tuned_model = result.data[0].fine_tuned_model
print(fine_tuned_model)

Met dit model kunnen we queries uitvoeren om de resultaten te valideren door een prompt en de modelnaam op te geven en een query te maken met de functie openai.Completion.create(). Het resultaat wordt opgehaald uit het answer-woordenboek als volgt:
new_prompt = "Which part is the smallest bone in the entire human body?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)

new_prompt = "Which type of gas is utilized by plants during the process of photosynthesis?"
answer = client.completions.create(
  model=fine_tuned_model,
  prompt=new_prompt
)

print(answer.choices[0].text)
Ook al zijn de prompts niet exact hetzelfde geformuleerd als in de validatieset, het model wist ze toch te koppelen aan de juiste antwoorden. De antwoorden op de bovenstaande verzoeken staan hieronder.

Met zeer weinig trainingsvoorbeelden hebben we een behoorlijk goed gefine-tuned model gekregen. Betere resultaten zijn te behalen met een grotere trainingsset.
Conclusie
In dit artikel hebben we het potentieel van GPT-3 verkend en het proces besproken om het model te fine-tunen om de prestaties voor specifieke usecases te verbeteren. We hebben de vereisten uiteengezet om GPT-3 succesvol te fine-tunen, waaronder basiskennis van Python en bekendheid met machine learning en natural language processing.
Daarnaast hebben we het openai Python-pakket geïntroduceerd, dat wordt gebruikt om het eenvoudiger te maken om via de API van OpenAI toegang te krijgen tot de mogelijkheden van GPT-3. Het artikel heeft alle stappen behandeld die komen kijken bij het fine-tunen van het GPT-3-model met Python en aangepaste datasets: van het verkrijgen van API-gegevens tot het voorbereiden van data, het trainen van het model en het valideren ervan.
Door de voordelen van fine-tuning te benadrukken en een uitgebreide gids voor het proces te bieden, wil dit artikel data scientists, ontwikkelaars en andere betrokkenen helpen met de tools en kennis die nodig zijn om nauwkeurigere en efficiëntere GPT-3-modellen te maken, afgestemd op hun specifieke behoeften en eisen.
We hebben ook een artikel over Wat is GPT-4 en waarom is het belangrijk? en een tutorial Een introductie tot het gebruik van Transformers en Hugging Face. Lees ze om je kennis naar een hoger niveau te tillen.


