
Last chance! 50% off DataCamp Premium
Sale ends in
Ministral 3 adalah keluarga baru model multimodal yang dioptimalkan untuk edge, tersedia dalam ukuran 3B, 8B, dan 14B, masing-masing menawarkan varian Base, Instruct, dan Reasoning dengan dukungan visi penuh.
Dirancang untuk menghadirkan kinerja level frontier yang kuat sekaligus tetap ringan untuk penerapan lokal dan privat, Ministral 3 menjembatani kemampuan lanjutan dengan keterbatasan perangkat keras praktis; model andalan 14B Instruct-nya muat dalam 24GB VRAM pada FP8 dan menandingi sistem yang lebih besar seperti Mistral Small 3.2 24B. Dengan jendela konteks besar 256k, cakupan multibahasa yang tangguh, pemanggilan fungsi native, kepatuhan kuat terhadap system prompt, dan lisensi terbuka Apache 2.0.
Dalam tutorial ini, kita akan melakukan fine-tune model Ministral 3 14B Instruct pada dataset X-ray patah tulang untuk meningkatkan kemampuannya mendeteksi fraktur dan mengklasifikasikan kategorinya secara akurat.
Anda akan mempelajari cara:
Jika Anda ingin mempelajari lebih lanjut tentang model Mistral AI, saya merekomendasikan panduan kami Mistral 3 dan tutorial Mistral 3 Large.
Disclaimer: Tutorial ini menunjukkan proses fine-tuning teknis untuk tujuan edukasi saja. Model yang dihasilkan tidak dimaksudkan untuk penggunaan medis atau klinis dan tidak boleh dijadikan dasar untuk diagnosis, pengambilan keputusan, atau perawatan pasien.
Meskipun kita melakukan fine-tune model 14B, pelatihan visi-bahasa membutuhkan memori yang jauh lebih besar daripada fine-tuning hanya teks. Image encoder meningkatkan beban GPU, yang berarti kita memerlukan akses ke GPU A100 dengan 80 GB VRAM agar proses ini berjalan lancar.
Untuk proyek ini, saya menggunakan Runpod dan meluncurkan pod A100.
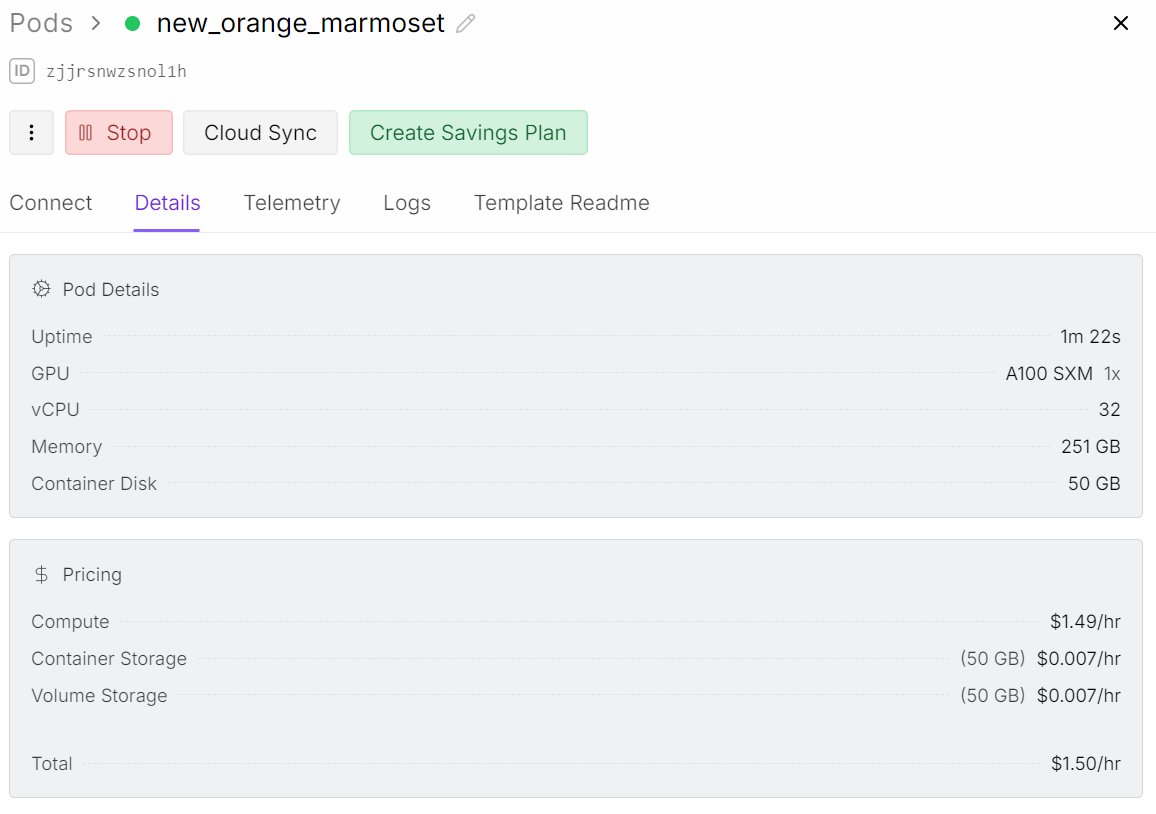
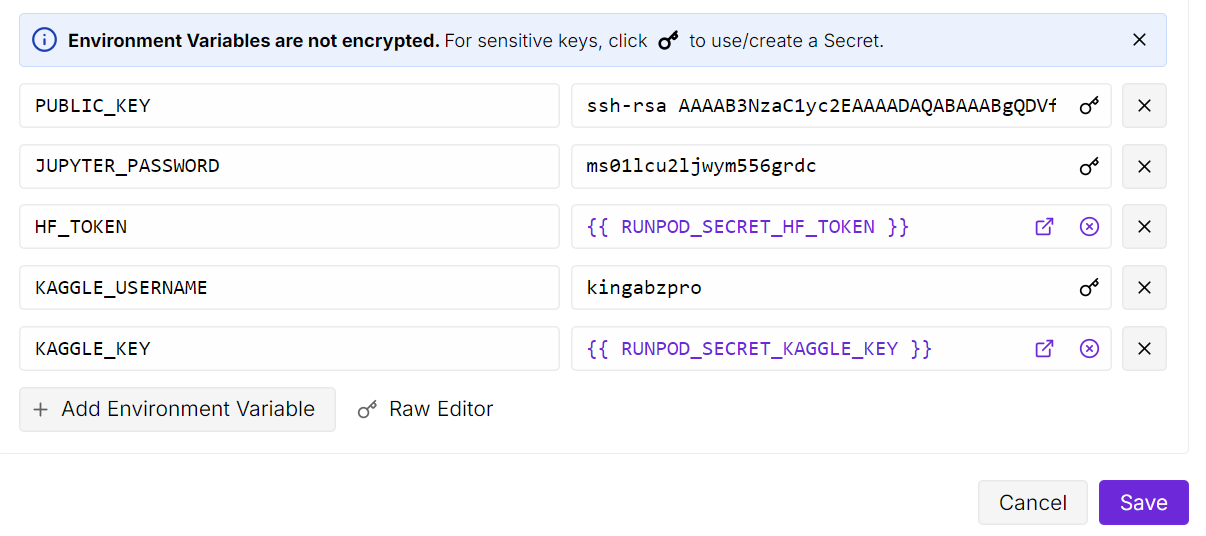
Setelah pod diluncurkan, tingkatkan penyimpanan container menjadi 50 GB. Lalu tambahkan variabel lingkungan untuk kunci API Kaggle dan Hugging Face.
Kaggle akan memungkinkan kita mengunduh dataset X-ray tulang secara langsung, dan Hugging Face akan memungkinkan kita mendorong kembali adaptor LoRA yang telah di-fine-tune ke model hub.
Selanjutnya, buka instance JupyterLab dan buat notebook baru. Sebelum pelatihan, kita perlu memasang semua paket Python yang diperlukan.
Pastikan pustaka Transformers diperbarui ke versi terbaru, karena dukungan Ministral 3 baru saja ditambahkan, dan build yang lebih lama tidak akan memuat model dengan benar.
! pip install --upgrade --quiet bitsandbytes datasets evaluate hf_transfer peft scikit-learn matplotlib Pillow kaggle ipywidgets
!pip install --quiet git+https://github.com/huggingface/transformers.git@bf3f0ae70d0e902efab4b8517fce88f6697636ce
!pip install --quiet --no-deps trl==0.22.2
Setelah semuanya terpasang, Anda siap memuat dataset, menyiapkan collator, dan memulai fine-tuning.
Pada langkah berikutnya, kita menyiapkan folder root untuk dataset dan menggunakan Kaggle Python API untuk mengunduh dataset Bone Break Classification Image.
Dataset ini berisi berbagai kategori patah tulang dalam format X-ray dan akan digunakan untuk fine-tune Ministral 3 untuk klasifikasi visual.
import os
import glob
from kaggle.api.kaggle_api_extended import KaggleApi

DATA_ROOT = "/bone-break"
os.makedirs(DATA_ROOT, exist_ok=True)

kaggle_dataset = "pkdarabi/bone-break-classification-image-dataset"

# Initialize and authenticate Kaggle API (it will read KAGGLE_USERNAME / KAGGLE_KEY)
api = KaggleApi()
api.authenticate()

# Download and unzip the dataset using the Python API
api.dataset_download_files(
    kaggle_dataset,
    path=DATA_ROOT,
    unzip=True,
)
Anda dapat melihat dataset di Kaggle di sini:
Dataset URL: https://www.kaggle.com/datasets/pkdarabi/bone-break-classification-image-datasetDataset yang diunduh tidak diatur dalam struktur yang biasa. Setiap kategori fraktur berisi folder pelatihan dan folder pengujian di dalamnya.
Jadi pertama, kita perlu metode untuk melakukan loop melalui setiap folder kelas, memisahkan dua split, lalu membuat dataset Hugging Face gabungan dengan pemetaan train dan test yang bersih.
import glob, os
from typing import Any, Dict, List

from datasets import Dataset, DatasetDict, Features, ClassLabel, Image

inner_root = os.path.join(
    DATA_ROOT, "Bone Break Classification", "Bone Break Classification"
)

classes = []
train_records: List[Dict[str, Any]] = []
test_records: List[Dict[str, Any]] = []

for class_name in sorted(os.listdir(inner_root)):
    class_dir = os.path.join(inner_root, class_name)
    if not os.path.isdir(class_dir):
        continue

    classes.append(class_name)

    for split_name, split_key in [("Train", "train"), ("Test", "test")]:
        split_dir = os.path.join(class_dir, split_name)
        if not os.path.isdir(split_dir):
            continue

        for ext in ("*.png", "*.jpg", "*.jpeg"):
            for img_path in glob.glob(os.path.join(split_dir, ext)):
                rec = {"image": img_path, "label_name": class_name}
                if split_key == "train":
                    train_records.append(rec)
                else:
                    test_records.append(rec)

print("Classes:", classes)
print("Train samples:", len(train_records))
print("Test samples:", len(test_records))
Kita memiliki total 10 klasifikasi, dengan 989 sampel pelatihan dan 140 sampel pengujian.
Classes: ['Avulsion fracture', 'Comminuted fracture', 'Fracture Dislocation', 'Greenstick fracture', 'Hairline Fracture', 'Impacted fracture', 'Longitudinal fracture', 'Oblique fracture', 'Pathological fracture', 'Spiral Fracture']
Train samples: 989
Test samples: 140
Sekarang kita akan melakukan encoding label untuk dataset Hugging Face sehingga setiap kelas label akan dianggap sebagai label kelas dan setiap gambar diperlakukan sebagai fitur gambar.
Kita akan membuat dua dataset: satu untuk pelatihan dan satu untuk pengujian. Terakhir, kita akan menggabungkannya menjadi satu dataset yang berisi subset pelatihan dan pengujian.
# Encode labels
classes = sorted(list(set(classes)))
label2id = {name: i for i, name in enumerate(classes)}

for rec in train_records:
    rec["label"] = label2id[rec["label_name"]]
for rec in test_records:
    rec["label"] = label2id[rec["label_name"]]

features = Features(
    {
        "image": Image(),
        "label": ClassLabel(names=classes),
    }
)

train_ds = Dataset.from_list(
    [{"image": r["image"], "label": r["label"]} for r in train_records],
    features=features,
)
test_ds = Dataset.from_list(
    [{"image": r["image"], "label": r["label"]} for r in test_records],
    features=features,
)

data = DatasetDict({"train": train_ds, "test": test_ds})
data
Berikut ikhtisar datasetnya.
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 989
    })
    test: Dataset({
        features: ['image', 'label'],
        num_rows: 140
    })
})Sebelum fine-tuning, ada baiknya memahami seberapa seimbang dataset dan seperti apa gambarnya. Kita akan mulai dengan memeriksa berapa banyak sampel pelatihan yang ada untuk setiap kategori fraktur.
from collections import Counter

label_names = data["train"].features["label"].names
label_ids = data["train"]["label"]

counts = Counter(label_ids)
print("Training Class counts:")
for lbl_id, cnt in counts.items():
    print(f"{lbl_id:2d} ({label_names[lbl_id]}): {cnt}")

FRACTURE_CLASSES = label_names
Kategorinya cukup seimbang, meskipun ukuran sampel keseluruhan kecil untuk tugas klasifikasi visi yang kompleks.
Untuk saat ini, kita akan melanjutkan dengan dataset ini, tetapi hasilnya harus ditafsirkan dengan ekspektasi realistis karena volume sampel yang terbatas.
Training Class counts:
 0 (Avulsion fracture): 109
 1 (Comminuted fracture): 134
 2 (Fracture Dislocation): 137
 3 (Greenstick fracture): 106
 4 (Hairline Fracture): 101
 5 (Impacted fracture): 75
 6 (Longitudinal fracture): 68
 7 (Oblique fracture): 69
 8 (Pathological fracture): 116
 9 (Spiral Fracture): 74
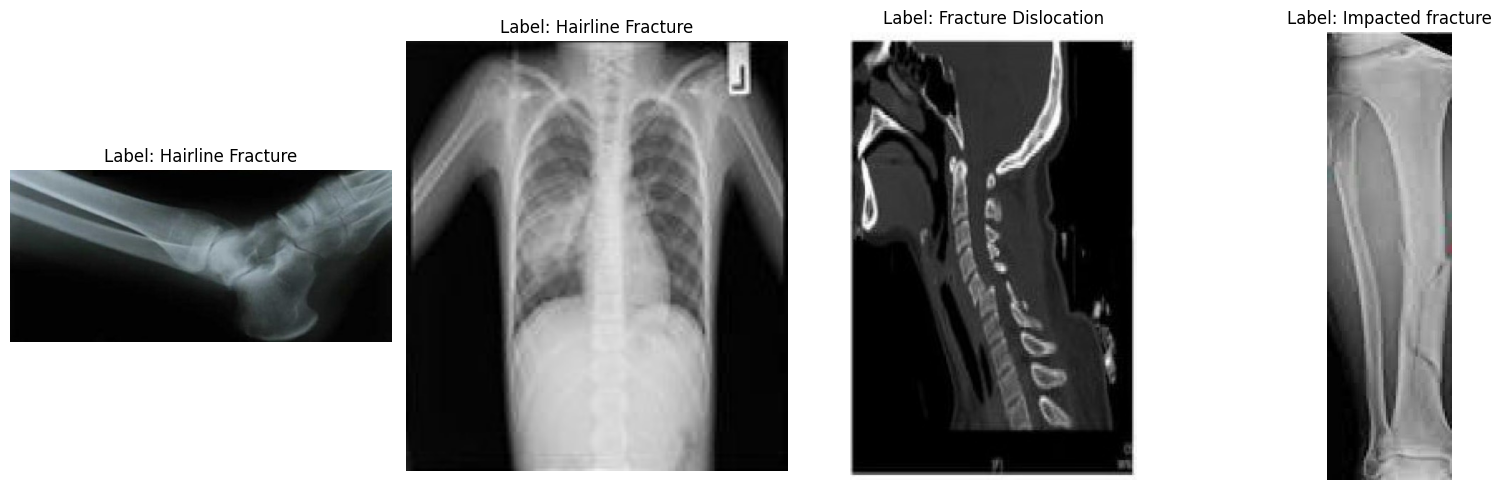
Selanjutnya, mari kita lihat beberapa gambar acak untuk lebih memahami dataset secara visual.
import matplotlib.pyplot as plt
from datasets import Image

# Cast the 'image' column to Hugging Face Image feature
dataset_images = data.cast_column("image", Image())

# Select random samples from the training set
samples = dataset_images["train"].shuffle(seed=420).select(range(4))

# Plot
fig, axes = plt.subplots(1, 4, figsize=(16, 5))

for i, sample in enumerate(samples):
    img_object = sample["image"]              # PIL Image
    label_id = sample["label"]               # int
    label_name = label_names[label_id]       # string

    axes[i].imshow(img_object)
    axes[i].set_title(f"Label: {label_name}")
    axes[i].axis("off")

plt.tight_layout()
plt.show()
Melihat contoh gambar, kita dapat melihat perbedaan ukuran, resolusi, orientasi, dan kualitas pemindaian. Ini tidak memengaruhi fine-tuning model visi-bahasa, tetapi dapat memengaruhi seberapa konsisten model mempelajari setiap kategori fraktur.
Mendeteksi fraktur secara visual sering kali mudah, tetapi mengklasifikasikannya ke salah satu dari sepuluh tipe fraktur medis yang halus membutuhkan data yang lebih terstruktur daripada yang tersedia di sini.
Selanjutnya, kita perlu memutuskan bagaimana kita ingin model berperilaku. Untuk tugas ini, tujuan kita sangat ketat: diberikan sebuah citra X-ray, model harus menghasilkan hanya satu nama kelas fraktur dan tidak ada yang lain. Tanpa penjelasan, tanpa markdown, tanpa teks tambahan.
Kita akan menulis prompt instruksi yang jelas lalu menggunakannya untuk membangun kolom messages dalam dataset.
PROMPT = f"""
You are a radiology assistant specialised in bone fracture classification.

You must classify the X-ray image into exactly ONE of the following classes:
{", ".join(FRACTURE_CLASSES)}

Rules:
- Reply with ONLY the class name.
- No explanations, no extra words, no markdown, no punctuation.
- Output must be EXACTLY one of: {", ".join(FRACTURE_CLASSES)}
""".strip()


from typing import Dict, Any

def convert_to_conversation(example: Dict[str, Any]) -> Dict[str, Any]:
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text",  "text": PROMPT},
                {"type": "image"},     # no image bytes here
            ],
        },
        {
            "role": "assistant",
            "content": [
                {"type": "text", "text": FRACTURE_CLASSES[example["label"]]},
            ],
        },
    ]
    example["messages"] = conversation
    return example


formatted_data = data["train"].map(convert_to_conversation)
formatted_data["messages"][0]
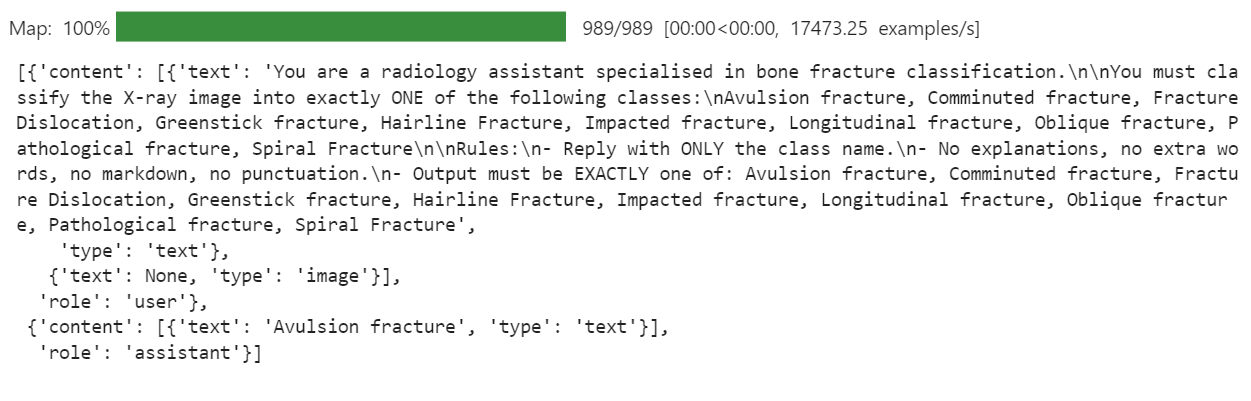
Ini membuat kolom messages di mana setiap rekaman kini berisi percakapan mini yang lengkap: instruksi ditambah kelas fraktur yang benar. Inilah tepatnya yang akan dilihat model visi-bahasa selama fine-tuning.
Sekarang kita memuat versi BF16 dari model Ministral-3 14B Instruct dari Hugging Face Hub, bersama dengan processor. Processor menggabungkan tokenizer dan pipeline prapemrosesan gambar, yang diperlukan untuk masukan visi-bahasa.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "mistralai/Ministral-3-14B-Instruct-2512-BF16"


model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"Template chat asli yang disediakan Mistral AI dirancang untuk kasus penggunaan percakapan panjang. Untuk proyek ini, itu menjadi masalah. Model mulai fokus pada instruksi peran yang panjang dan teks sistem, dan mengabaikan tujuan sebenarnya, yaitu memprediksi satu kelas patah tulang dari X-ray.
Untuk memperbaikinya, kita mendefinisikan template visi-bahasa yang lebih pendek yang hanya mempertahankan bagian penting: instruksi pengguna dan jawaban asisten. Ini mengurangi noise dan membantu model mempelajari pemetaan yang bersih dari gambar ke label kelas.
SHORT_VLM_TEMPLATE = r"""{{ bos_token }}[INST]
{% for message in messages if message['role'] == 'user' -%}
  {%- for content in message['content'] -%}
    {%- if content['type'] == 'text' -%}
{{ content['text'] }}

    {%- elif content['type'] == 'image' -%}
[IMG]
    {%- endif -%}
  {%- endfor -%}
{%- endfor -%}
[/INST]{% if not add_generation_prompt %}
  {%- for message in messages if message['role'] == 'assistant' -%}
{{ message['content'][0]['text'] }}{{ eos_token }}
  {%- endfor -%}
{%- endif %}"""


# Attach to processor / tokenizer
processor.chat_template = SHORT_VLM_TEMPLATE
processor.tokenizer.chat_template = SHORT_VLM_TEMPLATESebelum kita mulai fine-tuning, ada baiknya menguji model Ministral 3 14B Instruct asli untuk membuat baseline.
Pertama, kita berikan model sebuah gambar acak dari dataset dan ajukan pertanyaan umum, untuk melihat bagaimana ia memahami isi X-ray.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": "What is the image about?"},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 1000,
                   use_cache = True, temperature = 1.5, min_p = 0.1)
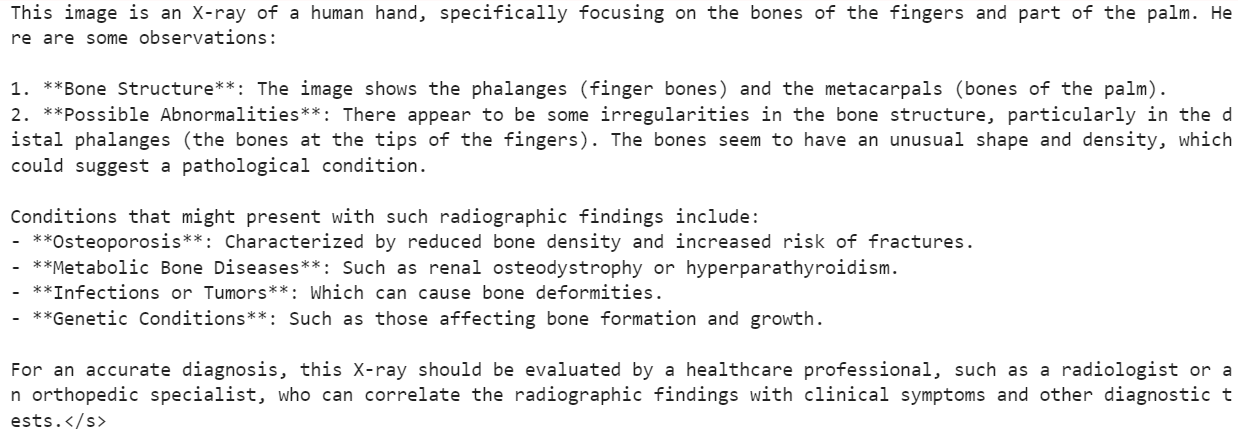
Hasilnya, model memahami isi umum X-ray, tetapi kemudian beralih ke deskripsi yang tidak andal untuk penggunaan medis.
Selanjutnya, kita mencoba sesuatu yang lebih dekat dengan tujuan akhir. Kita berikan gambar yang sama, tetapi kali ini kita gunakan prompt klasifikasi fraktur yang ketat alih-alih pertanyaan terbuka.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 1000,
                   use_cache = True, temperature = 1.5, min_p = 0.1
Untuk sampel ini, model merespons dengan:
Hairline Fracture</s>Sekarang kita periksa label ground truth aktual untuk gambar yang sama.
FRACTURE_CLASSES[formatted_data[200]["label"]]Ini mengembalikan:
'Comminuted fracture'Jadi, model mengikuti format instruksi dengan benar dan menghasilkan satu nama kelas, tetapi klasifikasinya salah.
Inilah alasan kita memerlukan fine-tuning. Model dasar memiliki pemahaman visi yang kuat, tetapi belum dilatih secara khusus untuk membedakan tipe patah tulang yang detail.
Pada langkah berikutnya, kita akan melakukan fine-tune pada dataset fraktur kita untuk meningkatkan perilaku tersebut.
Selanjutnya, kita menyiapkan LoRA untuk melakukan fine-tune model Ministral 3 secara efisien tanpa memperbarui semua parameter. Konfigurasi ini menargetkan lapisan atensi utama dan proyeksi MLP yang digunakan dalam model visi-bahasa gaya Mistral.
from peft import LoraConfig, TaskType, get_peft_model

# LoRA config for a Mistral-style VLM used as a causal LM
peft_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    modules_to_save=None,
)
Selanjutnya, kita mendefinisikan argumen pelatihan supervised fine-tuning (SFT).
Konfigurasi ini mengontrol seluruh proses pelatihan, termasuk bagaimana batch ditangani, optimasi memori, perilaku laju pembelajaran, logging, strategi penyimpanan, dan integrasi dengan Hugging Face Hub.
from trl import SFTConfig

args = SFTConfig(
    output_dir="ministral-3-bone-fracture",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    per_device_eval_batch_size=2,
    gradient_accumulation_steps=4,
    gradient_checkpointing=True,
    optim="adamw_8bit",
    logging_steps=0.1,
    save_strategy="epoch",
    learning_rate=2e-4,
    bf16=True,
    fp16=False,
    max_grad_norm=0.3,
    warmup_steps=25,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)Untuk melakukan fine-tune model visi-bahasa seperti Ministral 3, kita memerlukan data collator kustom yang dapat melakukan batch gambar dan teks bergaya chat bersama dalam format yang konsisten.
Collator di bawah ini menangani: penyiapan tokenizer dan pad token, penerapan template chat, tokenisasi teks dan gambar secara bersama, penerapan batas panjang urutan yang aman, serta pembuatan label di mana padding dan token gambar dimask (-100) sehingga tidak memengaruhi loss.
from typing import Any, Dict, List
import torch

# --- One-time processor setup ---
tokenizer = processor.tokenizer
tokenizer.padding_side = "right"

# Ensure we have a pad token
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({"pad_token": tokenizer.eos_token})

pad_token_id = tokenizer.pad_token_id
image_token_id = getattr(processor, "image_token_id", None)

# Hard cap for sequence length
MAX_SEQ_LEN = 2048


def collate_fn(examples: List[Dict[str, Any]]) -> Dict[str, torch.Tensor]:
    """
    Collate function for VLM fine-tuning.

    Each example must contain:
      - "image": a PIL image
      - "messages": chat-style conversation (list[dict])
    """
    images = [ex["image"] for ex in examples]
    conversations = [ex["messages"] for ex in examples]

    # Build chat prompts for the whole batch
    chat_texts = processor.apply_chat_template(
        conversations,
        add_generation_prompt=False,
        tokenize=False,
    )

    # Tokenize + process images
    batch = processor(
        text=chat_texts,
        images=images,
        padding="longest",
        truncation=True,
        max_length=MAX_SEQ_LEN,
        return_tensors="pt",
    )

    # Labels: same as input_ids but mask pad & image tokens
    labels = batch["input_ids"].clone()

    if pad_token_id is not None:
        labels[labels == pad_token_id] = -100

    if image_token_id is not None and image_token_id != pad_token_id:
        labels[labels == image_token_id] = -100

    batch["labels"] = labels
return batchDengan adaptor LoRA, konfigurasi pelatihan, dan data collator siap, kini kita dapat menyambungkan semuanya ke SFTTrainer milik trl.
Trainer ini menangani seluruh loop supervised fine-tuning untuk model visi-bahasa Ministral 3 kita, menggunakan dataset yang telah diformat, konfigurasi LoRA, dan fungsi collate kustom untuk batch gambar–teks.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data,
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)
Jalankan kode di bawah ini untuk memulai proses pelatihan.
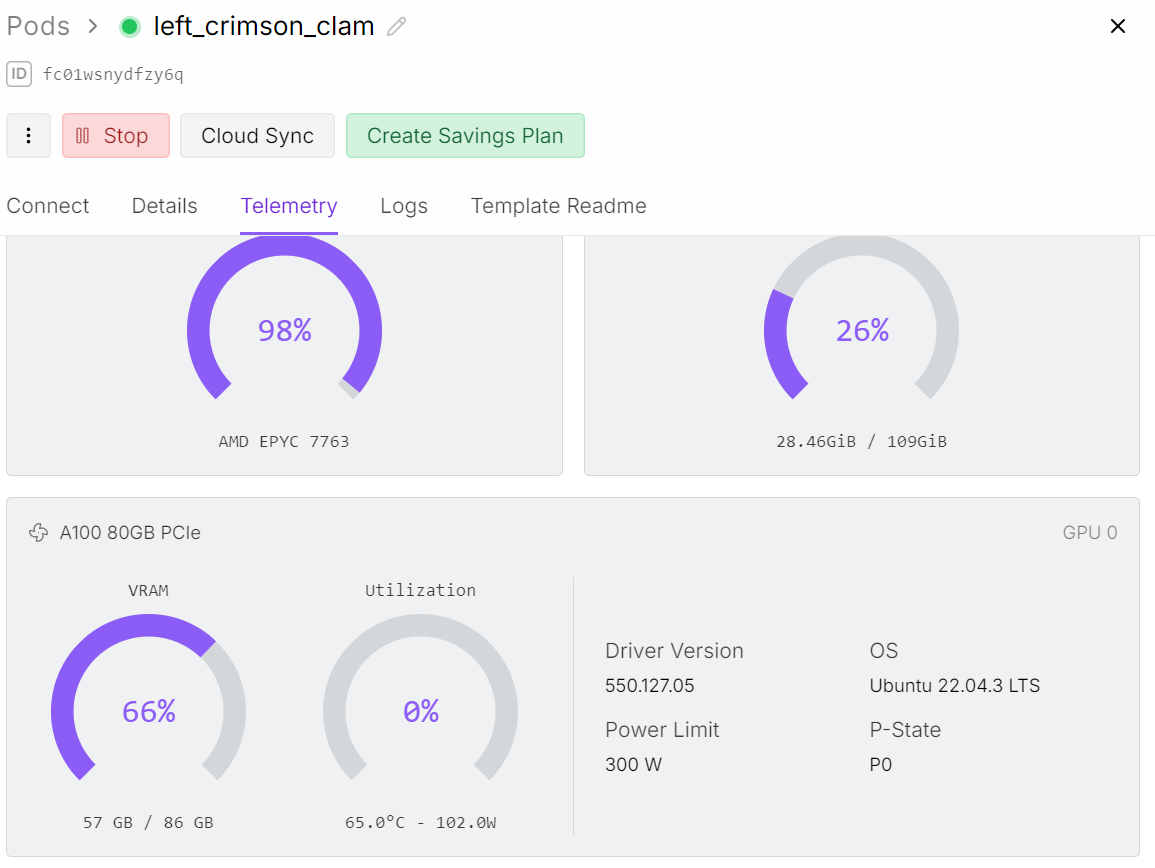
trainer.train()Selama saya menjalankan, fine-tuning menggunakan sekitar 57 GB VRAM, dan sedikit lebih banyak selama langkah evaluasi yang berjalan setiap beberapa iterasi. Dalam praktiknya, ini berarti Anda dapat melakukan fine-tune pengaturan ini dengan nyaman pada perangkat keras dengan VRAM di bawah 70 GB.
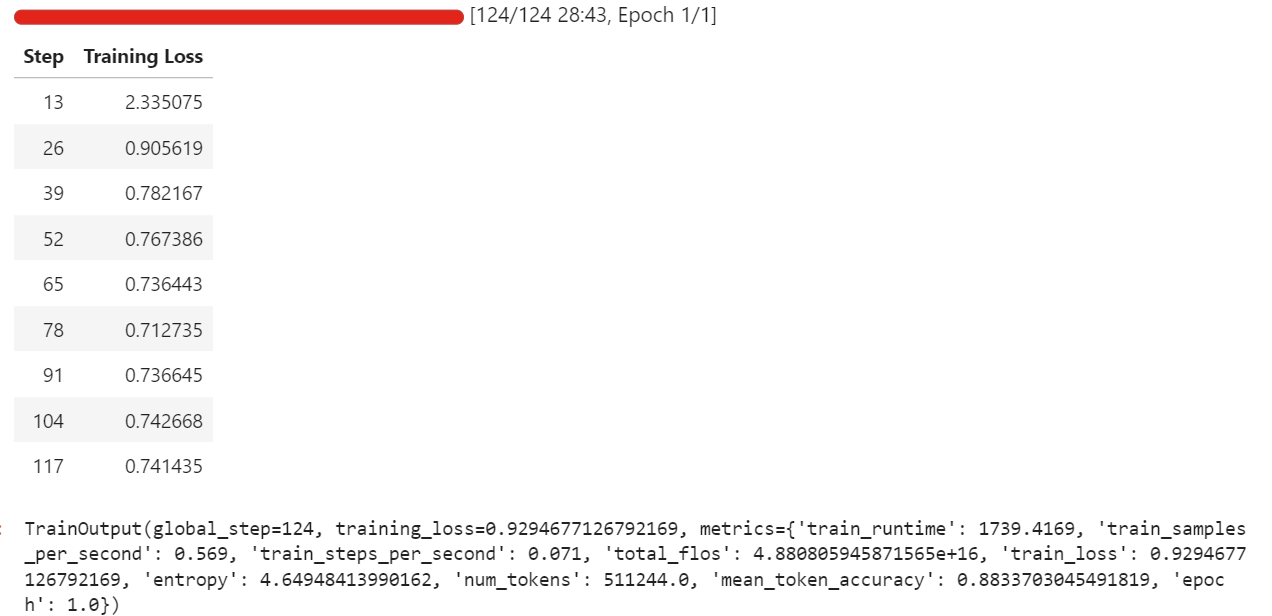
Pelatihan penuh memakan waktu sekitar setengah jam, dan training loss menurun secara bertahap dari waktu ke waktu, yang merupakan tanda baik bahwa model belajar dari dataset.
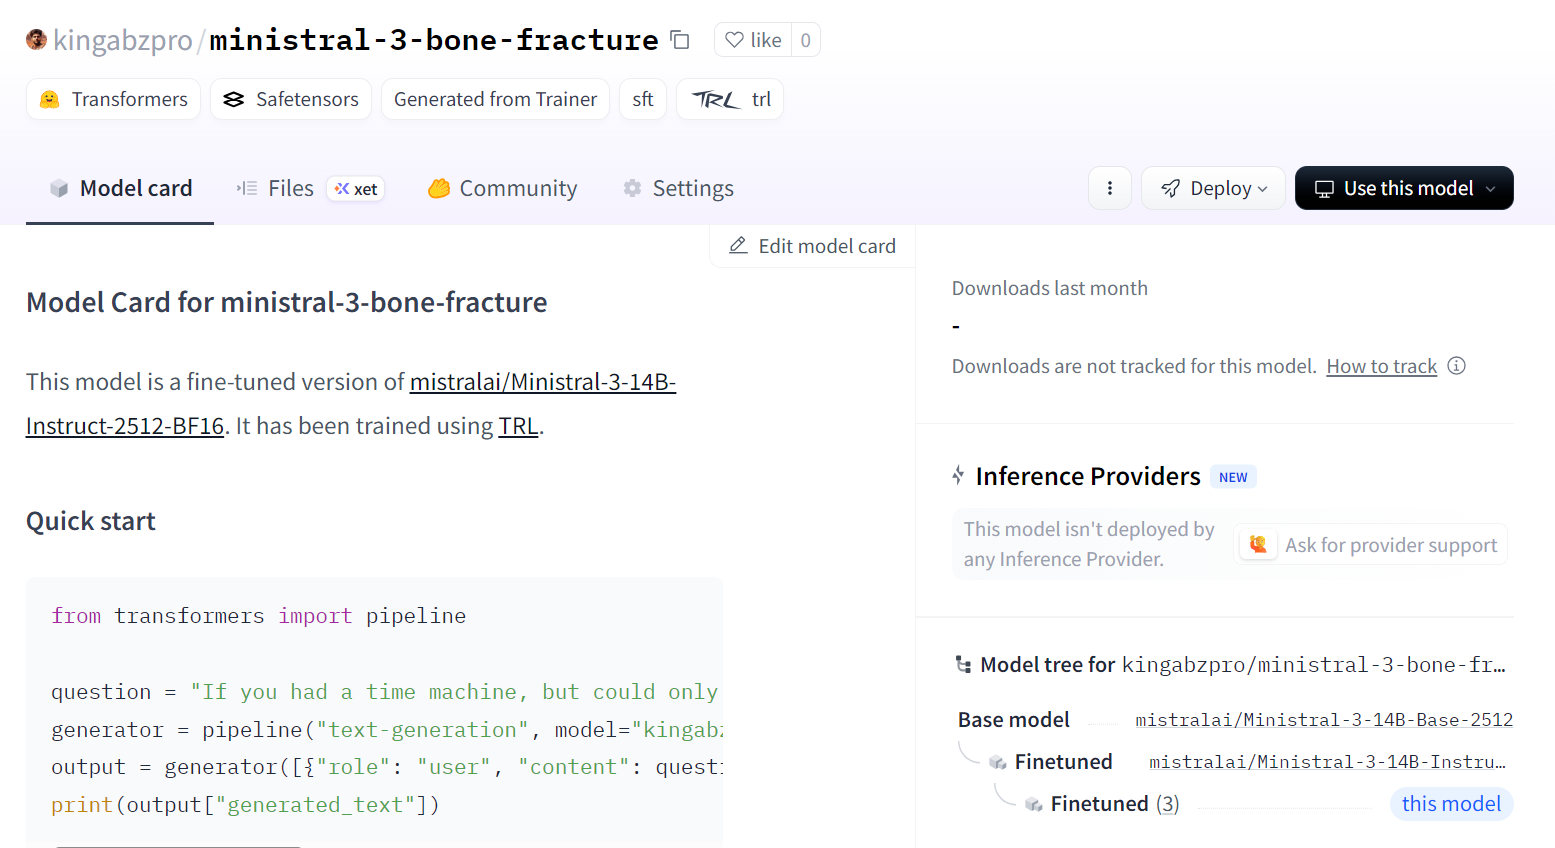
Setelah pelatihan selesai, kita menyimpan model yang telah diadaptasi ke Hugging Face Hub. Ini akan membuat repositori baru dan mendorong semua berkas yang diperlukan sehingga Anda dapat memuat ulang dan menjalankan model yang telah di-fine-tune dari lingkungan mana pun.
trainer.save_model()Anda dapat melihat modelnya di kingabzpro/ministral-3-bone-fracture.
Sekarang kita memuat model dan processor yang telah di-fine-tune dari Hugging Face Hub. Di balik layar, ini akan mengunduh adaptor LoRA yang disimpan, memuat checkpoint Ministral 3 dasar, dan menggabungkan adaptor ke model dasar sehingga siap untuk inferensi.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "kingabzpro/ministral-3-bone-fracture"


model_kwargs = dict(
    attn_implementation="eager",
    dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

processor.tokenizer.padding_side = "left"
Untuk menjaga perbandingan tetap adil, kita terlebih dahulu menggunakan kembali gambar yang sama yang diuji sebelum fine-tuning (indeks 200) dan menjalankannya melalui pipeline inferensi dengan prompt klasifikasi ketat kita.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 100)
Kita memperoleh hasil sempurna. Tidak diperlukan pascapemrosesan tambahan. Model mengikuti aturan prompt dan langsung menghasilkan kelas yang benar.
Comminuted fracture</s>Selanjutnya, kita coba sampel acak lain dari dataset untuk mengonfirmasi bahwa perilaku ini tidak terbatas pada satu contoh.
image = formatted_data[400]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 100)
Keluaran model:
Greenstick fracture</s>Ground truth:
FRACTURE_CLASSES[formatted_data[400]["label"]]Output:
'Greenstick fracture'Sekali lagi, prediksinya benar dan sepenuhnya selaras dengan label.
Dengan pemeriksaan ini, kita dapat mengatakan bahwa model Ministral 3 14B kita telah berhasil di-fine-tune pada dataset X-ray patah tulang dan kini mampu mengikuti prompt instruksi serta menghasilkan prediksi satu kelas yang akurat untuk contoh-contoh ini.
Melakukan fine-tune model Ministral 3 memerlukan kesabaran dan penyesuaian bertahap. Saya benar-benar membutuhkan dua hari penuh untuk memahami mengapa model tidak berlatih seperti yang saya harapkan dan mengapa, meskipun modelnya relatif kecil, ia tetap mendorong GPU saya ke error kehabisan memori.
Alasan utamanya sederhana, tetapi mudah terlewat. Ini bukan sekadar model bahasa. Ini adalah model visi-bahasa, yang berarti ia memiliki image encoder yang menambah penggunaan memori.
Resolusi gambar yang lebih besar secara langsung menyebabkan konsumsi VRAM yang lebih tinggi. Mengurangi ukuran gambar atau memulai dengan batch yang lebih kecil membuat proses pelatihan jauh lebih stabil.
Masalah lain yang saya temui adalah menggunakan template chat default. Template itu terlalu panjang dan terstruktur untuk jenis tugas ini. Model menghabiskan lebih banyak upaya untuk menyesuaikan format template alih-alih belajar membaca gambar dan menghasilkan klasifikasi fraktur yang jelas.
Setelah saya menyederhanakan prompt menjadi format instruksi langsung, model akhirnya mulai merespons masukan visual dengan benar alih-alih membentuk setiap jawaban seperti respons chat lengkap.
Saya juga berasumsi bahwa karena model memiliki kemampuan visi yang kuat, ia akan secara alami berkinerja baik pada pemindaian medis. Asumsi itu memperlambat saya. Menyebutnya “MedGemma” dalam benak saya tidak adil bagi model maupun prosesnya. Ini bukan model medis khusus sejak awal, dan mengharapkannya berperilaku seperti itu tanpa pelatihan yang tepat adalah kesalahan saya.
Pada akhirnya, saya berhasil melewati tiap kendala dan mengubah apa yang saya pelajari menjadi panduan ini. Tujuannya adalah membantu Anda menghindari kebingungan yang sama dan mencapai hasil yang bermakna lebih cepat.
“Dengan gambar yang lebih kecil, prompt yang lebih sederhana, dan ekspektasi yang realistis, Ministral 3 dapat di-fine-tune untuk pemahaman X-ray dengan cara yang jauh lebih mulus dan andal.”
Jika Anda ingin lebih banyak latihan langsung dengan fine-tuning, saya merekomendasikan kursus Fine-Tuning with Llama 3.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt




