
Kursus
Pengantar Model Claude
3 jam
14.7K
Mistral Large 3 adalah model MoE multimodal yang dibangun untuk membaca, menalar, dan menstrukturkan informasi dari dokumen visual yang kompleks. Alih-alih memperlakukan bagan dan PDF sebagai gambar statis, model ini dirancang untuk mengekstrak tabel, insight, dan menghasilkan narasi yang rapi darinya.
Dalam tutorial ini, kita akan menggunakan model Mistral Large 3 (mistral-large-2512) untuk membangun Pusat Evaluasi Kecerdasan Multimodal di Streamlit. Alurnya seperti ini:
Semua ini dilakukan dengan satu model (mistral-large-2512), satu endpoint (/v1/chat/completions), dan JSON Schema yang ketat untuk menjaga keluaran tetap terstruktur dan andal.
Saya merekomendasikan membaca artikel tentang Mistral 3 kami, yang memperkenalkan fitur utama dari model-model terbaru. Anda juga dapat mempelajari tentang fine-tuning Ministral 3 di tutorial terpisah.
Mistral Large 3 adalah arsitektur sparse mixture-of-experts (MOE) dengan 41B parameter aktif dari total 675B dan vision encoder 2,5B parameter untuk pemahaman gambar.
Berikut beberapa properti kunci yang relevan dengan model ini:
Kartu model dan dokumentasi ekosistem juga menyebutkan beberapa catatan penting:
Di bagian ini, kita akan membangun Pusat Evaluasi Kecerdasan Multimodal menggunakan Mistral Large 3 yang dibungkus dalam aplikasi Streamlit. Secara garis besar, berikut yang dilakukan aplikasi final:
mistral-large-2512, yang menggunakan response_format dalam mode JSON Schema untuk memperoleh payload JSON terstruktur.Ini mengubah laporan visual statis menjadi asisten intelijen interaktif yang sepenuhnya didukung oleh Mistral Large 3.
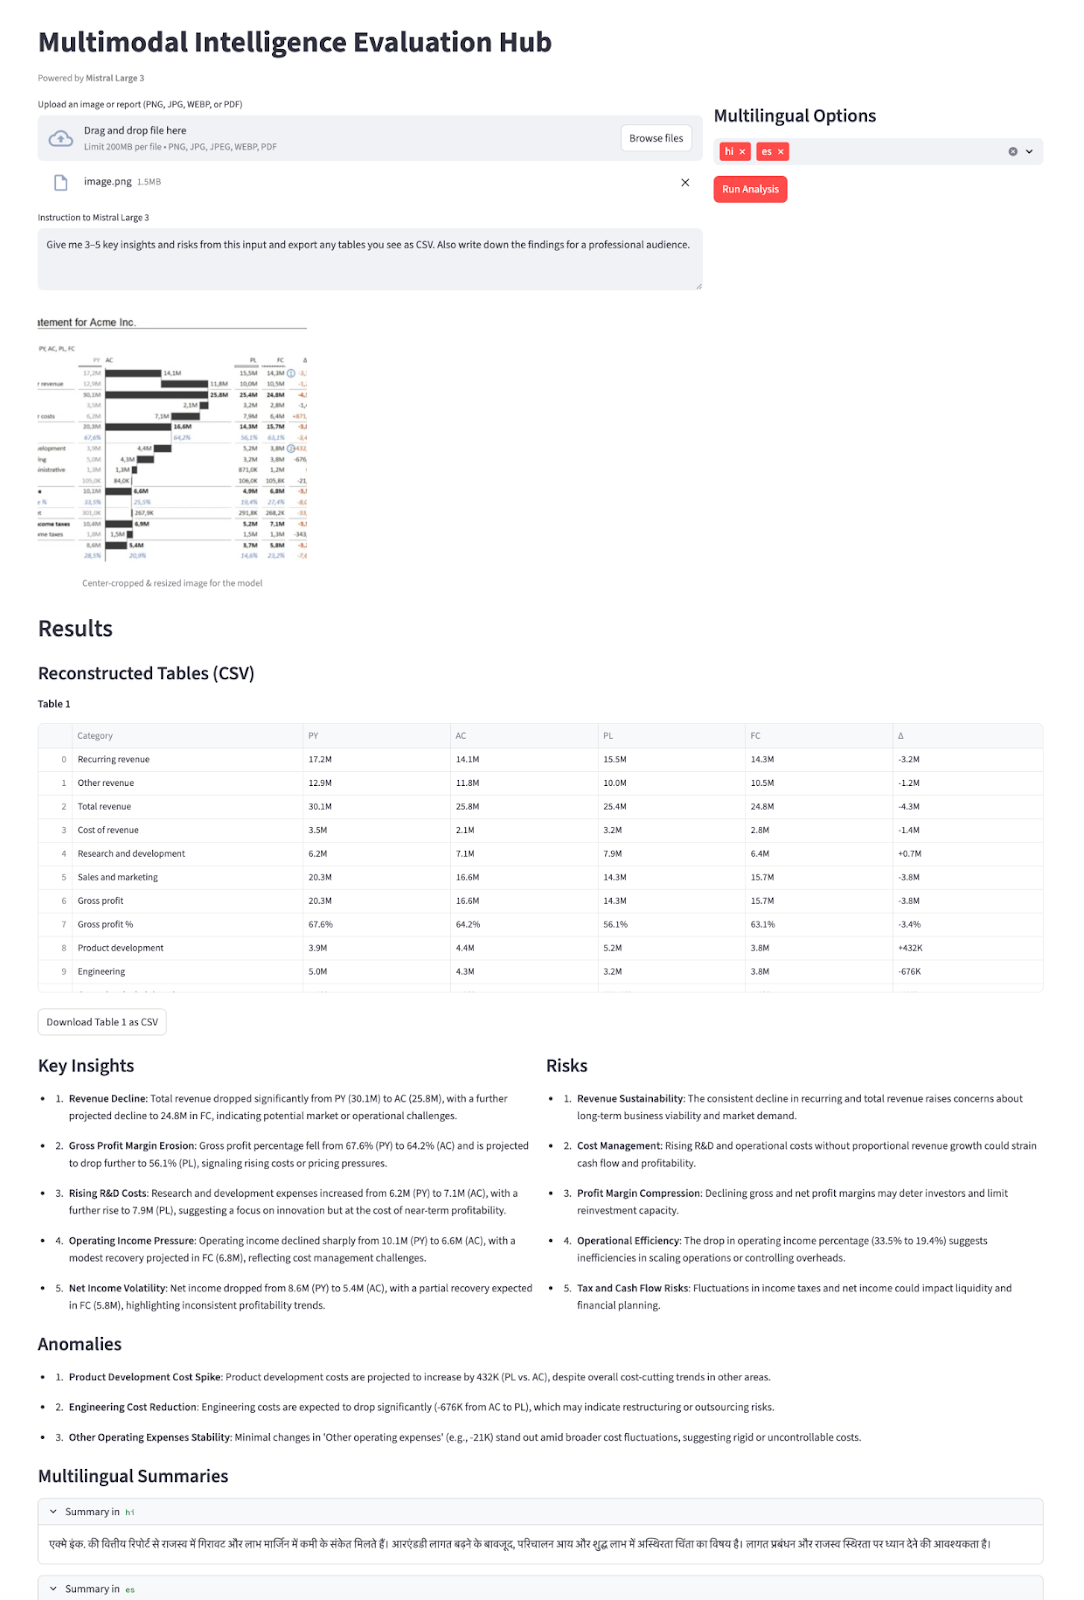
Mari kita bangun selangkah demi selangkah.
Sebelum kita membangun demo Streamlit di atas Mistral Large 3, kita memerlukan lingkungan lokal dasar untuk berkomunikasi dengan model melalui Mistral API. Mulailah dengan memasang beberapa pustaka pembantu untuk menangani UI, dokumen, dan konfigurasi.
pip install streamlit mistralai pillow pdf2image pandas python-dotenvKita akan menggunakan pustaka inti di atas seperti streamlit untuk UI aplikasi web interaktif, mistralai untuk berkomunikasi dengan Mistral API, pillow dan pdf2image untuk membuka dan mengonversi PDF ke gambar, pandas untuk menangani data tabular atau log, dan python-dotenv untuk memuat variabel lingkungan seperti MISTRAL_API_KEY dari berkas .env secara aman.
Selanjutnya, masuk ke Mistral AI Platform dan buka tab API Keys .
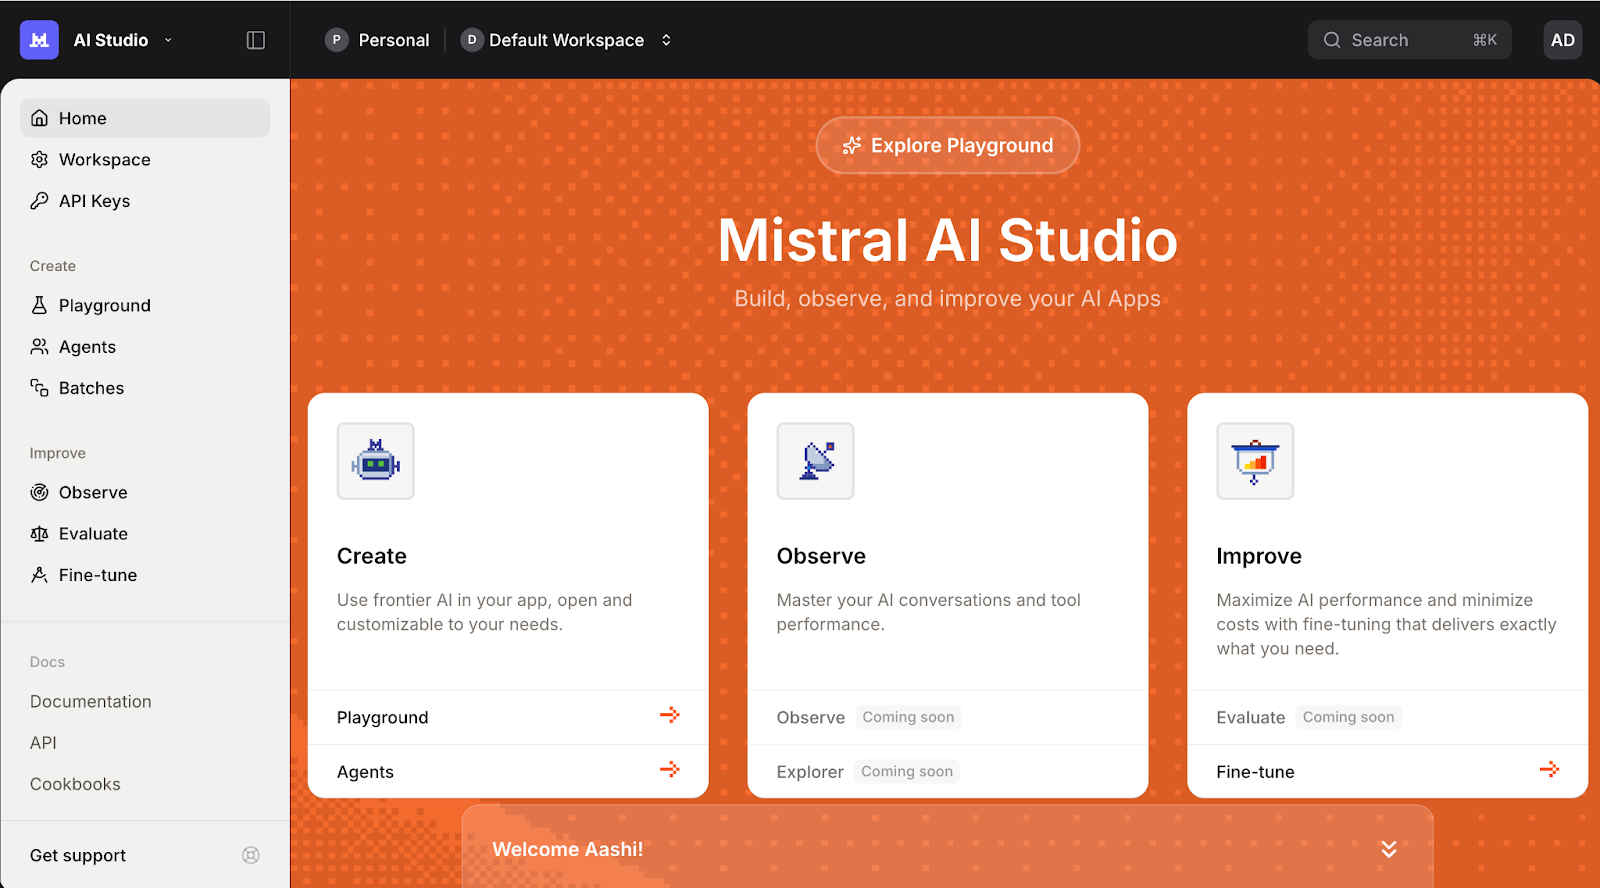
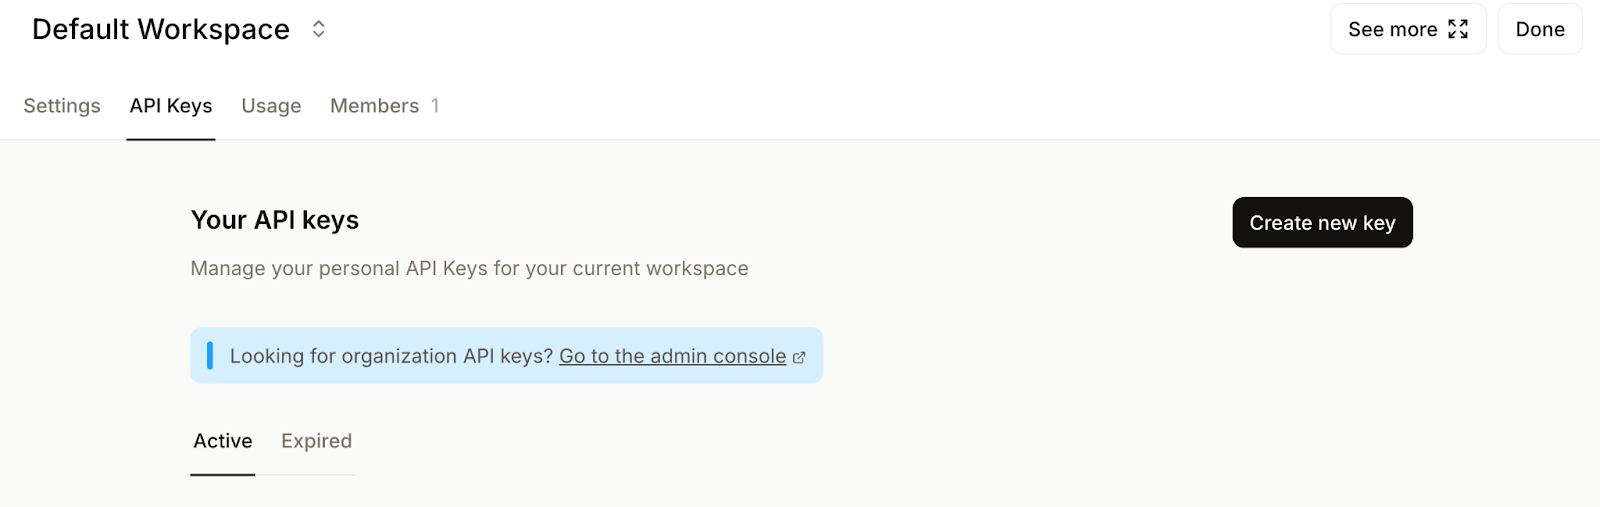
Atur ruang kerja default Anda (jika diminta) dan klik Create new key.
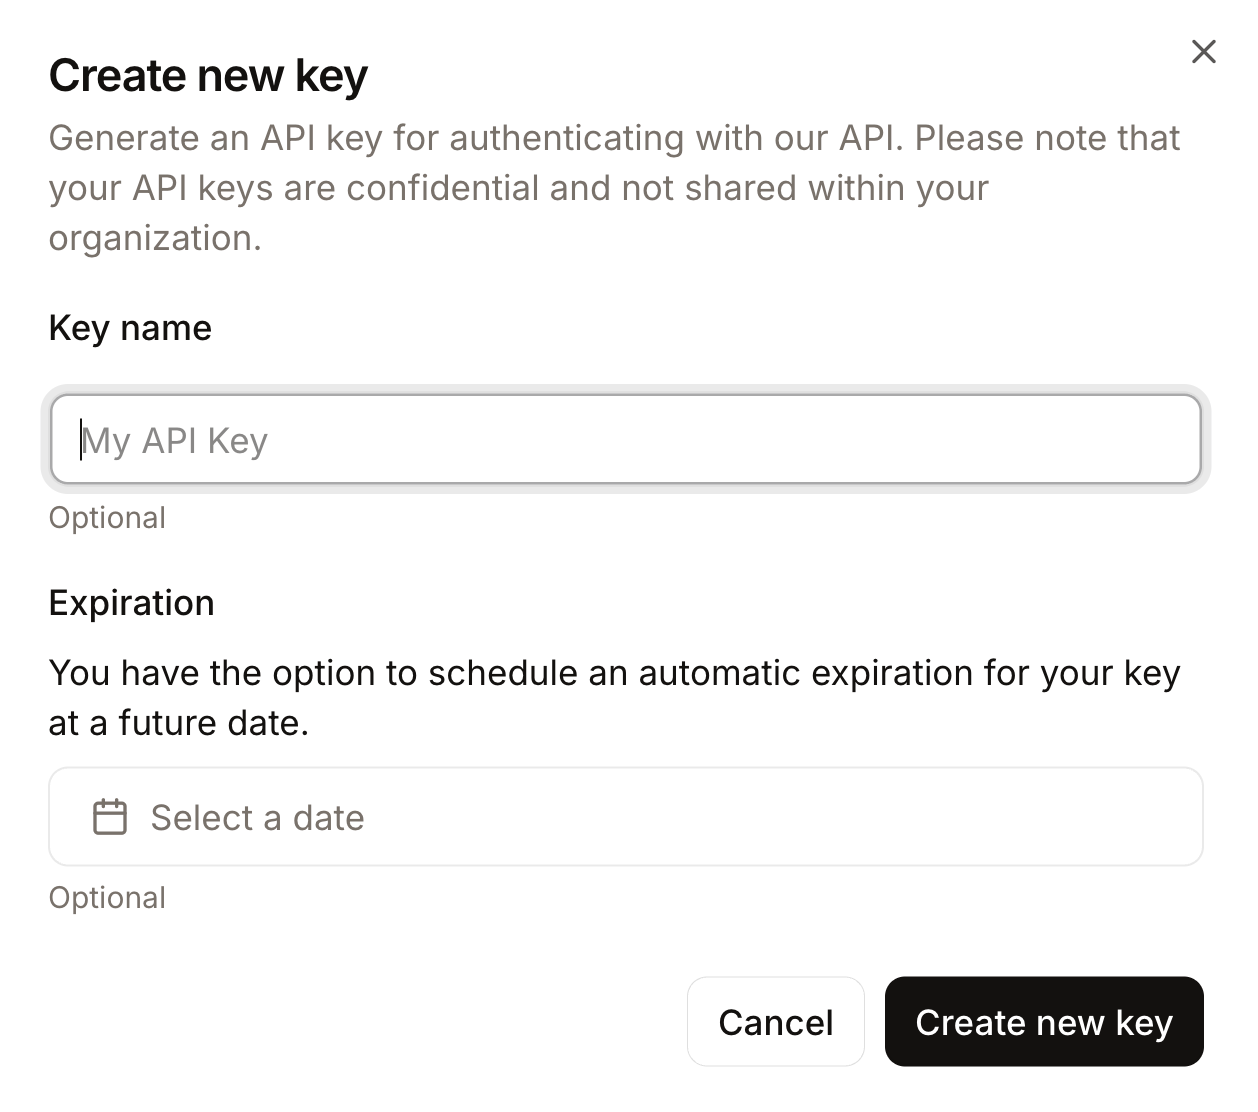
Beri nama kunci Anda yang bermakna dan opsional tetapkan tanggal kedaluwarsa.
Terakhir, salin kunci yang dihasilkan dan ekspor sebagai variabel lingkungan sebagai berikut:
export MISTRAL_API_KEY="your_mistral_api_key_here"Pada titik ini, lingkungan kita siap untuk diautentikasi dengan Mistral API.
Dengan lingkungan telah dikonfigurasi dan dependensi terpasang, langkah selanjutnya adalah menginisialisasi klien Mistral yang akan menangani semua panggilan kita ke model Mistral Large 3. Ini memberi kita titik masuk untuk mengirim prompt dari aplikasi Streamlit ke Mistral Large 3.
MISTRAL_API_KEY = os.getenv("MISTRAL_API_KEY")
MODEL_ID = "mistral-large-2512"
if MISTRAL_API_KEY is None:
    raise RuntimeError("Please set the MISTRAL_API_KEY environment variable.")
client = MistralClient(api_key=MISTRAL_API_KEY)
Blok kode di atas melakukan tiga hal:
MISTRAL_API_KEY dari lingkungan dan menyimpan nama model di MODEL_ID, sehingga bisa digunakan ulang di seluruh aplikasi.MistralClient menggunakan SDK resmi mistralai, yang akan kita gunakan untuk setiap permintaan berikutnya ke model.Dengan klien terinisialisasi, selanjutnya kita akan membangun beberapa fungsi pembantu yang mengirim prompt dan menangani respons dalam UI Streamlit.
Sebelum kita mengirim gambar atau PDF ke Mistral Large 3, kita perlu membuatnya ramah model. Vision API bekerja paling baik ketika input berbentuk persegi, berukuran wajar, dan dienkode dalam format yang konsisten.
Kita mulai dengan memuat gambar yang diunggah dan mengonversinya menjadi crop persegi.
def load_image_from_upload(uploaded_file) -> Image.Image:
    return Image.open(io.BytesIO(uploaded_file.read())).convert("RGB")
def center_crop_to_square(img: Image.Image) -> Image.Image:
    width, height = img.size
    if width == height:
        return img
    if width > height:
        offset = (width - height) // 2
        box = (offset, 0, offset + height, height)
    else:
        offset = (height - width) // 2
        box = (0, offset, width, offset + width)
    return img.crop(box)
Blok kode di atas memastikan bahwa bagan atau tabel yang kita unggah diubah menjadi crop persegi sebelum dikirim ke model, selaras dengan panduan visi Mistral.
Selanjutnya, kita mengubah ukuran gambar ke ukuran maksimum (1024×1024) untuk menyeimbangkan kualitas, latensi, dan biaya token.
def resize_for_vlm(img: Image.Image, max_size: int = 1024) -> Image.Image:
    width, height = img.size
    scale = min(max_size / width, max_size / height, 1.0)
    if scale == 1.0:
        return img
    new_w = int(width * scale)
    new_h = int(height * scale)
    return img.resize((new_w, new_h), Image.LANCZOS)
Di sini, kita menghitung faktor scale yang menjaga kedua dimensi tetap di bawah max_size sambil mempertahankan rasio aspek. Jika gambar sudah cukup kecil, kita kembalikan apa adanya. Jika tidak, kita hitung dimensi baru dan gunakan penyampelan ulang LANCZOS untuk pengecilan berkualitas tinggi.
Langkah ini memastikan gambar tidak membengkakkan jendela konteks Anda atau memperlambat respons secara tidak perlu.
Untuk PDF, kita sering ingin menampilkan lebih dari satu halaman kepada model. Trik sederhana adalah merender semua halaman dan menumpuknya secara vertikal menjadi satu gambar tinggi.
def stack_images_vertically(images: List[Image.Image]) -> Image.Image:
    if not images:
        raise ValueError("No images to stack")
    target_width = images[0].size[0]
    resized_images = []
    for img in images:
        if img.size[0] != target_width:
            aspect_ratio = img.size[1] / img.size[0]
            new_height = int(target_width * aspect_ratio)
            img = img.resize((target_width, new_height), Image.LANCZOS)
        resized_images.append(img)
    total_height = sum(img.size[1] for img in resized_images)
    stacked = Image.new('RGB', (target_width, total_height))
    y_offset = 0
    for img in resized_images:
        stacked.paste(img, (0, y_offset))
        y_offset += img.size[1]
    return stacked
def uploaded_file_to_square_base64(uploaded_file) -> Tuple[str, str]:
    mime_type = uploaded_file.type
    raw_bytes = uploaded_file.getvalue()
    if mime_type == "application/pdf":
        pages = convert_from_bytes(raw_bytes)
        pages_rgb = [page.convert("RGB") for page in pages]
        img = stack_images_vertically(pages_rgb)
        img = resize_for_vlm(img, max_size=1024)
        mime_type = "image/png"
    else:
        img = Image.open(io.BytesIO(raw_bytes)).convert("RGB")
        img = center_crop_to_square(img)
        img = resize_for_vlm(img, max_size=1024)
    return mime_type, image_to_base64_data_url(img, mime_type=mime_type)
Fungsi stack_images_vertically() menerima daftar gambar PIL, menormalkannya ke lebar umum sambil mempertahankan rasio aspek, menghitung total tinggi, dan menempelkannya satu per satu ke kanvas RGB tunggal. Sementara fungsi uploaded_file_to_square_base64() kemudian memutuskan tindakan berdasarkan tipe MIME:
Pada kedua kasus, fungsi mengembalikan gambar yang telah dinormalisasi beserta tipe MIME untuk langkah pengenkodean akhir.
Vision API Mistral menerima gambar sebagai objek image_url, yang bisa berupa URL aktual atau URL data:.
def image_to_base64_data_url(img: Image.Image, mime_type: str = "image/png") -> str:
    buffer = io.BytesIO()
    if mime_type == "image/jpeg":
        img.save(buffer, format="JPEG", quality=90)
    else:
        img.save(buffer, format="PNG")
        mime_type = "image/png"
    b64 = base64.b64encode(buffer.getvalue()).decode("utf-8")
    return f"data:{mime_type};base64,{b64}"
Kita mulai dengan menulis gambar ke buffer dalam memori dan memilih format yang sesuai (seperti JPEG atau PNG), sebelum akhirnya mengenkripsi byte ke base64.
Terakhir, kita bungkus string yang dienkode ke dalam URL data:{mime_type};base64 yang dapat langsung diteruskan ke Vision API Mistral sebagai image_url.
Pada akhir langkah ini, setiap berkas yang diunggah, baik PNG tunggal, dasbor lebar, atau PDF multi-halaman, melewati pipeline yang sama: center-crop, ubah ukuran, penumpukan PDF, dan konversi data URL base64.
Pada langkah ini, kita membungkus semuanya ke dalam satu fungsi pembantu yang mengirim permintaan visi plus teks dan memaksa model merespons dalam format JSON. Kita melakukan ini dengan menggabungkan:
response_format sehingga keluarannya terstruktur dan mudah diurai.def call_mistral_large_multimodal(
mime_type: str,
image_data_url: str,
user_instruction: str,
languages: List[str],
) -> Dict[str, Any]:
json_schema = {
"type": "object",
"properties": {
"csv_tables": {
"type": "array",
"items": {"type": "string"},
"description": "Each item is a CSV string representing one table found in the image."
},
"insights": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key insights about the content."
},
"risks": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key risks or red flags."
},
"anomalies": {
"type": "array",
"items": {"type": "string"},
"description": "Any anomalies, outliers, or surprising patterns you detect."
},
"translations": {
"type": "object",
"properties": {
lang: {"type": "string"} for lang in languages
},
"description": "Short high-level summaries in the selected languages."
},
},
"required": ["csv_tables", "insights", "risks"],
"additionalProperties": False,
}
system_prompt = (
"You are a Multimodal Intelligence Evaluator using Mistral Large 3.\n"
"You are given a single document-like image (e.g. chart + table, financial report page).\n\n"
"Your tasks:\n"
"1. Read all visible text and numbers directly from the image.\n"
"2. Reconstruct any clearly visible tables into valid CSV strings.\n"
" - Use the first row as headers when possible.\n"
" - Use commas as separators and newline per row.\n"
"3. Derive up to 5 concise INSIGHTS about trends, patterns, or takeaways.\n"
"4. Derive up to 5 concise RISKS or red flags (business, financial, operational, etc.).\n"
"5. Detect any anomalies or surprising patterns if present (else return an empty list).\n"
"6. Provide short summaries in the requested languages.\n\n"
"You MUST respond ONLY with a JSON object that matches the provided JSON schema.\n"
"Do not include any extra commentary outside of the JSON."
)
messages = [
{
"role": "system",
"content": [
{"type": "text", "text": system_prompt},
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": user_instruction or "Analyze this financial report page.",
},
{
"type": "image_url",
"image_url": image_data_url,
},
],
},
]
response = client.chat(
model=MODEL_ID,
messages=messages,
temperature=0.2,
max_tokens=2048,
response_format={
"type": "json_schema",
"json_schema": {
"name": "multimodal_intel_eval",
"schema": json_schema,
"strict": True,
},
},
)
content = response.choices[0].message.content
try:
parsed = json.loads(content)
except json.JSONDecodeError:
try:
start = content.index("{")
end = content.rindex("}") + 1
parsed = json.loads(content[start:end])
except Exception:
raise ValueError(f"Model did not return valid JSON. Raw content:\n{content}")
return parsedFungsi call_mistral_large_multimodal() membentuk mesin inti dari demo kecerdasan multimodal.
csv_tables, insights, risks, anomalies, dan objek translations dengan kunci yang diturunkan dari daftar languages. call_mistral_large_multimodal() kemudian menyusun array pesan dalam format chat dengan menggabungkan instruksi sistem dengan pesan pengguna yang mencakup instruksi teks dan payload image_url. Fungsi memanggil client.chat() dengan MODEL_ID sambil menjaga temperature rendah untuk keluaran deterministik, serta response_format={"type": "json_schema",}, sehingga respons mematuhi skema. Terakhir, kita mencoba mengurainya dengan json.loads.
Dengan ini, Anda kini memiliki titik masuk andal untuk mengubah gambar bagan atau laporan mentah menjadi narasi terstruktur.
Dengan pipeline prapemrosesan dan klien Mistral siap, langkah terakhir adalah membungkus semuanya di dalam antarmuka Streamlit.
st.set_page_config(
    page_title="Multimodal Intelligence Evaluation Hub - Mistral Large 3",
    layout="wide",
)
st.title("Multimodal Intelligence Evaluation Hub")
st.caption("Powered by **Mistral Large 3**")
col_left, col_right = st.columns([2, 1])
with col_left:
    uploaded_file = st.file_uploader(
        "Upload an image or report (PNG, JPG, WEBP, or PDF)",
        type=["png", "jpg", "jpeg", "webp", "pdf"],
    )
    default_prompt = (
        "Give me 3–5 key insights and risks from this input and export any tables you see as CSV "
        "Also write down the findings for a professional audience."
    )
    user_instruction = st.text_area(
        "Instruction to Mistral Large 3",
        value=default_prompt,
        height=120,
    )
with col_right:
    st.subheader("Multilingual Options")
    languages = st.multiselect(
        "Additional summary languages",
        options=["fr", "de", "es", "hi", "zh", "ja"],
        default=["hi"],
        help="Mistral Large 3 supports dozens of languages; these will receive short summaries.",
        label_visibility="collapsed",
    )
    run_button = st.button("Run Analysis", type="primary")
if run_button:
    if uploaded_file is None:
        st.error("Please upload an image or PDF first.")
        st.stop()
    prep_msg = "Preparing PDF (combining all pages)..." if uploaded_file.type == "application/pdf" else "Preparing image..."
    with st.spinner(prep_msg):
        mime_type, data_url = uploaded_file_to_square_base64(uploaded_file)
    mime, b64_part = data_url.split(",", 1)
    img_bytes = base64.b64decode(b64_part)
    st.image(img_bytes, caption="Center-cropped & resized image for the model", width=400)
    with st.spinner("Processing..."):
        try:
            result = call_mistral_large_multimodal(
                mime_type=mime_type,
                image_data_url=data_url,
                user_instruction=user_instruction,
                languages=languages,
            )
        except Exception as e:
            st.error(f"Error calling Mistral Large 3: {e}")
            st.stop()
    st.header("Results")
    csv_tables = result.get("csv_tables", [])
    if csv_tables:
        st.subheader("Reconstructed Tables (CSV)")
        for i, csv_str in enumerate(csv_tables):
            st.markdown(f"**Table {i+1}**")
            try:
                df = pd.read_csv(io.StringIO(csv_str))
                st.dataframe(df, use_container_width=True)
            except Exception:
                st.text_area(f"Raw CSV for Table {i+1}", value=csv_str, height=150)
            st.download_button(
                label=f"Download Table {i+1} as CSV",
                data=csv_str,
                file_name=f"table_{i+1}.csv",
                mime="text/csv",
                key=f"csv_download_{i}",
            )
    else:
        st.info("No tables were detected or reconstructed.")
    insights = result.get("insights", [])
    risks = result.get("risks", [])
    anomalies = result.get("anomalies", [])
    col_ins, col_risk = st.columns(2)
    with col_ins:
        st.subheader("Key Insights")
        if insights:
            for bullet in insights:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit insights returned._")
    with col_risk:
        st.subheader("Risks")
        if risks:
            for bullet in risks:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit risks returned._")
    st.subheader("Anomalies")
    if anomalies:
        for bullet in anomalies:
            st.markdown(f"- {bullet}")
    else:
        st.write("_No anomalies reported._")
    translations = result.get("translations", {}) or {}
    if translations:
        st.subheader(" Multilingual Summaries")
        for lang_code, summary in translations.items():
            with st.expander(f"Summary in {lang_code}"):
                st.write(summary)
    else:
        st.info("No multilingual summaries were requested or returned.")
    # Raw JSON (debug)
    # with st.expander(" Raw JSON (debug)"):
    #     st.json(result)
Kode UI StreamLit di atas melakukan beberapa hal utama:
Metode st.set_page_config membagi tata letak menjadi dua kolom. Sisi kiri menangani input inti (pengunggah berkas dan area teks yang dapat diedit dengan instruksi default). Sebaliknya, sisi kanan menawarkan opsi multibahasa melalui st.multiselect dan tombol utama Run Analysis. Saat tombol diklik, aplikasi memvalidasi bahwa berkas tersedia, sambil mengonversi gambar atau PDF menjadi data URL base64, dan menampilkan gambar pratinjau.
Setelah hasil kembali, tabel CSV yang direkonstruksi dirender sebagai dataframe, bersama dengan insight, risiko, anomali, dan ringkasan multibahasa apa pun. Opsional, kita juga dapat menampilkan tampilan debug (dikomentari) yang memungkinkan kita memeriksa JSON mentah selama pengembangan.
Dengan langkah ini selesai, Anda dapat menyimpan semuanya sebagai app.py dan meluncurkan pengalaman penuh dengan:
streamlit run app.pyDalam video di bawah, Anda dapat melihat versi ringkas dari alur kerja yang berjalan dengan input gambar dan PDF:
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




