
Last chance! 50% off DataCamp Premium
Sale ends in
Ministral 3 is een nieuwe familie van voor edge geoptimaliseerde multimodale modellen in de maten 3B, 8B en 14B, elk beschikbaar als Base-, Instruct- en Reasoning-variant met volledige visuele ondersteuning.
Ontworpen om sterke prestaties op frontrunnerniveau te leveren en toch lichtgewicht genoeg te blijven voor lokale en private deployment, slaat Ministral 3 een brug tussen geavanceerde mogelijkheden en praktische hardwarebeperkingen. Het vlaggenschip, het 14B Instruct-model, past in 24GB VRAM in FP8 en kan zich meten met grotere systemen zoals Mistral Small 3.2 24B. Met een groot 256k contextvenster, robuuste meertalige dekking, native function calling, sterke naleving van systeem-prompts en Apache 2.0 open licensing.
In deze tutorial gaan we het Ministral 3 14B Instruct-model fijnslijpen op een röntgendataset van botbreuken om de vaardigheid te verbeteren om breuken te detecteren en hun categorieën nauwkeurig te classificeren.
Je leert hoe je:
Als je meer wilt leren over de Mistral AI-modellen, raad ik onze gids Mistral 3 en de Mistral 3 Large-tutorial aan.
Disclaimer: deze tutorial demonstreert een technisch fine-tuningproces uitsluitend voor educatieve doeleinden. Het resulterende model is niet bedoeld voor medisch of klinisch gebruik en mag niet worden gebruikt voor diagnose, besluitvorming of patiëntenzorg.
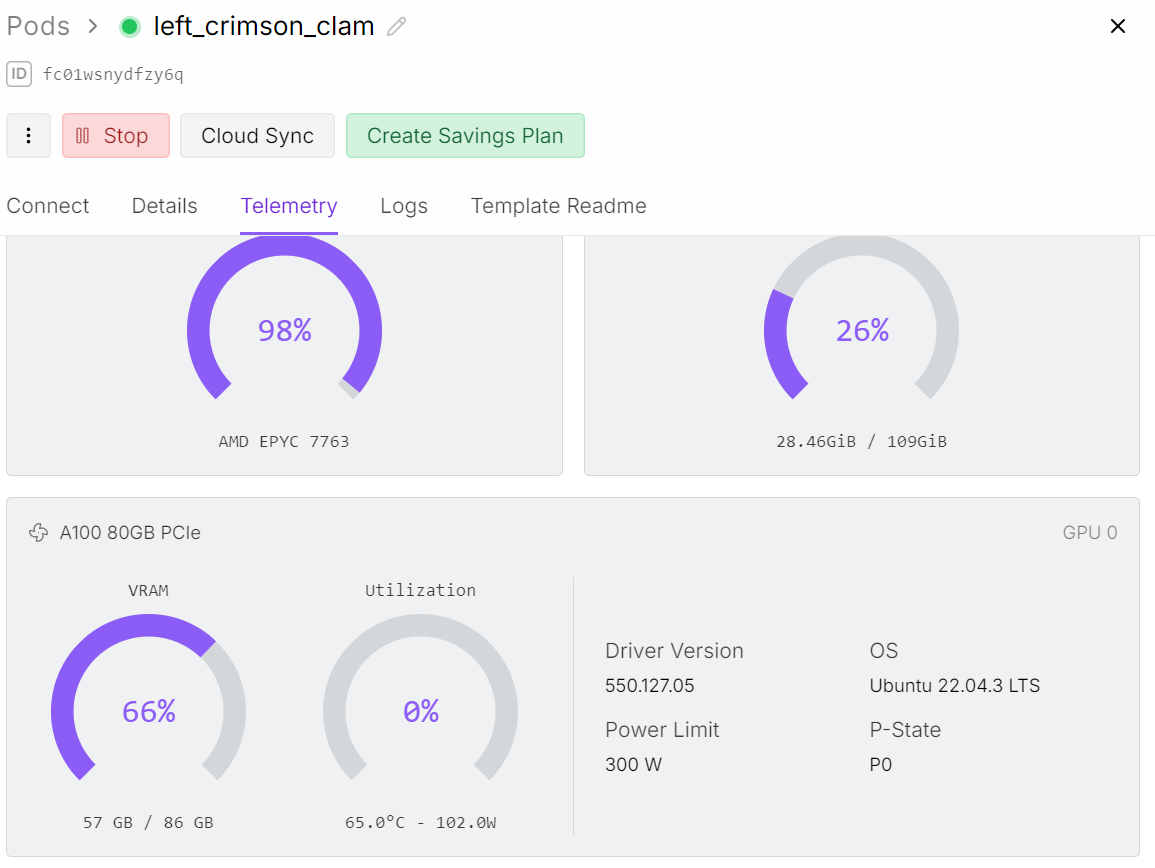
Hoewel we het 14B-model fijnslijpen, vereist visie-taaltraining aanzienlijk meer geheugen dan tekst-only fine-tuning. De beeldencoder verhoogt de GPU-belasting, wat betekent dat we toegang nodig hebben tot een A100-GPU met 80 GB VRAM om dit proces soepel te laten verlopen.
Voor dit project gebruik ik Runpod en start ik een A100-pod.
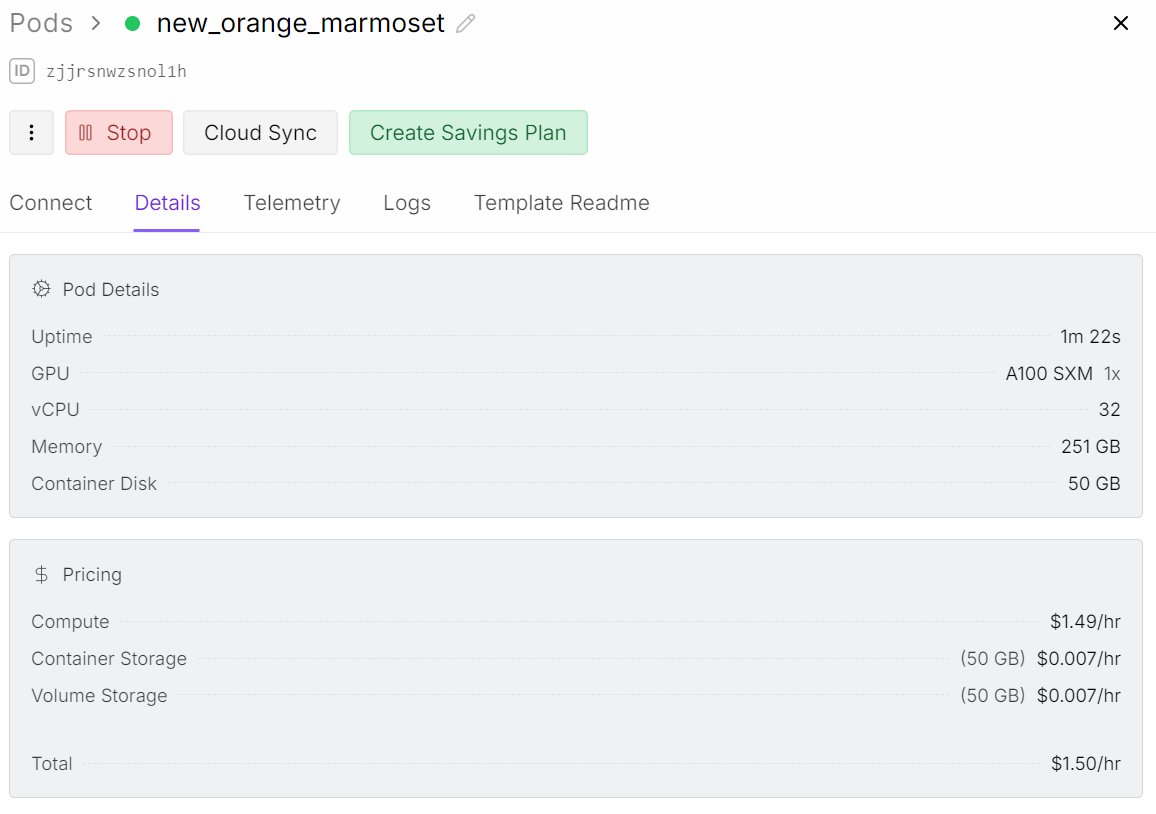
Na het starten van de pod, verhoog je de containeropslag naar 50 GB. Voeg vervolgens de omgevingsvariabelen toe voor zowel de Kaggle- als Hugging Face-API-sleutels.
Met Kaggle kunnen we de röntgendataset van botten direct downloaden, en met Hugging Face kunnen we onze fijnafgestelde LoRA-adapter terug pushen naar de modelhub.
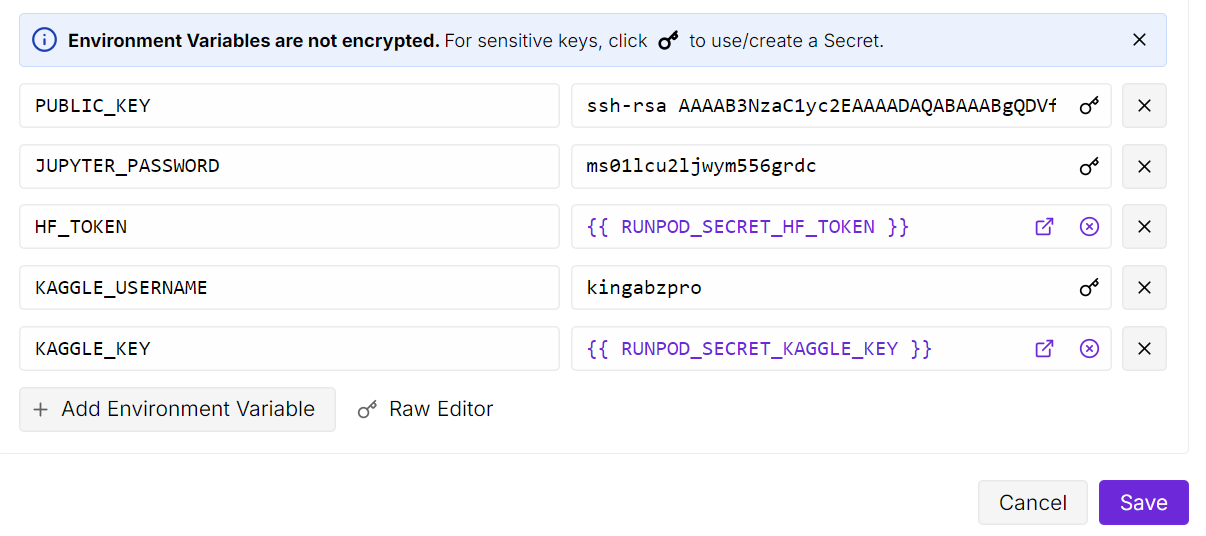
Open daarna de JupyterLab-instantie en maak een nieuw notebook aan. Voor we gaan trainen moeten we alle vereiste Python-pakketten installeren.
Zorg dat de Transformers-bibliotheek is bijgewerkt naar de nieuwste versie, omdat ondersteuning voor Ministral 3 recent is toegevoegd en oudere builds het model niet correct zullen laden.
! pip install --upgrade --quiet bitsandbytes datasets evaluate hf_transfer peft scikit-learn matplotlib Pillow kaggle ipywidgets
!pip install --quiet git+https://github.com/huggingface/transformers.git@bf3f0ae70d0e902efab4b8517fce88f6697636ce
!pip install --quiet --no-deps trl==0.22.2
Zodra alles is geïnstalleerd, kun je de dataset laden, de collator voorbereiden en beginnen met fine-tunen.
In de volgende stap maken we een hoofdmap aan voor onze dataset en gebruiken we de Kaggle Python-API om de Bone Break Classification Image-dataset te downloaden.
Deze dataset bevat verschillende categorieën botbreuken in röntgenformaat en zal worden gebruikt om Ministral 3 te fijnstemmen voor visuele classificatie.
import os
import glob
from kaggle.api.kaggle_api_extended import KaggleApi

DATA_ROOT = "/bone-break"
os.makedirs(DATA_ROOT, exist_ok=True)

kaggle_dataset = "pkdarabi/bone-break-classification-image-dataset"

# Initialize and authenticate Kaggle API (it will read KAGGLE_USERNAME / KAGGLE_KEY)
api = KaggleApi()
api.authenticate()

# Download and unzip the dataset using the Python API
api.dataset_download_files(
    kaggle_dataset,
    path=DATA_ROOT,
    unzip=True,
)
Je kunt de dataset hier op Kaggle bekijken:
Dataset URL: https://www.kaggle.com/datasets/pkdarabi/bone-break-classification-image-datasetDe gedownloade dataset is niet georganiseerd in de gebruikelijke structuur. Elke breukcategorie bevat zowel een trainingsmap als een testmap binnenin.
Dus we hebben eerst een methode nodig om door elke classmap te lopen, de twee splits te scheiden en vervolgens een gecombineerde Hugging Face-dataset te maken met een schone train- en testmapping.
import glob, os
from typing import Any, Dict, List

from datasets import Dataset, DatasetDict, Features, ClassLabel, Image

inner_root = os.path.join(
    DATA_ROOT, "Bone Break Classification", "Bone Break Classification"
)

classes = []
train_records: List[Dict[str, Any]] = []
test_records: List[Dict[str, Any]] = []

for class_name in sorted(os.listdir(inner_root)):
    class_dir = os.path.join(inner_root, class_name)
    if not os.path.isdir(class_dir):
        continue

    classes.append(class_name)

    for split_name, split_key in [("Train", "train"), ("Test", "test")]:
        split_dir = os.path.join(class_dir, split_name)
        if not os.path.isdir(split_dir):
            continue

        for ext in ("*.png", "*.jpg", "*.jpeg"):
            for img_path in glob.glob(os.path.join(split_dir, ext)):
                rec = {"image": img_path, "label_name": class_name}
                if split_key == "train":
                    train_records.append(rec)
                else:
                    test_records.append(rec)

print("Classes:", classes)
print("Train samples:", len(train_records))
print("Test samples:", len(test_records))
We hebben in totaal 10 classificaties, met 989 trainingsvoorbeelden en 140 testvoorbeelden.
Classes: ['Avulsion fracture', 'Comminuted fracture', 'Fracture Dislocation', 'Greenstick fracture', 'Hairline Fracture', 'Impacted fracture', 'Longitudinal fracture', 'Oblique fracture', 'Pathological fracture', 'Spiral Fracture']
Train samples: 989
Test samples: 140
We gaan nu de labels encoderen voor de Hugging Face-dataset, zodat elke labelklasse als classlabels wordt beschouwd en elke afbeelding als afbeeldingsfeature wordt behandeld.
We maken twee datasets: één voor training en één voor testen. Tot slot combineren we ze tot één dataset die zowel train- als test-subsets bevat.
# Encode labels
classes = sorted(list(set(classes)))
label2id = {name: i for i, name in enumerate(classes)}

for rec in train_records:
    rec["label"] = label2id[rec["label_name"]]
for rec in test_records:
    rec["label"] = label2id[rec["label_name"]]

features = Features(
    {
        "image": Image(),
        "label": ClassLabel(names=classes),
    }
)

train_ds = Dataset.from_list(
    [{"image": r["image"], "label": r["label"]} for r in train_records],
    features=features,
)
test_ds = Dataset.from_list(
    [{"image": r["image"], "label": r["label"]} for r in test_records],
    features=features,
)

data = DatasetDict({"train": train_ds, "test": test_ds})
data
Hier is het overzicht van de dataset.
DatasetDict({
    train: Dataset({
        features: ['image', 'label'],
        num_rows: 989
    })
    test: Dataset({
        features: ['image', 'label'],
        num_rows: 140
    })
})Voor het fijnstemmen is het handig om te begrijpen hoe gebalanceerd de dataset is en hoe de afbeeldingen eruitzien. We beginnen met te controleren hoeveel trainingsvoorbeelden er voor elke breukcategorie zijn.
from collections import Counter

label_names = data["train"].features["label"].names
label_ids = data["train"]["label"]

counts = Counter(label_ids)
print("Training Class counts:")
for lbl_id, cnt in counts.items():
    print(f"{lbl_id:2d} ({label_names[lbl_id]}): {cnt}")

FRACTURE_CLASSES = label_names
De categorieën zijn redelijk gebalanceerd, al is de totale steekproefomvang klein voor een complexe visieclassificatietaak.
Voor nu gaan we verder met deze dataset, maar de resultaten moeten met realistische verwachtingen worden geïnterpreteerd vanwege het beperkte aantal voorbeelden.
Training Class counts:
 0 (Avulsion fracture): 109
 1 (Comminuted fracture): 134
 2 (Fracture Dislocation): 137
 3 (Greenstick fracture): 106
 4 (Hairline Fracture): 101
 5 (Impacted fracture): 75
 6 (Longitudinal fracture): 68
 7 (Oblique fracture): 69
 8 (Pathological fracture): 116
 9 (Spiral Fracture): 74
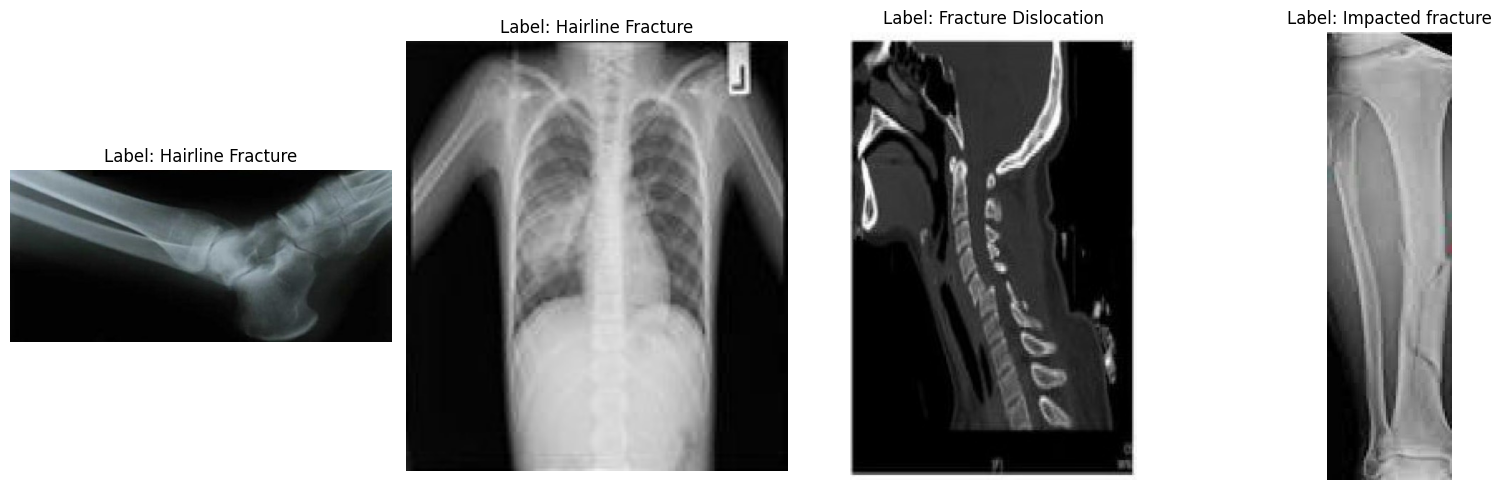
Vervolgens bekijken we een paar willekeurige afbeeldingen om de dataset visueel beter te begrijpen.
import matplotlib.pyplot as plt
from datasets import Image

# Cast the 'image' column to Hugging Face Image feature
dataset_images = data.cast_column("image", Image())

# Select random samples from the training set
samples = dataset_images["train"].shuffle(seed=420).select(range(4))

# Plot
fig, axes = plt.subplots(1, 4, figsize=(16, 5))

for i, sample in enumerate(samples):
    img_object = sample["image"]              # PIL Image
    label_id = sample["label"]               # int
    label_name = label_names[label_id]       # string

    axes[i].imshow(img_object)
    axes[i].set_title(f"Label: {label_name}")
    axes[i].axis("off")

plt.tight_layout()
plt.show()
Als we naar de voorbeeldafbeeldingen kijken, zien we verschillen in grootte, resolutie, oriëntatie en scan-kwaliteit. Dit belemmert het fijnstemmen van een visie-taalmodel niet, maar kan wel invloed hebben op hoe consistent het model elke breukcategorie leert.
Het visueel detecteren van een breuk is vaak rechttoe rechtaan, maar het classificeren in één van tien subtiele medische breuktypen vereist meer gestructureerde data dan hier aanwezig is.
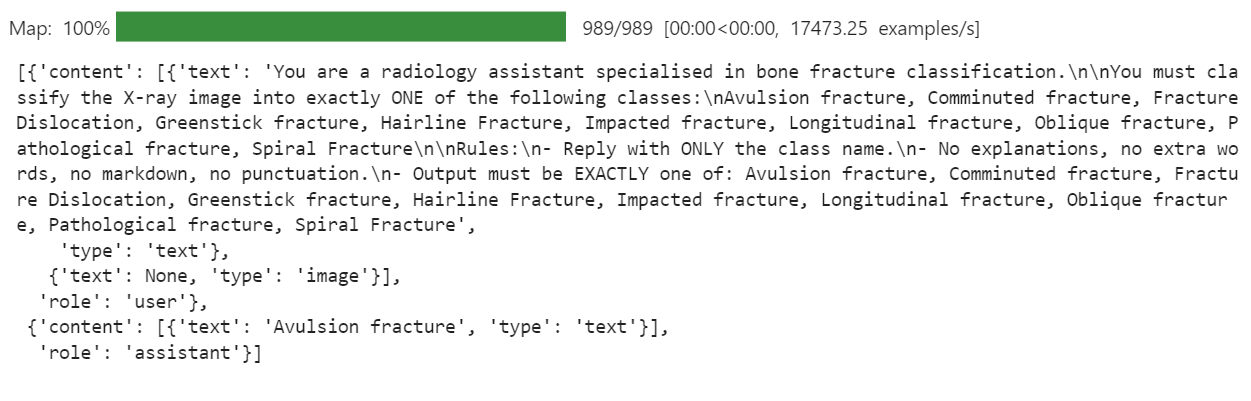
Vervolgens moeten we bepalen hoe we willen dat het model zich gedraagt. Voor deze taak is ons doel heel strikt: gegeven een röntgenafbeelding moet het model slechts één breukklassenaam en niets anders produceren. Geen uitleg, geen markdown, geen extra tekst.
We schrijven een duidelijke instructieprompt en gebruiken die vervolgens om een messages-kolom in de dataset op te bouwen.
PROMPT = f"""
You are a radiology assistant specialised in bone fracture classification.

You must classify the X-ray image into exactly ONE of the following classes:
{", ".join(FRACTURE_CLASSES)}

Rules:
- Reply with ONLY the class name.
- No explanations, no extra words, no markdown, no punctuation.
- Output must be EXACTLY one of: {", ".join(FRACTURE_CLASSES)}
""".strip()


from typing import Dict, Any

def convert_to_conversation(example: Dict[str, Any]) -> Dict[str, Any]:
    conversation = [
        {
            "role": "user",
            "content": [
                {"type": "text",  "text": PROMPT},
                {"type": "image"},     # no image bytes here
            ],
        },
        {
            "role": "assistant",
            "content": [
                {"type": "text", "text": FRACTURE_CLASSES[example["label"]]},
            ],
        },
    ]
    example["messages"] = conversation
    return example


formatted_data = data["train"].map(convert_to_conversation)
formatted_data["messages"][0]
Dit creëert een messages-kolom waarin elk record nu een complete mini-gesprek bevat: de instructie plus de juiste breukklasse. Dit is precies wat het visie-taalmodel tijdens fine-tuning te zien krijgt.
Nu laden we de BF16-versie van het Ministral-3 14B Instruct-model van de Hugging Face Hub, samen met de processor. De processor bundelt de tokenizer en de image preprocessing-pipeline, wat vereist is voor visie-taalinvoer.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "mistralai/Ministral-3-14B-Instruct-2512-BF16"


model_kwargs = dict(
    attn_implementation="eager",
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

# Use right padding to avoid issues during training
processor.tokenizer.padding_side = "right"De oorspronkelijke chattemplate van Mistral AI is ontworpen voor lange, conversatiestijlgebruik. Voor dit project werd dat een probleem. Het model ging zich richten op de lange rol-instructies en systeemtekst, en negeerde het eigenlijke doel: het voorspellen van één enkele botbreukklasse op basis van de röntgenfoto.
Om dit op te lossen definiëren we een kortere visie-taaltemplate die alleen de belangrijke onderdelen behoudt: de gebruikersinstructie en het antwoord van de assistant. Dit vermindert ruis en helpt het model een schone mapping van afbeelding naar klasselabel te leren.
SHORT_VLM_TEMPLATE = r"""{{ bos_token }}[INST]
{% for message in messages if message['role'] == 'user' -%}
  {%- for content in message['content'] -%}
    {%- if content['type'] == 'text' -%}
{{ content['text'] }}

    {%- elif content['type'] == 'image' -%}
[IMG]
    {%- endif -%}
  {%- endfor -%}
{%- endfor -%}
[/INST]{% if not add_generation_prompt %}
  {%- for message in messages if message['role'] == 'assistant' -%}
{{ message['content'][0]['text'] }}{{ eos_token }}
  {%- endfor -%}
{%- endif %}"""


# Attach to processor / tokenizer
processor.chat_template = SHORT_VLM_TEMPLATE
processor.tokenizer.chat_template = SHORT_VLM_TEMPLATEVoor we beginnen met fine-tunen is het nuttig om het oorspronkelijke Ministral 3 14B Instruct-model te testen om een baseline te creëren.
Eerst geven we het model een willekeurige afbeelding uit de dataset en stellen een algemene vraag, om te zien hoe het de inhoud van de röntgenfoto begrijpt.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": "What is the image about?"},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 1000,
                   use_cache = True, temperature = 1.5, min_p = 0.1)
Als resultaat begreep het model de algemene inhoud van de röntgenfoto, maar het ging daarna over op beschrijvingen die niet betrouwbaar zijn voor medisch gebruik.
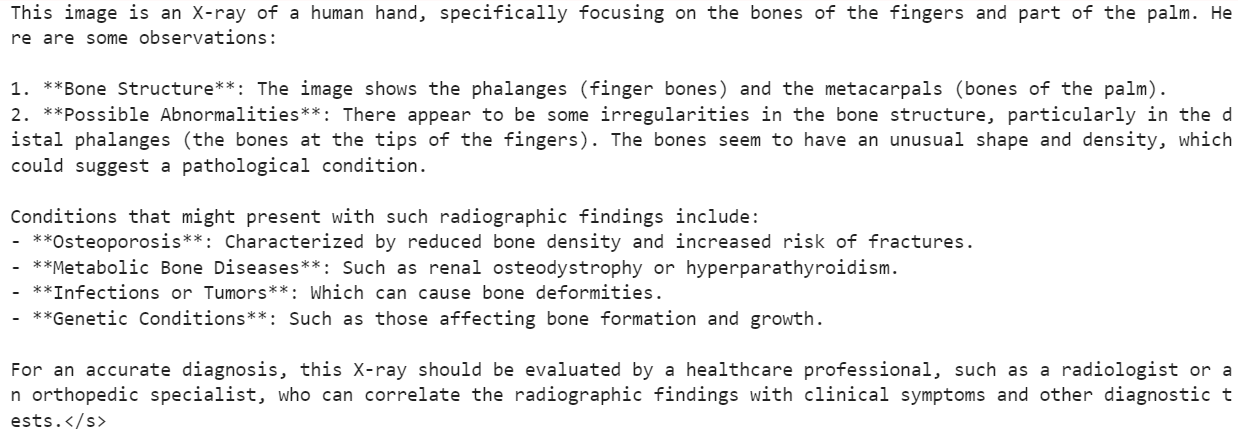
Vervolgens proberen we iets dat dichter bij ons einddoel ligt. We geven dezelfde afbeelding, maar dit keer gebruiken we onze strikte breukclassificatieprompt in plaats van een open vraag.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 1000,
                   use_cache = True, temperature = 1.5, min_p = 0.1
Voor dit voorbeeld reageerde het model met:
Hairline Fracture</s>Nu controleren we het daadwerkelijke groundtruth-label voor dezelfde afbeelding.
FRACTURE_CLASSES[formatted_data[200]["label"]]Dit geeft terug:
'Comminuted fracture'Het model volgde dus het instructieformaat correct en gaf één klassenaam, maar de classificatie zelf was onjuist.
Precies daarom hebben we fine-tuning nodig. Het basismodel heeft sterke visuele vaardigheden, maar is niet specifiek getraind om gedetailleerde botbreuktypen van elkaar te onderscheiden.
In de volgende stappen gaan we het fijnstemmen op onze breukdataset om dat gedrag te verbeteren.
Vervolgens zetten we LoRA op om het Ministral 3-model efficiënt te fijnstemmen zonder alle parameters te updaten. Deze configuratie richt zich op de belangrijkste attention- en MLP-projectielagen die in een Mistral-achtig visie-taalmodel worden gebruikt.
from peft import LoraConfig, TaskType, get_peft_model

# LoRA config for a Mistral-style VLM used as a causal LM
peft_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    modules_to_save=None,
)
Daarna definiëren we de trainingsargumenten voor supervised fine-tuning (SFT).
Deze configuratie stuurt het volledige trainingsproces aan, inclusief hoe batches worden afgehandeld, geheugenoptimalisatie, gedrag van de learning rate, logging, opslagstrategie en integratie met de Hugging Face Hub.
from trl import SFTConfig

args = SFTConfig(
    output_dir="ministral-3-bone-fracture",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    per_device_eval_batch_size=2,
    gradient_accumulation_steps=4,
    gradient_checkpointing=True,
    optim="adamw_8bit",
    logging_steps=0.1,
    save_strategy="epoch",
    learning_rate=2e-4,
    bf16=True,
    fp16=False,
    max_grad_norm=0.3,
    warmup_steps=25,
    lr_scheduler_type="linear",
    push_to_hub=True,
    report_to="none",
    gradient_checkpointing_kwargs={"use_reentrant": False},
    dataset_kwargs={"skip_prepare_dataset": True},
    remove_unused_columns = False,
    label_names=["labels"],
)Voor het fijnstemmen van een visie-taalmodel zoals Ministral 3 hebben we een aangepaste datacollator nodig die afbeeldingen en chat-achtige tekst consistent samen kan batchen.
De collator hieronder zorgt voor: het instellen van de tokenizer en pad-token, het toepassen van de chattemplate, het gezamenlijk tokenizen van tekst en afbeeldingen, het afdwingen van een veilige maximale sequentielengte, en het maken van labels waarbij padding- en beeldtokens worden gemaskeerd (-100) zodat ze de loss niet beïnvloeden.
from typing import Any, Dict, List
import torch

# --- One-time processor setup ---
tokenizer = processor.tokenizer
tokenizer.padding_side = "right"

# Ensure we have a pad token
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({"pad_token": tokenizer.eos_token})

pad_token_id = tokenizer.pad_token_id
image_token_id = getattr(processor, "image_token_id", None)

# Hard cap for sequence length
MAX_SEQ_LEN = 2048


def collate_fn(examples: List[Dict[str, Any]]) -> Dict[str, torch.Tensor]:
    """
    Collate function for VLM fine-tuning.

    Each example must contain:
      - "image": a PIL image
      - "messages": chat-style conversation (list[dict])
    """
    images = [ex["image"] for ex in examples]
    conversations = [ex["messages"] for ex in examples]

    # Build chat prompts for the whole batch
    chat_texts = processor.apply_chat_template(
        conversations,
        add_generation_prompt=False,
        tokenize=False,
    )

    # Tokenize + process images
    batch = processor(
        text=chat_texts,
        images=images,
        padding="longest",
        truncation=True,
        max_length=MAX_SEQ_LEN,
        return_tensors="pt",
    )

    # Labels: same as input_ids but mask pad & image tokens
    labels = batch["input_ids"].clone()

    if pad_token_id is not None:
        labels[labels == pad_token_id] = -100

    if image_token_id is not None and image_token_id != pad_token_id:
        labels[labels == image_token_id] = -100

    batch["labels"] = labels
return batchMet de LoRA-adapter, trainingsconfig en datacollator klaar, kunnen we nu alles aansluiten op de SFTTrainer van trl.
Deze trainer handelt de volledige supervised fine-tuninglus af voor ons visie-taal Ministral 3-model, met gebruik van onze geformatteerde dataset, LoRA-config en aangepaste collatefunctie voor beeld–tekst-batches.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,
    args=args,
    train_dataset=formatted_data,
    peft_config=peft_config,
    processing_class=processor,
    data_collator=collate_fn,
)
Voer onderstaande code uit om het trainingsproces te starten.
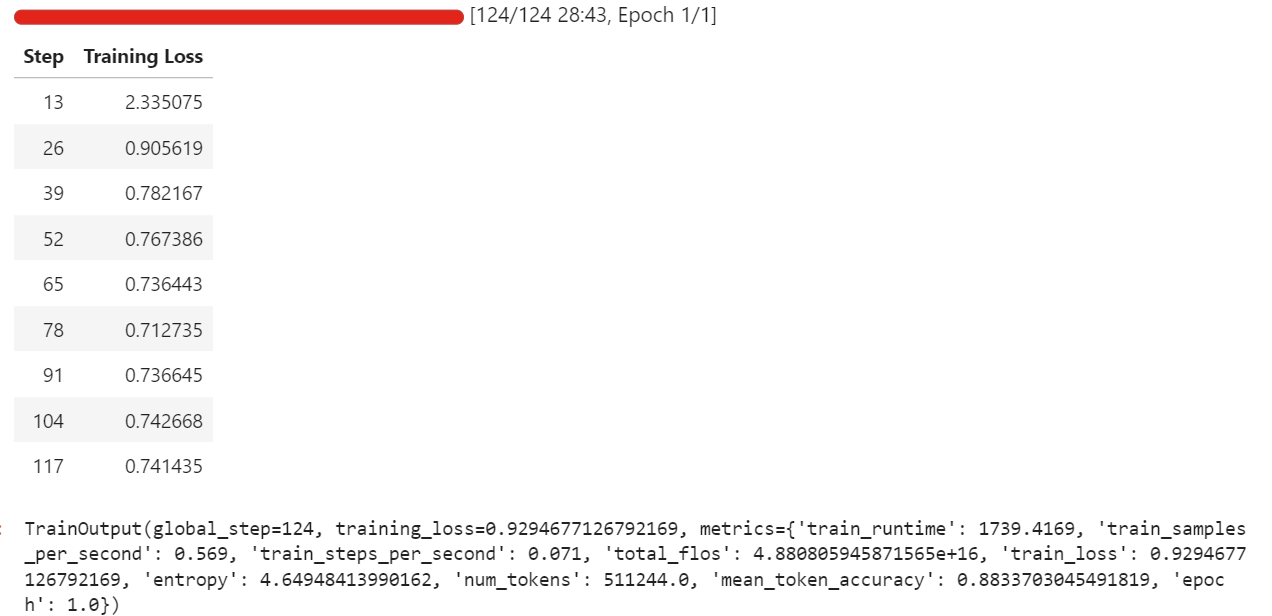
trainer.train()Tijdens mijn run gebruikte fine-tuning rond de 57 GB VRAM, en iets meer tijdens evaluatiestappen die om de paar iteraties draaien. In de praktijk betekent dit dat je deze setup comfortabel kunt fijnstemmen op hardware met minder dan 70 GB VRAM.
De volledige training duurde ongeveer een half uur en de training loss nam gestaag af, wat een goed teken is dat het model leert van de dataset.
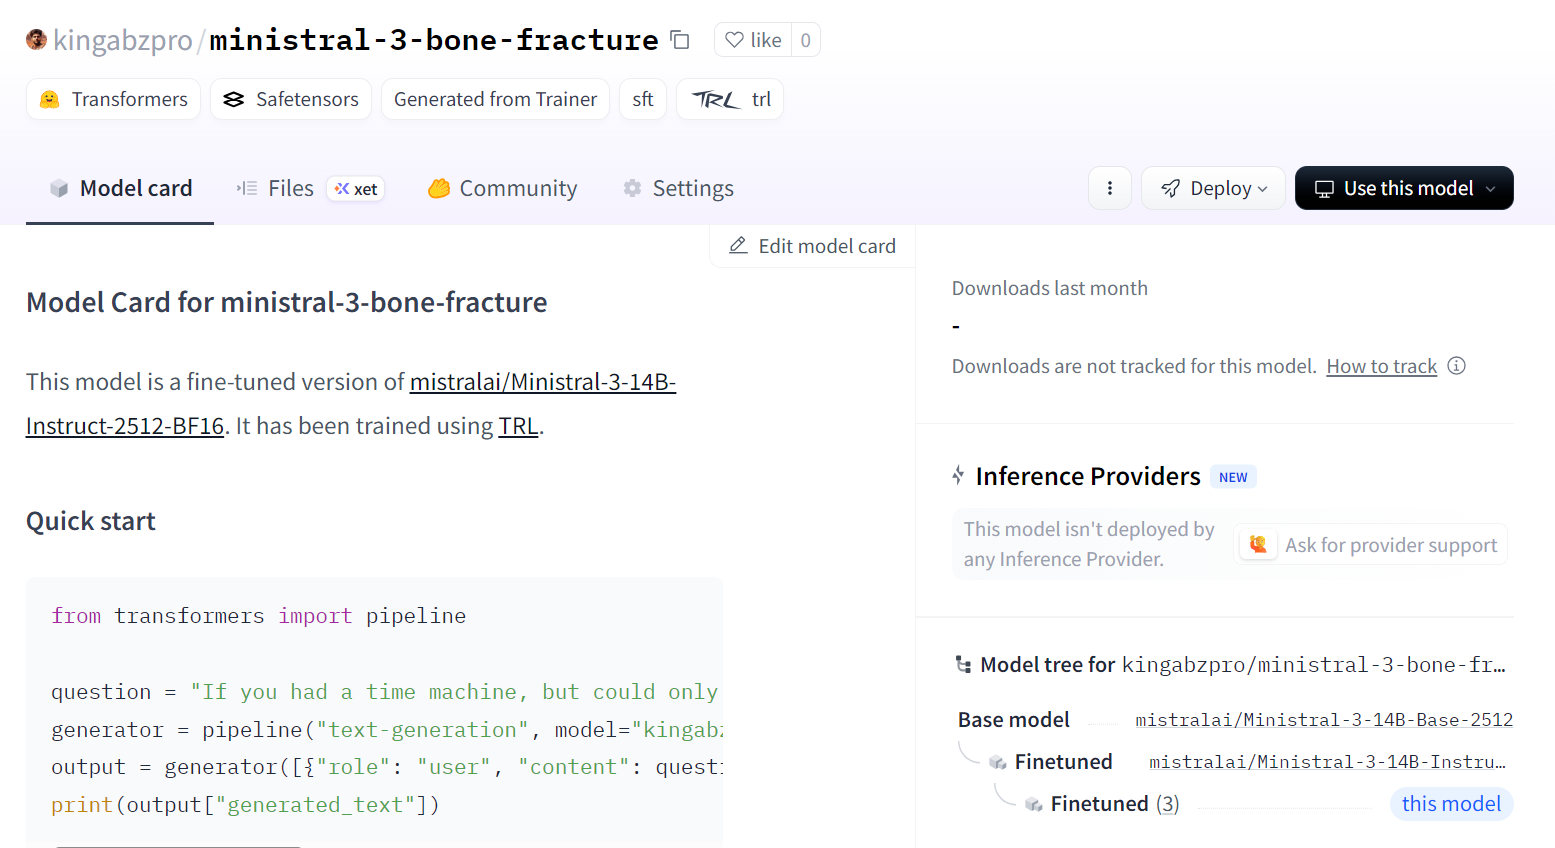
Zodra de training is voltooid, slaan we het aangepaste model op naar de Hugging Face Hub. Dit maakt een nieuwe repository aan en pusht alle vereiste bestanden zodat je het fijnafgestelde model vanuit elke omgeving opnieuw kunt laden en uitvoeren.
trainer.save_model()Je kunt het model bekijken op kingabzpro/ministral-3-bone-fracture.
Nu laden we het fijnafgestelde model en de processor van de Hugging Face Hub. Onder de motorkap downloadt dit de opgeslagen LoRA-adapter, laadt het de basismodel-checkpoint van Ministral 3 en voegt het de adapter samen met het basismodel zodat het klaar is voor inferentie.
import torch
from transformers import AutoProcessor, AutoModelForImageTextToText, BitsAndBytesConfig

model_id = "kingabzpro/ministral-3-bone-fracture"


model_kwargs = dict(
    attn_implementation="eager",
    dtype=torch.bfloat16,
    device_map="auto",
)

model = AutoModelForImageTextToText.from_pretrained(model_id, **model_kwargs)
processor = AutoProcessor.from_pretrained(model_id)

processor.tokenizer.padding_side = "left"
Om de vergelijking eerlijk te houden, gebruiken we eerst dezelfde afbeelding die we voor fine-tuning hebben getest (index 200) en laten we deze door de inferentiepipeline lopen met onze strikte classificatieprompt.
image = formatted_data[200]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 100)
We behaalden een perfect resultaat. Er was geen extra post-processing nodig. Het model volgde de promregels en gaf direct de juiste klasse.
Comminuted fracture</s>Vervolgens proberen we een ander willekeurig voorbeeld uit de dataset om te bevestigen dat dit gedrag niet beperkt is tot één voorbeeld.
image = formatted_data[400]["image"]

messages = [
    {"role": "user", "content": [
        {"type": "text", "text": PROMPT},
        {"type": "image"},

    ]}
]

input_text = processor.apply_chat_template(messages, add_generation_prompt = True)
inputs = processor(
    image,
    input_text,
    add_special_tokens = False,
    return_tensors = "pt",
).to(device="cuda", dtype=torch.bfloat16)

from transformers import TextStreamer
text_streamer = TextStreamer(processor, skip_prompt = True)
_ = model.generate(**inputs, streamer = text_streamer, max_new_tokens = 100)
Modeluitvoer:
Greenstick fracture</s>Ground truth:
FRACTURE_CLASSES[formatted_data[400]["label"]]Uitvoer:
'Greenstick fracture'Opnieuw is de voorspelling correct en volledig in lijn met het label.
Met deze checks kunnen we stellen dat ons Ministral 3 14B-model met succes is fijngetuned op de röntgendataset van botbreuken en nu de instructieprompt kan volgen en nauwkeurige single-class-voorspellingen kan produceren voor deze voorbeelden.
Het fijnstemmen van het Ministral 3-model vereist geduld en gestage aanpassingen. Het kostte me oprecht twee volle dagen om te begrijpen waarom het model niet trainde zoals ik verwachtte en waarom het, ondanks dat het relatief klein is, mijn GPU toch naar out-of-memory-fouten duwde.
De hoofdreden was simpel, maar gemakkelijk te missen. Dit is niet zomaar een taalmodel. Het is een visie-taalmodel, wat betekent dat het een beeldencoder bevat die extra geheugen gebruikt.
Grotere beeldresoluties leiden direct tot een hoger VRAM-gebruik. Het verkleinen van de beeldgrootte of beginnen met kleinere batches maakt het trainingsproces veel stabieler.
Een ander probleem waar ik tegenaan liep was het gebruik van de standaard chattemplate. Die was veel te lang en te gestructureerd voor dit type taak. Het model besteedde meer moeite aan het volgen van de template-opmaak dan aan het leren hoe het de afbeeldingen moest lezen en een duidelijke breukclassificatie moest geven.
Toen ik de prompt eenvoudiger maakte tot een directe instructie, begon het model eindelijk correct te reageren op de visuele input in plaats van elk antwoord te vormen als een volledige chatreactie.
Ik ging er ook vanuit dat, omdat het model sterke visuele capaciteiten heeft, het vanzelf goed zou presteren op medische scans. Die aanname hield me tegen. Het in mijn hoofd “MedGemma” noemen was niet eerlijk tegenover het model of het proces. Het is niet out-of-the-box een gespecialiseerd medisch model, en verwachten dat het zich zo gedraagt zonder goede training was mijn fout.
Uiteindelijk heb ik elk obstakel overwonnen en mijn inzichten omgezet in deze gids. Het doel is om jou dezelfde verwarring te besparen en sneller tot betekenisvolle resultaten te komen.
“Met kleinere afbeeldingen, eenvoudigere prompts en realistische verwachtingen kun je Ministral 3 veel soepeler en betrouwbaarder fijnstemmen voor het begrijpen van röntgenbeelden.”
Als je graag meer hands-on wilt oefenen met fine-tuning, raad ik de cursus Fine-Tuning met Llama 3 aan.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


