Last chance! 50% off DataCamp Premium
Sale ends in
AI open‑source bergerak sangat cepat; model baru bermunculan hampir setiap hari, mengungguli versi sebelumnya sekaligus menjadi lebih cepat, lebih mudah dilatih, dan lebih “siap‑agen”.
Dalam tutorial praktis ini, kita akan menyelami Qwen3‑Next, menjalankannya secara lokal, meluncurkan server lokal sederhana, dan menyiapkannya agar Anda dapat mengintegrasikannya ke dalam aplikasi Anda nanti. Yang terbaik, kita akan melakukan semuanya hanya dengan kerangka kerja Hugging Face Transformers, baik untuk inferensi maupun serving.
Pada akhirnya, Anda akan:
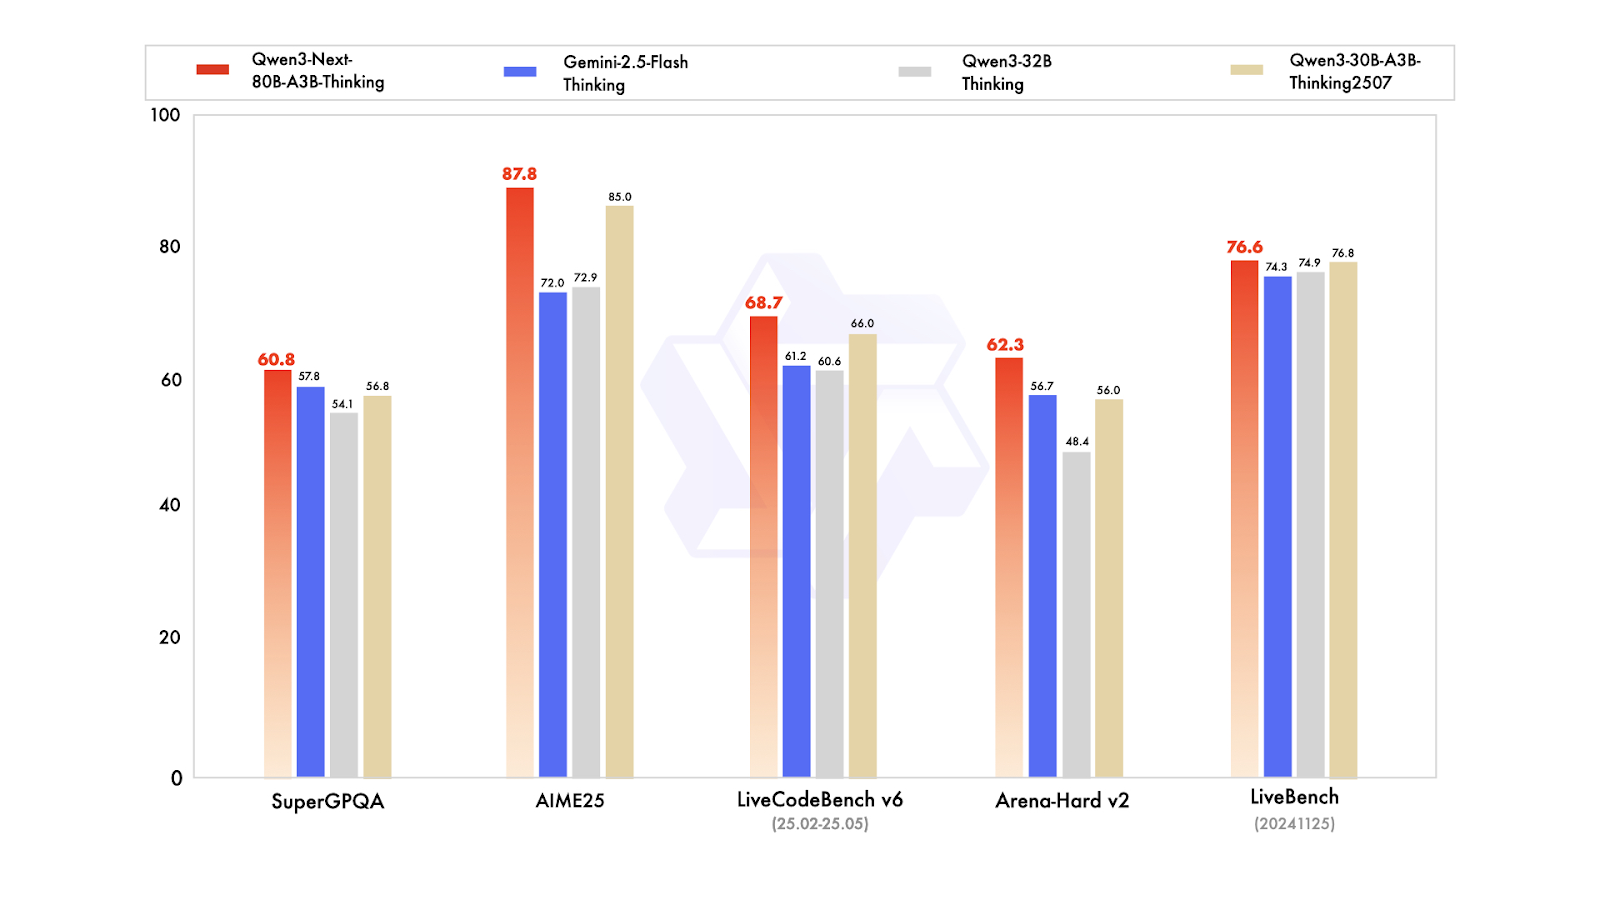
Qwen3-Next adalah arsitektur baru yang dirancang untuk penskalaan panjang konteks dan total parameter. Model dasar dengan 80 miliar parameter hanya mengaktifkan sekitar 3 miliar parameter saat inferensi, sekaligus mencapai kinerja yang menyamai atau sedikit melampaui model Dense Qwen3-32B, semua dengan biaya pelatihan kurang dari 10%. Model ini juga menyediakan throughput lebih dari 10 kali lipat untuk panjang konteks yang melebihi 32.000 token.
Dalam hal varian pascapelatihan, model Instruct bersaing dengan model andalan 235 miliar parameter dan mendukung panjang konteks hingga 256.000 token. Selain itu, varian Thinking melampaui model Qwen3-30B-A3B dan Qwen3-32B, serta Gemini-2.5-Flash-Thinking, mendekati kinerja model Thinking 235 miliar.
Sumber: Qwen
Apa yang baru di Qwen3-Next:
Anda dapat memperoleh Qwen3‑Next di Hugging Face dan ModelScope untuk diunduh guna penggunaan lokal, atau menerapkannya sebagai server dengan kerangka kerja seperti vLLM, SGLang, atau Transformers Serve.
Untuk menjalankan Qwen3-Next secara lokal, kita akan memasang pustaka transformers dari repositori utama, bersama accelerate, bitsandbytes, flash-linear-attention, dan causal-conv1d untuk backend yang lebih cepat.
Setelah pemasangan, harap mulai ulang kernel Jupyter notebook.
%%capture

!pip install git+https://github.com/huggingface/transformers.git@main
!pip install accelerate bitsandbytes

!pip install git+https://github.com/fla-org/flash-linear-attention.git
!pip install git+https://github.com/Dao-AILab/causal-conv1d.git
Selanjutnya, unduh dan muat tokenizer serta model menggunakan tipe data dan peta perangkat yang sesuai.
Kita akan memuat model terkuantisasi 4-bit, yang mengurangi jejak memori empat kali lipat. Artinya, Anda memerlukan ruang penyimpanan dan VRAM lebih sedikit untuk memuat dan menjalankan inferensi.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit"

# --- Load tokenizer ---
tokenizer = AutoTokenizer.from_pretrained(model_name)

# --- Load model ---
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    dtype="auto",
)
Kita kemudian akan membuat prompt, menyusun pesan, dan melewatkannya melalui template chat untuk memastikan formatnya dikenali oleh model Qwen3-Next.
# prepare the model input
prompt = "Write a short introduction to large language models, highlighting how learners can explore them through DataCamp's interactive courses and hands-on projects."
messages = [
    {"role": "user", "content": prompt},
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
Setelah itu, kita akan melakukan tokenisasi teks, melewatkannya ke model, dan mengekstrak hanya token keluaran. Lalu kita dekode dan tampilkan respons akhir.
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

content = tokenizer.decode(output_ids, skip_special_tokens=True)

print("content:", content)
Keluaran terlihat sempurna:
content: Large language models (LLMs) are advanced AI systems trained on vast amounts of text data to understand, generate, and reason with human language.
From answering questions and writing code to summarizing documents and engaging in conversation, LLMs are transforming how we interact with technology--and how we learn.
At DataCamp, learners can explore the power of LLMs through interactive courses and hands-on projects that bridge theory with real-world application.
Whether you're building your first chatbot, fine-tuning a model with Hugging Face, or evaluating AI-generated text, DataCamp's guided, code-based learning environment lets you experiment safely and effectively--no prior AI expertise required.
Start your journey into the future of language AI today.
Beberapa hal yang perlu diingat:
Anda dapat menyajikan Qwen3-Next secara lokal menggunakan SGLang atau vLLM, seperti ditunjukkan pada halaman model untuk Qwen. Namun, dalam tutorial ini, kita akan mempelajari hal baru: menggunakan CLI Transformers untuk menyajikan model dan mengaksesnya melalui antarmuka chat yang disediakan oleh Transformers, mirip dengan Ollama.
Pertama, pasang pustaka Transformers dengan kemampuan serving:
pip install transformers[serving]Berikutnya, jalankan server Transformers dari terminal Anda. Ini adalah server umum, mirip dengan Ollama.
transformers serveSeperti yang terlihat, server dapat diakses pada port 8000:
INFO:     Started server process [3502]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://localhost:8000 (Press CTRL+C to quit)
Cara termudah berinteraksi dengan server adalah menggunakan CLI chat Transformers. Ini memungkinkan Anda terhubung ke server dan menyediakan antarmuka seperti chat di terminal Anda.
Luncurkan jendela terminal baru dan pasang pustaka Rich:
pip install richLalu, jalankan perintah berikut untuk memulai antarmuka chat dengan path model:
transformers chat localhost:8000 \
  --model-name-or-path unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit
Chat Transformers akan secara otomatis menentukan model yang sudah diunduh untuk dipilih dan memuatnya. Awalnya, pemuatan model mungkin memakan waktu, tetapi setelah itu, Anda bisa mulai mengobrol.
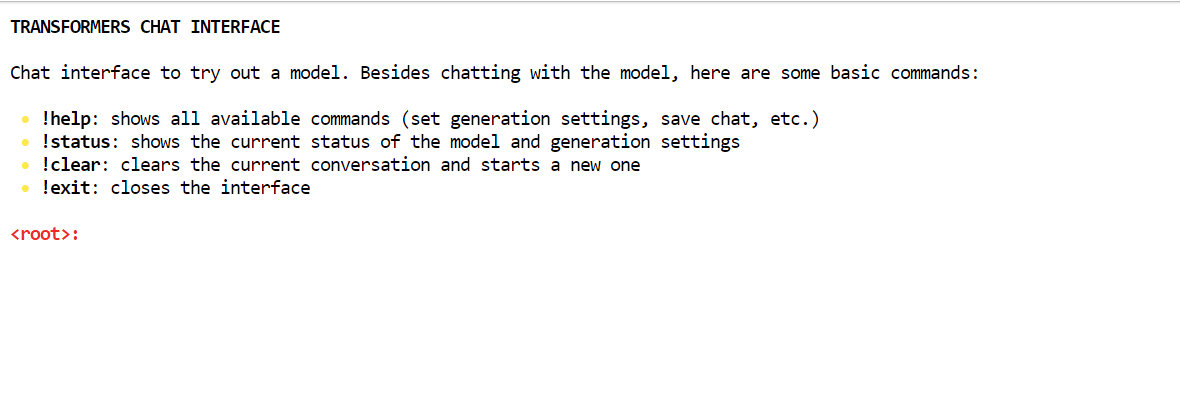
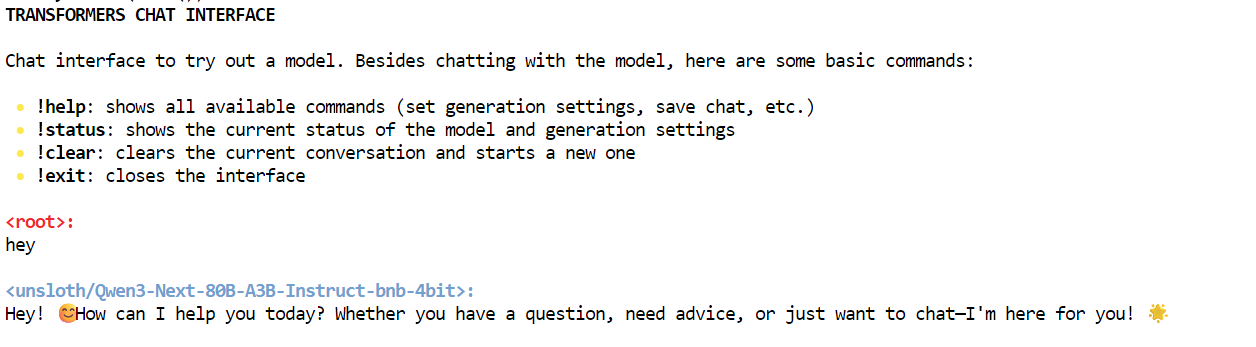
Seperti yang Anda lihat, kita berinteraksi dengan model Qwen3-Next secara lokal menggunakan antarmuka chat.
Ada banyak cara untuk berinteraksi dengan server. Anda bisa menggunakan AsyncInferenceClient dari Hugging Face Hub, membuat perintah CURL, menggunakan pustaka requests di Python, atau mengakses server melalui OpenAI API.
Server ini kompatibel dengan OpenAI, artinya Anda dapat mengintegrasikannya ke VSCode, alur kerja Agentic Anda, atau menggunakannya sebagai server MCP.
Pertama, kita akan menjalankan perintah CURL sederhana di terminal baru untuk memeriksa berapa banyak model yang tersedia di server:
curl -s http://localhost:8000/v1/modelsSetelah itu, kita akan menggunakan API responses. Kita memberinya model, prompt, dan menyetel streaming ke false:
curl -s http://localhost:8000/v1/responses \
  -H "Content-Type: application/json" \
  -d '{
    "model": "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",
    "input": "One line: what is Qwen3-Next?",
    "stream": false
  }'
Hasilnya, server menghasilkan respons berisi informasi tentang model Qwen3-Next.
{"response":{"id":"resp_req_0","created_at":1758494863.6661901,"model":"unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit@main","object":"response","output":[{"id":"msg_req_0","content":[{"annotations":[],"text":"Qwen3-Next is the next-generation large language model in Alibaba's Qwen series, featuring enhanced performance, broader knowledge, and improved reasoning capabilities.","type":"output_text"}],"role":"assistant","status":"completed","type":"message","annotations":[]}],"parallel_tool_calls":false,"tool_choice":"auto","tools":[],"status":"completed","text":{"format":{"type":"text"}}},"sequence_number":40,"type":"response.completed"}Demikian pula, Anda dapat membuat berkas Python, menambahkan kode berikut, dan menjalankannya.
Kode akan menginisialisasi klien OpenAI dengan URL server lokal. Kita memberinya nama model, masukan, dan menghasilkan respons sebagai stream.
from openai import OpenAI

# Connect to your local server
client = OpenAI(
    base_url="http://localhost:8000/v1",  # transformers serve endpoint
    api_key="not-needed"                  # required by SDK, but can be dummy
)

# Create a streaming response request
response = client.responses.create(
    model="unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",  # use your loaded model
    instructions="You are a helpful assistant.",
    input="What is love?",
    stream=True,                      # enable SSE streaming
    metadata={"source": "local-test"} # optional metadata
)

# Iterate over server-sent events
for event in response:
    if event.type == "response.output_text.delta":
        # This event contains the incremental text
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        print("\n--- done ---")
Kita menerima hasil yang sesuai sebagai respons streaming. Keren.
Love is one of the most profound, complex, and universal human experiences -- a powerful emotion that defies simple definition but shapes our lives in countless ways.

At its core, **love** is a deep affection, care, and connection toward another person -- or even a thing, idea, or cause. It can manifest in many forms:

### Types of Love (from ancient Greek philosophy):
- **Eros**: Passionate, romantic, or sexual love.
- **Philia**: Deep friendship and platonic affection.
- **Storge**: Familial love -- the natural affection between parents and children.
- **Agape**: Selfless, unconditional love -- often spiritual or altruistic.
- **Ludus**: Playful, flirtatious love.
- **Pragma**: Long-lasting, committed love built on patience and compromise.
- **Philautia**: Self-love -- healthy self-regard that enables us to love others.

### What Love Feels Like:
- **Emotionally**: Warmth, safety, joy, vulnerability, longing, and sometimes pain.
- **Behaviorally**: Acts of kindness, sacrifice, patience, listening, and presence.
- **Biologically**: Involves neurotransmitters like oxytocin, dopamine, and serotonin -- chemicals that bond us and create attachment.

### Love Is Also a Choice:
Beyond feelings, love is often a decision -- to show up, to forgive, to stay even when it's hard. It's not just a rush of butterflies; it's the quiet commitment to care for someone day after day.

### In Essence:
> **Love is seeing someone's soul -- and choosing to hold it gently.**

It's the reason people write poetry, compose music, risk everything for another, and find meaning in life. Love connects us -- to others, to ourselves, and to something greater than just our individual existence.

So what is love?
It's complicated. It's messy. It's beautiful.
And above all -- it's human. ❤️
--- done ---Pada saat penulisan, versi GGUF dari Qwen3-Next belum tersedia, yang berarti belum dapat dijalankan secara lokal menggunakan Ollama atau Llama.cpp. Model penuh memerlukan empat GPU A100 untuk beroperasi secara efektif, jadi kami memilih versi terkuantisasi yang memungkinkan model dijalankan pada satu GPU A100 dengan VRAM 80GB. Meskipun membutuhkan waktu untuk mengunduh dan menyiapkan model, kita berhasil mempelajari cara menjalankan inferensi.
Dalam tutorial ini, kita mengeksplorasi model Qwen3-Next, yang bersaing dengan model proprietari terkemuka lainnya dalam hal kecepatan dan akurasi, meski berukuran lebih kecil.
Setelah menjalankan model secara lokal, kita mengaksesnya menggunakan perintah curl dan OpenAI Python SDK. Langkah berikutnya adalah mengoptimalkan model untuk mesin Anda. Kita mungkin mengeksplorasi versi yang lebih kecil, seperti model 1,2‑bit, untuk meningkatkan kecepatan inferensi, terutama pada GPU kelas bawah.
Sebagai alternatif, Anda dapat mempertimbangkan menyewa server GPU untuk menyiapkan server LLM privat Anda sendiri; Runpod adalah opsi yang patut dipertimbangkan.
Kursus Teratas DataCamp
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt