Last chance! 50% off DataCamp Premium
Sale ends in
L’AI open source si muove a una velocità vertiginosa: quasi ogni giorno nascono nuovi modelli che superano le versioni precedenti, diventano più veloci, più facili da addestrare e sempre più “agent‑ready”.
In questo tutorial pratico esploreremo Qwen3‑Next, lo eseguiremo in locale, avvieremo un semplice server locale e prepareremo tutto per poterlo integrare in un secondo momento nelle tue applicazioni. La parte migliore? Faremo tutto usando solo il framework Hugging Face Transformers, sia per l’inferenza sia per il serving.
Alla fine sarai in grado di:
Qwen3-Next è una nuova architettura progettata per scalare sia la lunghezza del contesto sia il numero totale di parametri. Il modello base da 80 miliardi di parametri ne attiva solo circa 3 miliardi durante l’inferenza, ottenendo prestazioni pari o leggermente superiori al modello denso Qwen3-32B, il tutto con meno del 10% del costo di training. Inoltre, offre oltre 10 volte il throughput per lunghezze di contesto superiori a 32.000 token.
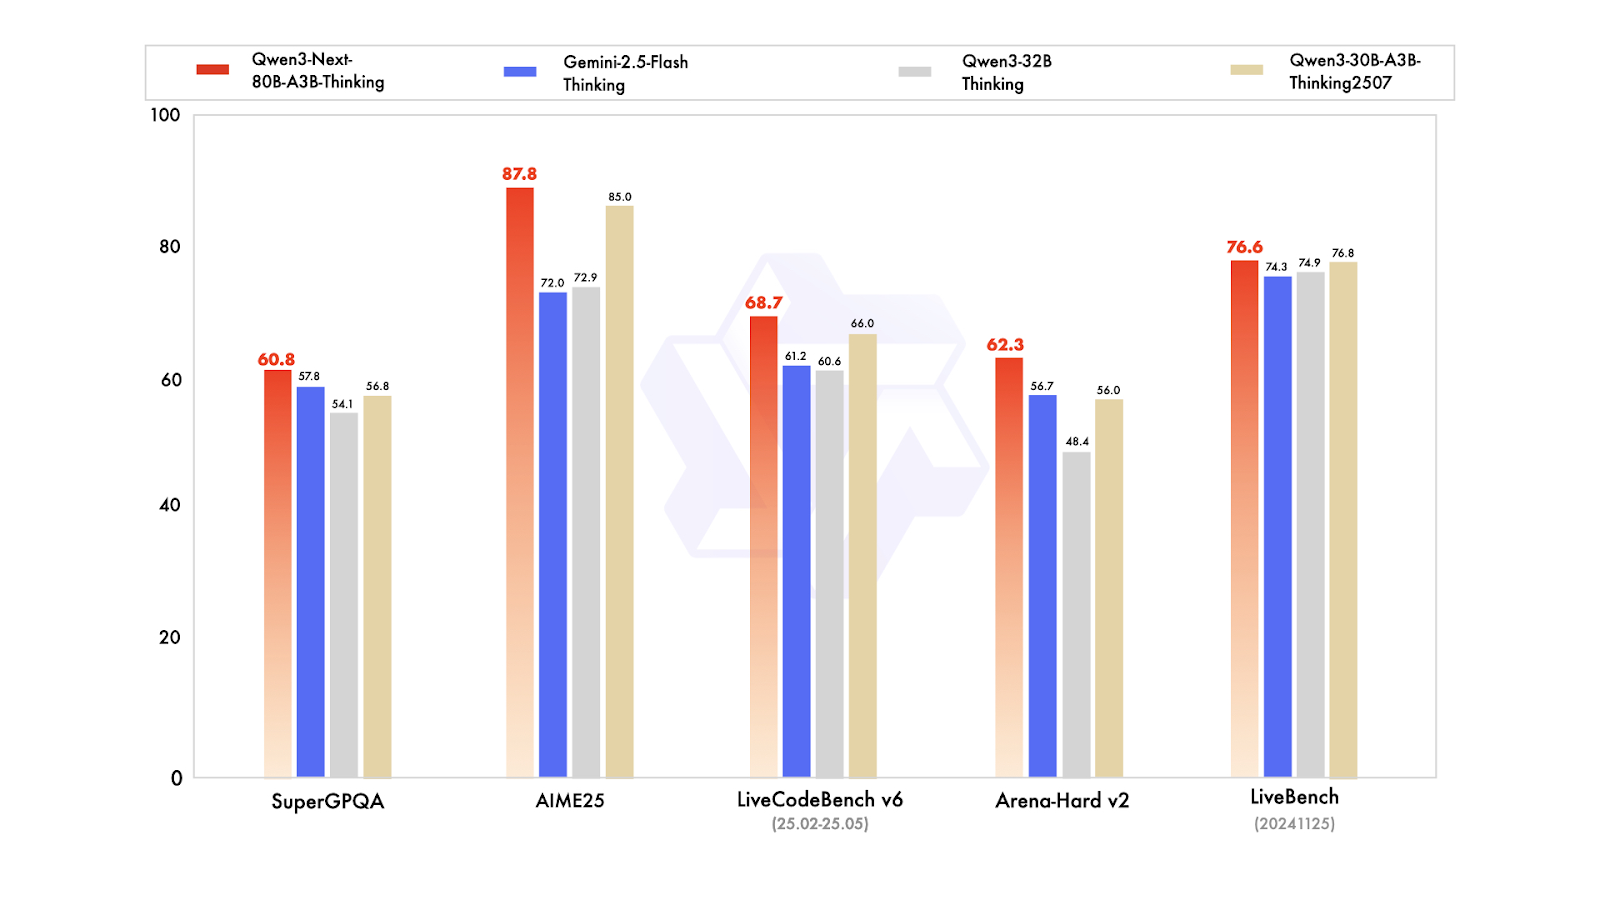
Per quanto riguarda le varianti post‑training, il modello Instruct compete con il modello di punta da 235 miliardi di parametri e supporta lunghezze di contesto fino a 256.000 token. Inoltre, la variante Thinking supera i modelli Qwen3-30B-A3B e Qwen3-32B, così come Gemini-2.5-Flash-Thinking, avvicinandosi alle prestazioni del modello Thinking da 235 miliardi.
Fonte: Qwen
Novità in Qwen3-Next:
Puoi ottenere Qwen3‑Next su Hugging Face e ModelScope per il download e l’uso in locale, oppure distribuirlo come server con framework come vLLM, SGLang o Transformers Serve.
Per eseguire Qwen3-Next in locale, installeremo la libreria transformers dal repository principale, insieme a accelerate, bitsandbytes, flash-linear-attention e causal-conv1d per un backend più veloce.
Dopo l’installazione, riavvia il kernel del notebook Jupyter.
%%capture

!pip install git+https://github.com/huggingface/transformers.git@main
!pip install accelerate bitsandbytes

!pip install git+https://github.com/fla-org/flash-linear-attention.git
!pip install git+https://github.com/Dao-AILab/causal-conv1d.git
Poi, scarica e carica tokenizer e modello usando i tipi di dato e la device map appropriati.
Caricheremo un modello quantizzato a 4 bit, che riduce l’impronta in memoria di quattro volte. Significa che ti serviranno meno spazio su disco e meno VRAM per caricare ed eseguire l’inferenza.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit"

# --- Load tokenizer ---
tokenizer = AutoTokenizer.from_pretrained(model_name)

# --- Load model ---
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    dtype="auto",
)
Creeremo quindi un prompt, formuleremo un messaggio e lo passeremo a un template di chat per garantire il formato richiesto dal modello Qwen3-Next.
# prepare the model input
prompt = "Write a short introduction to large language models, highlighting how learners can explore them through DataCamp's interactive courses and hands-on projects."
messages = [
    {"role": "user", "content": prompt},
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
Successivamente, tokenizzeremo il testo, lo passeremo al modello ed estrarremo solo i token di output. Infine decodificheremo e mostreremo la risposta finale.
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

content = tokenizer.decode(output_ids, skip_special_tokens=True)

print("content:", content)
L’output è perfetto:
content: Large language models (LLMs) are advanced AI systems trained on vast amounts of text data to understand, generate, and reason with human language.
From answering questions and writing code to summarizing documents and engaging in conversation, LLMs are transforming how we interact with technology--and how we learn.
At DataCamp, learners can explore the power of LLMs through interactive courses and hands-on projects that bridge theory with real-world application.
Whether you're building your first chatbot, fine-tuning a model with Hugging Face, or evaluating AI-generated text, DataCamp's guided, code-based learning environment lets you experiment safely and effectively--no prior AI expertise required.
Start your journey into the future of language AI today.
Alcune cose da tenere a mente:
Puoi servire Qwen3-Next in locale usando SGLang o vLLM, come mostrato nella pagina del modello di Qwen. In questo tutorial, però, vedremo qualcosa di nuovo: usare la CLI di Transformers per servire il modello e accedervi tramite un’interfaccia chat fornita da Transformers, in modo simile a Ollama.
Per prima cosa, installa la libreria Transformers con le capacità di serving:
pip install transformers[serving]Poi avvia il server di Transformers dal terminale. Si tratta di un server generale, simile a Ollama.
transformers serveCome vedi, il server sarà accessibile sulla porta 8000:
INFO:     Started server process [3502]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://localhost:8000 (Press CTRL+C to quit)
Il modo più semplice per interagire con il server è usare la chat CLI di Transformers. Ti consente di connetterti al server e offre un’interfaccia tipo chat direttamente nel terminale.
Apri una nuova finestra di terminale e installa la libreria Rich:
pip install richPoi esegui il seguente comando per avviare l’interfaccia chat indicando il percorso del modello:
transformers chat localhost:8000 \
  --model-name-or-path unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit
La chat di Transformers deciderà automaticamente quale modello già scaricato usare e lo caricherà. All’inizio il caricamento può richiedere un po’ di tempo, ma poi puoi iniziare a chattare.
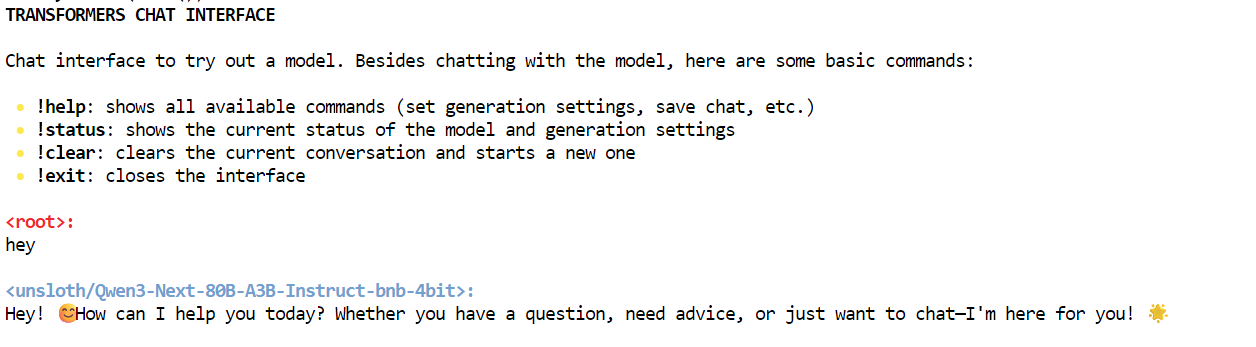
Come puoi vedere, stiamo interagendo in locale con il modello Qwen3-Next usando l’interfaccia chat.
Ci sono molti modi per interagire con il server. Puoi usare l’AsyncInferenceClient di Hugging Face Hub, fare un comando CURL, usare la libreria requests di Python o accedere al server tramite l’API OpenAI.
Questo server è compatibile con OpenAI, quindi puoi integrarlo in VSCode, in un workflow agentico o usarlo come server MCP.
Per cominciare, esegui un semplice comando CURL nel nuovo terminale per verificare quanti modelli sono disponibili sul server:
curl -s http://localhost:8000/v1/modelsDopodiché useremo la responses API. Le forniremo il modello, i prompt e imposteremo lo streaming su false:
curl -s http://localhost:8000/v1/responses \
  -H "Content-Type: application/json" \
  -d '{
    "model": "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",
    "input": "One line: what is Qwen3-Next?",
    "stream": false
  }'
Di conseguenza, ha generato una risposta contenente informazioni sul modello Qwen3-Next.
{"response":{"id":"resp_req_0","created_at":1758494863.6661901,"model":"unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit@main","object":"response","output":[{"id":"msg_req_0","content":[{"annotations":[],"text":"Qwen3-Next is the next-generation large language model in Alibaba's Qwen series, featuring enhanced performance, broader knowledge, and improved reasoning capabilities.","type":"output_text"}],"role":"assistant","status":"completed","type":"message","annotations":[]}],"parallel_tool_calls":false,"tool_choice":"auto","tools":[],"status":"completed","text":{"format":{"type":"text"}}},"sequence_number":40,"type":"response.completed"}Allo stesso modo, puoi creare un file Python, aggiungere il seguente codice ed eseguirlo.
Il codice inizializzerà il client OpenAI con l’URL del server locale. Gli forniremo il nome del modello, gli input e genereremo risposte in streaming.
from openai import OpenAI

# Connect to your local server
client = OpenAI(
    base_url="http://localhost:8000/v1",  # transformers serve endpoint
    api_key="not-needed"                  # required by SDK, but can be dummy
)

# Create a streaming response request
response = client.responses.create(
    model="unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",  # use your loaded model
    instructions="You are a helpful assistant.",
    input="What is love?",
    stream=True,                      # enable SSE streaming
    metadata={"source": "local-test"} # optional metadata
)

# Iterate over server-sent events
for event in response:
    if event.type == "response.output_text.delta":
        # This event contains the incremental text
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        print("\n--- done ---")
Abbiamo ricevuto risultati corretti come risposta in streaming. Fantastico.
Love is one of the most profound, complex, and universal human experiences -- a powerful emotion that defies simple definition but shapes our lives in countless ways.

At its core, **love** is a deep affection, care, and connection toward another person -- or even a thing, idea, or cause. It can manifest in many forms:

### Types of Love (from ancient Greek philosophy):
- **Eros**: Passionate, romantic, or sexual love.
- **Philia**: Deep friendship and platonic affection.
- **Storge**: Familial love -- the natural affection between parents and children.
- **Agape**: Selfless, unconditional love -- often spiritual or altruistic.
- **Ludus**: Playful, flirtatious love.
- **Pragma**: Long-lasting, committed love built on patience and compromise.
- **Philautia**: Self-love -- healthy self-regard that enables us to love others.

### What Love Feels Like:
- **Emotionally**: Warmth, safety, joy, vulnerability, longing, and sometimes pain.
- **Behaviorally**: Acts of kindness, sacrifice, patience, listening, and presence.
- **Biologically**: Involves neurotransmitters like oxytocin, dopamine, and serotonin -- chemicals that bond us and create attachment.

### Love Is Also a Choice:
Beyond feelings, love is often a decision -- to show up, to forgive, to stay even when it's hard. It's not just a rush of butterflies; it's the quiet commitment to care for someone day after day.

### In Essence:
> **Love is seeing someone's soul -- and choosing to hold it gently.**

It's the reason people write poetry, compose music, risk everything for another, and find meaning in life. Love connects us -- to others, to ourselves, and to something greater than just our individual existence.

So what is love?
It's complicated. It's messy. It's beautiful.
And above all -- it's human. ❤️
--- done ---Al momento della stesura, la versione GGUF di Qwen3-Next non è disponibile, il che significa che non può essere eseguito in locale con Ollama o Llama.cpp. Il modello completo richiede quattro GPU A100 per funzionare in modo efficace, quindi abbiamo optato per una versione quantizzata che ci consente di eseguire il modello su una singola A100 con 80 GB di VRAM. Anche se il download e la configurazione hanno richiesto un po’ di tempo, abbiamo imparato con successo come eseguire l’inferenza.
In questo tutorial abbiamo esplorato il modello Qwen3-Next, che compete con altri modelli proprietari leader per velocità e accuratezza, pur essendo più piccolo.
Dopo aver eseguito il modello in locale, vi abbiamo avuto accesso tramite il comando curl e l’SDK OpenAI per Python. Il prossimo passo del percorso è ottimizzare il modello per la tua macchina specifica. Potremmo esplorare versioni più piccole, come i modelli a 1,2 bit, per aumentare la velocità di inferenza, soprattutto su GPU di fascia bassa.
In alternativa, puoi valutare il noleggio di un server GPU per configurare un tuo server LLM privato; Runpod è un’ottima opzione da considerare.
I migliori corsi DataCamp
Programma
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min