
लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
ओपन‑सोर्स AI बेहद तेज़ी से आगे बढ़ रहा है; नए मॉडल लगभग रोज़ सामने आ रहे हैं, जो पहले के संस्करणों से बेहतर प्रदर्शन करते हैं और साथ ही तेज़, ट्रेन करने में आसान, और अधिक “एजेंट‑रेडी” होते जा रहे हैं।
इस हैंड्स‑ऑन ट्यूटोरियल में, हम Qwen3‑Next को समझेंगे, उसे लोकली चलाएँगे, एक सरल लोकल सर्वर शुरू करेंगे, और आगे चलकर इसे अपनी एप्लिकेशन में इंटीग्रेट करने के लिए सेटअप करेंगे। सबसे अच्छी बात, हम इन्फरेंस और सर्विंग—दोनों के लिए—सिर्फ Hugging Face Transformers फ़्रेमवर्क का उपयोग करेंगे।
अंत तक पहुँचते‑पहुँचते, आप:
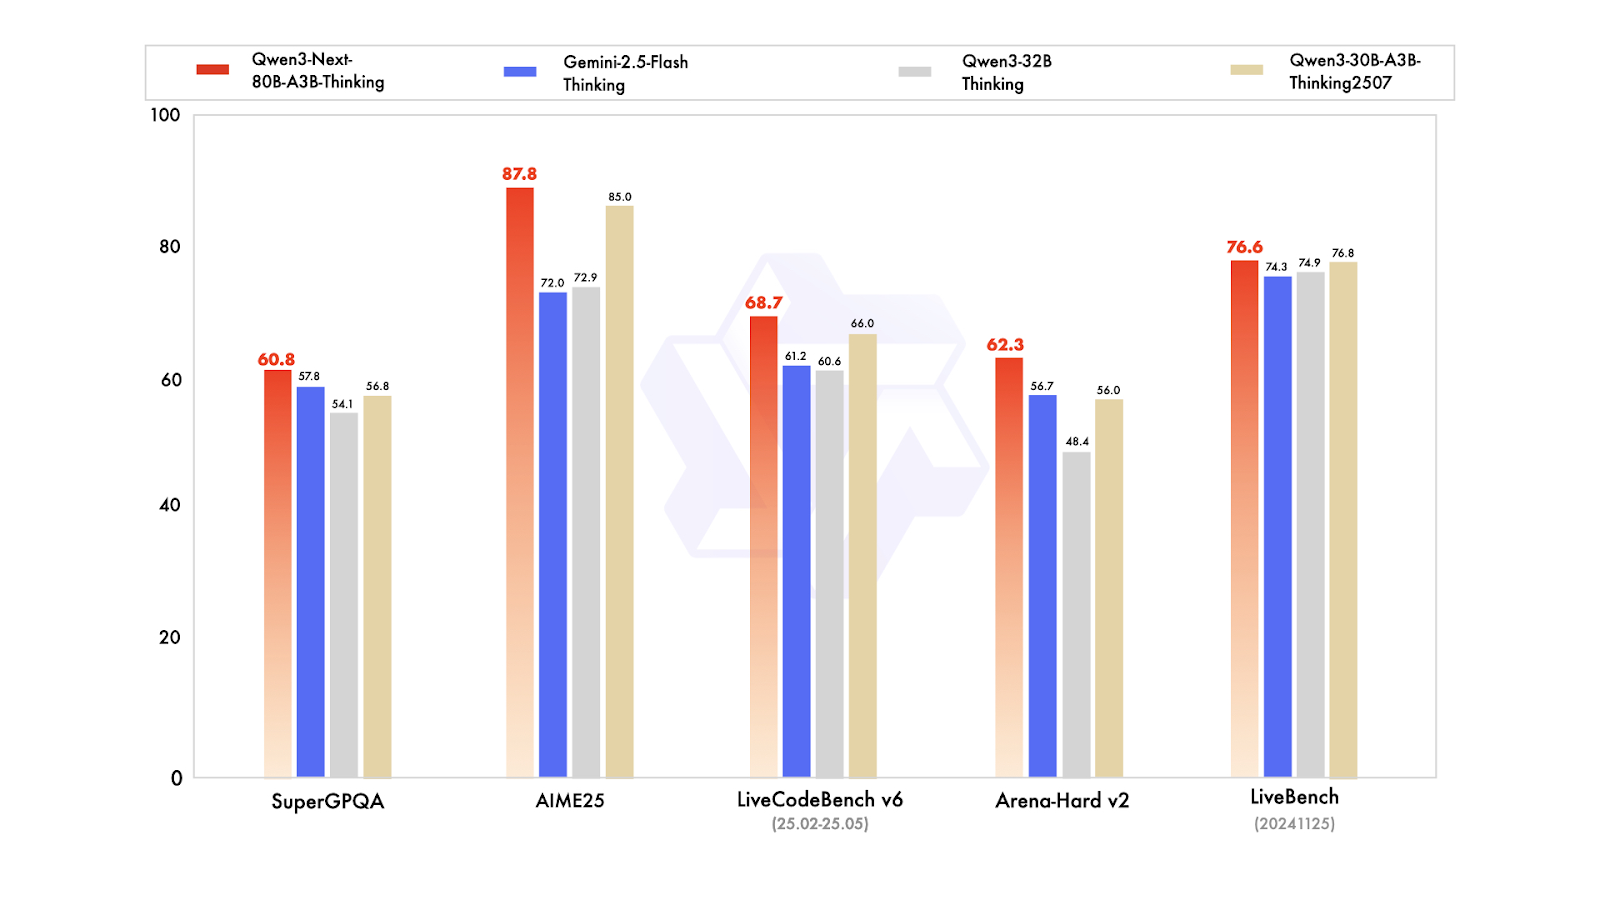
Qwen3-Next एक नई आर्किटेक्चर है, जिसे कॉन्टेक्स्ट लंबाई और कुल पैरामीटर—दोनों—को स्केल करने के लिए डिज़ाइन किया गया है। 80 बिलियन‑पैरामीटर बेस मॉडल इन्फरेंस के दौरान केवल लगभग 3 बिलियन पैरामीटर सक्रिय करता है, जबकि Dense Qwen3-32B मॉडल के समान या उससे थोड़ा बेहतर प्रदर्शन हासिल करता है—वह भी 10% से कम ट्रेनिंग लागत में। यह 32,000 टोकन से अधिक कॉन्टेक्स्ट लंबाई के लिए 10 गुना से अधिक थ्रूपुट भी प्रदान करता है।
पोस्ट‑ट्रेनिंग वेरिएंट्स की बात करें, तो Instruct मॉडल 235 बिलियन‑पैरामीटर फ्लैगशिप मॉडल से टक्कर लेता है और 256,000 टोकन तक की कॉन्टेक्स्ट लंबाई सपोर्ट करता है। साथ ही, Thinking वेरिएंट Qwen3-30B-A3B और Qwen3-32B मॉडलों के साथ‑साथ Gemini-2.5-Flash-Thinking से बेहतर प्रदर्शन करता है, और 235 बिलियन Thinking मॉडल के प्रदर्शन के क़रीब पहुँचता है।
स्रोत: Qwen
Qwen3-Next में नया क्या है:
आप Qwen3‑Next को Hugging Face और ModelScope पर लोकल उपयोग के लिए डाउनलोड कर सकते हैं, या vLLM, SGLang, या Transformers Serve जैसे फ़्रेमवर्क से सर्वर के रूप में डिप्लॉय कर सकते हैं।
Qwen3-Next को लोकली चलाने के लिए, हम मुख्य रिपॉज़िटरी से transformers लाइब्रेरी इंस्टॉल करेंगे, साथ में तेज़ बैकएंड के लिए accelerate, bitsandbytes, flash-linear-attention, और causal-conv1d भी।
इंस्टॉलेशन के बाद, कृपया Jupyter नोटबुक कर्नेल को रिस्टार्ट करें।
%%capture

!pip install git+https://github.com/huggingface/transformers.git@main
!pip install accelerate bitsandbytes

!pip install git+https://github.com/fla-org/flash-linear-attention.git
!pip install git+https://github.com/Dao-AILab/causal-conv1d.git
अब, उचित डेटा टाइप्स और डिवाइस मैप का उपयोग करके टोकनाइज़र और मॉडल डाउनलोड व लोड करें।
हम 4‑बिट क्वांटाइज़्ड मॉडल लोड करेंगे, जो हमारी मेमोरी खपत को चार गुना तक घटा देता है। यानी आपको स्टोरेज स्पेस और इन्फरेंस चलाने के लिए VRAM—दोनों—कम चाहिए होंगे।
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit"

# --- Load tokenizer ---
tokenizer = AutoTokenizer.from_pretrained(model_name)

# --- Load model ---
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    dtype="auto",
)
इसके बाद हम एक प्रॉम्प्ट बनाएँगे, एक संदेश तैयार करेंगे, और उसे चैट टेम्पलेट से गुज़ारेंगे ताकि Qwen3-Next मॉडल द्वारा पहचाने जाने योग्य आवश्यक फ़ॉर्मेटिंग सुनिश्चित हो सके।
# prepare the model input
prompt = "Write a short introduction to large language models, highlighting how learners can explore them through DataCamp's interactive courses and hands-on projects."
messages = [
    {"role": "user", "content": prompt},
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
उसके बाद हम टेक्स्ट को टोकनाइज़ करेंगे, मॉडल से गुज़ारेंगे, और केवल आउटपुट टोकन निकालेंगे। फिर उन्हें डिकोड करके अंतिम प्रतिक्रिया प्रदर्शित करेंगे।
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

content = tokenizer.decode(output_ids, skip_special_tokens=True)

print("content:", content)
आउटपुट बेहतरीन दिखता है:
content: Large language models (LLMs) are advanced AI systems trained on vast amounts of text data to understand, generate, and reason with human language.
From answering questions and writing code to summarizing documents and engaging in conversation, LLMs are transforming how we interact with technology--and how we learn.
At DataCamp, learners can explore the power of LLMs through interactive courses and hands-on projects that bridge theory with real-world application.
Whether you're building your first chatbot, fine-tuning a model with Hugging Face, or evaluating AI-generated text, DataCamp's guided, code-based learning environment lets you experiment safely and effectively--no prior AI expertise required.
Start your journey into the future of language AI today.
कुछ बातें ध्यान में रखें:
आप SGLang या vLLM का उपयोग करके Qwen3‑Next को लोकली सर्व कर सकते हैं, जैसा कि Qwen के मॉडल पेज पर दिखाया गया है। लेकिन इस ट्यूटोरियल में, हम कुछ नया सीखेंगे: Transformers CLI का उपयोग करके मॉडल को सर्व करना और Transformers द्वारा उपलब्ध कराए गए, Ollama जैसे, चैट इंटरफ़ेस से उसे एक्सेस करना।
सबसे पहले, सर्विंग क्षमताओं के साथ Transformers लाइब्रेरी इंस्टॉल करें:
pip install transformers[serving]इसके बाद, अपने टर्मिनल से Transformers सर्वर शुरू करें। यह एक सामान्य सर्वर है, Ollama जैसा।
transformers serveजैसा कि हम देख सकते हैं, सर्वर पोर्ट 8000 पर उपलब्ध होगा:
INFO:     Started server process [3502]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://localhost:8000 (Press CTRL+C to quit)
सर्वर के साथ इंटरैक्ट करने का सबसे आसान तरीका Transformers चैट CLI का उपयोग करना है। यह आपको सर्वर से कनेक्ट होने देता है और आपके टर्मिनल के भीतर चैट‑जैसा इंटरफ़ेस प्रदान करता है।
एक नया टर्मिनल विंडो खोलें और Rich लाइब्रेरी इंस्टॉल करें:
pip install richफिर, मॉडल पाथ के साथ चैट इंटरफ़ेस शुरू करने के लिए निम्न कमांड चलाएँ:
transformers chat localhost:8000 \
  --model-name-or-path unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit
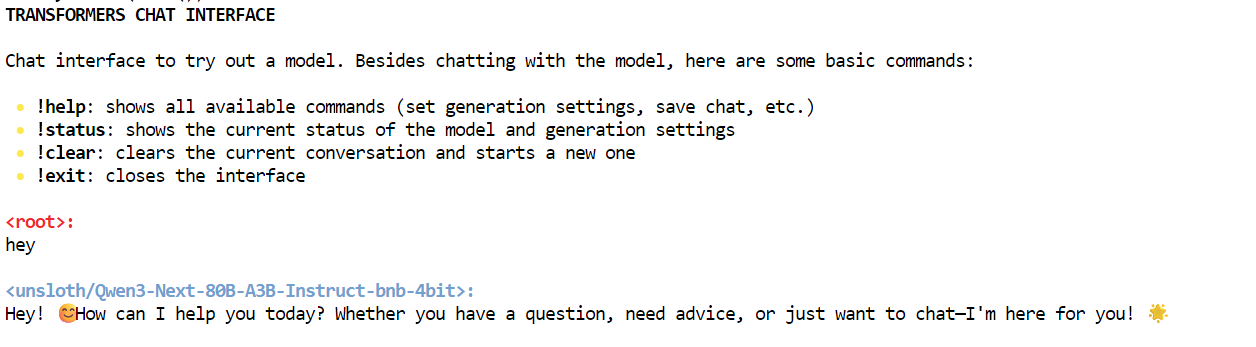
Transformers चैट स्वतः ही तय कर लेगा कि कौन‑सा पहले से डाउनलोड किया गया मॉडल चुनना और लोड करना है। शुरुआत में मॉडल लोड होने में समय लग सकता है, लेकिन उसके बाद आप चैट करना शुरू कर सकते हैं।
जैसा कि आप देख सकते हैं, हम चैट इंटरफ़ेस का उपयोग करके लोकली Qwen3‑Next मॉडल के साथ इंटरैक्ट कर रहे हैं।
सर्वर के साथ इंटरैक्ट करने के कई तरीके हैं। आप Hugging Face Hub के AsyncInferenceClient का उपयोग कर सकते हैं, CURL कमांड चला सकते हैं, Python की requests लाइब्रेरी का उपयोग कर सकते हैं, या OpenAI API के जरिए सर्वर तक पहुँच सकते हैं।
यह सर्वर OpenAI संगत है, यानी आप इसे अपने VSCode, Agentic वर्कफ़्लो में इंटीग्रेट कर सकते हैं, या इसे एक MCP सर्वर के रूप में उपयोग कर सकते हैं।
पहले, नए टर्मिनल में एक साधारण CURL कमांड चलाकर देखें कि सर्वर पर कितने मॉडल उपलब्ध हैं:
curl -s http://localhost:8000/v1/modelsउसके बाद, हम responses API का उपयोग करेंगे। हम इसमें मॉडल, प्रॉम्प्ट देंगे, और स्ट्रीमिंग को false पर सेट करेंगे:
curl -s http://localhost:8000/v1/responses \
  -H "Content-Type: application/json" \
  -d '{
    "model": "unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",
    "input": "One line: what is Qwen3-Next?",
    "stream": false
  }'
नतीजे के तौर पर, इसने Qwen3‑Next मॉडल के बारे में जानकारी वाली प्रतिक्रिया जेनरेट कर दी है।
{"response":{"id":"resp_req_0","created_at":1758494863.6661901,"model":"unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit@main","object":"response","output":[{"id":"msg_req_0","content":[{"annotations":[],"text":"Qwen3-Next is the next-generation large language model in Alibaba's Qwen series, featuring enhanced performance, broader knowledge, and improved reasoning capabilities.","type":"output_text"}],"role":"assistant","status":"completed","type":"message","annotations":[]}],"parallel_tool_calls":false,"tool_choice":"auto","tools":[],"status":"completed","text":{"format":{"type":"text"}}},"sequence_number":40,"type":"response.completed"}इसी तरह, आप एक Python फ़ाइल बनाएँ, नीचे दिया कोड जोड़ें, और चलाएँ।
यह कोड लोकल सर्वर URL के साथ OpenAI क्लाइंट इनिशियलाइज़ करेगा। हम इसे मॉडल नाम, इनपुट देते हैं, और स्ट्रीम के रूप में प्रतिक्रियाएँ जेनरेट करते हैं।
from openai import OpenAI

# Connect to your local server
client = OpenAI(
    base_url="http://localhost:8000/v1",  # transformers serve endpoint
    api_key="not-needed"                  # required by SDK, but can be dummy
)

# Create a streaming response request
response = client.responses.create(
    model="unsloth/Qwen3-Next-80B-A3B-Instruct-bnb-4bit",  # use your loaded model
    instructions="You are a helpful assistant.",
    input="What is love?",
    stream=True,                      # enable SSE streaming
    metadata={"source": "local-test"} # optional metadata
)

# Iterate over server-sent events
for event in response:
    if event.type == "response.output_text.delta":
        # This event contains the incremental text
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        print("\n--- done ---")
हमें स्ट्रीमिंग प्रतिक्रिया के रूप में सटीक परिणाम मिले। यह शानदार है।
Love is one of the most profound, complex, and universal human experiences -- a powerful emotion that defies simple definition but shapes our lives in countless ways.

At its core, **love** is a deep affection, care, and connection toward another person -- or even a thing, idea, or cause. It can manifest in many forms:

### Types of Love (from ancient Greek philosophy):
- **Eros**: Passionate, romantic, or sexual love.
- **Philia**: Deep friendship and platonic affection.
- **Storge**: Familial love -- the natural affection between parents and children.
- **Agape**: Selfless, unconditional love -- often spiritual or altruistic.
- **Ludus**: Playful, flirtatious love.
- **Pragma**: Long-lasting, committed love built on patience and compromise.
- **Philautia**: Self-love -- healthy self-regard that enables us to love others.

### What Love Feels Like:
- **Emotionally**: Warmth, safety, joy, vulnerability, longing, and sometimes pain.
- **Behaviorally**: Acts of kindness, sacrifice, patience, listening, and presence.
- **Biologically**: Involves neurotransmitters like oxytocin, dopamine, and serotonin -- chemicals that bond us and create attachment.

### Love Is Also a Choice:
Beyond feelings, love is often a decision -- to show up, to forgive, to stay even when it's hard. It's not just a rush of butterflies; it's the quiet commitment to care for someone day after day.

### In Essence:
> **Love is seeing someone's soul -- and choosing to hold it gently.**

It's the reason people write poetry, compose music, risk everything for another, and find meaning in life. Love connects us -- to others, to ourselves, and to something greater than just our individual existence.

So what is love?
It's complicated. It's messy. It's beautiful.
And above all -- it's human. ❤️
--- done ---लेखन के समय, Qwen3‑Next का GGUF संस्करण उपलब्ध नहीं है, यानी इसे Ollama या Llama.cpp के जरिए लोकली नहीं चलाया जा सकता। पूर्ण मॉडल को प्रभावी ढंग से चलाने के लिए चार A100 GPUs की आवश्यकता होती है, इसलिए हमने क्वांटाइज़्ड संस्करण चुना जो हमें 80GB VRAM वाले एकल A100 GPU पर मॉडल चलाने देता है। मॉडल डाउनलोड और सेटअप में थोड़ा समय लगा, लेकिन हमने सफलतापूर्वक इन्फरेंस चलाना सीख लिया है।
इस ट्यूटोरियल में, हमने Qwen3‑Next मॉडल का अन्वेषण किया, जो छोटा होने के बावजूद गति और सटीकता के मामले में अन्य अग्रणी प्रोपाइटरी मॉडलों से होड़ लेता है।
लोकली मॉडल चलाने के बाद, हमने उसे curl कमांड और OpenAI Python SDK से एक्सेस किया। हमारी अगली मंज़िल आपके विशेष मशीन के लिए मॉडल का अनुकूलन करना है। हम छोटे संस्करणों—जैसे 1.2‑बिट मॉडल—की जाँच कर सकते हैं ताकि, खासकर लो‑एंड GPUs पर, इन्फरेंस स्पीड बढ़ाई जा सके।
वैकल्पिक रूप से, आप अपना निजी LLM सर्वर सेटअप करने के लिए GPU सर्वर किराए पर लेने पर विचार कर सकते हैं; इस संदर्भ में Runpod एक अच्छा विकल्प है।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स