Tutorial ini merupakan kontribusi berharga dari komunitas kami dan telah disunting untuk kejelasan dan ketelitian oleh DataCamp.
Tertarik berbagi keahlian Anda? Kami ingin mendengarnya! Silakan kirim artikel atau ide Anda melalui Formulir Kontribusi Komunitas.
Model non-linear kini tidak lagi populer seperti dulu. Saat ini, banyak buku melewatkan pembahasan tentang model non-linear atau menjelaskannya secara terbatas. Ternyata, ada sejumlah alasan untuk itu. Pertama, kita dapat menyesuaikan kurva non-linear menggunakan regresi linear dengan menambahkan suku polinomial orde lebih tinggi atau menerapkan fungsi basis (dengan kata lain, menerapkan transformasi log atau sqrt pada variabel penjelas). Kedua, orang mungkin memilih kesederhanaan dibanding model kompleks karena model linear mudah diinterpretasikan dan dijelaskan.
Selain itu, untuk menerapkan model non-linear, penting untuk memvisualisasikan data dan memahami trajektorinya, yang tidak memungkinkan dalam pengaturan multivariat. Terakhir, model non-linear paling cocok untuk kasus mekanistik di mana fenomena bersifat murni fisik atau deterministik, yang bukan merupakan karakter big data, di mana aktivitas pengguna dicatat oleh mesin.
Namun, terlepas dari semua alasan tersebut, pemodelan non-linear adalah ilmu yang indah yang patut dieksplorasi dan dibandingkan dengan padanannya yang linear.
Model Regresi Non-Linear
Teknik estimasi untuk model non-linear secara eksplisit bersifat iteratif. Selain itu, ada perbedaan mendasar dalam cara menerapkan rumus non-linear, yang tidak sama dengan rumus linear. Tiga persamaan/rumus berikut, masing-masing dianggap linear karena hubungan antara variabel y dan B0, B1, serta B2 berupa garis lurus.
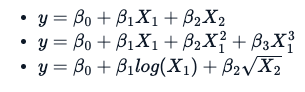
Yang membuat sebuah rumus menjadi non-linear adalah bentuk seperti ini:
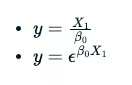
Penggunaan B0 atau B1 bersifat sewenang-wenang. Namun, dua persamaan terakhir tidak memiliki hubungan garis lurus antara variabel y dan B0.
Sayangnya, hal ini membuat perhitungan lebih sulit, dan solusi numerik yang berhasil untuk masalah estimasi tidak dijamin. Jadi, model non-linear hadir dengan peringatan bahwa hasilnya mungkin tidak intuitif atau akurat.
Model Terspesialisasi
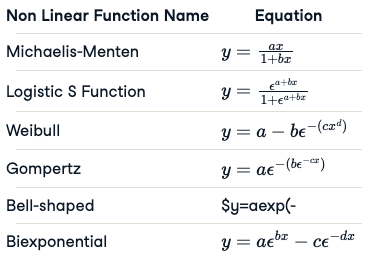
Biasanya, saat menerapkan model non-linear, orang menggunakan tipe-tipe yang terspesialisasi. Ini membuat fitting model non-linear lebih nyaman atau secara numerik lebih mudah, tetapi perlu disepakati oleh pakar domain dan selaras dengan data. Dengan tipe terspesialisasi, maksudnya adalah menggunakan persamaan matematika yang sudah ditentukan. Berikut daftar persamaan non-linear yang paling sering digunakan (sebagian dihilangkan demi ringkasnya).
Strategi dalam Model Regresi Non-Linear
- Visualisasikan data untuk melihat apakah ada fungsi matematika terspesialisasi yang paling tepat menjelaskan data.
- Dengan memperkirakan dari plot atau menggunakan fungsi self-starter (dijelaskan di bawah), pilih nilai parameter awal.
- Lakukan fitting model dan periksa hasilnya.
- Lakukan analisis statistik pada model yang terpasang untuk memahami interval kepercayaan parameter, galat residual, dan variasi yang dijelaskan.
- Cobalah menambahkan lebih banyak parameter ke model jika dapat membantu mengurangi galat residual.
- Selalu pasang model linear dan bandingkan hasil model non-linear serta linear.
Menjelaskan Model Non-Linear Melalui Contoh
Kita akan melakukan fitting model non-linear terspesialisasi pada dataset populer, Puromycin, yang menyajikan laju reaksi dan informasi konsentrasi untuk reaksi enzimatik yang melibatkan sel dengan obat Puromycin. Data ini memiliki dua kelas sel, satu diperlakukan dengan obat Puromycin dan satu lagi tanpa obat ini.
names(Puromycin)Puromycin'conc''rate''state'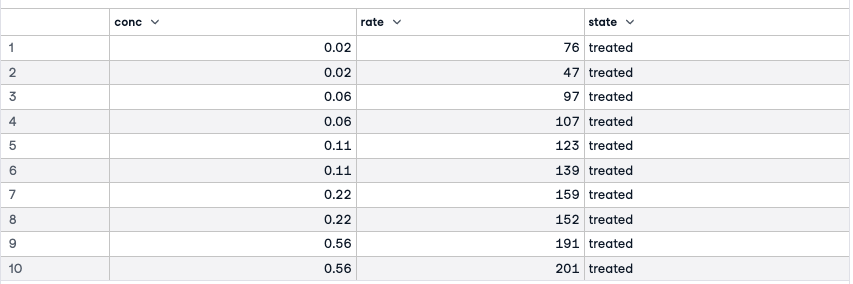
Tiga variabel dalam dataframe ini adalah konsentrasi substrat, laju awal reaksi, dan penanda perlakuan atau tanpa perlakuan.
Dengan memplot laju terhadap konsentrasi dan memberi label dua tingkat perlakuan, kita dapat melihat pola umum. Kurva bersifat asimtotik dan cukup berbeda antara kelompok sel yang diberi perlakuan dan yang tidak.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))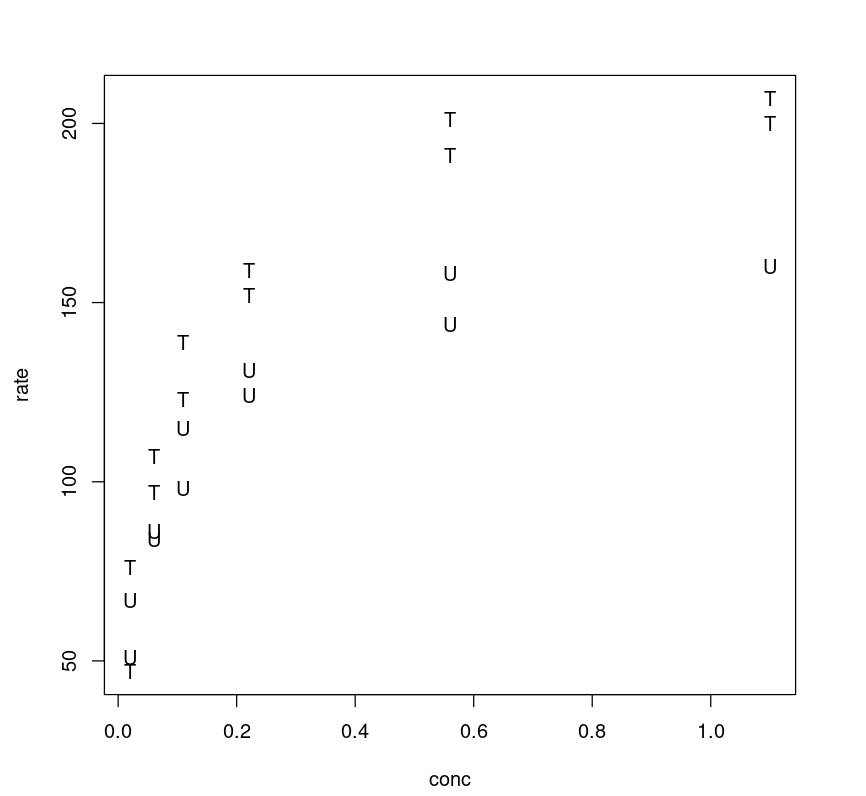
Karena data ini menunjukkan hubungan Michaelis-Menten yang kuat antara laju reaksi dan konsentrasi, para peneliti berharap dapat menyesuaikan persamaan matematika berikut.
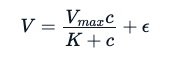
Di sini, E adalah galat eksperimen. Dengan analogi yang sama seperti pada model linear, melalui model non-linear terspesialisasi, kita mencoba mengestimasi parameter Vmax dan K yang akan meminimalkan jumlah kuadrat residual (meskipun ada metode lain yang dapat digunakan untuk mengestimasi parameter-parameter ini):
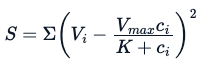
Melakukan Fitting Model Non-Linear
Walaupun kita mengetahui hubungannya, melakukan fitting model non-linear tidaklah sesederhana itu karena model memerlukan tebakan awal untuk Vmax dan K. Jika gagal memilih tebakan awal yang baik, model mungkin menyesuaikan data dengan buruk. Ada dua opsi yang dapat dipilih:
- Memperkirakan dari plot untuk menemukan nilai awal.
- Menggunakan fungsi self-starter (diberikan di bawah).
Fungsi Self-Starter | Model |
SSasymp | model regresi asimtotik |
SSasympOff | model regresi asimtotik dengan offset |
SSasympOrig | model regresi asimtotik melalui titik asal |
SSbiexp | model biexponensial |
SSfol | model kompartemen orde pertama |
SSfpl | model logistik empat parameter |
SSgompertz | model pertumbuhan Gompertz |
SSlogis | model logistik |
SSmicmen | model Michaelis–Menten |
SSweibull | model kurva pertumbuhan Weibull |
Untuk setiap tipe model, tersedia fungsi self-starter yang dapat digunakan sebagai tebakan awal.
Melakukan Fitting Model dengan Tebakan Awal
Dengan nilai awal Vmax = 160, K = 0.05 yang diperoleh dari perkiraan pada plot, kita dapat menggunakan fungsi R nls() untuk melakukan fitting data. Biasanya, untuk regresi linear, kita tidak perlu menentukan parameter Vm atau K, tetapi untuk model non-linear berbeda. Setiap algoritma iteratif memerlukan titik awal yang baik. Jika tidak, bisa gagal konvergen. Berikut cara melakukan fitting model non-linear pada Puromycin dengan nilai awal.
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Menghitung galat residual
Kita menghitung galat residual sebagai berikut:
sse <- Purboth_1$m$deviance()sse7276.54697931423Menghitung varians yang dijelaskan
Untuk mengetahui varians yang dijelaskan oleh model ini (pada dasarnya R-square dalam terminologi model linear), kita perlu mencari total varians pada rate dengan memasang model nol, mengestimasi mean keseluruhan, dan mengekstrak jumlah kuadrat total, sst, dari ringkasan model nol lalu menggunakannya untuk menghitung persentase varians yang dijelaskan.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Model ini menjelaskan 85,34% variasi pada data.
Fitting Menggunakan Model dengan Fungsi Self-Start
Karena kita menggunakan model Michaelis-Menten, kita bisa memakai fungsi self-start SSmicmen(). Namun, hasilnya sama.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Menghitung galat residual
sse <- Purboth_self$m$deviance()sse7276.54697947673Menghitung Varians yang Dijelaskan
Kita dapat memeriksa varians yang dijelaskan oleh model.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141Secara umum, persamaan yang terpasang, yaitu hubungan antara rate vs concentration, terlihat seperti ini:
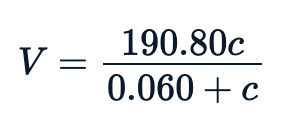
Memvisualisasikan Hasil Fitting
Kita dapat memvisualisasikan kinerja model dengan menggambar garis hasil fitting pada data, yang terlihat non-linear.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Pemilihan Model yang Lebih Baik
Model dapat disetel lebih lanjut dengan menambahkan lebih banyak parameter. Jika mengamati plot antara laju vs konsentrasi, Anda mungkin memperhatikan bahwa kelas yang berbeda (treated vs untreated) mengikuti trajektori yang berbeda, dan perbedaan laju (sumbu y) antara dua trajektori kelas dapat didekati sekitar 40.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))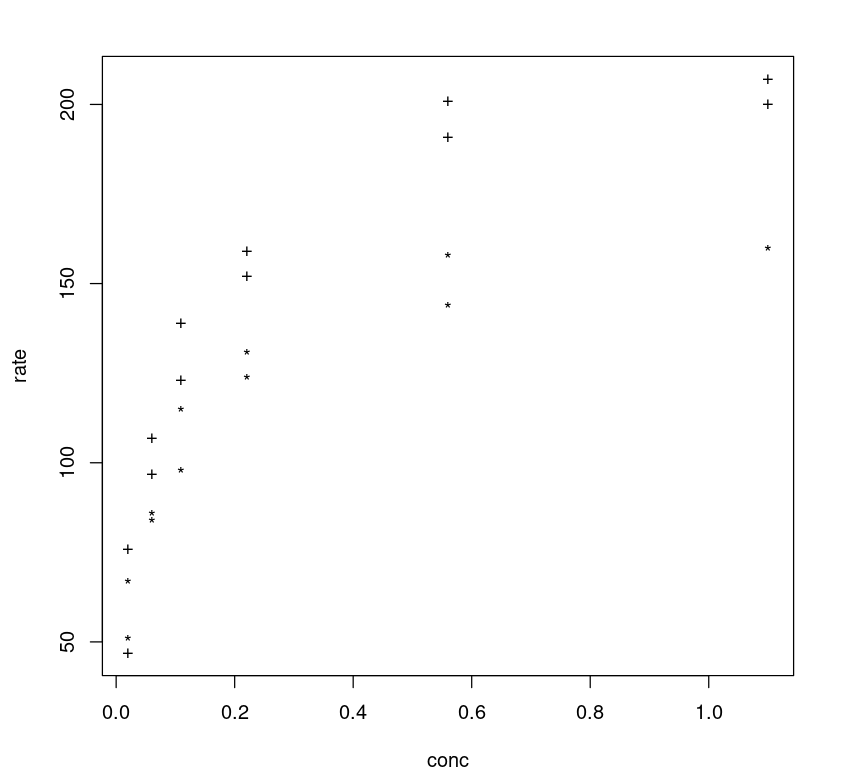
Intinya, kita mencoba memasang model dengan mengondisikan pada variabel state, yang menghasilkan persamaan non-linear berikut.
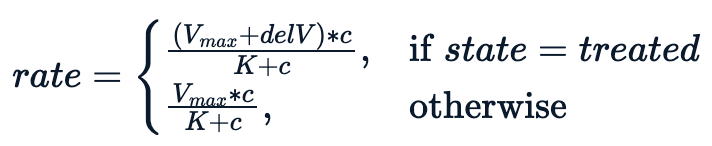
Model berkinerja lebih baik dengan parameter tambahan delV. Kita tetapkan nilai awal 40 untuk delV dan memasang model menggunakan nls dengan tiga parameter.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06Ringkasan menunjukkan bahwa ketiga parameter tersebut signifikan secara statistik.
Menghitung Galat Residual
Untuk model ini, galat residual berkurang secara substansial:
sse <- Purboth$m$deviance()sse2240.89143883885Menghitung Varians yang Dijelaskan
Lebih banyak varians yang dijelaskan oleh model ini.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744Pemeriksaan AIC
Kita juga dapat melakukan pemeriksaan AIC pada kedua model, meskipun praktik umum saat ini adalah menggunakan validasi silang, namun itu umumnya memerlukan lebih banyak data. Secara umum, AIC yang lebih rendah menandakan model yang lebih baik.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742Memvisualisasikan Hasil Fitting
Kita dapat memvisualisasikan kinerja model yang disetel dengan menggambar garis hasil fitting pada data. Tak mengejutkan, model yang disetel memberikan fitting yang lebih baik untuk kelas yang berbeda.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))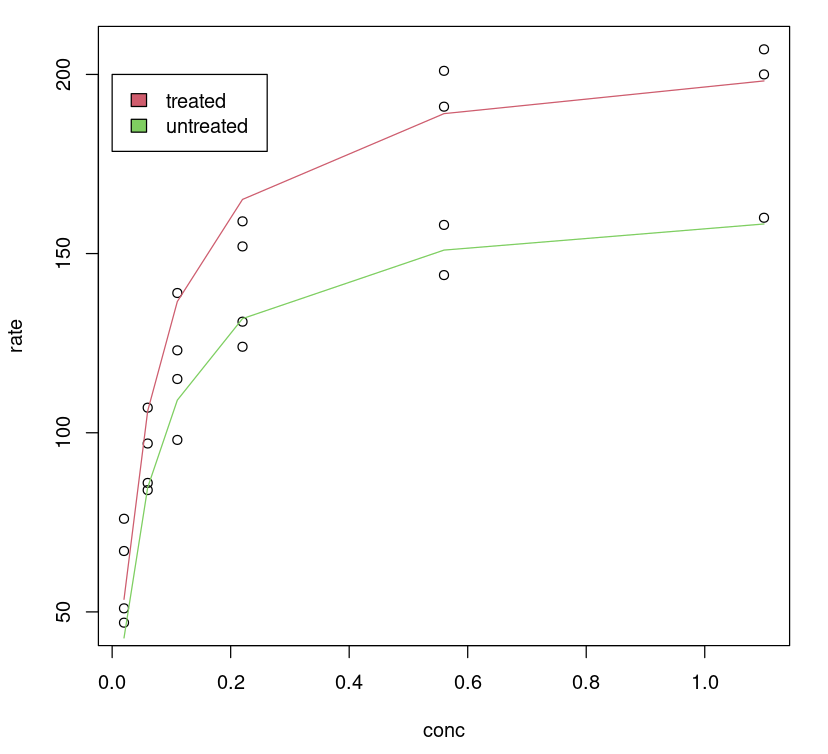
Interval Kepercayaan Parameter
Kita tidak bisa hanya bergantung pada p-value; interval kepercayaan 95% memberikan nilai koefisien untuk setiap parameter signifikan pada 2,5% dan 97,5%. Tak satu pun yang mencakup 0.
confint(Purboth)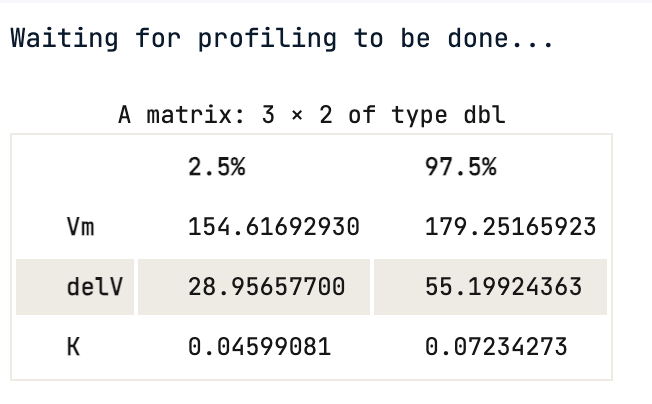
Dengan menggunakan nilai interval kepercayaan, kita dapat menyatakan secara statistik bahwa ada peluang 95% bahwa nilai sebenarnya dari parameter misalnya Vmax berada dalam rentang yang diberikan di atas, yaitu (154,62, 179,25) untuk Vmax.
Profiling
Model dapat diprofilkan lebih lanjut untuk memahami ketidakpastian dalam estimasi parameter dengan memeriksa fungsi objektif secara langsung. Dalam model kita, ada tiga parameter, Vmax, delV, K yang dapat kita profilkan:
- Untuk mendapatkan interval kepercayaan.
- Dan menggunakan fungsi profil t, yang mirip dengan t-statistik yang digunakan pada model linear. Plot fungsi profil t memberikan interval likelihood untuk parameter individual dan menjelaskan seberapa non-linear estimasinya.
Memplot interval kepercayaan
Ini memplot interval kepercayaan parameter untuk berbagai nilai (yang berkorespondensi dengan interval kepercayaan berbeda: 99%, 95%, 90%, 80% dan 50%). Ini serupa dengan interval kepercayaan (95%) yang diberikan oleh confint(object, parm, level = 0.95, ...)function.
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)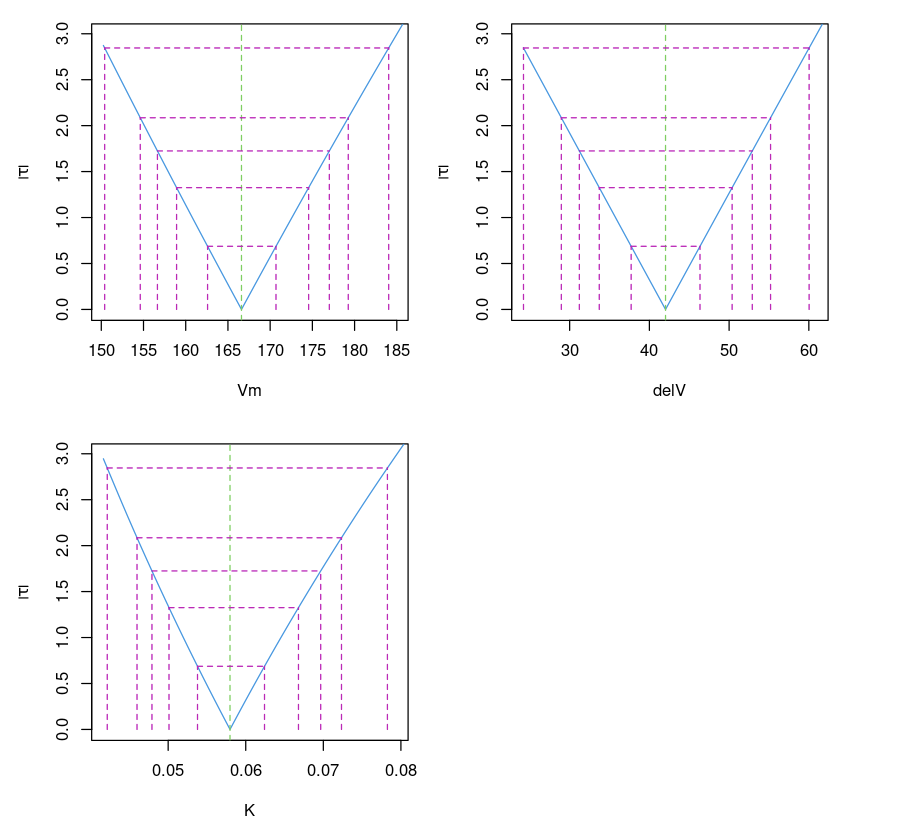
Memplot T vs parameter
Memplot tiga parameter Vmax, delV, K terhadap T memberi gambaran apakah fitting bersifat linear atau non-linear. Dapat diamati bahwa garis tampak linear untuk parameter delV dan Vm, serta sedikit melengkung untuk K. Ini wajar karena parameter K menunjukkan hubungan non-linear.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")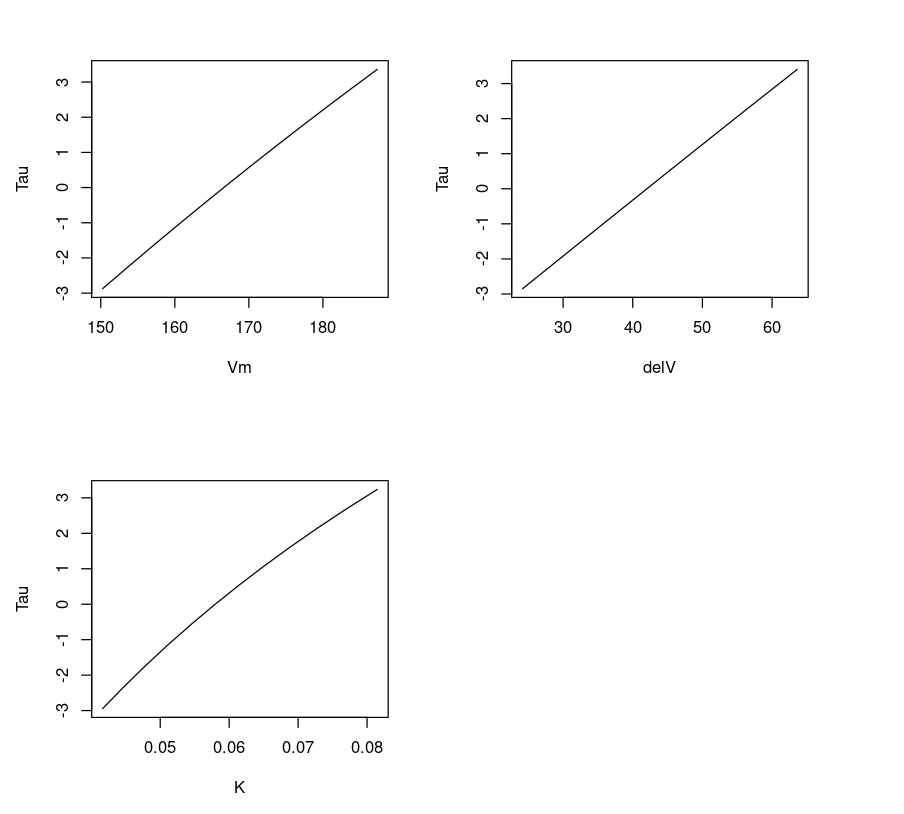
Melakukan Fitting Model Linear
Kita dapat menggunakan fungsi pustaka R yang sama, nls(), untuk memasang model linear seperti di bawah ini. Menurut saya, adalah kebiasaan yang baik untuk selalu mencoba model linear demi interpretabilitas dan perbandingan.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Walaupun parameter terlihat signifikan, fitting-nya buruk. Galat standar residualnya tinggi.
Memvisualisasikan Hasil Fitting
Tampaknya model linear berkinerja buruk; kita dapat memvisualisasikannya dengan menggambar garis hasil fitting pada data dan membandingkannya dengan padanan non-linear.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)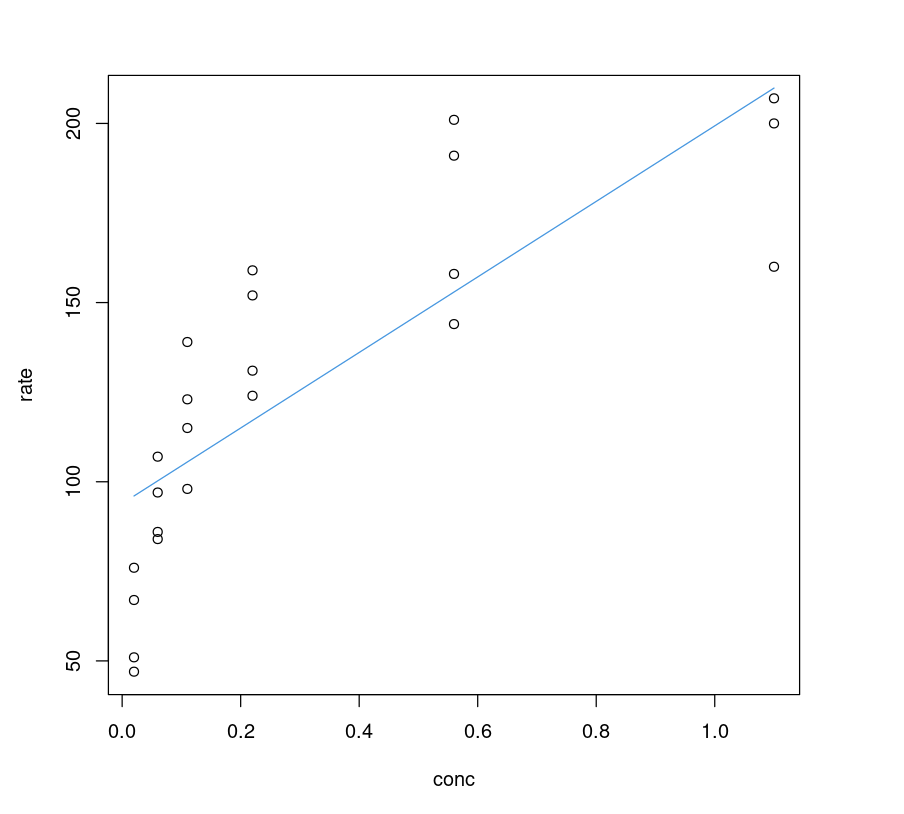
Membandingkan Model Non-Linear vs Linear Secara Analitis
Dari plot di atas, kita tahu model linear berkinerja buruk, tetapi bagaimana cara membandingkan model-model ini? Ini seperti membandingkan apel dan jeruk. Hasil AIC tidak dapat langsung digunakan.
Goodness of Fit
Apa yang dimaksud fitting yang baik—untuk regresi, yaitu nilai prediksi dan aktual sedekat mungkin. Jadi jika kita memeriksa kualitas prediksi suatu model menggunakan fungsi R lm(), kita dapat membandingkannya. Model yang lebih akurat akan memiliki titik-titik yang jatuh dekat dengan garis ideal. Garis ideal adalah model yang 100% akurat—prediksi sama dengan nilai aktual untuk setiap titik data. Oleh karena itu, semua titik akan berada pada garis lurus.
Fitting Non-Linear
Untuk setiap titik data masukan, kita gunakan model untuk memprediksi nilai target lalu terapkan fungsi lm() seperti ditunjukkan. Dengan memplot sebar antara laju aktual (sumbu x) dan laju prediksi (sumbu y) serta menggambar garis ideal, kita dapat mengamati seberapa dekat titik-titik dengan garis tersebut.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104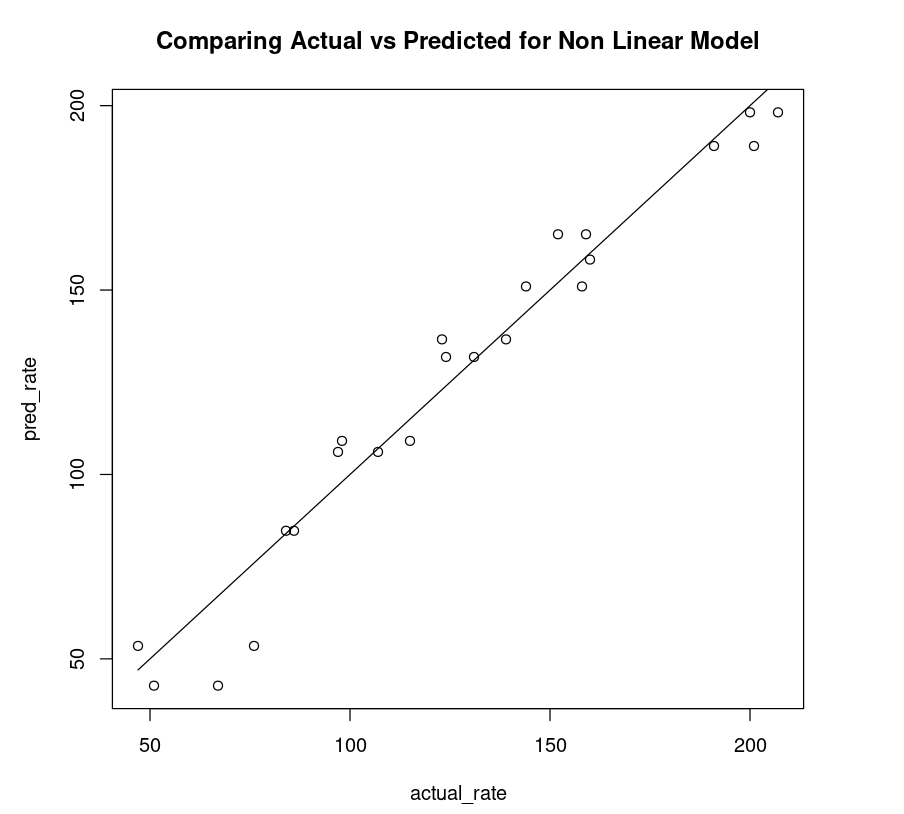
Fitting Linear
Plot non-linear di atas jelas lebih baik dibandingkan plot linear (di bawah).
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551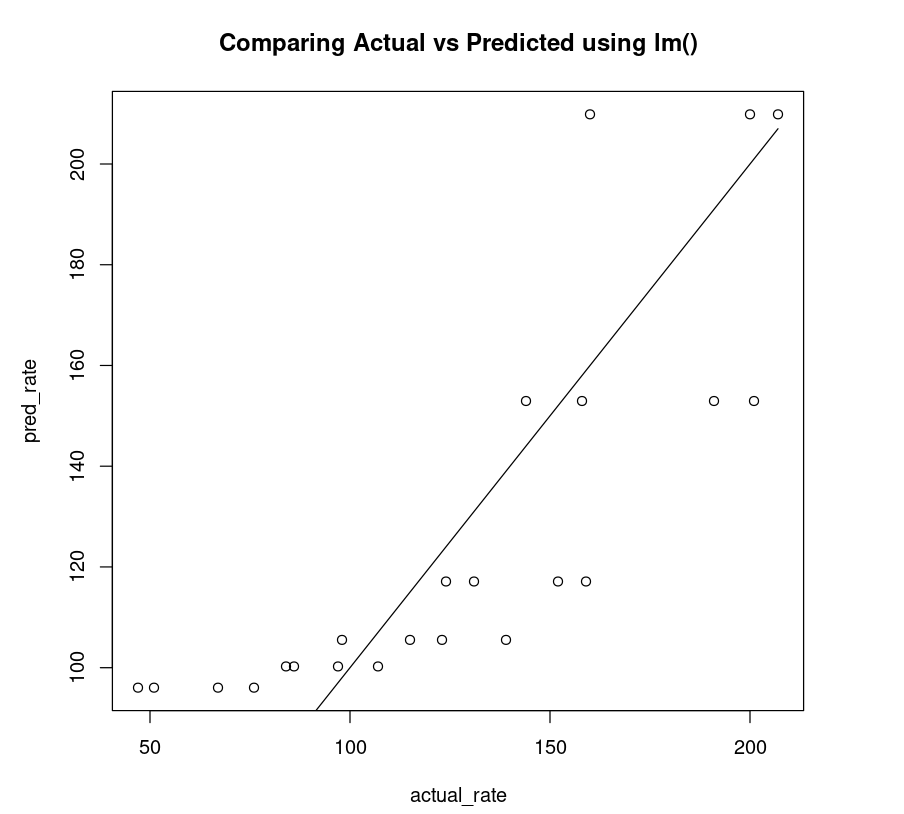
Meningkatkan Model Linear
Sepertinya kita tidak adil pada model linear karena jelas data tidak mengikuti garis lurus, jadi kita dapat mencoba memasang model menggunakan data yang ditransformasikan. Kita pilih sqrt() untuk mentransformasi conc dan memasang model linear seperti di bawah.
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09Memang, ada penurunan galat standar residual, tetapi tidak sebesar yang kita harapkan.
Memplot hasil fitting
Terlihat jelas bahwa menggunakan sqrt() pada conc memperbaiki model linear. Namun, dibandingkan dengan model non-linear Purboth, ini tidak lebih baik. Galat standar residual model PurbothLinearSqrt hampir dua kali lipat Purboth, sehingga kita tidak akan menganalisis model ini lebih lanjut. Anda bisa mencoba memasang suku polinomial orde lebih tinggi (menggunakan regresi polinomial), tetapi upaya yang diperlukan untuk menyetelnya jauh lebih besar, sementara hasil yang lebih baik dapat dicapai dengan model non-linear.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)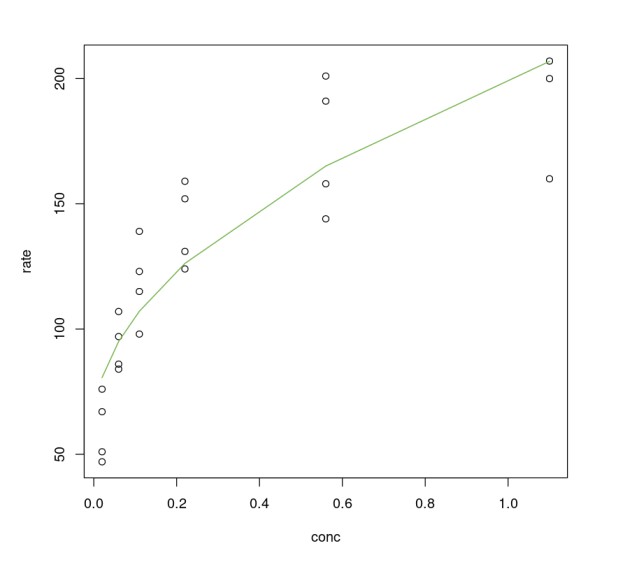
Membuka Lipatan Persamaan Non-Linear
Ada trik untuk membuka lipatan fungsi non-linear dan memasang model linear. Teknik ini digunakan di masa lalu ketika perhitungan dilakukan manual, bukan oleh komputer. Namun, model seperti itu gagal memberikan kinerja yang lebih baik.
Mengonversi Non-Linear ke Bentuk Linear
Sebagai ilustrasi, kita dapat mengubah persamaan Michaelis-Menten dengan mengambil inversnya, seperti ditunjukkan di bawah, dan menggunakan bentuk yang dimodifikasi untuk menerapkan model linear.
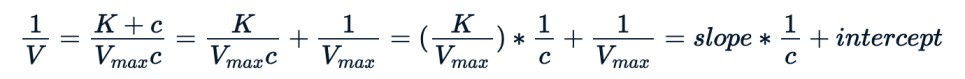
Kita dapat menggunakan nls() yang sama untuk memasang persamaan baru.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09Galat standar residualnya rendah, tetapi data yang digunakan tidak dapat dibandingkan dengan model non-linear. Pilihan terbaik adalah memvisualisasikan bagaimana kedua model berkinerja pada dataset asli.
Memplot hasil fitting
Kita membandingkan model Purboth_1, yang menggunakan dua parameter Vmax, K dengan PurbothPseudoLinear. Plot menunjukkan dengan jelas bahwa model non-linear bekerja lebih baik.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))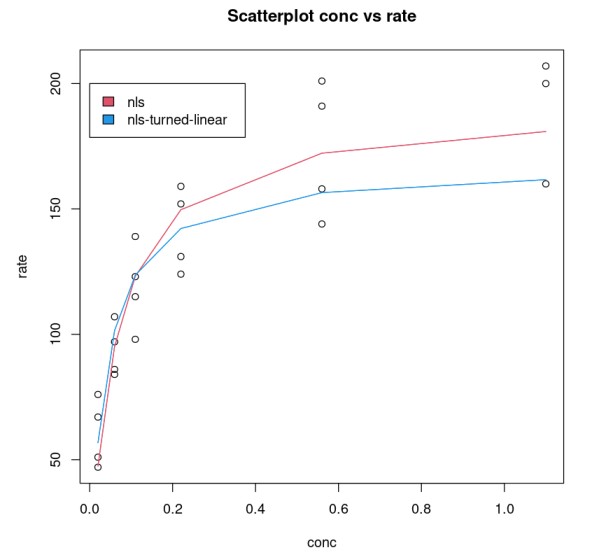
Goodness of Fit
Kita dapat membandingkan kelayakan model.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Ini menunjukkan bahwa model yang menggunakan fungsi non-linear berkinerja jauh lebih baik.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)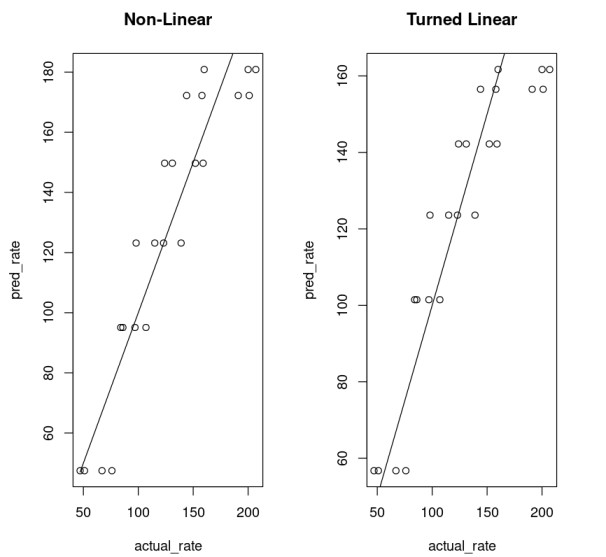
Kesimpulan
Model non-linear berkinerja lebih baik daripada padanannya yang linear, terutama pada kasus dengan data mekanistik. Namun, model non-linear tidak menjamin solusi numerik untuk masalah estimasi. Kita dapat memplot dan memilih fungsi matematika yang paling mungkin menjelaskan hubungan antardata. Dalam kasus seperti itu, model non-linear dapat melampaui model linear.
Jika Anda merasa artikel ini mencerahkan dan ingin menyelami lebih dalam dunia model regresi, lihat kursus DataCamp Intermediate Regression in R.



