Deze tutorial is een gewaardeerde bijdrage uit onze community en is door DataCamp bewerkt voor helderheid en nauwkeurigheid.
Wil je je eigen expertise delen? We horen graag van je! Dien je artikelen of ideeën in via ons Community Contribution Form.
Niet-lineaire modellen zijn niet meer zo populair als vroeger. Tegenwoordig slaan veel boeken een bespreking van niet-lineaire modellen over of behandelen ze het slechts beperkt. Daar zijn blijkbaar goede redenen voor. Ten eerste kun je een niet-lineaire curve fitten met lineaire regressie door hogere-orde polynoomtermen te gebruiken of een basisfunctie toe te passen (met andere woorden: een log- of worteltransformatie op de verklarende variabelen). Ten tweede kun je kiezen voor eenvoud boven complexiteit, omdat lineaire modellen makkelijk te interpreteren en uit te leggen zijn.
Daarnaast is het voor het toepassen van een niet-lineair model belangrijk om de data te visualiseren en gevoel te krijgen voor het verloop, wat in een multivariabele setting niet mogelijk is. Tot slot zijn niet-lineaire modellen vooral geschikt voor mechanistische gevallen waarbij de verschijnselen puur fysisch of deterministisch zijn, wat niet geldt voor big data, waar gebruikersactiviteiten door machines worden gelogd.
Toch is niet-lineaire modellering, ondanks al deze goede redenen, een mooie tak van wetenschap die het verdient om verkend en vergeleken te worden met het lineaire tegenhanger.
Niet-lineair regressiemodel
De schattingstechnieken voor een niet-lineair model zijn expliciet iteratief. Bovendien is er een fundamenteel verschil in hoe je een niet-lineaire formule toepast, die niet hetzelfde is als een lineaire formule. De volgende drie verschillende vergelijkingen/formules worden elk als lineair beschouwd omdat de relatie tussen variabele y en B0, B1 en B2 een rechte lijn is.
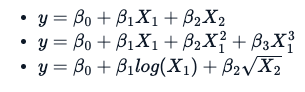
Wat een formule niet-lineair maakt, is iets als dit:
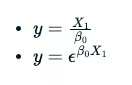
Het gebruik van B0 of B1 is willekeurig. De laatste twee vergelijkingen hebben echter geen lineaire relatie tussen variabele y en B0.
Helaas maakt dit de berekeningen lastiger, en is een succesvolle numerieke oplossing voor het schattingsprobleem niet gegarandeerd. Niet-lineaire modellen komen dus met de waarschuwing dat de uitkomsten niet altijd intuïtief of nauwkeurig zijn.
Gespecialiseerd model
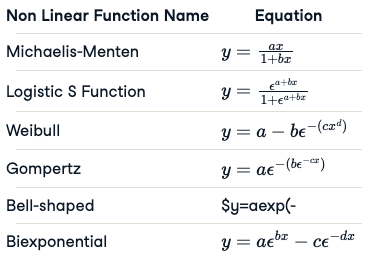
Meestal gebruikt men bij een niet-lineair model een gespecialiseerd type. Dat maakt het fitten van een niet-lineair model handiger of numeriek eenvoudiger, maar het moet wel worden afgestemd met een inhoudsexpert en aansluiten op de data. Met gespecialiseerde types bedoelen we dat je een vooraf gedefinieerde wiskundige vergelijking gebruikt. Hier is een lijst met de meest gebruikte niet-lineaire vergelijkingen (sommige zijn voor de beknoptheid weggelaten).
Aanpak voor een niet-lineair regressiemodel
- Visualiseer de data om te zien of een gespecialiseerde wiskundige functie de data het beste kan verklaren.
- Kies de initiële parameterwaarden door de plot te schatten op het oog of met een self-starterfunctie (hieronder uitgelegd).
- Fit het model en bekijk het resultaat.
- Voer een statistische analyse uit op het gefitte model om het betrouwbaarheidsinterval van parameters, residuele fout en verklaarde variatie te begrijpen.
- Probeer meer parameters toe te voegen aan het model als dat helpt de residuele fout te verkleinen.
- Fit altijd ook een lineair model en vergelijk de resultaten van niet-lineaire en lineaire modellen.
Het niet-lineaire model uitleggen met een voorbeeld
We gaan een gespecialiseerd niet-lineair model fitten op een bekende dataset, Puromycin, die de reactiesnelheid en de concentratie-informatie geeft voor een enzymatische reactie met cellen die behandeld zijn met het medicijn Puromycin. De data bevat twee klassen cellen: één behandeld met Puromycin en één zonder dit middel.
names(Puromycin)Puromycin'conc''rate''state'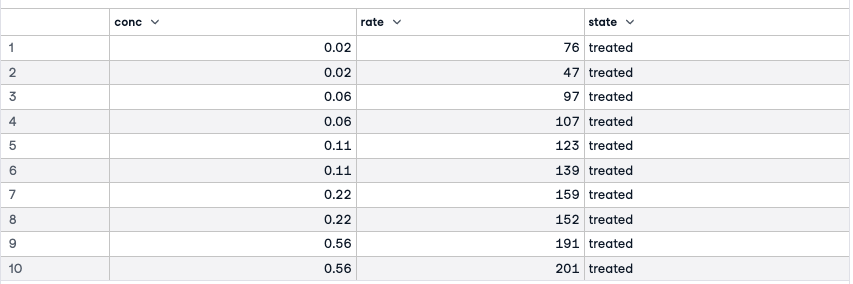
De drie variabelen in dit dataframe zijn de concentratie van het substraat, de initiële reactiesnelheid en een indicator voor behandeld of onbehandeld.
Door de snelheid uit te zetten tegen de concentratie en de twee behandelingsniveaus te labelen, zien we een algemeen patroon. De curves zijn asymptotisch en duidelijk verschillend voor de cohorten van behandelde en onbehandelde cellen.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))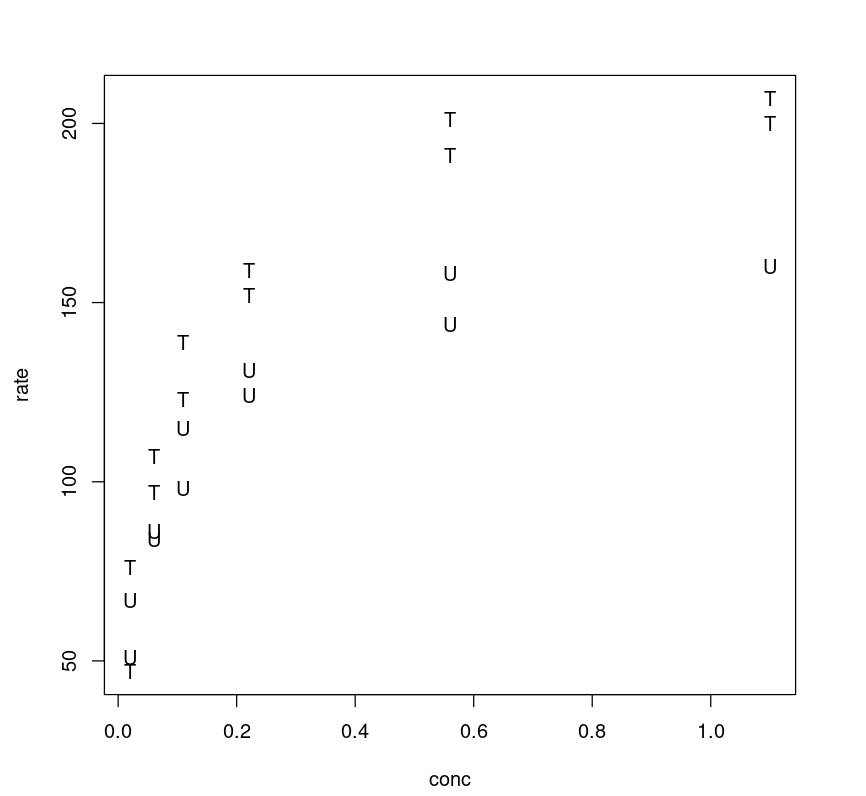
Omdat deze data een sterke Michaelis-Menten-relatie vertoont tussen reactiesnelheid en concentratie, verwachten de onderzoekers dat de volgende wiskundige vergelijking past.
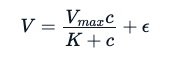
Hier is E de experimentele fout. Met dezelfde analogie als bij het lineaire model proberen we via een gespecialiseerd niet-lineair model de parameters Vmax en K te schatten die de som van de kwadraten van de residuen minimaliseren (al zijn er andere methoden om deze parameters te schatten):
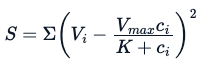
Een niet-lineair model fitten
Ook al kennen we de relatie, een niet-lineair model fitten is niet zo eenvoudig omdat het model initiële schattingen vereist voor Vmax en K. Als je geen goede beginschatting kiest, kan het model de data slecht fitten. Je hebt twee opties:
- Ofwel schat je de initiële waarden op het oog uit de plot.
- Of je gebruikt een self-starterfunctie (hieronder gegeven).
Self-starterfunctie | Model |
SSasymp | asymptotisch regressiemodel |
SSasympOff | asymptotisch regressiemodel met offset |
SSasympOrig | asymptotisch regressiemodel door de oorsprong |
SSbiexp | biexponentieel model |
SSfol | ééncompartimentmodel van eerste orde |
SSfpl | logistisch model met vier parameters |
SSgompertz | Gompertz-groeimodel |
SSlogis | logistisch model |
SSmicmen | Michaelis–Menten-model |
SSweibull | Weibull-groeicurvemodel |
Voor elk modeltype is er een bijbehorende self-starterfunctie die je kunt gebruiken voor een initiële schatting.
Een model fitten met een initiële schatting
Met de initiële waarden Vmax = 160, K = 0,05 op het oog geschat uit de plot, kun je de R-functie nls() gebruiken om de data te fitten. Bij lineaire regressie hoeven we de parameters Vm of K meestal niet te specificeren, maar bij een niet-lineair model is dat anders. Elk iteratief algoritme heeft een goed startpunt nodig; anders kan het niet convergeren. Zo fitten we een niet-lineair model op Puromycin met initiële waarden.
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Residuele fout berekenen
We berekenen de residuele fout als:
sse <- Purboth_1$m$deviance()sse7276.54697931423De verklaarde variantie berekenen
Om de verklaarde variantie van dit model te vinden (feitelijk de R-kwadraat in terminologie van lineaire modellen), moeten we de totale variantie in rate vinden door een nulmodel te fitten, het algemene gemiddelde te schatten en de totale som van kwadraten, sst, uit de samenvatting van het nulmodel te halen en dat vervolgens gebruiken om het percentage verklaarde variantie te berekenen.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Dit model verklaart 85,34% van de variatie in de data.
Fitten met een model met self-starterfunctie
Omdat we het Michaelis-Menten-model gebruiken, kun je in plaats daarvan de self-starterfunctie SSmicmen() gebruiken. Dit geeft echter dezelfde resultaten.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Residuele fout berekenen
sse <- Purboth_self$m$deviance()sse7276.54697947673De verklaarde variantie berekenen
Je kunt de door het model verklaarde variantie controleren.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141In het algemeen ziet de gefitte vergelijking, de relatie tussen snelheid en concentratie, er zo uit:
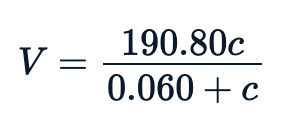
De fit visualiseren
Je kunt visualiseren hoe het model presteert door een gefitte lijn op de data te plotten, die er niet-lineair uitziet.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Betere modelselectie
Je kunt het model verder afstemmen door meer parameters toe te voegen. Als je de plot van snelheid versus concentratie bekijkt, valt op dat verschillende klassen (behandeld vs. onbehandeld) verschillende trajecten volgen, en dat het snelheidsverschil (y-as) tussen de twee klassen ongeveer 40 is.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))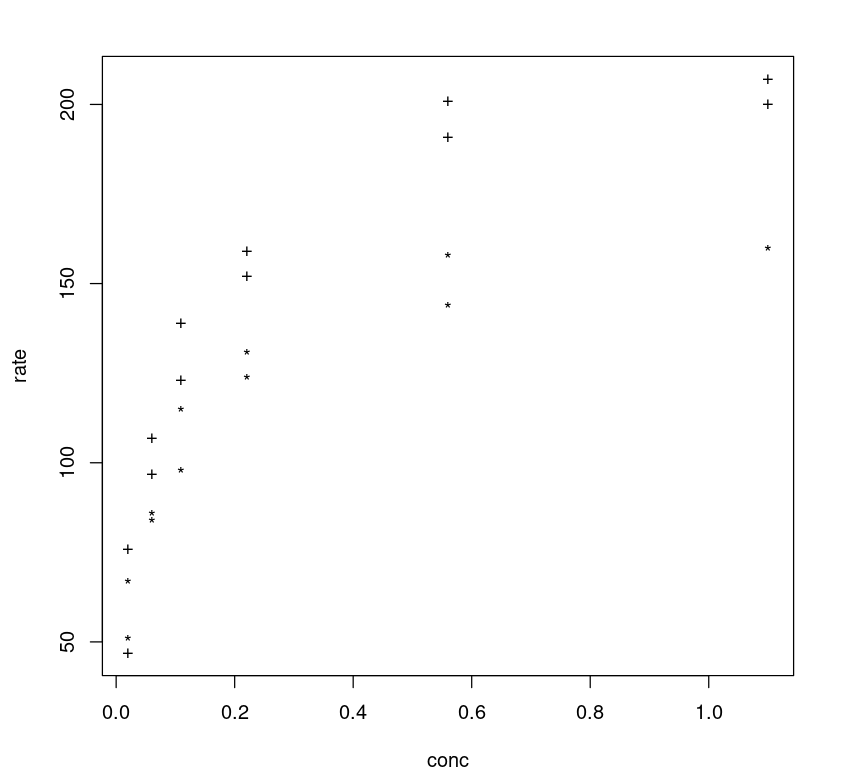
In essentie proberen we een model te fitten geconditioneerd op de variabele state, wat leidt tot de volgende niet-lineaire vergelijking.
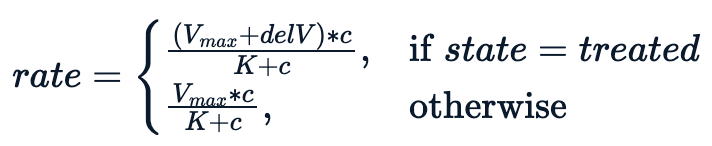
Het model presteert beter met een extra parameter delV. We geven delV een initiële waarde van 40 en fitten het model met nls met drie parameters.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06De samenvatting laat zien dat alle drie de parameters statistisch significant zijn.
Residuele fout berekenen
Voor dit model zie je dat de residuele fout aanzienlijk afneemt:
sse <- Purboth$m$deviance()sse2240.89143883885De verklaarde variantie berekenen
Dit model verklaart meer variantie.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744AIC-check
Je kunt ook de AIC-check uitvoeren op beide modellen, hoewel het tegenwoordig gebruikelijker is om cross-validatie te gebruiken. Daarvoor is in het algemeen meer data nodig; hoe lager de AIC, hoe beter het model.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742De fit visualiseren
Je kunt visualiseren hoe het afgestemde model presteert door een gefitte lijn op de data te tekenen. Niet verrassend geeft het afgestemde model een betere fit voor de verschillende klassen.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))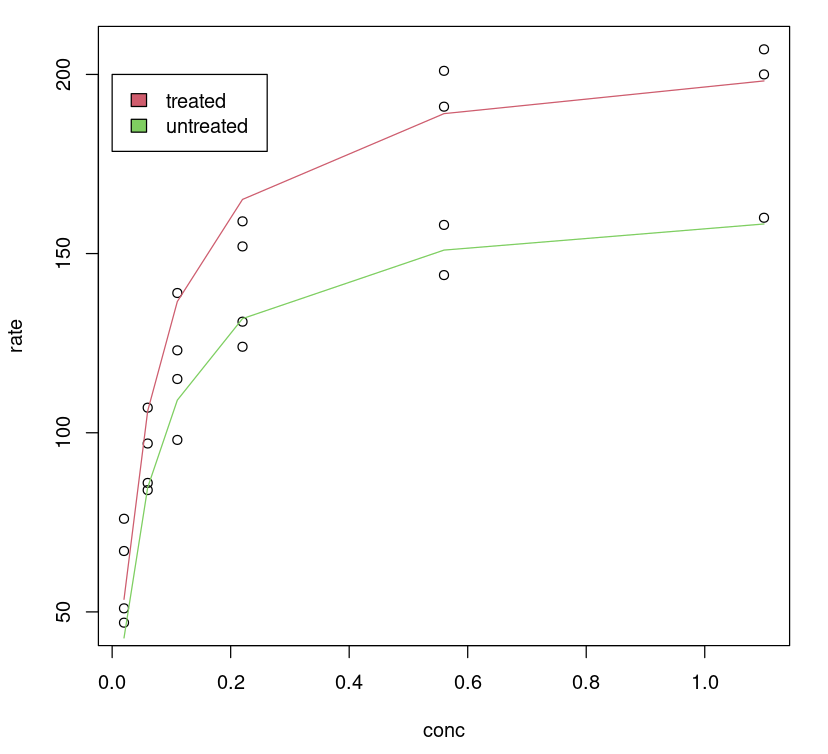
Betrouwbaarheidsinterval van parameters
Je kunt niet alleen op p-waarden vertrouwen; het 95%-betrouwbaarheidsinterval geeft de coëfficiëntwaarden voor elke significante parameter bij 2,5% en 97,5%. Geen van beide omvat 0.
confint(Purboth)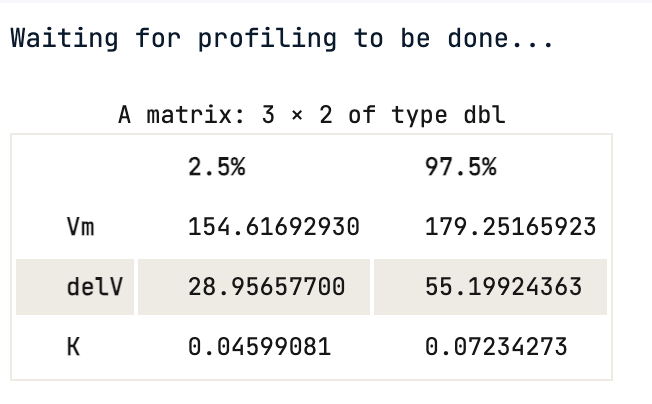
Met het betrouwbaarheidsinterval kun je statistisch zeggen dat er 95% kans is dat de werkelijke waarde van de parameter, bijvoorbeeld Vmax, binnen het bovenstaande bereik valt, wat (154,62, 179,25) is voor Vmax.
Profiling
Je kunt het model verder profileren om de onzekerheid in de parameterschatting te begrijpen door de doelfunctie rechtstreeks te onderzoeken. In ons model hebben we drie parameters, Vmax, delV, K; die kunnen we profileren:
- Om het betrouwbaarheidsinterval te krijgen.
- En de profilefunctie t te gebruiken, vergelijkbaar met de t-statistiek bij het lineaire model. Plots van de profile t-functie geven de likelihood-intervallen voor individuele parameters en laten zien hoe niet-lineair de schatting is.
Het betrouwbaarheidsinterval plotten
Dit plot toont het betrouwbaarheidsinterval van parameters voor verschillende waarden van (wat overeenkomt met verschillende betrouwbaarheidsintervallen: 99%, 95%, 90%, 80% en 50%). Het is vergelijkbaar met het betrouwbaarheidsinterval (95%) gegeven door confint(object, parm, level = 0.95, ...)function.
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)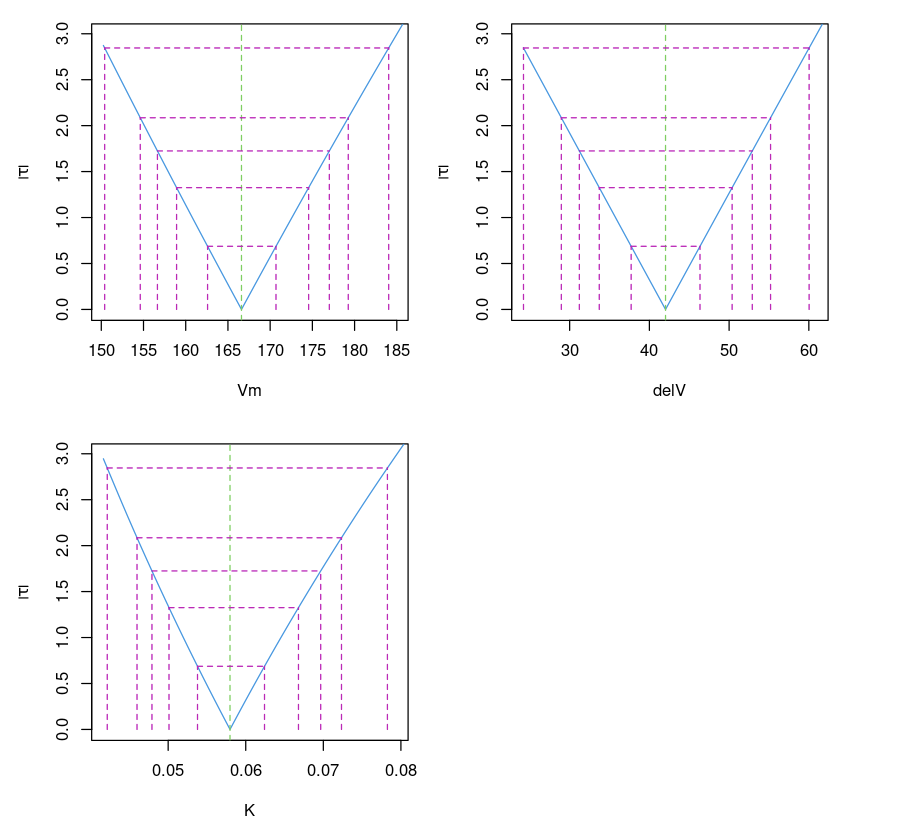
Plotten van T versus parameters
Het plotten van de drie parameters Vmax, delV, K tegen T geeft een gevoel of de fit lineair of niet-lineair is. Je ziet dat de lijn lineair lijkt voor de parameters delV en Vm, en licht gekromd voor K. Dat is te verwachten omdat parameter K een niet-lineaire relatie vertoont.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")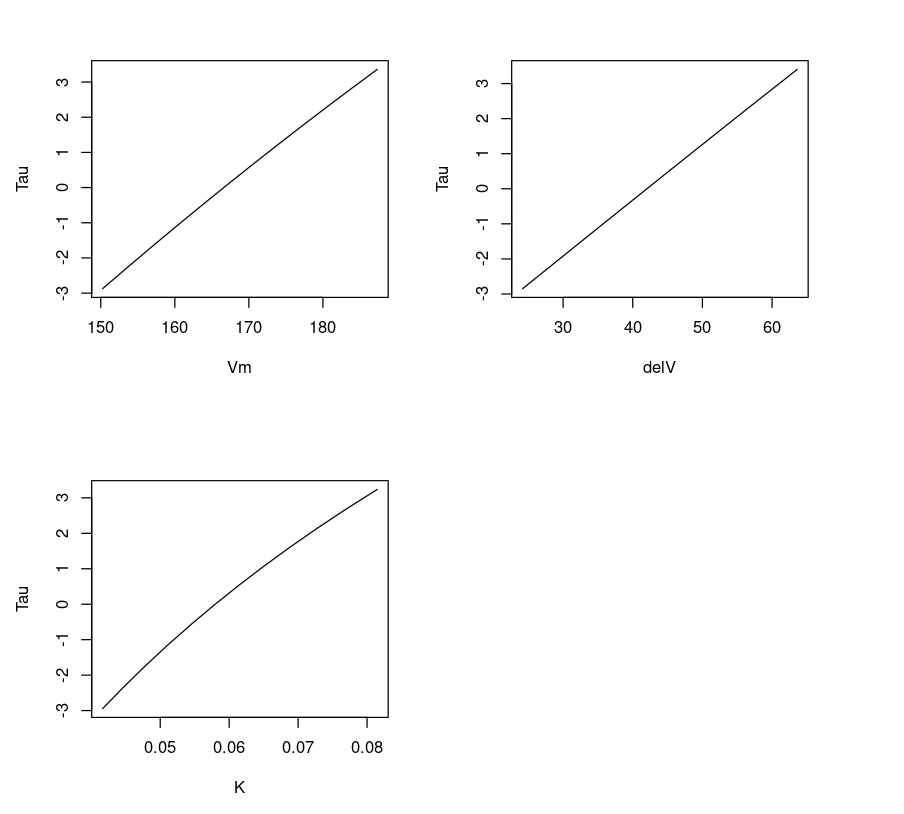
Een lineair model fitten
Je kunt dezelfde R-bibliotheekfunctie nls() gebruiken om een lineair model te fitten, zoals hieronder getoond. Het is sowieso een goede gewoonte om altijd een lineair model te proberen voor de interpretatie en vergelijking.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Hoewel de parameters significant lijken, is het een slechte fit. De residuele standaardfout is hoog.
De fit visualiseren
Het lijkt erop dat het lineaire model slecht presteert; je kunt dit visualiseren door een gefitte lijn op de data te tekenen en te vergelijken met de niet-lineaire tegenhanger.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)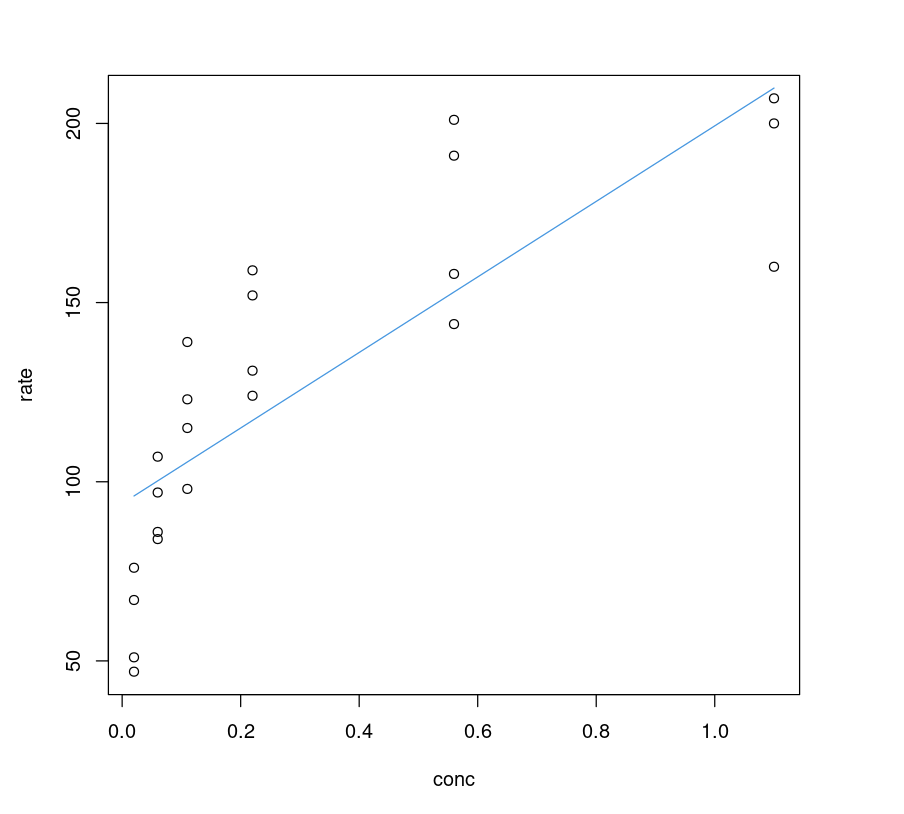
Niet-lineair vs. lineair model analytisch vergelijken
Uit de bovenstaande plot weten we dat het lineaire model slecht werk levert, maar hoe vergelijken we deze modellen? Het is appels met peren vergelijken. AIC-resultaten kun je niet direct gebruiken.
Goodness of fit
Wat is een goede fit? Bij regressie is dat wanneer voorspeld en werkelijk zo dicht mogelijk bij elkaar liggen. Als we de kwaliteit inspecteren van wat een model heeft voorspeld met een R-functie lm(), kun je ze vergelijken. Het model dat nauwkeuriger is, heeft punten die dicht bij de ideale lijn liggen. Een ideale lijn is een model dat 100% accuraat is: de voorspelling is gelijk aan de werkelijke waarde voor elk datapunt. Dan liggen alle punten op één rechte lijn.
Niet-lineaire fit
Voor elk inputdatapunt gebruiken we het model om de doelwaarde te voorspellen en passen we vervolgens de functie lm() toe zoals getoond. Door een spreidingsdiagram te maken tussen de werkelijke snelheid (x-as) en de voorspelde snelheid (y-as) en een ideale lijn te tekenen, kun je zien hoe dicht de punten bij de lijn liggen.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104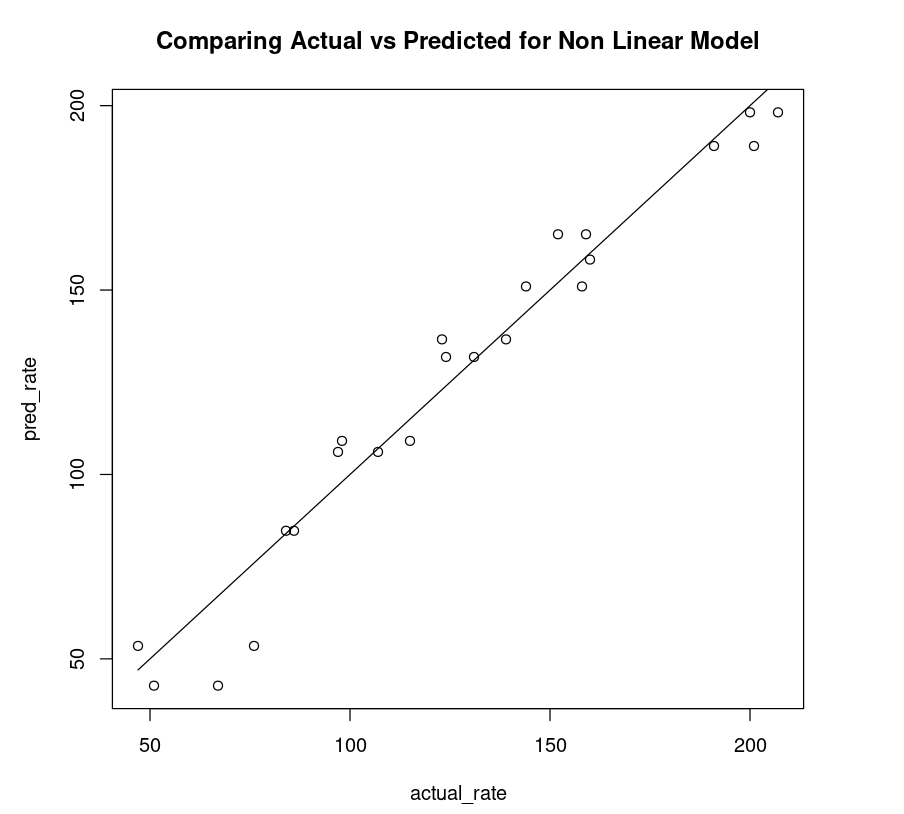
Lineaire fit
De niet-lineaire plot hierboven is duidelijk een betere fit vergeleken met de lineaire plot (hieronder).
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551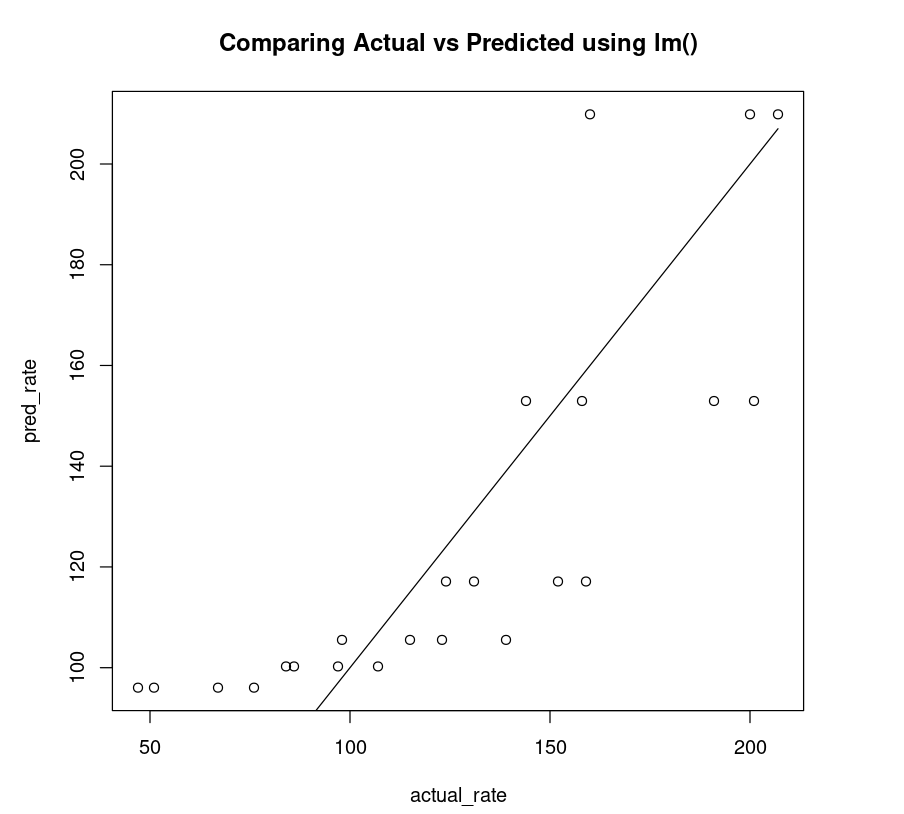
Lineair model verbeteren
Het lijkt alsof we het lineaire model benadelen, want we zien duidelijk dat de data geen rechte lijn volgt, dus we kunnen proberen het model te fitten met getransformeerde data. We kiezen sqrt() om conc te transformeren en fitten een lineair model zoals hieronder.
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09Er is inderdaad een daling in de residuele standaardfout, maar minder dan verwacht.
De fit plotten
Je ziet duidelijk dat sqrt() op conc het lineaire model verbetert. Vergeleken met het niet-lineaire model Purboth is het echter niet beter. De residuele standaardfout van het model PurbothLinearSqrt is bijna het dubbele van Purboth, daarom analyseren we dit model niet verder. Je kunt proberen hogere-orde polynoomtermen te fitten (polynomiale regressie), maar de inspanning om dat model fijn af te stemmen is veel groter terwijl je met een niet-lineair model betere resultaten kunt behalen.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)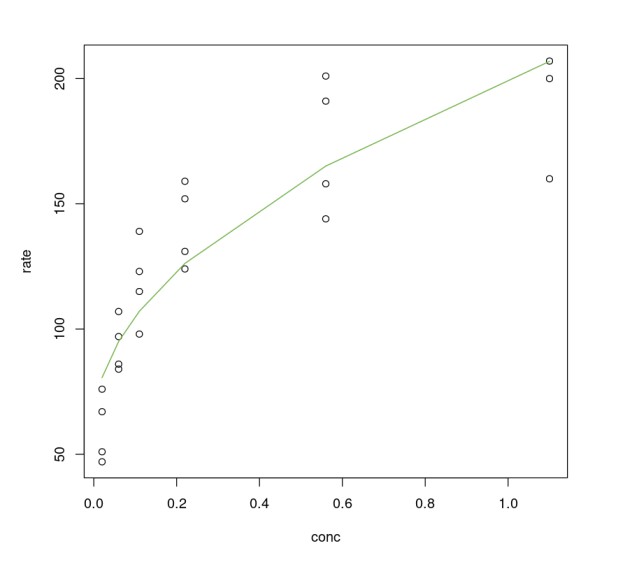
De niet-lineariteit ontwarren
Je kunt een truc toepassen om een niet-lineaire functie te ontwarren en een lineair model te fitten. Deze techniek werd vroeger gebruikt toen berekeningen met de hand werden gedaan, niet door computers. Zulke modellen presteren echter vaak minder goed.
Niet-lineair naar lineaire vorm omzetten
Als illustratie kun je de Michaelis-Menten-vergelijking inverteren, zoals hieronder, en de aangepaste vorm gebruiken om een lineair model toe te passen.
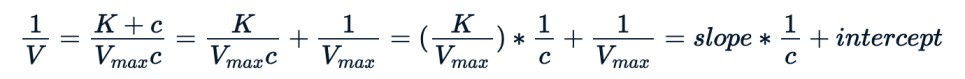
We kunnen dezelfde nls() gebruiken om de nieuwe vergelijking te fitten.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09De residuele standaardfout is laag, maar de gebruikte data is daardoor niet te vergelijken met niet-lineaire modellen. De beste optie is te visualiseren hoe beide modellen presteren op de oorspronkelijke dataset.
De fit plotten
We vergelijken het model Purboth_1, dat de twee parameters Vmax en K gebruikt, met PurbothPseudoLinear. De plot laat duidelijk zien dat een niet-lineair model beter presteert.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))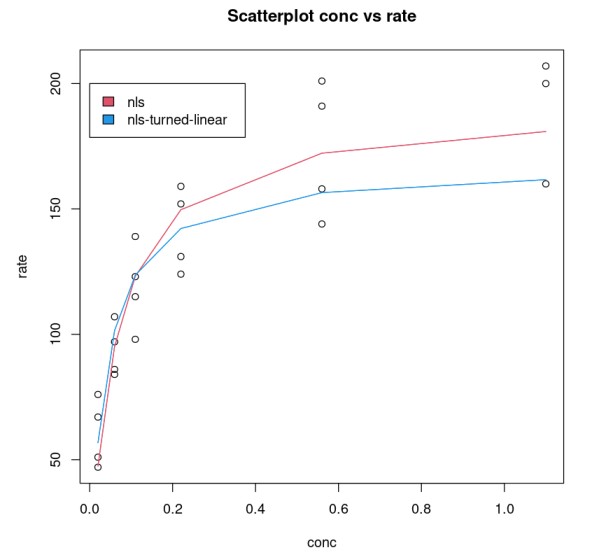
Goodness of fit
Je kunt de kwaliteit van het model vergelijken.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Dit laat zien dat een model dat een niet-lineaire functie gebruikt veel beter presteert.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)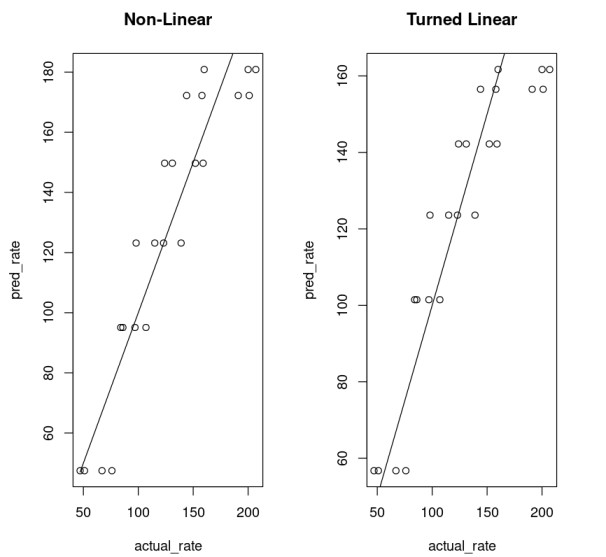
Conclusie
Het niet-lineaire model presteert beter dan het lineaire tegenhanger, vooral in gevallen met mechanistische data. Een niet-lineair model garandeert echter geen numerieke oplossing voor een schattingsprobleem. Je kunt een plot maken en een wiskundige functie kiezen die de relatie in de data het beste verklaart. In zulke gevallen kan het niet-lineaire model zijn lineaire tegenhanger overtreffen.
Vond je dit artikel verhelderend en wil je dieper duiken in de wereld van regressiemodellen? Bekijk dan de DataCamp-cursus Intermediate Regression in R.

