Hướng dẫn này là đóng góp quý giá từ cộng đồng và đã được DataCamp biên tập để đảm bảo rõ ràng và chính xác.
Quan tâm chia sẻ chuyên môn của riêng bạn? Chúng tôi rất mong được lắng nghe! Hãy gửi bài viết hoặc ý tưởng của bạn qua Biểu mẫu Đóng góp Cộng đồng.
Mô hình phi tuyến không còn phổ biến như trước đây. Ngày nay, nhiều sách bỏ qua việc thảo luận về mô hình phi tuyến hoặc chỉ giải thích ở mức hạn chế. Rõ ràng có khá nhiều lý do cho điều này. Thứ nhất, có thể khớp một đường cong phi tuyến bằng hồi quy tuyến tính bằng cách dùng các hạng đa thức bậc cao hơn hoặc áp dụng hàm cơ sở (nói cách khác, áp dụng biến đổi log hoặc căn bậc hai lên biến giải thích). Thứ hai, có thể ưu tiên sự đơn giản thay vì các mô hình phức tạp vì mô hình tuyến tính dễ diễn giải và giải thích.
Hơn nữa, để áp dụng một mô hình phi tuyến, điều quan trọng là trực quan hóa dữ liệu và nắm bắt được quỹ đạo, điều này không khả thi trong bối cảnh đa biến. Cuối cùng, mô hình phi tuyến phù hợp nhất cho các trường hợp cơ chế, nơi hiện tượng thuần túy mang tính vật lý hoặc tất định, điều này không đúng với dữ liệu lớn, nơi các hoạt động của người dùng được máy móc ghi nhận.
Tuy vậy, bất chấp tất cả những lý do chính đáng đó, mô hình hóa phi tuyến là một bộ môn đẹp đẽ đáng để khám phá và so sánh với người anh em tuyến tính.
Mô hình Hồi quy Phi tuyến
Các kỹ thuật ước lượng cho mô hình phi tuyến là lặp tường minh. Ngoài ra, có một khác biệt cơ bản trong cách áp dụng công thức phi tuyến, vốn không giống công thức tuyến tính. Ba phương trình/công thức sau, mỗi cái đều được coi là tuyến tính vì quan hệ giữa biến y và B0, B1, và B2 là một đường thẳng.
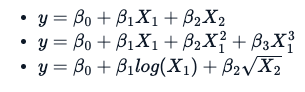
Một công thức trở nên phi tuyến khi giống như sau:
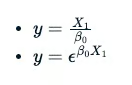
Việc dùng B0 hay B1 là tùy ý. Tuy nhiên, hai phương trình sau không có quan hệ dạng đường thẳng giữa biến y và B0.
Đáng tiếc là điều này khiến tính toán khó hơn, và không có gì đảm bảo sẽ có nghiệm số thành công cho bài toán ước lượng. Vì thế, mô hình phi tuyến đi kèm cảnh báo rằng việc tìm ra lời giải có thể không trực quan hoặc không chính xác.
Mô hình Chuyên biệt
Thường thì khi áp dụng mô hình phi tuyến, người ta dùng các dạng chuyên biệt. Điều này giúp việc khớp mô hình phi tuyến thuận tiện hoặc dễ dàng hơn về mặt số trị, nhưng cần được chuyên gia lĩnh vực đồng thuận và phù hợp với dữ liệu. Dạng chuyên biệt ở đây nghĩa là dùng một phương trình toán học được định nghĩa sẵn. Dưới đây là danh sách các phương trình phi tuyến được dùng thường xuyên (một số được lược bớt cho gọn).
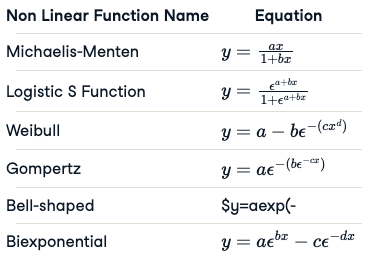
Chiến lược cho Mô hình Hồi quy Phi tuyến
- Trực quan hóa dữ liệu để xem liệu một hàm toán học chuyên biệt có thể giải thích tốt nhất dữ liệu không.
- Bằng cách ước lượng bằng mắt từ đồ thị hoặc dùng hàm khởi tạo tự động (giải thích bên dưới), chọn các giá trị tham số ban đầu.
- Khớp mô hình và kiểm tra.
- Thực hiện phân tích thống kê trên mô hình đã khớp để hiểu khoảng tin cậy tham số, sai số dư và phần biến thiên được giải thích.
- Thử thêm tham số vào mô hình nếu giúp giảm sai số dư.
- Luôn khớp một mô hình tuyến tính và so sánh kết quả giữa mô hình phi tuyến và tuyến tính.
Giải thích Mô hình Phi tuyến qua Ví dụ
Chúng ta sẽ khớp một mô hình phi tuyến chuyên biệt trên bộ dữ liệu phổ biến Puromycin, trình bày tốc độ phản ứng và nồng độ cho một phản ứng enzyme liên quan đến các tế bào với thuốc Puromycin. Dữ liệu gồm hai nhóm tế bào, một nhóm được xử lý bằng Puromycin và nhóm còn lại không dùng thuốc này.
names(Puromycin)Puromycin'conc''rate''state'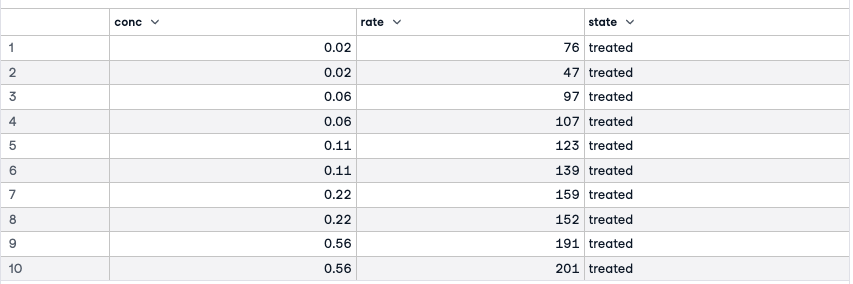
Ba biến trong dataframe này là nồng độ chất nền, tốc độ ban đầu của phản ứng và chỉ báo đã xử lý hay chưa xử lý.
Bằng cách vẽ tốc độ theo nồng độ và gắn nhãn hai mức xử lý, ta có thể thấy một mẫu hình chung. Các đường cong tiệm cận và khá khác biệt giữa hai nhóm tế bào được xử lý và không xử lý.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))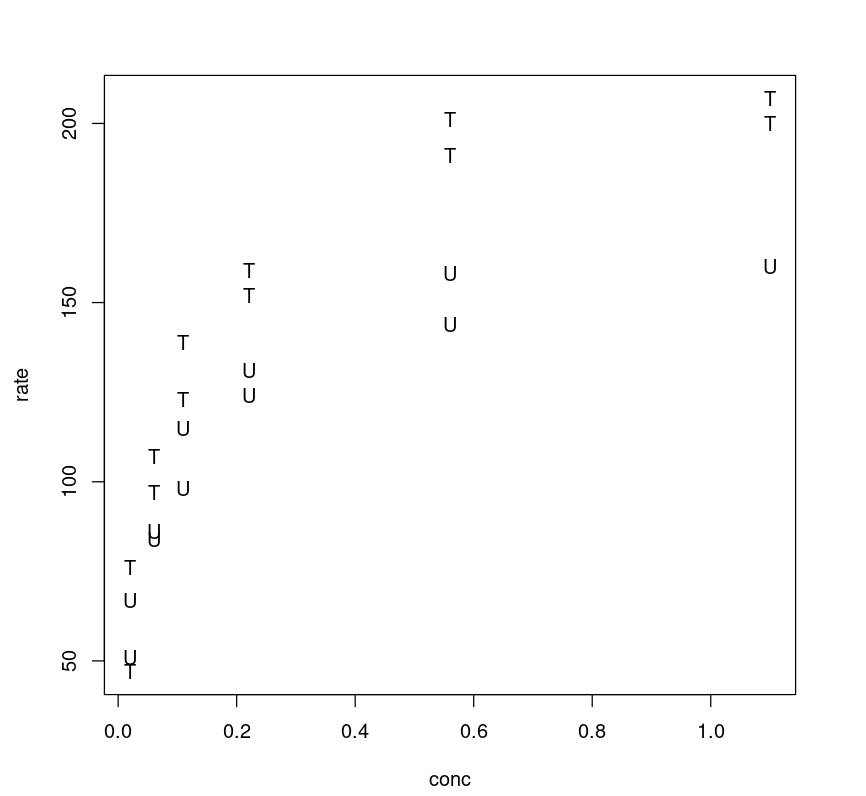
Vì dữ liệu này thể hiện mối quan hệ Michaelis-Menten mạnh giữa tốc độ phản ứng và nồng độ, các nhà thực nghiệm kỳ vọng khớp phương trình toán học sau.
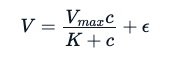
Ở đây, E là sai số thí nghiệm. Tương tự như mô hình tuyến tính, với mô hình phi tuyến chuyên biệt, ta cố gắng ước lượng các tham số Vmax và K để tối thiểu hóa tổng bình phương phần dư (tuy nhiên có những phương pháp khác để ước lượng các tham số này):
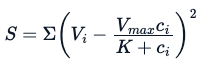
Khớp một Mô hình Phi tuyến
Dù chúng ta biết mối quan hệ, việc khớp mô hình phi tuyến không hề đơn giản vì mô hình cần các giá trị đoán ban đầu cho Vmax và K. Nếu không chọn được giá trị khởi tạo tốt, mô hình có thể khớp dữ liệu kém. Có hai lựa chọn:
- Hoặc ước lượng bằng mắt từ đồ thị để tìm giá trị ban đầu.
- Hoặc dùng hàm tự khởi tạo (bên dưới).
Hàm Tự khởi tạo | Mô hình |
SSasymp | mô hình hồi quy tiệm cận |
SSasympOff | mô hình hồi quy tiệm cận có độ lệch |
SSasympOrig | mô hình hồi quy tiệm cận qua gốc tọa độ |
SSbiexp | mô hình hai mũ |
SSfol | mô hình ngăn bậc nhất |
SSfpl | mô hình logistic bốn tham số |
SSgompertz | mô hình tăng trưởng Gompertz |
SSlogis | mô hình logistic |
SSmicmen | mô hình Michaelis–Menten |
SSweibull | mô hình đường cong tăng trưởng Weibull |
Với mỗi loại mô hình, có một hàm tự khởi tạo tương ứng dùng làm giá trị đoán ban đầu.
Khớp Mô hình bằng Giá trị Khởi tạo
Dùng giá trị ban đầu Vmax = 160, K = 0.05 ước lượng bằng mắt từ đồ thị, có thể dùng hàm R nls() để khớp dữ liệu. Thông thường với hồi quy tuyến tính, ta không cần chỉ định tham số Vm hay K, nhưng với mô hình phi tuyến thì khác. Mỗi thuật toán lặp đều cần một điểm khởi động tốt, nếu không có thể không hội tụ. Đây là cách khớp mô hình phi tuyến trên Puromycin với các giá trị ban đầu.
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Tính sai số dư
Ta tính sai số dư như sau:
sse <- Purboth_1$m$deviance()sse7276.54697931423Tính phần biến thiên được giải thích
Để tìm phần biến thiên được mô hình giải thích (về cơ bản là R-square theo thuật ngữ mô hình tuyến tính), ta cần tìm tổng biến thiên của rate bằng cách khớp mô hình rỗng, ước lượng trung bình tổng thể, trích tổng bình phương sst từ tóm tắt mô hình rỗng rồi dùng nó để tính phần trăm biến thiên được giải thích.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Mô hình này giải thích 85,34% biến thiên trong dữ liệu.
Khớp Mô hình bằng Hàm Tự khởi tạo
Vì chúng ta đang dùng mô hình Michaelis-Menten, có thể dùng hàm tự khởi tạo SSmicmen(). Tuy nhiên, kết quả là như nhau.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Tính sai số dư
sse <- Purboth_self$m$deviance()sse7276.54697947673Tính phần biến thiên được giải thích
Có thể kiểm tra phần biến thiên được giải thích bởi mô hình.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141Nhìn chung, phương trình đã khớp, tức quan hệ giữa tốc độ và nồng độ, trông như sau:
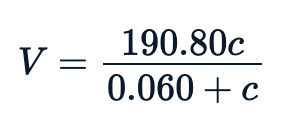
Trực quan hóa mức độ khớp
Có thể trực quan hóa cách mô hình hoạt động bằng cách vẽ đường khớp lên dữ liệu, trông phi tuyến.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Chọn mô hình tốt hơn
Có thể tinh chỉnh thêm mô hình bằng cách thêm tham số. Nếu quan sát đồ thị tốc độ theo nồng độ, có thể nhận thấy các lớp khác nhau (đã xử lý vs chưa xử lý) theo các quỹ đạo khác nhau, và chênh lệch tốc độ (trục y) giữa hai quỹ đạo lớp xấp xỉ 40.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))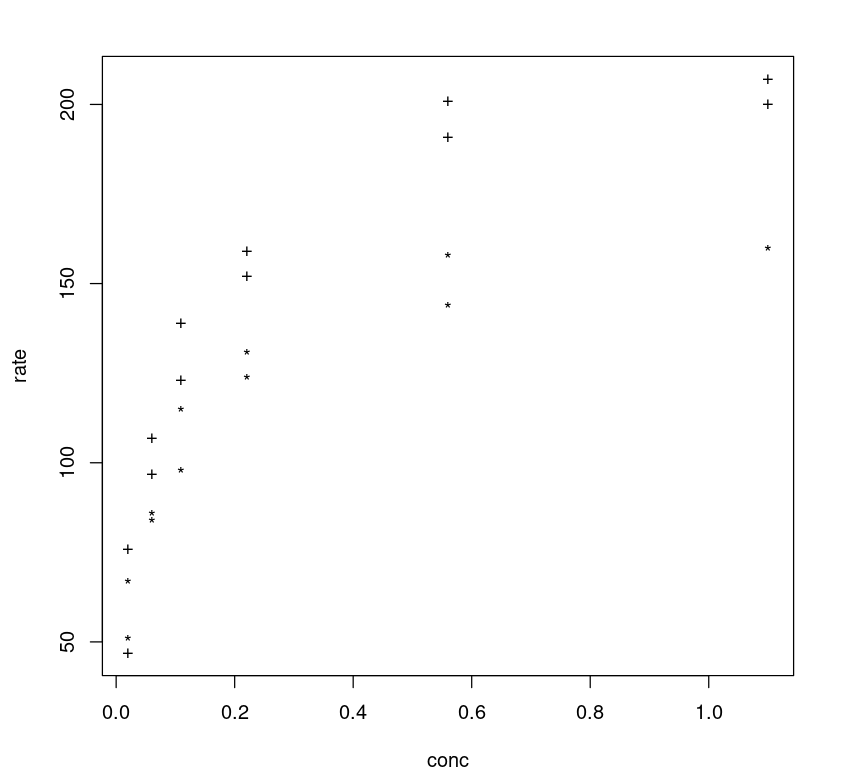
Về bản chất, chúng ta đang cố khớp một mô hình có điều kiện theo biến trạng thái, dẫn đến phương trình phi tuyến sau.
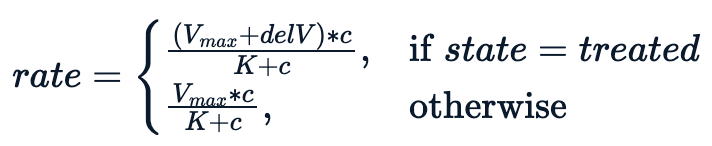
Mô hình hoạt động tốt hơn với tham số bổ sung delV. Chúng ta gán giá trị ban đầu 40 cho delV và khớp mô hình bằng nls với ba tham số.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06Bản tóm tắt cho thấy cả ba tham số đều có ý nghĩa thống kê.
Tính sai số dư
Có thể thấy với mô hình này, sai số dư giảm đáng kể:
sse <- Purboth$m$deviance()sse2240.89143883885Tính phần biến thiên được giải thích
Mô hình này giải thích được nhiều biến thiên hơn.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744Kiểm tra AIC
Cũng có thể thực hiện kiểm tra AIC trên cả hai mô hình, dù hiện nay thực hành phổ biến là dùng kiểm định chéo, nhưng điều đó thường đòi hỏi nhiều dữ liệu hơn; nói chung, AIC càng thấp thì mô hình càng tốt.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742Trực quan hóa mức độ khớp
Có thể trực quan hóa cách mô hình đã tinh chỉnh hoạt động bằng cách vẽ đường khớp lên dữ liệu; không ngạc nhiên, mô hình tinh chỉnh cho mức độ khớp tốt hơn giữa các lớp.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))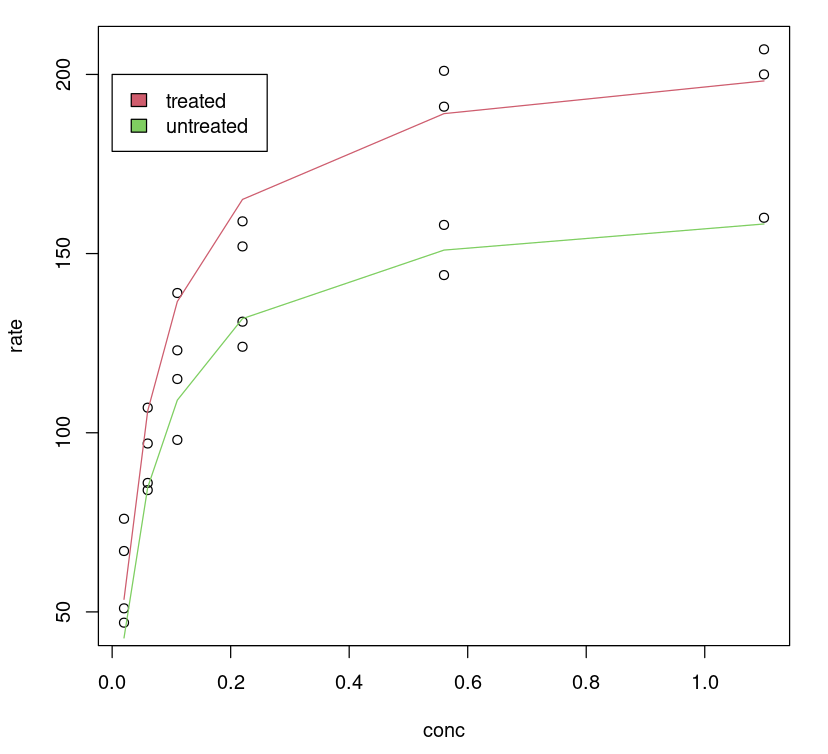
Khoảng tin cậy của tham số
Không thể chỉ dựa vào p-value; khoảng tin cậy 95% cho giá trị hệ số của mỗi tham số có ý nghĩa tại mức 2,5% và 97,5%. Không tham số nào bao gồm 0.
confint(Purboth)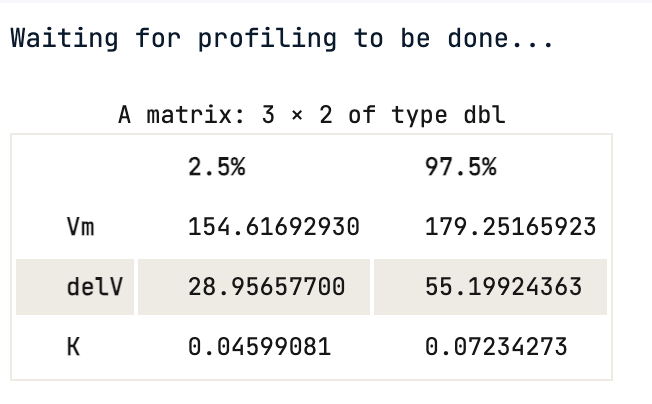
Dựa vào khoảng tin cậy, có thể nói một cách thống kê rằng có 95% khả năng giá trị thật của tham số, ví dụ Vmax, nằm trong khoảng trên, tức (154,62; 179,25) đối với Vmax.
Lập hồ sơ (Profiling)
Có thể lập hồ sơ mô hình để hiểu độ bất định trong ước lượng tham số bằng cách xem xét trực tiếp hàm mục tiêu. Trong mô hình của chúng ta có ba tham số Vmax, delV, K, ta có thể lập hồ sơ chúng:
- Để lấy khoảng tin cậy.
- Và dùng hàm profile t, tương tự thống kê t trong mô hình tuyến tính. Các đồ thị của hàm profile t cung cấp khoảng khả dĩ (likelihood interval) cho từng tham số và cho thấy mức độ phi tuyến của ước lượng.
Vẽ khoảng tin cậy
Đồ thị này vẽ khoảng tin cậy của các tham số cho các giá trị khác nhau của , tương ứng với các mức khoảng tin cậy khác nhau (99%, 95%, 90%, 80% và 50%). Nó tương tự khoảng tin cậy (95%) do confint(object, parm, level = 0.95, ...)function cung cấp.
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)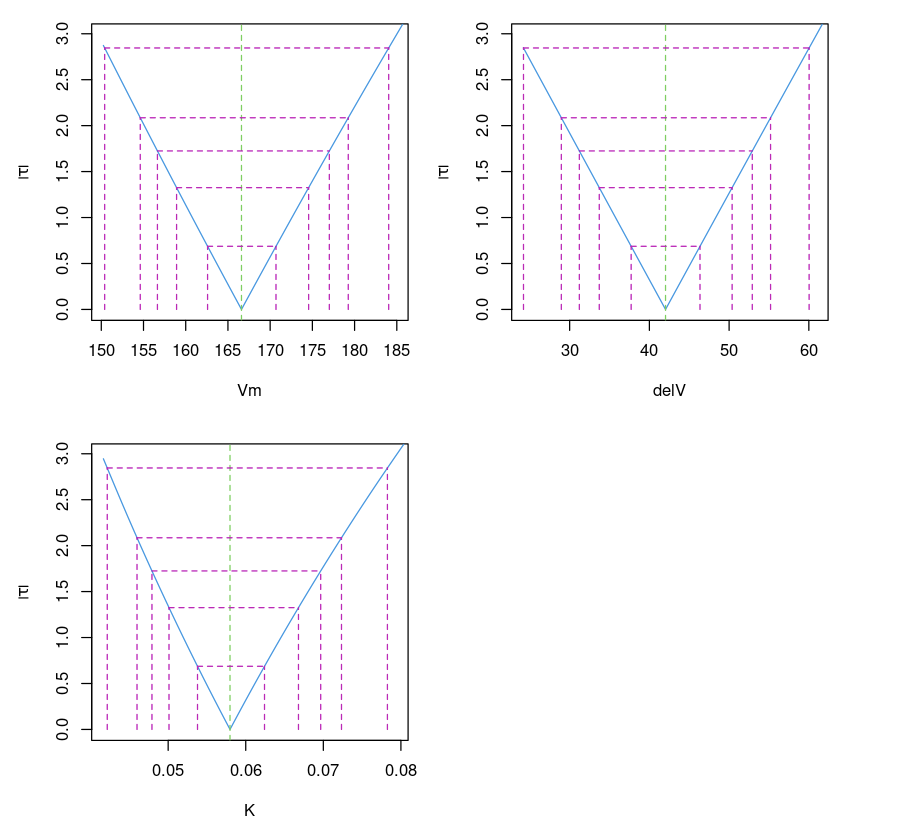
Vẽ T so với tham số
Vẽ ba tham số Vmax, delV, K theo T cho ta cảm nhận liệu phép khớp là tuyến tính hay phi tuyến. Có thể nhận thấy đường trông tuyến tính với tham số delV và Vm, và hơi cong với K. Điều này là kỳ vọng vì tham số K thể hiện quan hệ phi tuyến.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")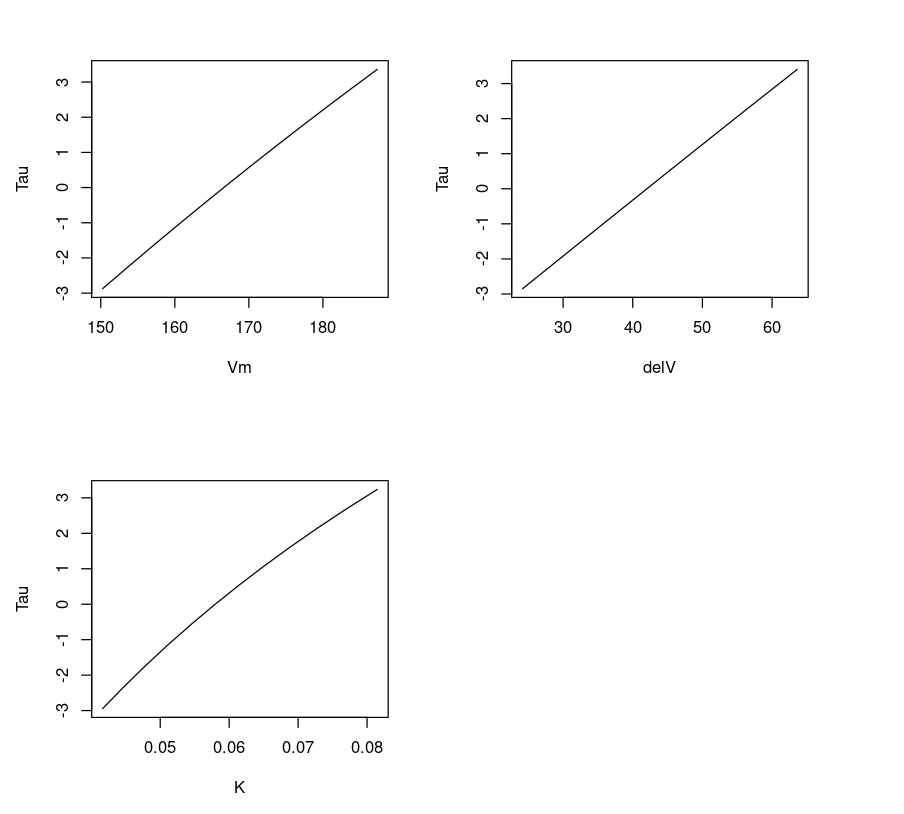
Khớp một Mô hình Tuyến tính
Có thể dùng cùng hàm thư viện R nls() để khớp một mô hình tuyến tính như dưới đây. Theo tôi, luôn thử mô hình tuyến tính để dễ diễn giải và so sánh là một thói quen tốt.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Dù các tham số có vẻ có ý nghĩa, đây là mức khớp kém. Sai số chuẩn của phần dư cao.
Trực quan hóa mức độ khớp
Có vẻ mô hình tuyến tính hoạt động kém; có thể trực quan hóa bằng cách vẽ đường khớp lên dữ liệu và so với mô hình phi tuyến.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)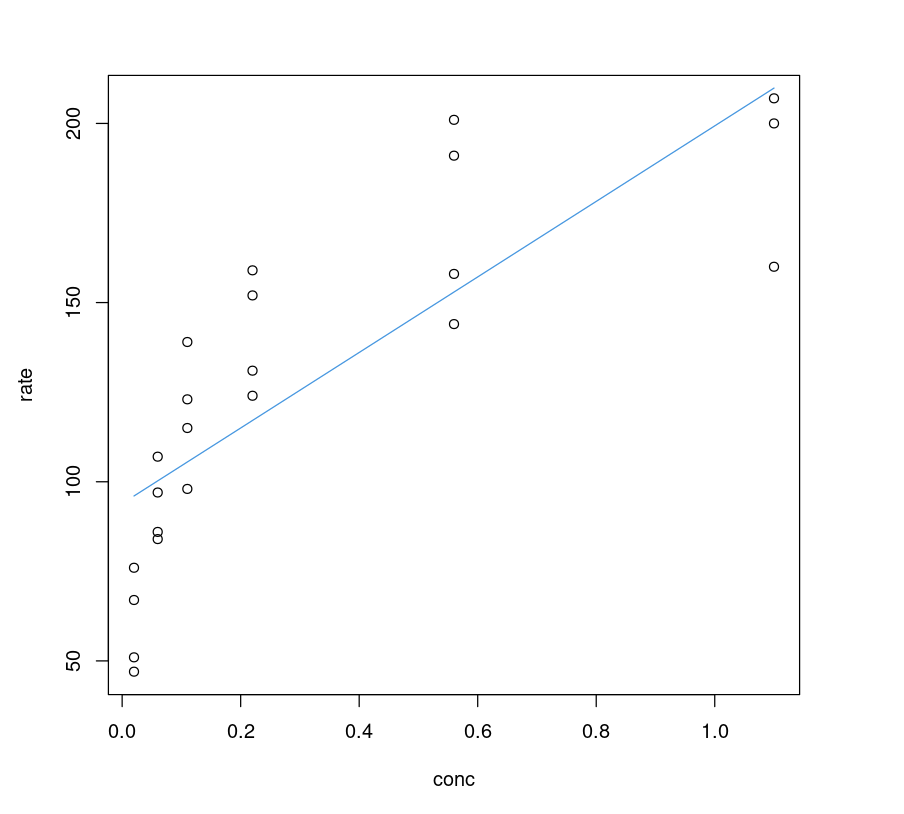
So sánh Mô hình Phi tuyến và Tuyến tính một cách Phân tích
Từ đồ thị trên, ta biết mô hình tuyến tính làm việc kém, nhưng so sánh các mô hình này thế nào? Sẽ giống như so táo với cam. Kết quả AIC không thể dùng trực tiếp.
Mức độ khớp tốt
Thế nào là khớp tốt – đối với hồi quy, đó là giá trị dự đoán và giá trị thực càng gần nhau càng tốt. Vì vậy, nếu kiểm tra chất lượng dự đoán của một mô hình bằng hàm lm() của R, có thể so sánh chúng. Mô hình chính xác hơn sẽ có các điểm nằm gần đường lý tưởng. Đường lý tưởng là mô hình chính xác 100% – dự đoán trùng khớp với giá trị thực tại mỗi điểm dữ liệu. Do đó, mọi điểm sẽ nằm trên một đường thẳng.
Mức độ khớp Phi tuyến
Với mỗi điểm dữ liệu đầu vào, ta dùng mô hình để dự đoán giá trị đích rồi áp dụng hàm lm() như sau. Bằng cách vẽ biểu đồ phân tán giữa tốc độ thực (trục x) và tốc độ dự đoán (trục y) và vẽ đường lý tưởng, có thể quan sát các điểm gần đường đến mức nào.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104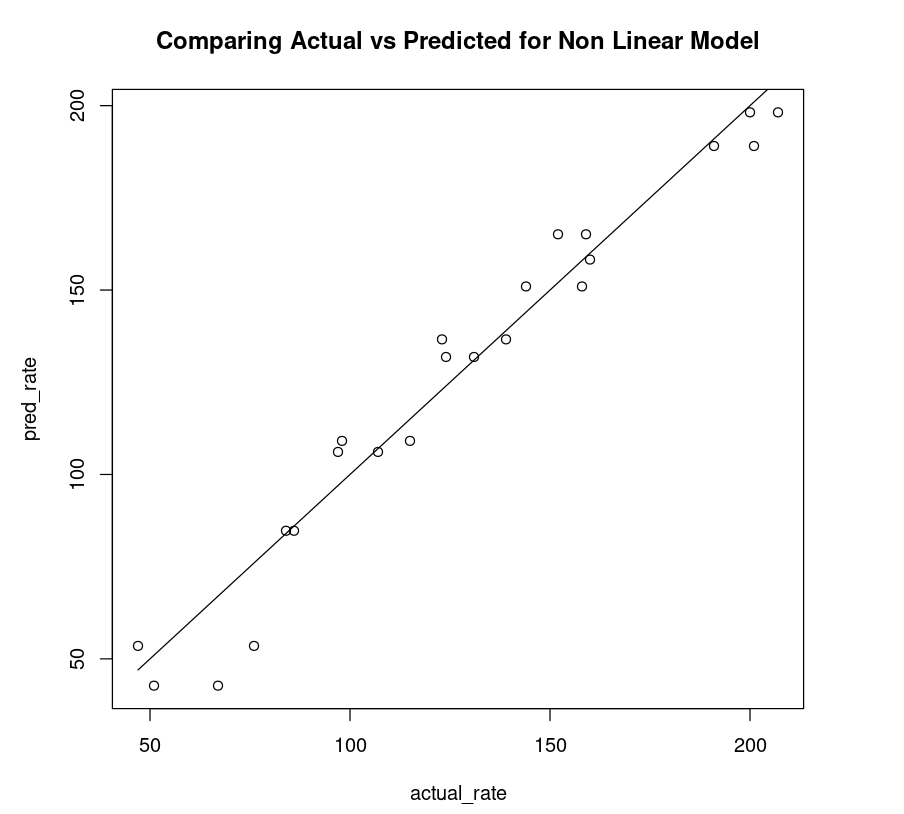
Mức độ khớp Tuyến tính
Đồ thị phi tuyến ở trên rõ ràng khớp tốt hơn so với đồ thị tuyến tính (bên dưới).
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551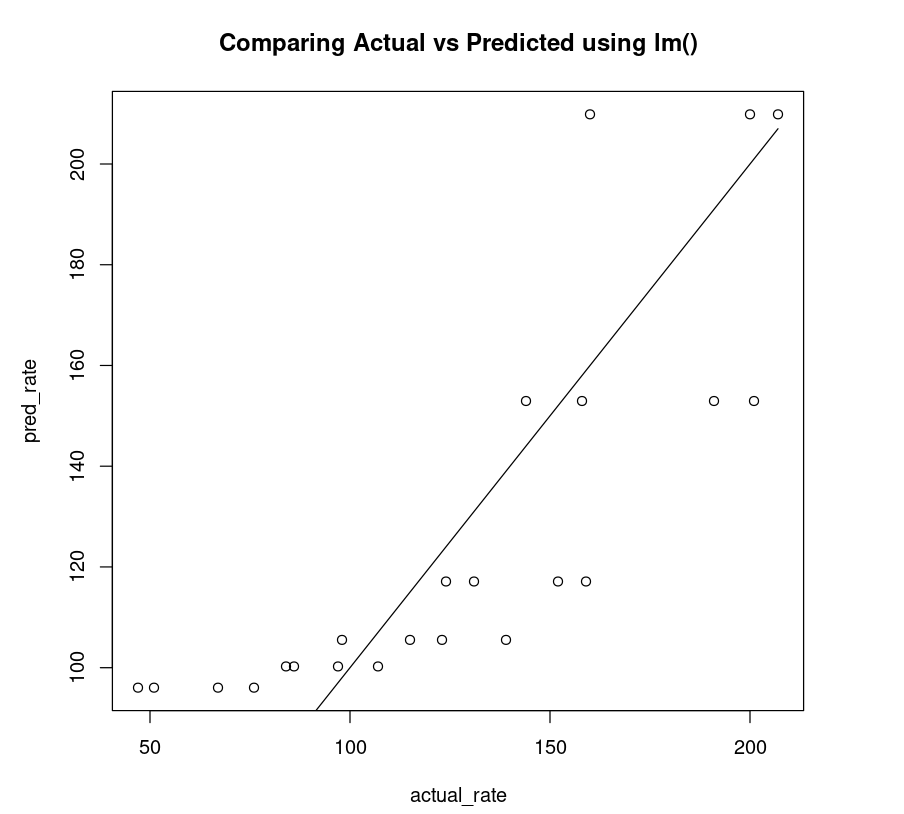
Cải thiện Mô hình Tuyến tính
Có vẻ như chúng ta hơi bất công với mô hình tuyến tính vì rõ ràng dữ liệu không theo đường thẳng, nên có thể thử khớp mô hình bằng dữ liệu đã biến đổi. Ta chọn sqrt() để biến đổi conc và khớp mô hình tuyến tính như dưới đây.
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09Quả thực, sai số chuẩn của phần dư giảm, nhưng không như kỳ vọng.
Vẽ mức độ khớp
Rõ ràng dùng sqrt() trên conc giúp cải thiện mô hình tuyến tính. Tuy nhiên, so với mô hình phi tuyến Purboth thì vẫn không tốt hơn. Sai số chuẩn phần dư của mô hình PurbothLinearSqrt gần gấp đôi Purboth nên chúng ta sẽ không phân tích thêm mô hình này. Có thể thử khớp các hạng đa thức bậc cao (hồi quy đa thức) nhưng công sức tinh chỉnh sẽ nhiều hơn rất nhiều trong khi mô hình phi tuyến có thể mang lại kết quả tốt hơn.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)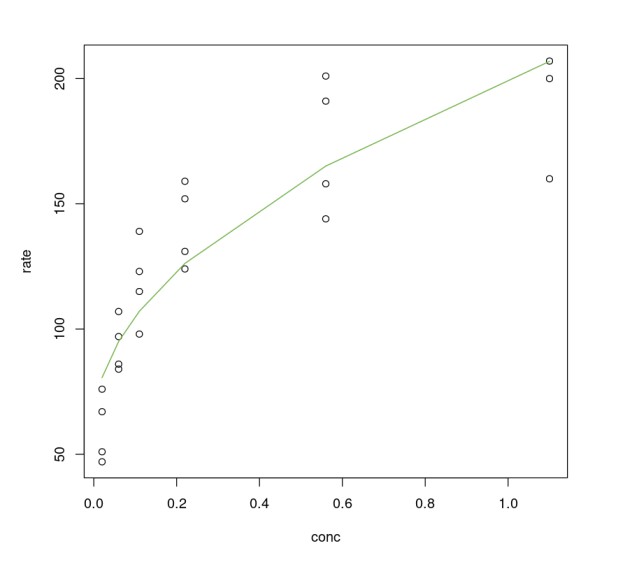
Tháo xoắn Phương trình Phi tuyến
Có thể áp dụng một mẹo để “tháo xoắn” hàm phi tuyến và khớp một mô hình tuyến tính. Kỹ thuật này từng được dùng khi tính toán thực hiện bằng tay, không phải máy tính. Tuy nhiên, các mô hình như vậy thường không tốt hơn.
Chuyển Phi tuyến về Dạng tuyến tính
Ví dụ, có thể biến đổi phương trình Michaelis-Menten bằng cách lấy nghịch đảo, như dưới đây, rồi dùng dạng đã biến đổi để áp dụng mô hình tuyến tính.
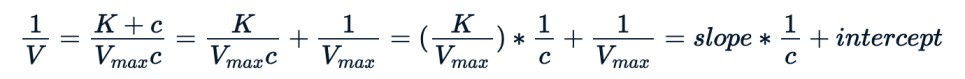
Ta có thể dùng cùng nls() để khớp phương trình mới.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09Sai số chuẩn phần dư thấp, nhưng dữ liệu sử dụng như vậy không thể dùng để so sánh với các mô hình phi tuyến. Cách tốt nhất là trực quan hóa cách cả hai mô hình hoạt động trên bộ dữ liệu gốc.
Vẽ mức độ khớp
Chúng ta so sánh mô hình Purboth_1, dùng hai tham số Vmax, K, với PurbothPseudoLinear. Đồ thị cho thấy rõ mô hình phi tuyến hoạt động tốt hơn.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))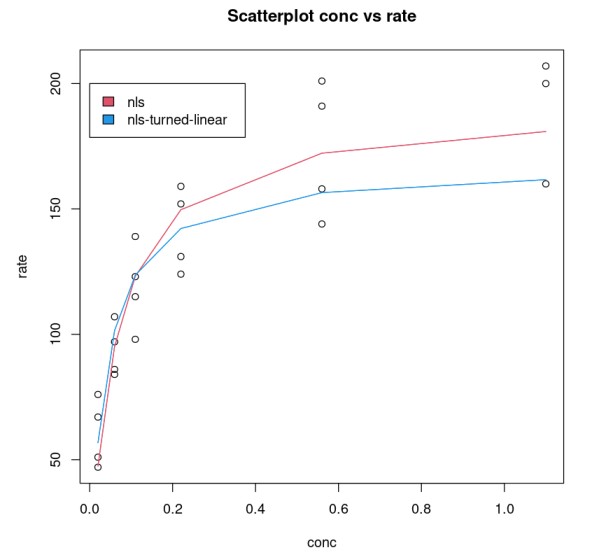
Mức độ khớp tốt
Có thể so sánh mức độ khớp của mô hình.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Điều này cho thấy mô hình dùng hàm phi tuyến hoạt động tốt hơn nhiều.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)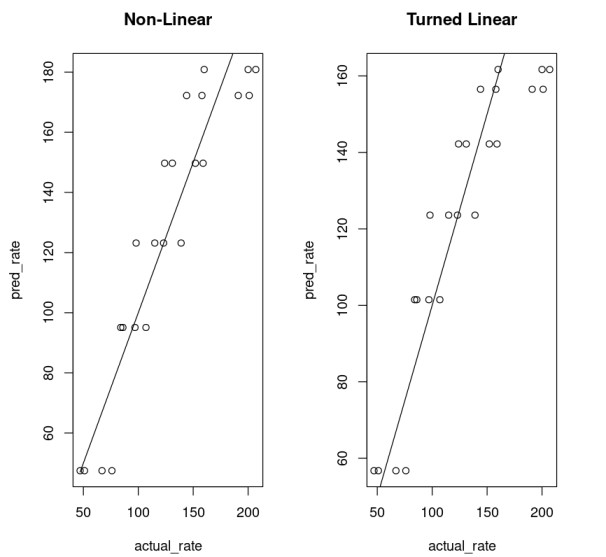
Kết luận
Mô hình phi tuyến hoạt động tốt hơn so với mô hình tuyến tính, đặc biệt trong các trường hợp dữ liệu cơ chế. Tuy nhiên, mô hình phi tuyến không đảm bảo có nghiệm số cho bài toán ước lượng. Có thể vẽ và chọn một hàm toán học có thể giải thích tốt nhất mối quan hệ giữa dữ liệu. Trong những trường hợp như vậy, mô hình phi tuyến có thể vượt trội so với mô hình tuyến tính.
Nếu bạn thấy bài viết này hữu ích và muốn tìm hiểu sâu hơn về thế giới các mô hình hồi quy, hãy xem khóa học Intermediate Regression in R của DataCamp.
