Dieses Tutorial ist ein wertvoller Beitrag aus unserer Community und wurde von DataCamp redaktionell überarbeitet.
Du möchtest dein Fachwissen teilen? Wir freuen uns auf dich! Reiche deine Artikel oder Ideen gern über unser Community Contribution Form ein.
Nichtlineare Modelle sind längst nicht mehr so populär wie früher. Viele Bücher lassen das Thema heute ganz weg oder behandeln es nur am Rande. Dafür gibt es einige gute Gründe. Erstens lässt sich eine nichtlineare Kurve auch mit linearer Regression annähern, zum Beispiel über Polynomterme höherer Ordnung oder durch Basisfunktionen (also Log- oder Wurzel-Transformationen der erklärenden Variablen). Zweitens setzen viele aus Gründen der Einfachheit auf lineare Modelle, weil sie sich leichter interpretieren und erklären lassen.
Zudem ist es für nichtlineare Modelle wichtig, die Daten zu visualisieren und ein Gefühl für den Verlauf zu bekommen – das ist in multivariaten Settings nicht ohne Weiteres möglich. Und nichtlineare Modelle eignen sich besonders für mechanistische Zusammenhänge, bei denen die Phänomene physikalisch bzw. deterministisch sind – was bei Big Data mit maschinell protokollierten Nutzeraktivitäten oft nicht zutrifft.
Trotz all dieser Punkte ist nichtlineares Modellieren eine faszinierende Disziplin, die man erkunden und mit der linearen Alternative vergleichen sollte.
Nichtlineares Regressionsmodell
Schätzverfahren für nichtlineare Modelle sind explizit iterativ. Außerdem gibt es einen grundlegenden Unterschied in der Anwendung der Formel: Sie funktioniert nicht wie eine lineare Formel. Die folgenden drei Gleichungen gelten alle als linear, weil die Beziehung zwischen y und B0, B1 und B2 jeweils eine Gerade ist.
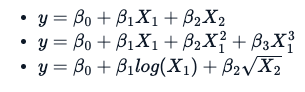
Nichtlinear wird eine Formel zum Beispiel so:
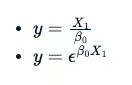
Die Verwendung von B0 oder B1 ist dabei beliebig. In den beiden letzten Gleichungen ist die Beziehung zwischen y und B0 jedoch keine Gerade.
Das erschwert leider die Berechnungen, und eine erfolgreiche numerische Lösung des Schätzproblems ist nicht garantiert. Nichtlineare Modelle kommen daher mit dem Warnhinweis, dass Ergebnisse nicht immer intuitiv oder präzise sind.
Spezialisierte Modelle
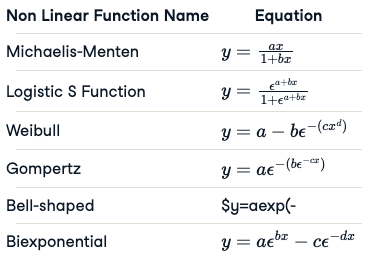
In der Praxis nutzt man für nichtlineare Modelle häufig spezialisierte Typen. Das macht das Fitten bequemer bzw. numerisch stabiler, sollte aber fachlich begründet und mit den Daten abgestimmt sein. Mit „spezialisiert“ meinen wir vordefinierte mathematische Gleichungen. Hier ist eine Auswahl häufig genutzter nichtlinearer Gleichungen (einige der Vollständigkeit halber weggelassen):
Vorgehen beim nichtlinearen Regressionsmodell
- Visualisiere die Daten und prüfe, ob eine spezielle mathematische Funktion die Daten am besten beschreibt.
- Wähle Startwerte für die Parameter, entweder per Augenmaß aus dem Plot oder über eine Self-Starter-Funktion (siehe unten).
- Fitte das Modell und untersuche die Ergebnisse.
- Führe eine statistische Analyse des gefitteten Modells durch: Konfidenzintervalle der Parameter, Residuenfehler und aufgeklärte Varianz.
- Ergänze bei Bedarf weitere Parameter, wenn sich dadurch der Residuenfehler reduziert.
- Fitte immer auch ein lineares Modell und vergleiche die Ergebnisse mit dem nichtlinearen Modell.
Das nichtlineare Modell am Beispiel erklärt
Wir fitten ein spezialisiertes nichtlineares Modell auf dem bekannten Datensatz Puromycin. Er enthält Reaktionsgeschwindigkeit und Konzentration für eine enzymatische Reaktion in Zellkulturen mit dem Wirkstoff Puromycin. Es gibt zwei Zellklassen: behandelt mit Puromycin und unbehandelt.
names(Puromycin)Puromycin'conc''rate''state'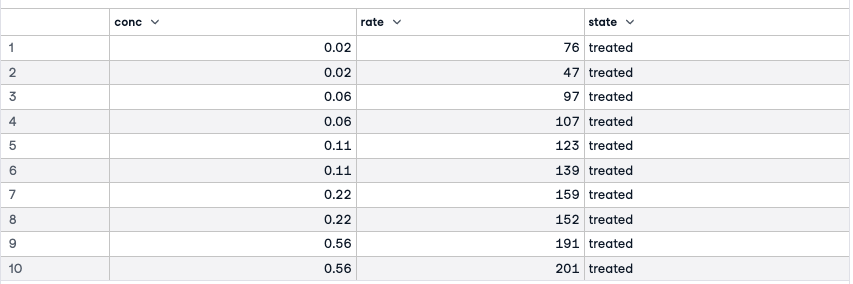
Die drei Variablen sind die Substratkonzentration, die anfängliche Reaktionsgeschwindigkeit und ein Indikator für behandelt vs. unbehandelt.
Wenn wir Rate gegen Konzentration plotten und die beiden Behandlungsstufen kennzeichnen, erkennen wir ein Muster: Die Kurven verlaufen asymptotisch und unterscheiden sich deutlich zwischen den Kohorten.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))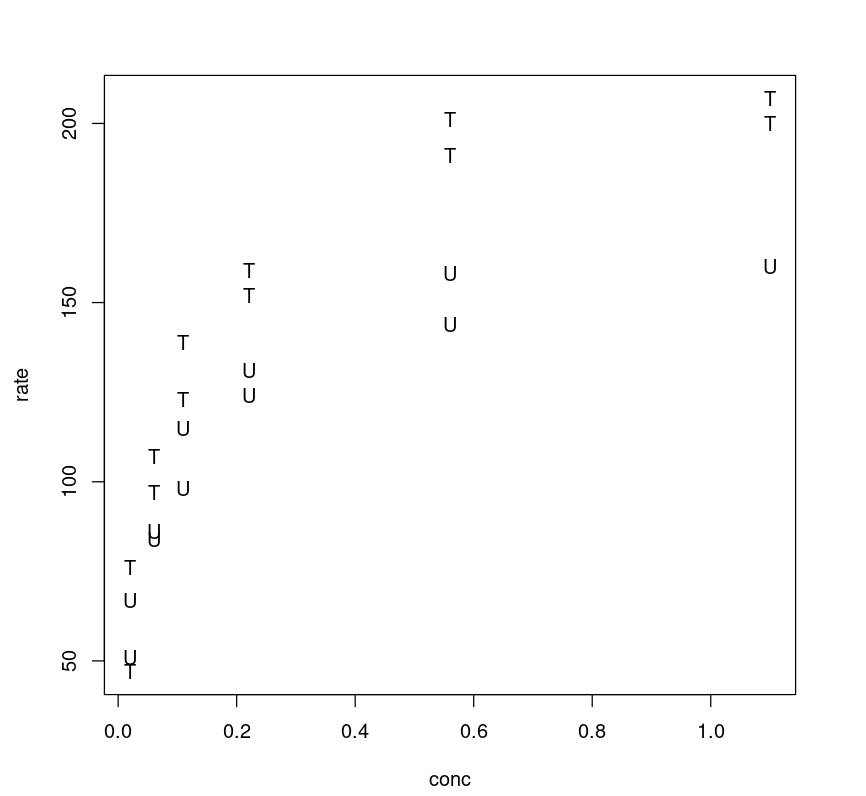
Da die Daten eine ausgeprägte Michaelis-Menten-Beziehung zwischen Reaktionsgeschwindigkeit und Konzentration zeigen, liegt folgende Gleichung nahe:
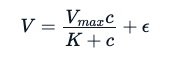
Dabei steht E für den Versuchsfehler. Analog zur linearen Regression schätzen wir in einem spezialisierten nichtlinearen Modell die Parameter Vmax und K so, dass die Summe der quadrierten Residuen minimiert wird (es gibt auch alternative Schätzmethoden):
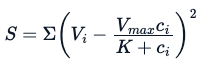
Ein nichtlineares Modell fitten
Auch wenn wir die Beziehung kennen, ist das Fitten nicht ganz trivial, denn das Modell braucht Startwerte für Vmax und K. Sind die Startwerte schlecht gewählt, kann das Fit scheitern oder ungenau werden. Es gibt zwei Optionen:
- Startwerte per Augenmaß aus dem Plot ableiten.
- Eine Self-Starter-Funktion verwenden (siehe unten).
Self-Starter-Funktion | Modell |
SSasymp | asymptotisches Regressionsmodell |
SSasympOff | asymptotisches Regressionsmodell mit Offset |
SSasympOrig | asymptotisches Regressionsmodell durch den Ursprung |
SSbiexp | biexponentielles Modell |
SSfol | Ein-Kompartiment-Modell erster Ordnung |
SSfpl | logistisches Vier-Parameter-Modell |
SSgompertz | Gompertz-Wachstumsmodell |
SSlogis | logistisches Modell |
SSmicmen | Michaelis–Menten-Modell |
SSweibull | Weibull-Wachstumskurvenmodell |
Zu jedem Modelltyp gibt es eine passende Self-Starter-Funktion für die Startwertschätzung.
Modellfit mit Startwerten
Mit den Startwerten Vmax = 160, K = 0.05 (per Augenmaß) lässt sich die R-Funktion nls() zum Fitten nutzen. Bei linearer Regression müssen wir Parameter wie Vm oder K nicht angeben, beim nichtlinearen Modell ist das anders. Jeder iterative Algorithmus braucht einen guten Startpunkt, sonst konvergiert er möglicherweise nicht. So fitten wir Puromycin mit Startwerten:
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Residuenfehler berechnen
Den Residuenfehler berechnen wir so:
sse <- Purboth_1$m$deviance()sse7276.54697931423Aufgeklärte Varianz berechnen
Um die aufgeklärte Varianz zu bestimmen (analog zum R-Quadrat in der linearen Regression), fitten wir ein Nullmodell, schätzen den Gesamtmittelwert, entnehmen die totale Quadratsumme sst aus der ANOVA-Zusammenfassung des Nullmodells und berechnen daraus den Prozentsatz aufgeklärter Varianz.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Dieses Modell erklärt 85,34 % der Variation in den Daten.
Fit mit Self-Starter-Funktion
Da wir das Michaelis-Menten-Modell verwenden, können wir stattdessen die Self-Starter-Funktion SSmicmen() nutzen. Das liefert hier identische Ergebnisse.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Residuenfehler berechnen
sse <- Purboth_self$m$deviance()sse7276.54697947673Aufgeklärte Varianz berechnen
Wir prüfen die aufgeklärte Varianz des Modells.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141Allgemein ergibt sich für die Beziehung Rate vs. Konzentration folgende Gleichung:
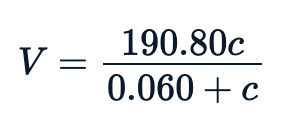
Fit visualisieren
Wie gut das Modell passt, siehst du, wenn du die gefittete Kurve über die Daten legst – der Verlauf ist deutlich nichtlinear.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Besseres Modell wählen
Wir können das Modell weiter abstimmen, indem wir Parameter ergänzen. Betrachtet man den Plot Rate vs. Konzentration, sieht man unterschiedliche Verläufe für die Klassen (behandelt vs. unbehandelt); der Abstand zwischen den Klassen auf der y-Achse liegt etwa bei 40.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))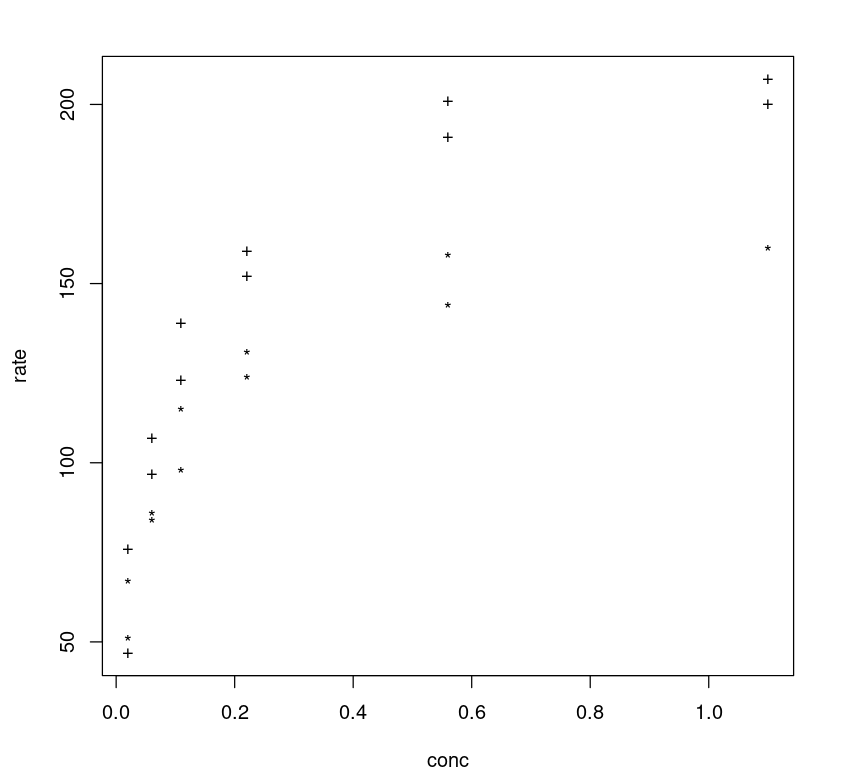
Wir konditionieren also auf die Zustandsvariable und erhalten folgende nichtlineare Gleichung:
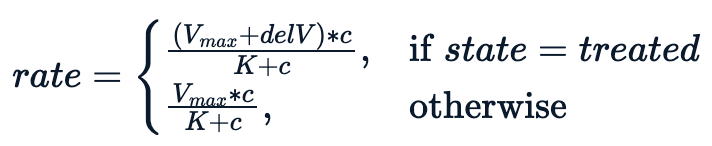
Mit dem zusätzlichen Parameter delV performt das Modell besser. Wir setzen delV initial auf 40 und fitten mit nls drei Parameter.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06Die Summary zeigt, dass alle drei Parameter statistisch signifikant sind.
Residuenfehler berechnen
Bei diesem Modell sinkt der Residuenfehler deutlich:
sse <- Purboth$m$deviance()sse2240.89143883885Aufgeklärte Varianz berechnen
Dieses Modell erklärt mehr Varianz.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744AIC-Prüfung
Man kann auch den AIC beider Modelle vergleichen. Heute nutzt man zwar oft Cross-Validation, das erfordert aber generell mehr Daten. Grundsätzlich gilt: Je niedriger der AIC, desto besser das Modell.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742Fit visualisieren
Wie gut das getunte Modell passt, zeigen gefittete Linien für beide Klassen – wenig überraschend liefert das getunte Modell die bessere Anpassung.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))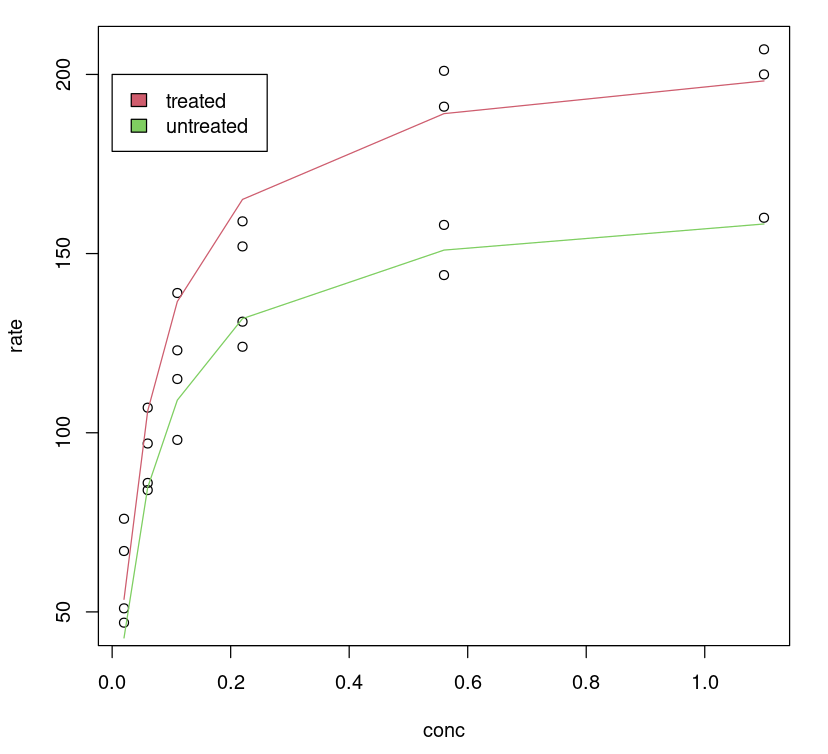
Konfidenzintervalle der Parameter
Verlass dich nicht nur auf p-Werte. Das 95%-Konfidenzintervall gibt für jeden signifikanten Koeffizienten die Werte bei 2,5 % und 97,5 % an. Keines der Intervalle enthält 0.
confint(Purboth)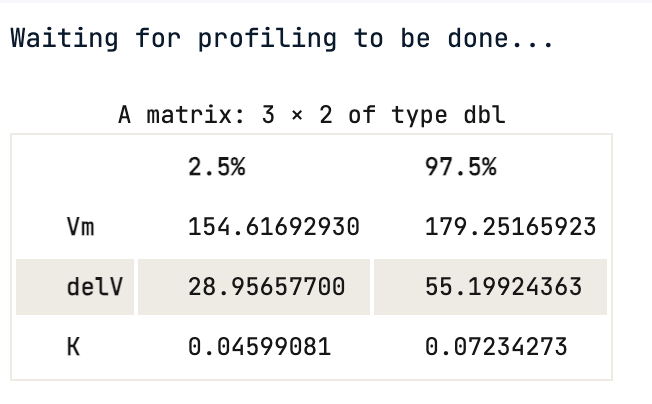
Mit dem Konfidenzintervall kann man statistisch sagen, dass mit 95 % Wahrscheinlichkeit der wahre Parameterwert, z. B. Vmax, im angegebenen Bereich liegt – für Vmax also zwischen 154,62 und 179,25.
Profiling
Über ein Profiling des Modells lässt sich die Unsicherheit der Parameterschätzung untersuchen, indem man die Zielfunktion direkt betrachtet. In unserem Modell haben wir drei Parameter Vmax, delV, K, die wir profilieren können:
- Um Konfidenzintervalle zu erhalten.
- Und über die Profilfunktion t, die dem t-Statistikansatz in linearen Modellen ähnelt. Plots der Profil-t-Funktion liefern Likelihood-Intervalle für einzelne Parameter und zeigen, wie nichtlinear die Schätzung ist.
Konfidenzintervalle plotten
Diese Plots zeigen die Konfidenzintervalle der Parameter für verschiedene Werte von , was verschiedenen Konfidenzniveaus (99 %, 95 %, 90 %, 80 % und 50 %) entspricht. Das ist ähnlich zum 95%-Intervall aus confint(object, parm, level = 0.95, ...)function.
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)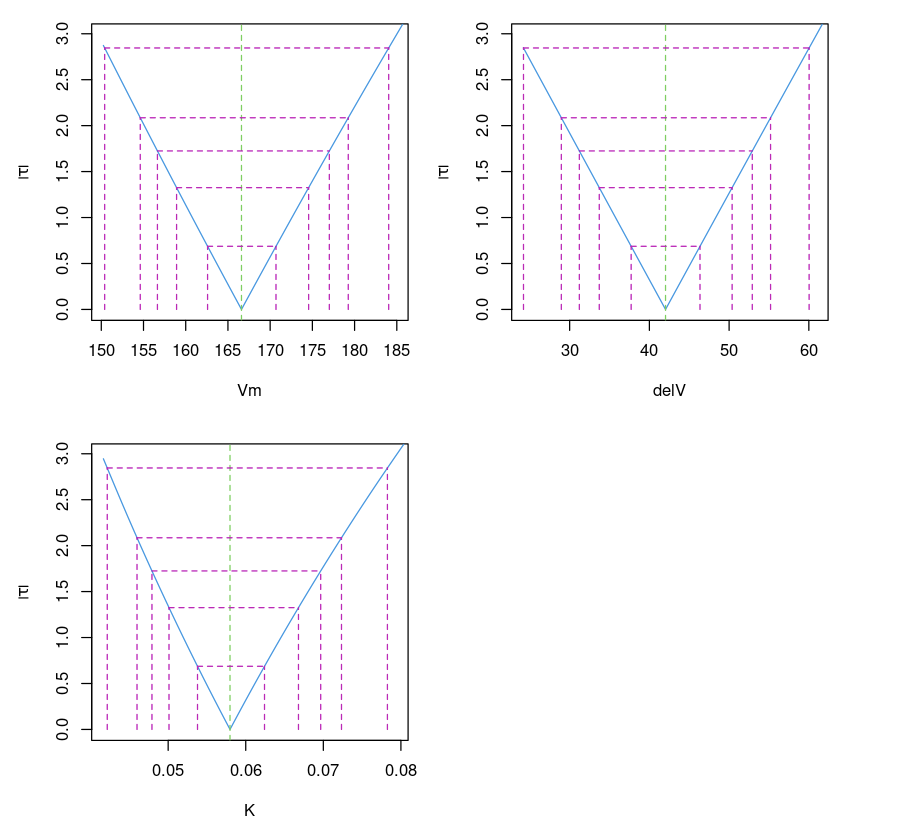
Plot von T vs. Parameter
Die Plots der drei Parameter Vmax, delV, K gegen T zeigen, ob der Fit eher linear oder nichtlinear ist. Man erkennt: für delV und Vm wirkt die Linie linear, für K leicht gekrümmt. Das ist zu erwarten, da K eine nichtlineare Beziehung aufweist.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")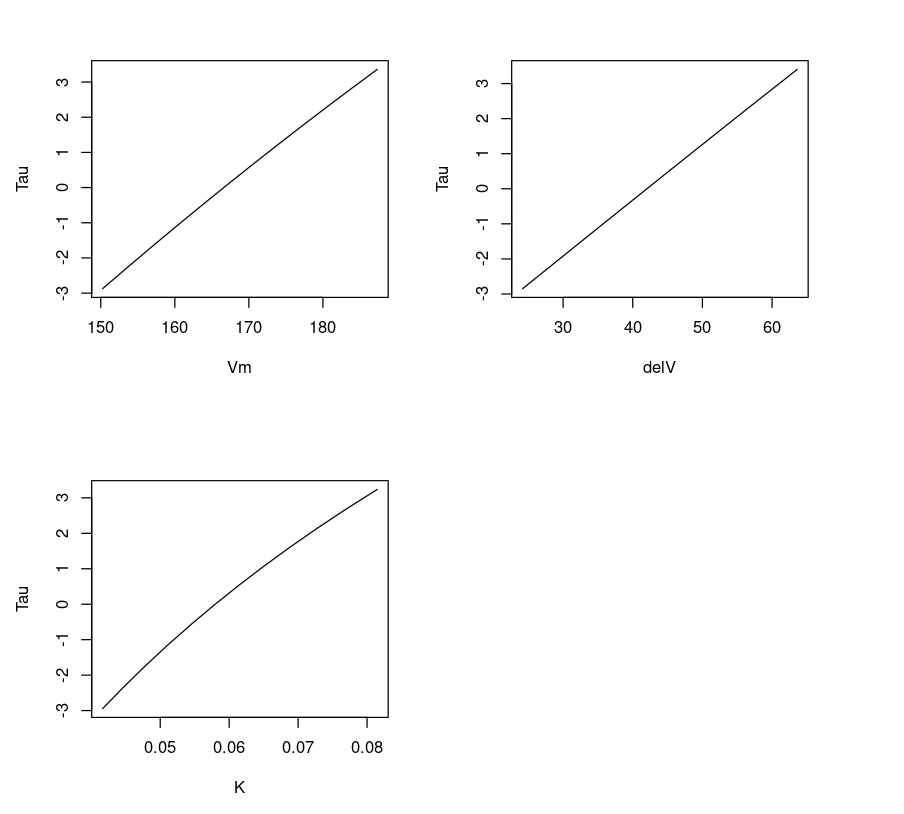
Lineares Modell fitten
Mit nls() lässt sich auch ein lineares Modell fitten, wie unten gezeigt. Aus Interpretations- und Vergleichsgründen ist es generell sinnvoll, stets auch ein lineares Modell zu testen.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Obwohl die Parameter signifikant wirken, ist der Fit schwach. Der Residual Standard Error ist hoch.
Fit visualisieren
Das lineare Modell schneidet sichtbar schlechter ab. Der Plot der gefitteten Linie im Vergleich zum nichtlinearen Pendant macht das klar.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)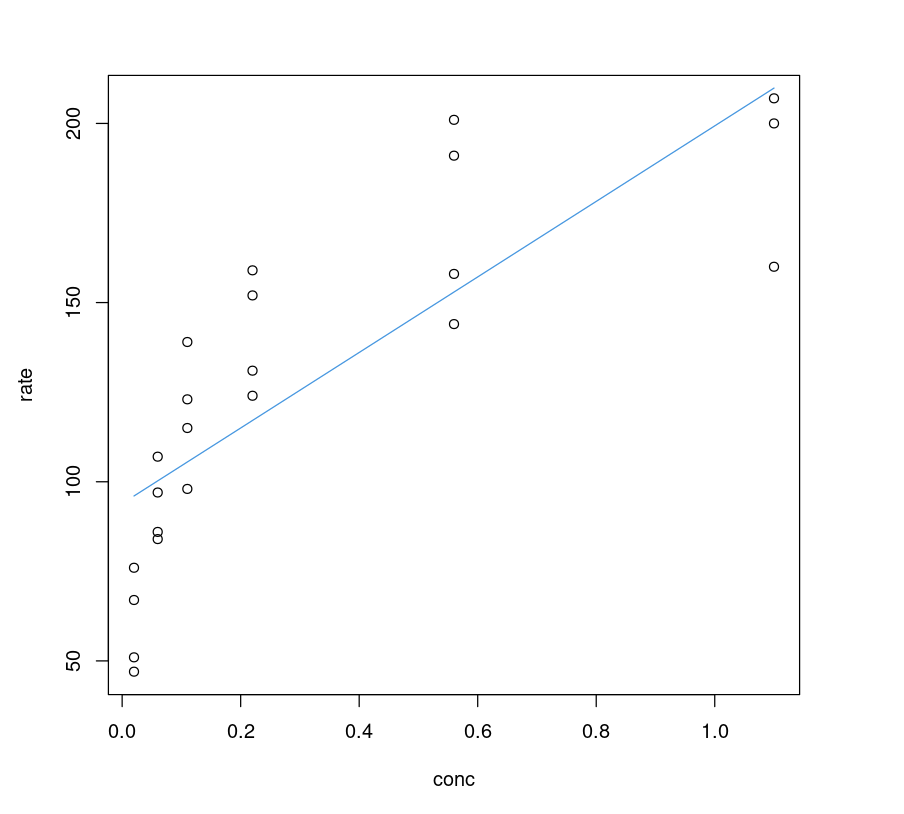
Nichtlineares vs. lineares Modell analytisch vergleichen
Der obige Plot zeigt: Das lineare Modell leistet wenig. Wie vergleichen wir die Modelle fair? Ein direkter AIC-Vergleich ist hier nicht sinnvoll.
Goodness of Fit
Ein guter Fit bedeutet bei Regression: Vorhersage und Ist-Wert liegen möglichst dicht beieinander. Prüft man mit lm() die Qualität der Vorhersagen, lassen sich Modelle vergleichen. Je näher die Punkte an der Ideallinie liegen (100 % korrekte Vorhersage), desto besser.
Nichtlinearer Fit
Für jeden Datenpunkt sagen wir den Zielwert voraus und nutzen danach lm(). Im Scatterplot zwischen Ist-Rate (x) und Vorhersage (y) plus Ideallinie sieht man die Abweichungen.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104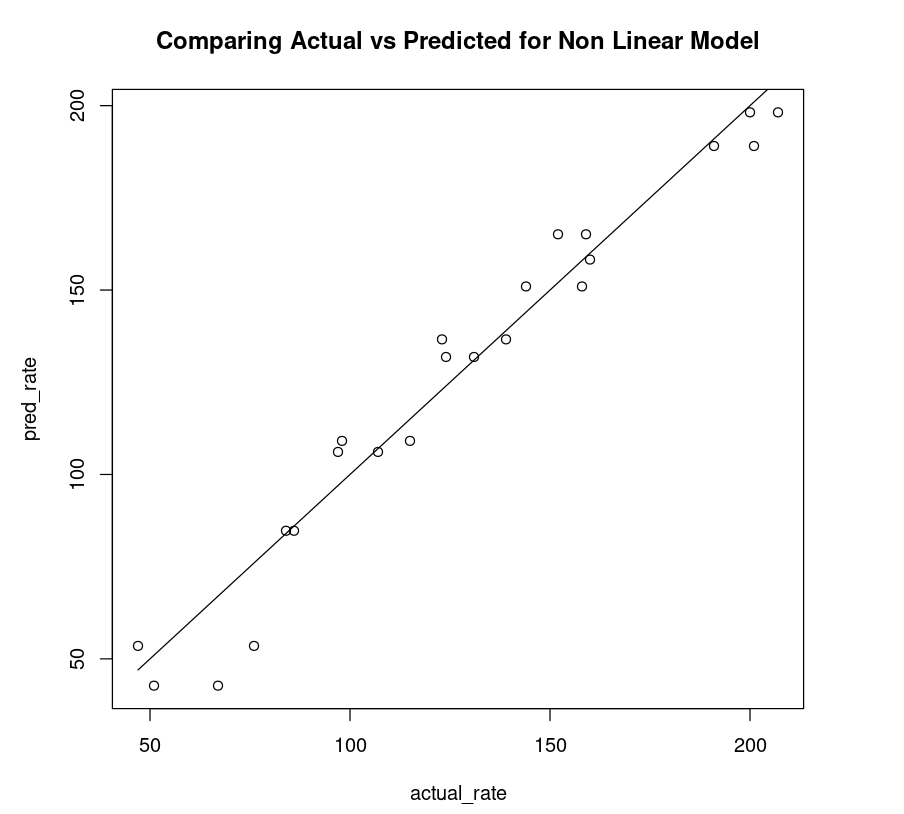
Linearer Fit
Der oben gezeigte nichtlineare Plot passt klar besser als der lineare Plot unten.
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551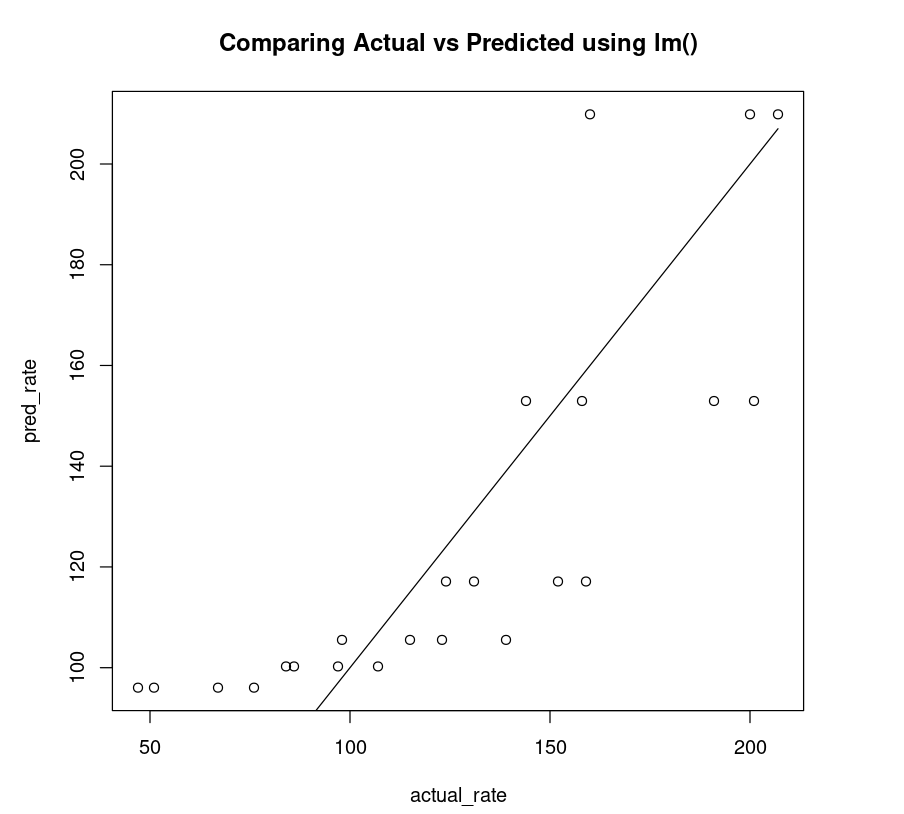
Lineares Modell verbessern
Dem linearen Modell tun wir etwas Unrecht, denn die Daten folgen erkennbar keiner Geraden. Wir können es daher mit transformierten Daten probieren. Mit sqrt() transformieren wir conc und fitten ein lineares Modell:
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09Tatsächlich sinkt der Residual Standard Error, aber weniger stark als erhofft.
Fit plotten
Die sqrt()-Transformation von conc verbessert das lineare Modell sichtbar. Gegenüber dem nichtlinearen Modell Purboth ist es jedoch weiterhin unterlegen. Der Residual Standard Error von PurbothLinearSqrt ist fast doppelt so hoch wie bei Purboth. Wir verfolgen dieses Modell daher nicht weiter. Höhere Polynomgrade (polynomielle Regression) wären möglich, erfordern aber deutlich mehr Feintuning – während ein nichtlineares Modell hier schneller zu besseren Ergebnissen führt.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)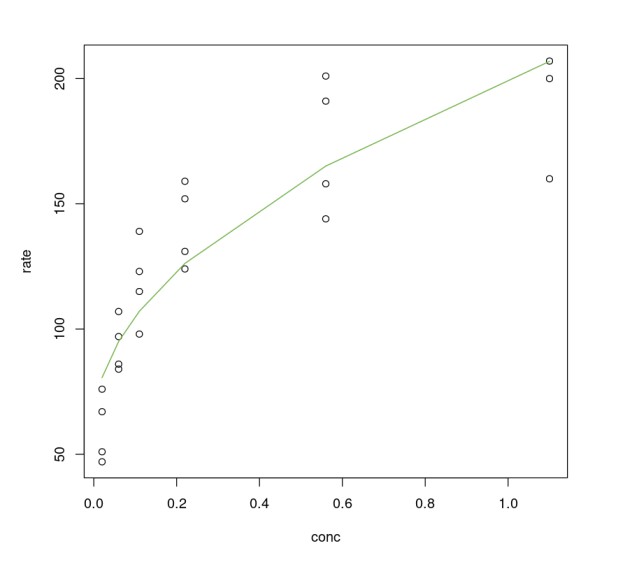
Nichtlinearität „entwirren“
Man kann eine nichtlineare Funktion auch umformen und dann ein lineares Modell fitten. Diese Technik stammt aus Zeiten von Handrechnungen – in der Praxis überzeugt sie selten.
Nichtlinear in lineare Form überführen
Zur Veranschaulichung invertieren wir die Michaelis-Menten-Gleichung und nutzen die modifizierte Form für ein lineares Modell.
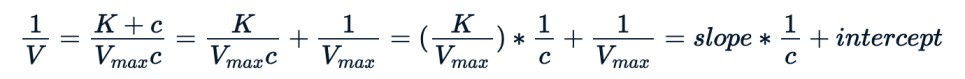
Auch hier können wir nls() verwenden, um die neue Gleichung zu fitten.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09Der Residual Standard Error ist hier zwar niedrig, aber auf transformierten Daten – damit ist ein Vergleich mit den nichtlinearen Modellen auf Originalskala nicht zulässig. Am besten visualisieren wir die Performance auf dem Originaldatensatz.
Fit plotten
Wir vergleichen das Zwei-Parameter-Modell Purboth_1 (Vmax, K) mit PurbothPseudoLinear. Der Plot zeigt klar: Das nichtlineare Modell leistet mehr.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))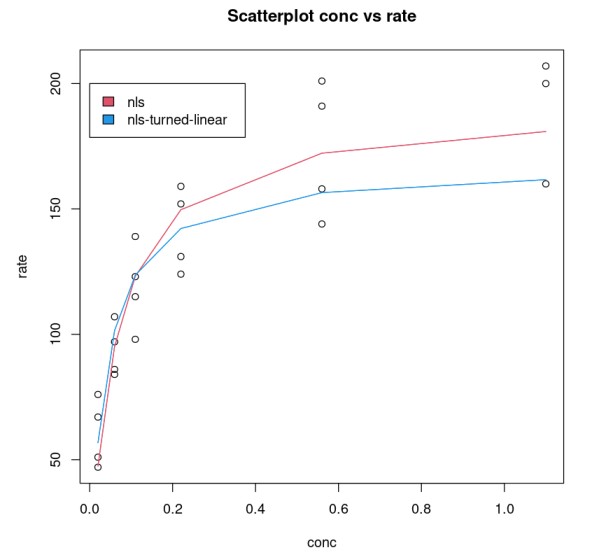
Goodness of Fit
Wir vergleichen die Modellgüte.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Das zeigt: Ein Modell mit nichtlinearer Funktion schneidet deutlich besser ab.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)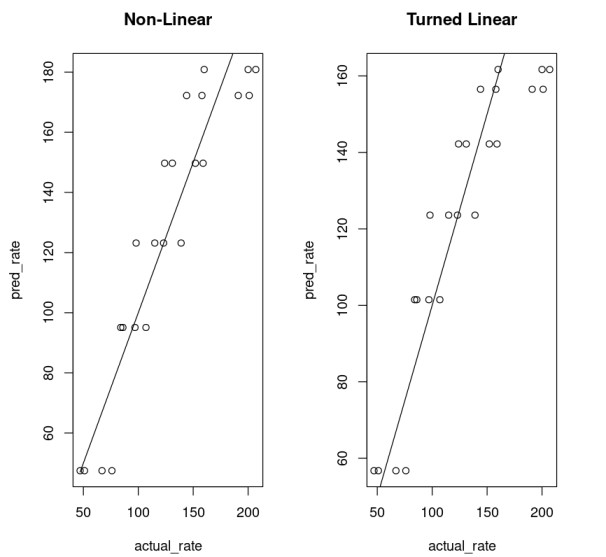
Fazit
Das nichtlineare Modell ist dem linearen Pendant oft überlegen – besonders bei mechanistischen Daten. Aber: Nichtlineare Modelle garantieren keine numerische Lösung. Visualisiere die Daten und wähle eine passende mathematische Funktion für die Beziehung. In solchen Fällen ist das nichtlineare Modell seinem linearen Gegenstück meist überlegen.
Wenn dir dieser Artikel weitergeholfen hat und du tiefer in Regressionsmodelle einsteigen willst, schau dir den DataCamp-Kurs Intermediate Regression in R an.






