Ce tutoriel est une précieuse contribution de notre communauté et a été édité par DataCamp pour en garantir la clarté et l'exactitude.
Envie de partager votre expertise ? Nous serions ravis de vous lire ! Soumettez vos articles ou idées via notre formulaire de contribution communautaire.
Les modèles non linéaires sont moins en vogue qu'autrefois. Aujourd'hui, de nombreux ouvrages les passent sous silence ou n'en proposent qu'un aperçu. Les raisons ne manquent pas. D'abord, on peut ajuster une courbe non linéaire avec une régression linéaire, en ajoutant des termes polynomiaux d'ordre supérieur ou en appliquant une fonction de base (par exemple, une transformation log ou racine carrée sur les variables explicatives). Ensuite, on privilégie souvent la simplicité : les modèles linéaires sont plus faciles à interpréter et à expliquer.
Par ailleurs, pour appliquer un modèle non linéaire, il est crucial de visualiser les données et d'apprécier la trajectoire, ce qui n'est pas possible en contexte multivarié. Enfin, les modèles non linéaires conviennent surtout aux cas mécanistes où les phénomènes sont purement physiques ou déterministes, ce qui s'accorde moins avec le big data, où les activités des utilisateurs sont enregistrées par des systèmes.
Pour autant, malgré ces arguments, la modélisation non linéaire reste une discipline élégante qu'il vaut la peine d'explorer et de comparer à son pendant linéaire.
Modèle de régression non linéaire
Les techniques d'estimation des modèles non linéaires sont, par nature, itératives. De plus, il existe une différence fondamentale dans la manière d'appliquer une formule non linéaire, qui n'est pas la même qu'une formule linéaire. Les trois équations/formules suivantes sont chacune considérées comme linéaires car la relation entre la variable y et B0, B1 et B2 est une droite.
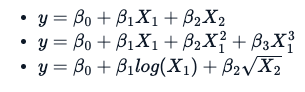
Ce qui rend une formule non linéaire, c'est par exemple ceci :
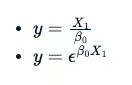
L'utilisation de B0 ou B1 est arbitraire. Toutefois, dans les deux dernières équations, la relation entre la variable y et B0 n'est pas une droite.
Conséquence : les calculs deviennent plus complexes et une solution numérique satisfaisante au problème d'estimation n'est pas garantie. Les modèles non linéaires s'accompagnent donc d'un avertissement : les résultats peuvent être peu intuitifs ou imprécis.
Modèle spécialisé
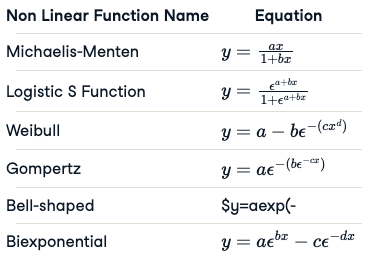
En pratique, lorsqu'on ajuste un modèle non linéaire, on recourt souvent à des formes spécialisées. Cela facilite l'ajustement ou le rend numériquement plus stable, à condition que le choix soit validé par un expert du domaine et cohérent avec les données. Par types spécialisés, on entend l'usage d'équations mathématiques prédéfinies. Voici une liste des équations non linéaires les plus courantes (liste non exhaustive).
Démarche pour un modèle de régression non linéaire
- Visualiser les données pour identifier une fonction mathématique spécialisée apte à mieux les décrire.
- À l'œil (depuis le graphique) ou via une fonction d'initialisation automatique (voir ci-dessous), choisir des valeurs initiales de paramètres.
- Ajuster le modèle et l'examiner.
- Réaliser une analyse statistique du modèle ajusté pour étudier les intervalles de confiance des paramètres, l'erreur résiduelle et la part de variation expliquée.
- Essayer d'ajouter des paramètres si cela réduit l'erreur résiduelle.
- Toujours ajuster un modèle linéaire en parallèle et comparer les résultats des modèles non linéaires et linéaires.
Expliquer le modèle non linéaire par un exemple
Nous allons ajuster un modèle non linéaire spécialisé sur un jeu de données bien connu, Puromycin, qui présente la vitesse de réaction et la concentration pour une réaction enzymatique sur des cellules exposées au Puromycin. Les données comptent deux groupes de cellules : l'un traité au Puromycin, l'autre non traité.
names(Puromycin)Puromycin'conc''rate''state'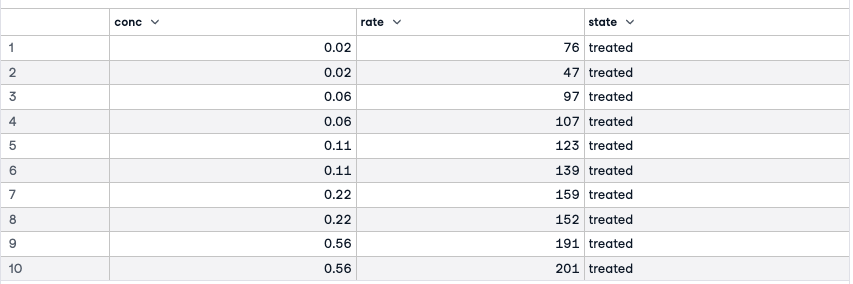
Les trois variables de ce dataframe sont la concentration du substrat, la vitesse initiale de la réaction et un indicateur de traitement (traité ou non).
En représentant la vitesse en fonction de la concentration et en distinguant les deux modalités de traitement, on observe un motif clair. Les courbes sont asymptotiques et bien distinctes pour les cellules traitées et non traitées.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))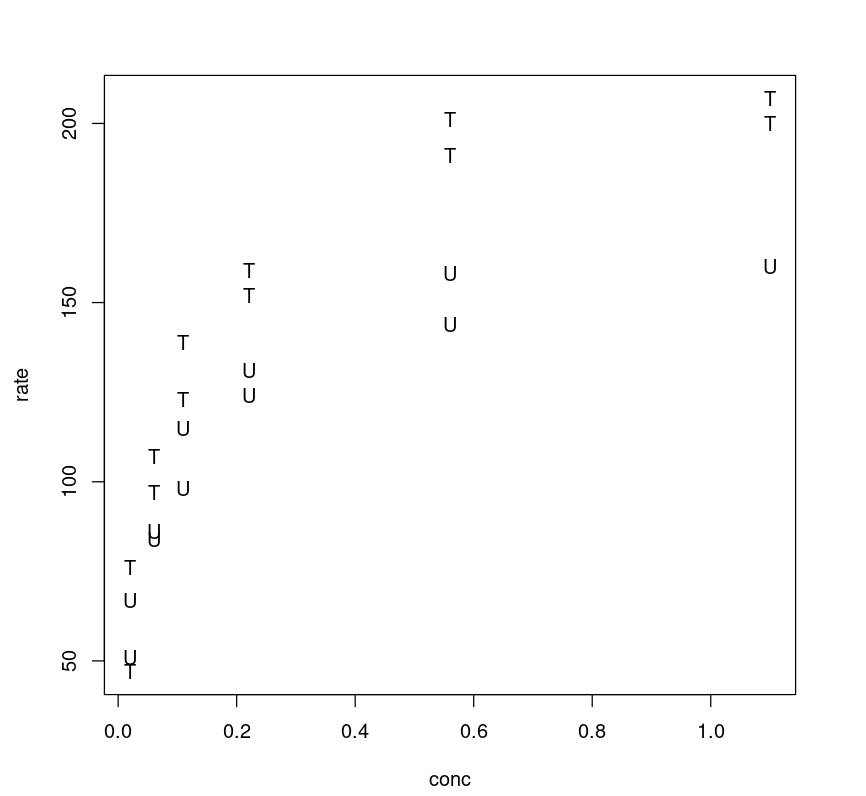
Comme ces données suivent clairement une relation de Michaelis-Menten entre la vitesse de réaction et la concentration, les expérimentateurs s'attendent à pouvoir ajuster l'équation suivante.
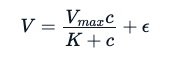
Ici, E désigne l'erreur expérimentale. Par analogie avec le modèle linéaire, via un modèle non linéaire spécialisé, nous cherchons à estimer les paramètres Vmax et K qui minimisent la somme des carrés des résidus (d'autres méthodes d'estimation existent toutefois) :
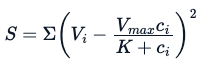
Ajuster un modèle non linéaire
Même si la relation est connue, l'ajustement n'est pas trivial car le modèle requiert des valeurs initiales pour Vmax et K. Si l'on choisit mal ces valeurs de départ, l'ajustement peut être médiocre. Deux options s'offrent à vous :
- Estimer les valeurs initiales à l'œil depuis le graphique.
- Ou utiliser une fonction d'initialisation automatique (voir ci-dessous).
Fonction auto-initialisée | Modèle |
SSasymp | modèle de régression asymptotique |
SSasympOff | modèle de régression asymptotique avec décalage |
SSasympOrig | modèle de régression asymptotique passant par l'origine |
SSbiexp | modèle bi-exponentiel |
SSfol | modèle compartimental d'ordre 1 |
SSfpl | modèle logistique à quatre paramètres |
SSgompertz | modèle de croissance de Gompertz |
SSlogis | modèle logistique |
SSmicmen | modèle de Michaelis-Menten |
SSweibull | modèle de courbe de croissance de Weibull |
Pour chaque type de modèle, une fonction d'initialisation dédiée permet de proposer une valeur de départ.
Ajuster un modèle avec valeurs initiales
Avec les valeurs initiales Vmax = 160, K = 0,05 (estimées à l'œil), on peut utiliser la fonction R nls() pour ajuster le modèle. En régression linéaire, nous n'avons généralement pas besoin de préciser Vm ou K, mais c'est différent pour un modèle non linéaire. Tout algorithme itératif a besoin d'un bon point de départ, faute de quoi il peut ne pas converger. Voici comment ajuster un modèle non linéaire sur Puromycin avec ces valeurs initiales.
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Calculer l'erreur résiduelle
On calcule l'erreur résiduelle comme suit :
sse <- Purboth_1$m$deviance()sse7276.54697931423Calculer la variance expliquée
Pour obtenir la variance expliquée par ce modèle (l'équivalent du R² en régression linéaire), on estime la variance totale de la variable rate via un modèle nul, on estime la moyenne globale, on extrait la somme totale des carrés (sst) du résumé du modèle nul, puis on calcule le pourcentage de variance expliquée.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Ce modèle explique 85,34 % de la variabilité des données.
Ajuster le modèle avec une fonction d'initialisation
Puisque nous utilisons le modèle de Michaelis-Menten, on peut employer la fonction d'initialisation SSmicmen(). Elle conduit cependant aux mêmes résultats.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Calculer l'erreur résiduelle
sse <- Purboth_self$m$deviance()sse7276.54697947673Calculer la variance expliquée
On peut vérifier la variance expliquée par le modèle.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141L'équation ajustée, soit la relation entre vitesse et concentration, s'écrit en général ainsi :
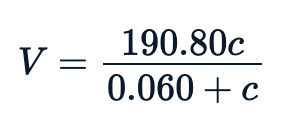
Visualiser l'ajustement
On peut visualiser la performance du modèle en traçant la courbe ajustée sur les données : la forme est bien non linéaire.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Vers un meilleur modèle
On peut affiner le modèle en ajoutant des paramètres. En observant le nuage vitesse vs concentration, on note que les deux classes (traité vs non traité) suivent des trajectoires différentes, et que l'écart de vitesse (axe y) entre les deux courbes est d'environ 40.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))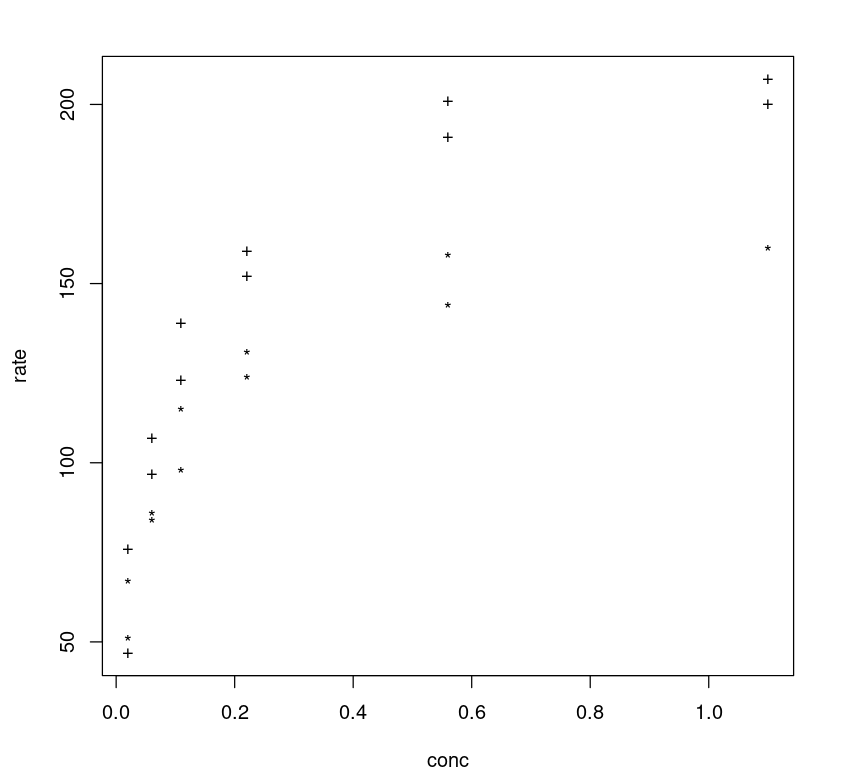
Nous cherchons donc à ajuster un modèle conditionnellement à la variable d'état, ce qui conduit à l'équation non linéaire suivante.
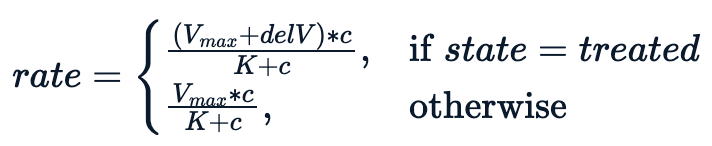
Le modèle gagne en performance avec un paramètre supplémentaire delV. On fixe une valeur initiale de 40 pour delV et on ajuste le modèle avec nls en trois paramètres.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06Le résumé indique que les trois paramètres sont statistiquement significatifs.
Calculer l'erreur résiduelle
On constate que, pour ce modèle, l'erreur résiduelle baisse nettement :
sse <- Purboth$m$deviance()sse2240.89143883885Calculer la variance expliquée
Ce modèle explique davantage de variance.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744Vérification AIC
On peut aussi comparer l'AIC des deux modèles. Même si l'usage courant privilégie aujourd'hui la validation croisée (qui demande en général plus de données), un AIC plus faible indique un meilleur compromis ajustement-complexité.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742Visualiser l'ajustement
On visualise la performance du modèle ajusté en traçant la courbe sur les données : sans surprise, le modèle affiné offre un meilleur ajustement pour les différentes classes.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))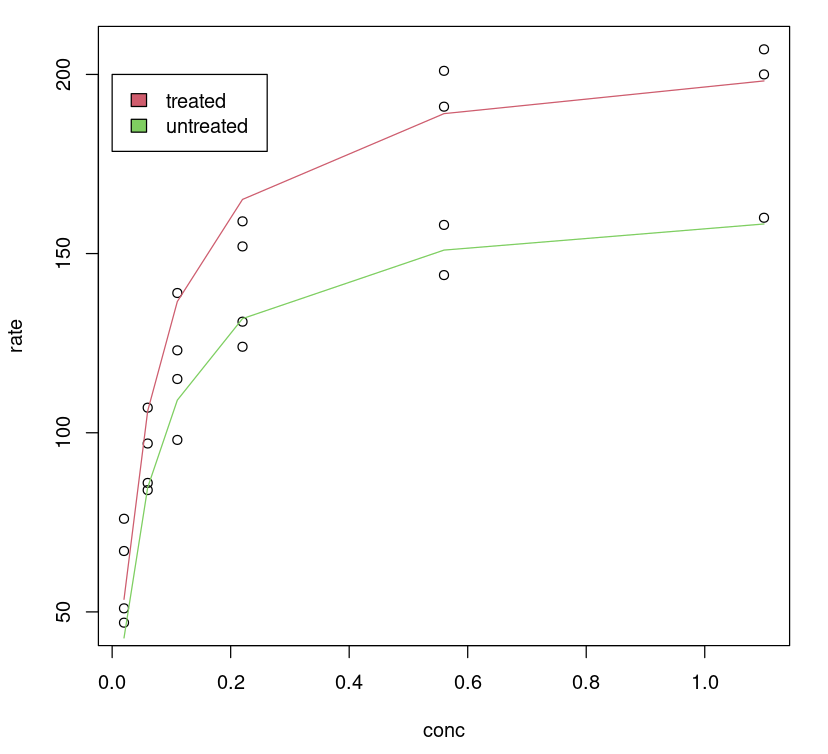
Intervalle de confiance des paramètres
On ne se fie pas qu'aux valeurs p : l'intervalle de confiance à 95 % fournit, pour chaque paramètre significatif, les bornes à 2,5 % et 97,5 %. Aucune n'inclut 0.
confint(Purboth)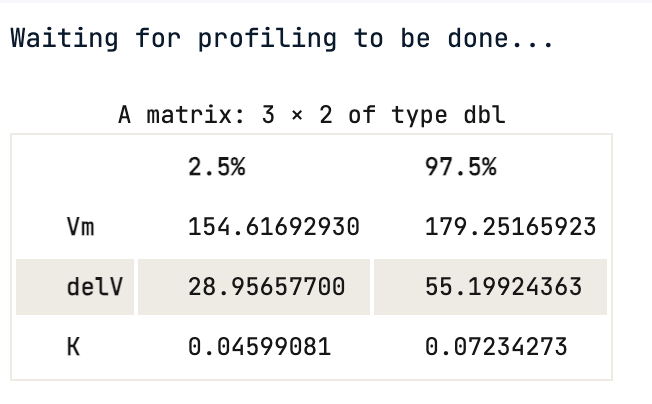
D'après ces intervalles, on peut affirmer statistiquement qu'il y a 95 % de chances que la vraie valeur d'un paramètre, par exemple Vmax, se situe dans la plage indiquée ci-dessus, soit (154,62 ; 179,25) pour Vmax.
Profilage
On peut aller plus loin en profilant le modèle pour appréhender l'incertitude d'estimation en examinant directement la fonction objectif. Notre modèle comporte trois paramètres, Vmax, delV, K : on peut les profiler pour :
- obtenir leurs intervalles de confiance ;
- utiliser la fonction de profil t, analogue aux statistiques t des modèles linéaires. Les graphiques de la fonction t de profil donnent les intervalles de vraisemblance des paramètres pris isolément et renseignent sur le caractère non linéaire de l'estimation.
Tracer l'intervalle de confiance
Ce tracé représente l'intervalle de confiance des paramètres pour différentes valeurs de (ce qui correspond à différents niveaux de confiance : 99 %, 95 %, 90 %, 80 % et 50 %). Il est analogue à l'intervalle de confiance (95 %) produit par confint(object, parm, level = 0.95, ...).
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)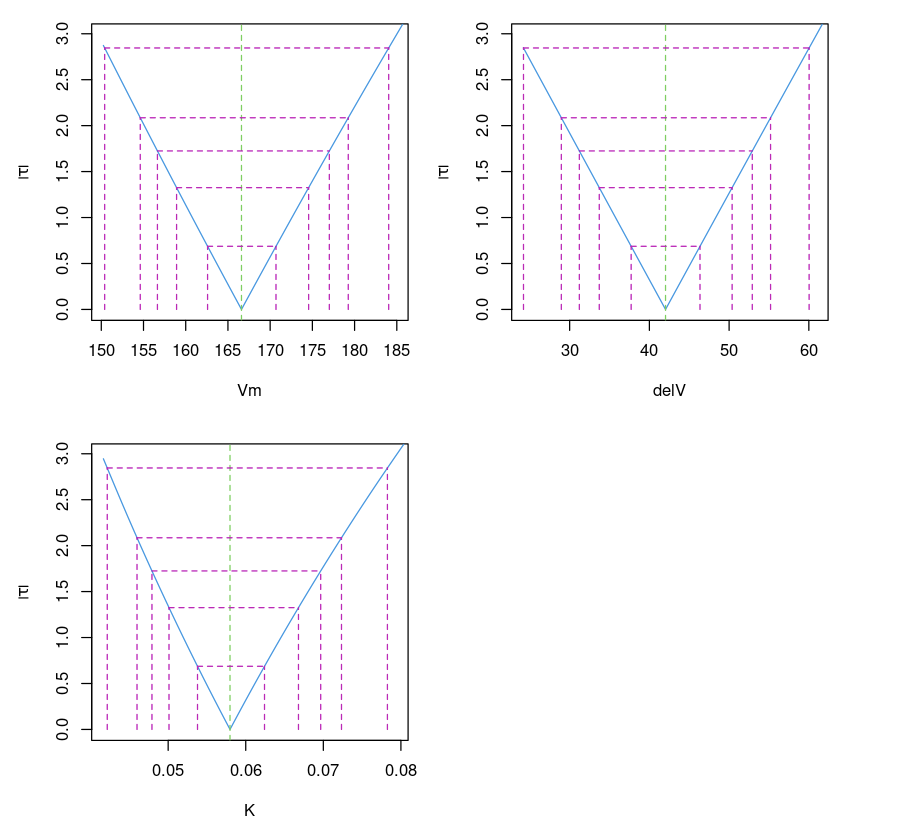
Tracer T en fonction des paramètres
Tracer les trois paramètres Vmax, delV, K en fonction de T permet d'évaluer si l'ajustement est linéaire ou non. On observe des droites pour delV et Vm, et une légère courbure pour K, ce qui est attendu car K entretient une relation non linéaire.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")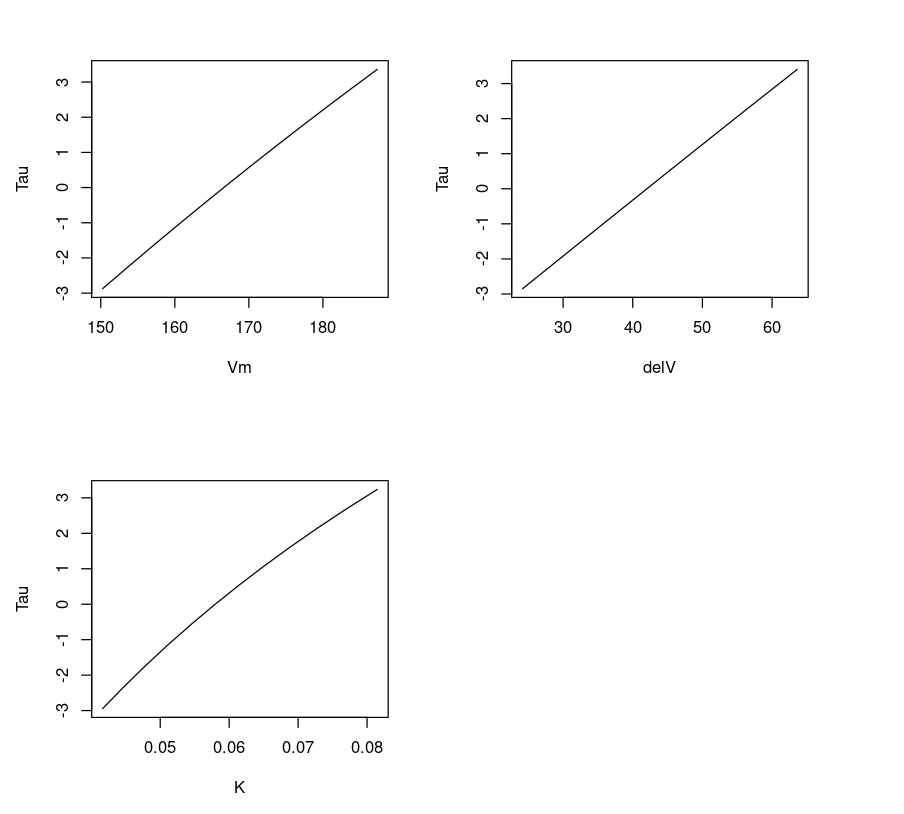
Ajuster un modèle linéaire
On peut employer la même fonction R nls() pour ajuster un modèle linéaire, comme ci-dessous. Il est toujours utile d'essayer un modèle linéaire pour l'interprétation et la comparaison.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Même si les paramètres semblent significatifs, l'ajustement est médiocre : l'erreur standard résiduelle est élevée.
Visualiser l'ajustement
Le modèle linéaire se comporte mal : on peut le constater en traçant la droite ajustée et en la comparant à son équivalent non linéaire.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)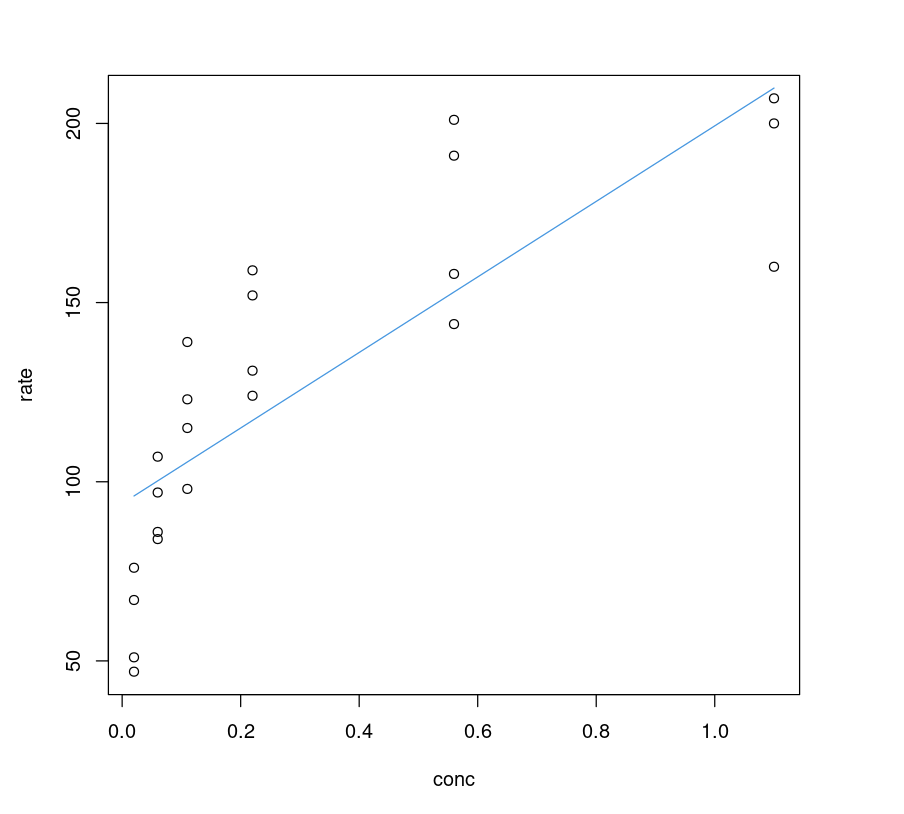
Comparer analytiquement modèles non linéaire vs linéaire
Le graphique ci-dessus montre que le modèle linéaire s'en sort mal. Mais comment comparer ces modèles, qui ne sont pas de même nature ? Ce serait comparer des pommes et des oranges. Les résultats d'AIC ne sont pas directement exploitables.
Qualité d'ajustement
Qu'est-ce qu'un bon ajustement en régression ? La proximité entre valeurs prévues et valeurs observées. En examinant la qualité des prédictions via une fonction R lm(), on peut comparer les modèles. Le modèle le plus précis présente des points proches de la droite idéale. Cette droite représente un modèle parfaitement précis : la prédiction est égale à la valeur observée pour chaque point, tous les points sont alignés.
Ajustement non linéaire
Pour chaque observation, on prédit la valeur cible et on applique ensuite lm() comme indiqué. En traçant le nuage entre la vitesse réelle (axe x) et la vitesse prédite (axe y) et en ajoutant la droite idéale, on évalue la proximité des points à cette droite.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104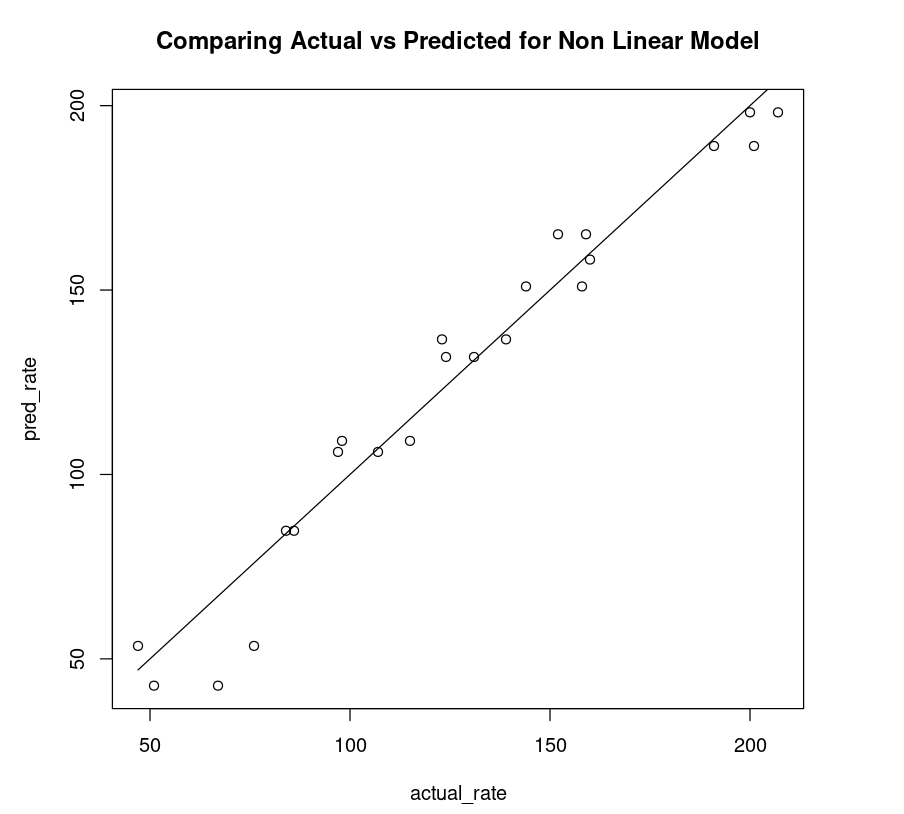
Ajustement linéaire
Le graphique non linéaire ci-dessus est clairement meilleur que le graphique linéaire (ci-dessous).
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551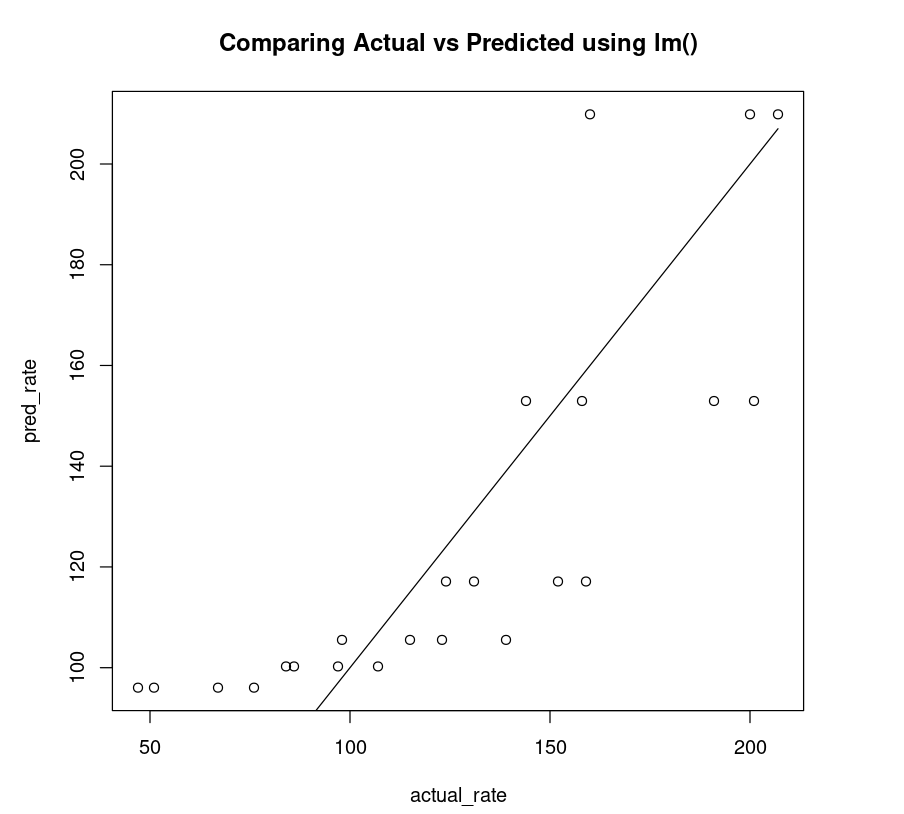
Améliorer le modèle linéaire
Soyons justes avec le modèle linéaire : les données ne suivent pas une droite, essayons donc une transformation. On applique sqrt() à conc et on ajuste un modèle linéaire comme suit.
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09L'erreur standard résiduelle baisse bien, mais moins que prévu.
Tracer l'ajustement
On voit nettement que la transformation sqrt() sur conc améliore le modèle linéaire. Cependant, en comparaison du modèle non linéaire Purboth, ce n'est pas meilleur. L'erreur standard résiduelle du modèle PurbothLinearSqrt est presque le double de celle de Purboth ; nous n'analyserons donc pas davantage ce modèle. On pourrait tenter des polynômes d'ordre supérieur, mais l'effort de réglage serait bien plus important alors qu'un modèle non linéaire fournit déjà de meilleurs résultats.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)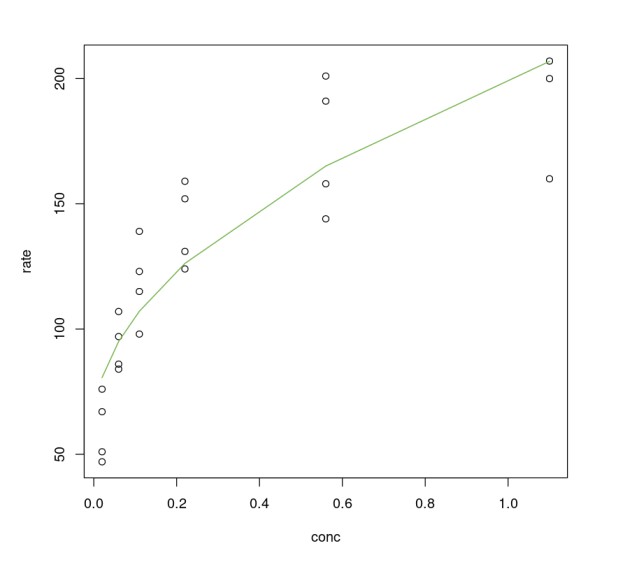
Linéariser une équation non linéaire
On peut recourir à une astuce pour linéariser une fonction non linéaire et ajuster un modèle linéaire. Cette technique, courante quand les calculs se faisaient à la main, est aujourd'hui dépassée et donne en général de moins bons résultats.
Passer d'une forme non linéaire à linéaire
À titre d'illustration, on peut inverser l'équation de Michaelis-Menten comme ci-dessous, puis ajuster un modèle linéaire sur cette forme transformée.
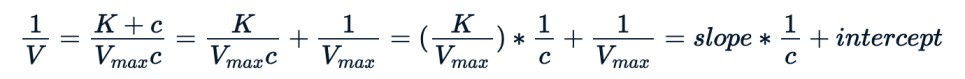
On peut utiliser la même fonction nls() pour ajuster la nouvelle équation.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09L'erreur standard résiduelle est faible, mais elle est calculée sur des données transformées, ce qui interdit la comparaison directe avec les modèles non linéaires sur l'échelle d'origine. Le mieux est de visualiser les performances sur les données initiales.
Tracer l'ajustement
Comparons le modèle Purboth_1 (deux paramètres Vmax et K) à PurbothPseudoLinear. Le tracé montre clairement que le modèle non linéaire s'en sort mieux.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))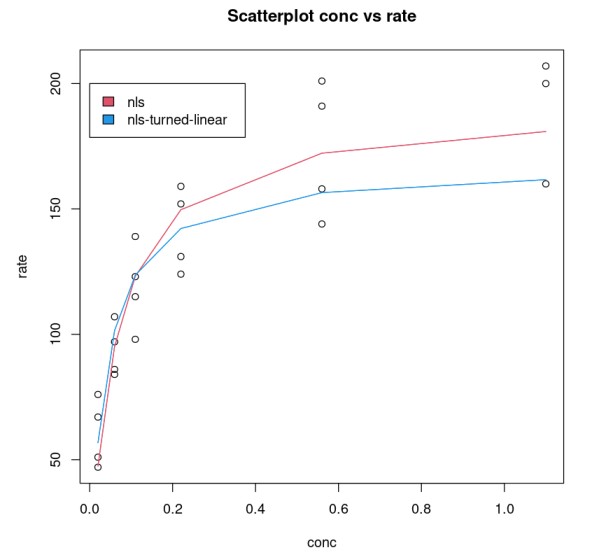
Qualité d'ajustement
On peut comparer la qualité des deux modèles.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Cela confirme qu'un modèle utilisant une fonction non linéaire fonctionne nettement mieux.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)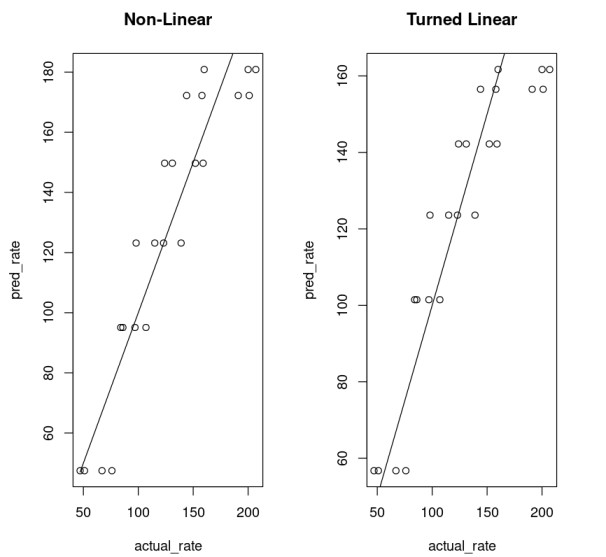
Conclusion
Les modèles non linéaires surpassent souvent leurs homologues linéaires, en particulier lorsque les données traduisent des mécanismes sous-jacents. Attention toutefois : ils ne garantissent pas l'existence d'une solution numérique à chaque problème d'estimation. En visualisant les données et en choisissant une fonction adéquate, on peut mieux capturer la relation ; dans ces cas, le non linéaire prend l'avantage.
Si cet article vous a éclairé et que vous souhaitez aller plus loin dans l'univers des modèles de régression, découvrez le cours Intermediate Regression in R de DataCamp.