
Last chance! 50% off DataCamp Premium
Sale ends in
यह ट्यूटोरियल हमारे समुदाय का एक मूल्यवान योगदान है और स्पष्टता व शुद्धता के लिए DataCamp द्वारा संपादित किया गया है।
क्या आप अपना विशेषज्ञता ज्ञान साझा करना चाहते हैं? हमें आपसे सुनकर खुशी होगी! हमारे Community Contribution Form के माध्यम से अपने लेख या विचार भेजें।
नॉन-लिनियर मॉडल पहले जितने लोकप्रिय थे, अब उतने नहीं रहे। आजकल कई किताबें नॉन-लिनियर मॉडलों पर चर्चा को छोड़ देती हैं या बहुत सीमित रूप में समझाती हैं। इसके कई कारण हैं। पहला, उच्च-क्रम के बहुपद पद जोड़कर या बेसिस फंक्शन लागू करके (यानी व्याख्यात्मक चरों पर log या sqrt ट्रांसफॉर्मेशन) लिनियर रिग्रेशन से भी नॉन-लिनियर कर्व फिट किया जा सकता है। दूसरा, कई बार जटिल मॉडलों की तुलना में सादगी को प्राथमिकता दी जाती है क्योंकि लिनियर मॉडल समझाने और व्याख्या करने में आसान होते हैं।
इसके अलावा, नॉन-लिनियर मॉडल लागू करने के लिए डेटा का विज़ुअलाइज़ेशन करना और उसकी ट्रैजेक्टरी का अंदाज़ा लगाना ज़रूरी होता है, जो मल्टीवेरिएट सेटिंग में संभव नहीं है। अंततः, नॉन-लिनियर मॉडल उन्हीं मेकेनिस्टिक मामलों के लिए सबसे उपयुक्त हैं जहाँ घटनाएँ पूरी तरह भौतिक या नियतात्मक हों—जबकि बिग डेटा में उपयोगकर्ता गतिविधियाँ मशीनों द्वारा लॉग की जाती हैं, वहाँ ऐसा नहीं होता।
फिर भी, इन सभी कारणों के बावजूद, नॉन-लिनियर मॉडलिंग एक सुंदर विज्ञान है, जिसे इसके लिनियर समकक्ष से तुलना करते हुए अवश्य खोजा जाना चाहिए।
नॉन-लिनियर मॉडल के आकलन की तकनीकें मूलतः इटरेटिव होती हैं। साथ ही, नॉन-लिनियर सूत्र लागू करने का तरीका लिनियर सूत्र से मौलिक रूप से अलग होता है। नीचे दिए गए तीन अलग-अलग समीकरणों/सूत्रों में से प्रत्येक को लिनियर माना जाता है क्योंकि चर y और B0, B1, तथा B2 के बीच संबंध सीधी रेखा का है।
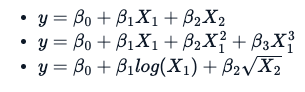
किसी सूत्र को नॉन-लिनियर बनाता है, कुछ इस प्रकार:
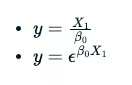
B0 या B1 का उपयोग मनमाना है। हालाँकि, बाद की दोनों समीकरणों में चर y और B0 के बीच सीधी-रेखा संबंध नहीं है।
दुर्भाग्य से, इससे गणनाएँ अधिक कठिन हो जाती हैं, और अनुमान की समस्या का सफल संख्यात्मक हल सुनिश्चित नहीं रहता। इसलिए, नॉन-लिनियर मॉडल के साथ सावधानी बरतनी होती है कि उनसे निकले उत्तर सहज या सटीक न भी हों।
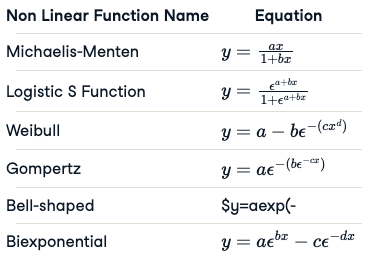
आमतौर पर, जब नॉन-लिनियर मॉडल लगाया जाता है, तो विशेष प्रकारों का उपयोग किया जाता है। इससे नॉन-लिनियर मॉडल फिट करना सुविधाजनक या संख्यात्मक रूप से सरल हो जाता है, लेकिन इसे विषय-विशेषज्ञ की सहमति और डेटा के अनुरूप होना चाहिए। विशेष प्रकार से आशय है कि कोई पूर्व-परिभाषित गणितीय समीकरण अपनाया जाए। यहाँ प्रायः उपयोग होने वाली नॉन-लिनियर समीकरणों की सूची दी है (संक्षेप में कुछ छोड़ी गई हैं)।
हम एक लोकप्रिय डेटासेट Puromycin पर विशेषीकृत नॉन-लिनियर मॉडल फिट करने जा रहे हैं, जो Puromycin दवा से संबद्ध कोशिकाओं में एंज़ाइमेटिक रिएक्शन के रिएक्शन रेट और कॉन्सेंट्रेशन की जानकारी प्रस्तुत करता है। डेटा में कोशिकाओं के दो वर्ग हैं—एक, जिन्हें Puromycin दवा दी गई, और दूसरा, जिन्हें नहीं दी गई।
names(Puromycin)Puromycin'conc''rate''state'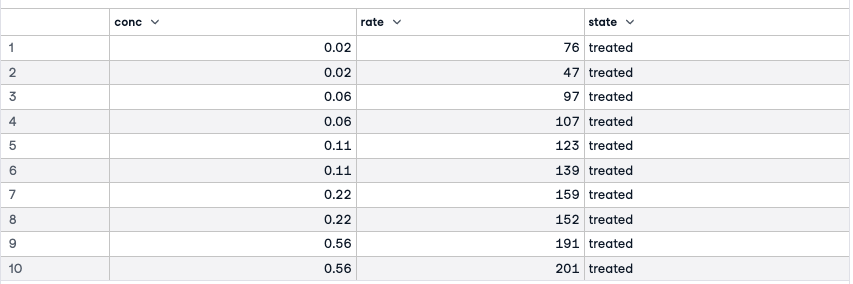
इस डेटा फ्रेम में तीन चर हैं—सब्सट्रेट का कॉन्सेंट्रेशन, रिएक्शन का प्रारंभिक रेट, और ट्रीटमेंट (ट्रीटेड/अनट्रीटेड) का संकेतक।
रेट को कॉन्सेंट्रेशन के विरुद्ध प्लॉट करके और ट्रीटमेंट के दोनों स्तरों को लेबल करके हम एक सामान्य पैटर्न देख सकते हैं। कर्व्स एसिम्प्टोटिक हैं और ट्रीटेड तथा अनट्रीटेड कोशिका समूहों के लिए काफ़ी भिन्न दिखते हैं।
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))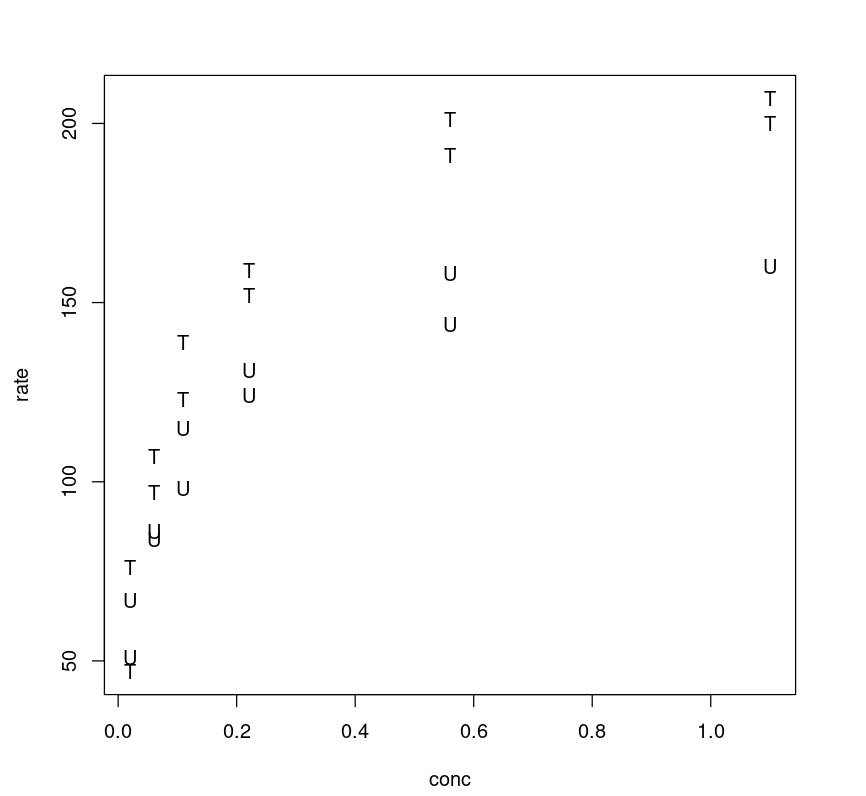
क्योंकि इस डेटा में रिएक्शन रेट और कॉन्सेंट्रेशन के बीच प्रबल Michaelis-Menten संबंध दिखता है, प्रयोगकर्ता निम्न गणितीय समीकरण फिट करने की अपेक्षा करते हैं।
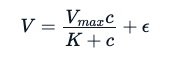
यहाँ E प्रयोगजन्य त्रुटि है। लिनियर मॉडल के लिए प्रयुक्त समान उपमा के साथ, नॉन-लिनियर विशेषीकृत मॉडल के द्वारा हम Vmax और K पैरामीटरों का आकलन करने का प्रयास करते हैं ताकि रेजिडुअल्स के सम वर्गों का योग न्यूनतम हो सके (हालाँकि इन पैरामीटरों के आकलन के अन्य तरीके भी उपलब्ध हैं):
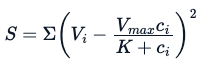
यद्यपि हमें संबंध ज्ञात है, नॉन-लिनियर मॉडल फिट करना इतना सीधा नहीं है क्योंकि मॉडल को Vmax और K के प्रारंभिक अनुमान चाहिए होते हैं। यदि अच्छा प्रारंभिक अनुमान न चुना जाए तो मॉडल डेटा पर खराब फिट हो सकता है। आपके पास दो विकल्प हैं:
सेल्फ-स्टार्टिंग फ़ंक्शन | मॉडल |
SSasymp | एसिम्प्टोटिक रिग्रेशन मॉडल |
SSasympOff | ऑफ़सेट सहित एसिम्प्टोटिक रिग्रेशन मॉडल |
SSasympOrig | ऑरिजिन से गुजरता एसिम्प्टोटिक रिग्रेशन मॉडल |
SSbiexp | बाइएक्सपोनेंशियल मॉडल |
SSfol | फ़र्स्ट-ऑर्डर कम्पार्टमेंट मॉडल |
SSfpl | फ़ोर-पैरामीटर लॉजिस्टिक मॉडल |
SSgompertz | Gompertz ग्रोथ मॉडल |
SSlogis | लॉजिस्टिक मॉडल |
SSmicmen | Michaelis–Menten मॉडल |
SSweibull | Weibull ग्रोथ कर्व मॉडल |
हर मॉडल प्रकार के लिए हमारे पास एक संबंधित सेल्फ-स्टार्टर फ़ंक्शन है, जिसे प्रारंभिक अनुमान हेतु उपयोग किया जा सकता है।
Vmax = 160, K = 0.05 के प्रारंभिक मान, जो प्लॉट देखकर निकाले गए, का उपयोग करके R का nls() फ़ंक्शन डेटा फिट करने हेतु प्रयोग किया जा सकता है। सामान्यतः लिनियर रिग्रेशन में हमें Vm या K पैरामीटर बताने की आवश्यकता नहीं होती, पर नॉन-लिनियर मॉडल में यह अलग है। हर इटरेटिव एल्गोरिद्म को एक अच्छा शुरुआती बिंदु चाहिए, अन्यथा यह कन्वर्ज नहीं कर सकता। Puromycin पर प्रारंभिक मानों के साथ नॉन-लिनियर मॉडल इस प्रकार फिट करते हैं।
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06हम रेजिडुअल त्रुटि इस प्रकार निकालते हैं:
sse <- Purboth_1$m$deviance()sse7276.54697931423इस मॉडल द्वारा समझाई गई विचरण (मूलतः लिनियर मॉडल शब्दावली में R-square) निकालने के लिए, हमें एक नल मॉडल फिट कर कुल विचरण निकालना, समग्र औसत का आकलन करना, और नल मॉडल के सारांश से कुल सम वर्ग, sst, प्राप्त करना होगा; फिर इसका उपयोग करके समझाई गई विचरण का प्रतिशत निकालेंगे।
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681यह मॉडल डेटा में 85.34% भिन्नताओं को समझाता है।
क्योंकि हम Michaelis-Menten मॉडल उपयोग कर रहे हैं, इसलिए SSmicmen() सेल्फ-स्टार्ट फ़ंक्शन भी इस्तेमाल किया जा सकता है। हालाँकि, इससे वही परिणाम मिलते हैं।
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06sse <- Purboth_self$m$deviance()sse7276.54697947673मॉडल द्वारा समझाई गई विचरण जाँची जा सकती है।
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141सामान्यतः, फिट किया गया समीकरण, जो रेट बनाम कॉन्सेंट्रेशन का संबंध है, कुछ ऐसा दिखता है:
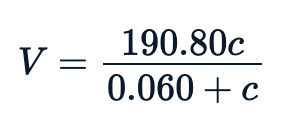
डेटा पर फिट की गई रेखा प्लॉट करके देखा जा सकता है कि मॉडल कैसा प्रदर्शन करता है; यह नॉन-लिनियर दिखती है।
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
मॉडल में और पैरामीटर जोड़कर उसे और ट्यून किया जा सकता है। यदि रेट बनाम कॉन्सेंट्रेशन का प्लॉट देखें तो ध्यान होगा कि अलग-अलग वर्ग (ट्रीटेड बनाम अनट्रीटेड) अलग ट्रैजेक्टरी का अनुसरण करते हैं, और दो वर्गों की ट्रैजेक्टरी के बीच रेट का अंतर (y-अक्ष) लगभग 40 माना जा सकता है।
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))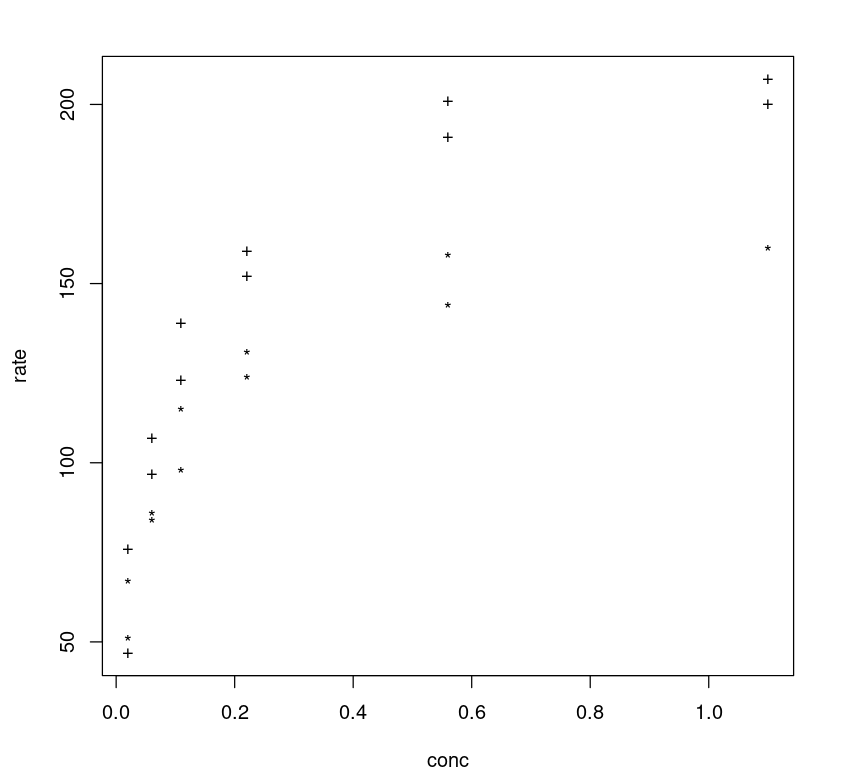
मूलतः, हम state चर पर कंडीशनिंग करते हुए मॉडल फिट करने का प्रयास कर रहे हैं, जो निम्न नॉन-लिनियर समीकरण की ओर ले जाता है।
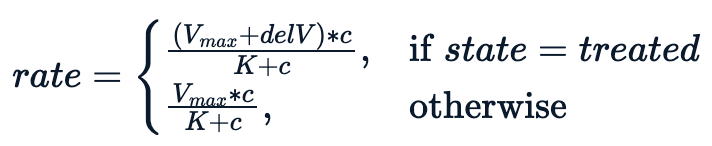
अतिरिक्त पैरामीटर delV के साथ मॉडल बेहतर प्रदर्शन करता है। हम delV के लिए प्रारंभिक मान 40 रखते हैं और nls से तीन पैरामीटरों वाला मॉडल फिट करते हैं।
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06सारांश बताता है कि तीनों पैरामीटर सांख्यिकीय रूप से महत्वपूर्ण हैं।
इस मॉडल के लिए रेजिडुअल त्रुटि में पर्याप्त कमी देखी जा सकती है:
sse <- Purboth$m$deviance()sse2240.89143883885इस मॉडल द्वारा अधिक विचरण समझाया गया है।
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744दोनों मॉडलों पर AIC जाँच भी की जा सकती है, यद्यपि आजकल सामान्य प्रथा क्रॉस-वैलिडेशन की है—हालाँकि इसके लिए सामान्यतः अधिक डेटा चाहिए होता है। सामान्य नियम यह है कि AIC जितना कम, मॉडल उतना बेहतर।
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742ट्यून किए गए मॉडल का प्रदर्शन डेटा पर फिट की गई रेखा प्लॉट करके देखा जा सकता है—कोई आश्चर्य नहीं, ट्यून किया गया मॉडल अलग-अलग वर्गों के लिए बेहतर फिट देता है।
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))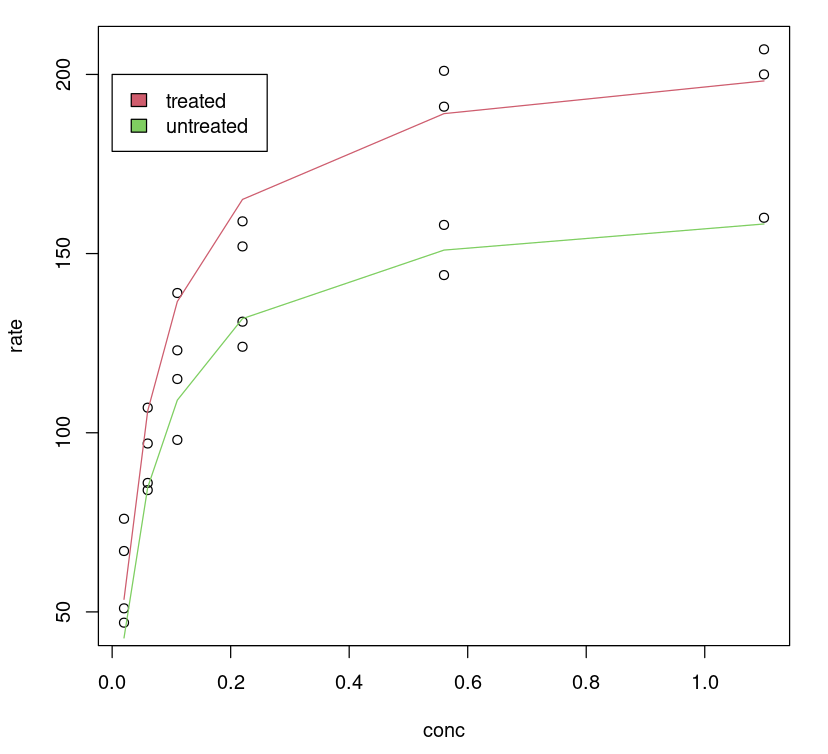
केवल p-values पर निर्भर नहीं होना चाहिए; 95% कॉन्फिडेंस इंटरवल प्रत्येक महत्वपूर्ण पैरामीटर के लिए 2.5% और 97.5% पर गुणांक मान देता है। इनमें से कोई भी 0 को शामिल नहीं करता।
confint(Purboth)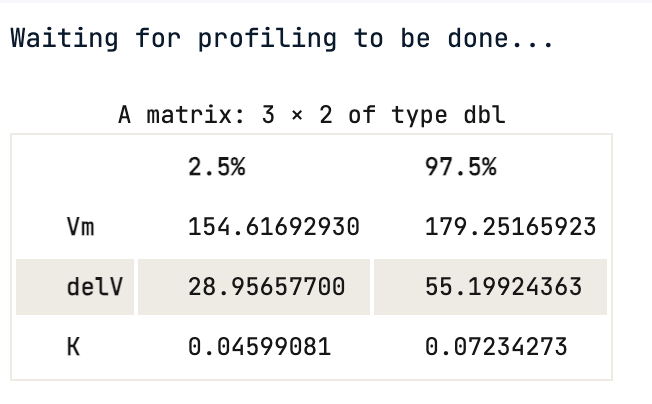
कॉन्फिडेंस इंटरवल के आधार पर सांख्यिकीय रूप से कहा जा सकता है कि 95% संभावना है कि, उदाहरण के लिए Vmax का वास्तविक मान ऊपर दी गई सीमा के भीतर आता है, जो Vmax के लिए (154.62, 179.25) है।
उद्देश्य फ़ंक्शन का प्रत्यक्ष परीक्षण करके पैरामीटर आकलन में अनिश्चितता समझने हेतु मॉडल की प्रोफाइलिंग और की जा सकती है। हमारे मॉडल में तीन पैरामीटर Vmax, delV, K हैं; हम इनकी प्रोफाइलिंग कर सकते हैं:
यह अलग-अलग मानों के लिए पैरामीटरों के कॉन्फिडेंस इंटरवल्स प्लॉट करता है (जो विभिन्न कॉन्फिडेंस इंटरवल—99%, 95%, 90%, 80% और 50%—से मेल खाते हैं)। यह confint(object, parm, level = 0.95, ...)function द्वारा दिए गए (95%) कॉन्फिडेंस इंटरवल के समान है।
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)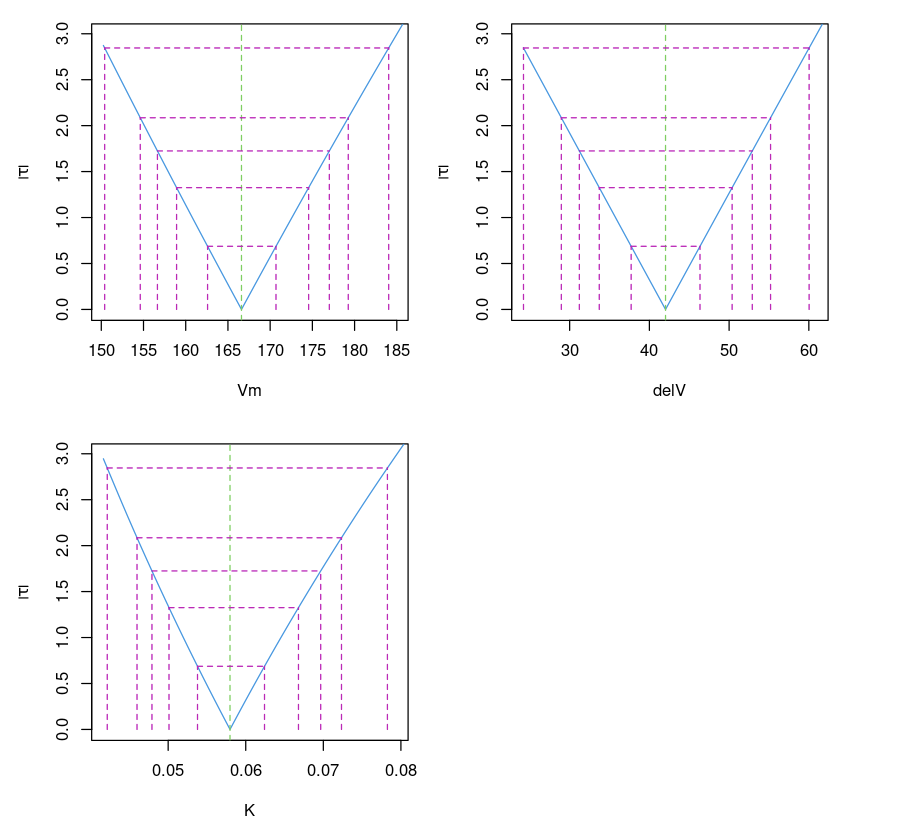
T के विरुद्ध तीन पैरामीटर Vmax, delV, K का प्लॉट हमें यह आभास देता है कि फिट लिनियर है या नॉन-लिनियर। देखा जा सकता है कि delV और Vm के लिए रेखा लिनियर सी दिखती है, जबकि K के लिए थोड़ी घुमावदार है। यह अपेक्षित है क्योंकि K पैरामीटर नॉन-लिनियर संबंध प्रदर्शित करता है।
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")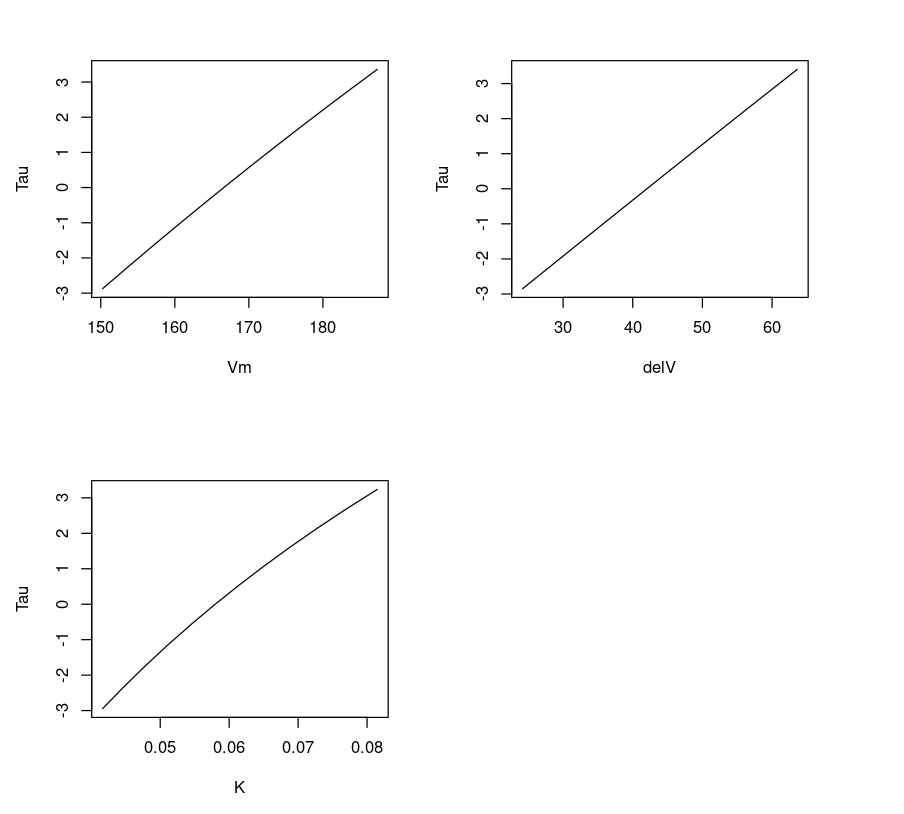
उसी R लाइब्रेरी फ़ंक्शन nls() का उपयोग नीचे दिखाए अनुसार लिनियर मॉडल फिट करने के लिए किया जा सकता है। मेरा मानना है कि व्याख्यात्मकता और तुलना हेतु हमेशा लिनियर मॉडल आज़माने की आदत अच्छी है।
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09यद्यपि पैरामीटर महत्वपूर्ण दिखते हैं, यह एक कमजोर फिट है। रेजिडुअल मानक त्रुटि अधिक है।
ऐसा प्रतीत होता है कि लिनियर मॉडल का प्रदर्शन कमजोर है; डेटा पर फिट की गई रेखा प्लॉट करके और उसके नॉन-लिनियर समकक्ष से तुलना करके इसे देखा जा सकता है।
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)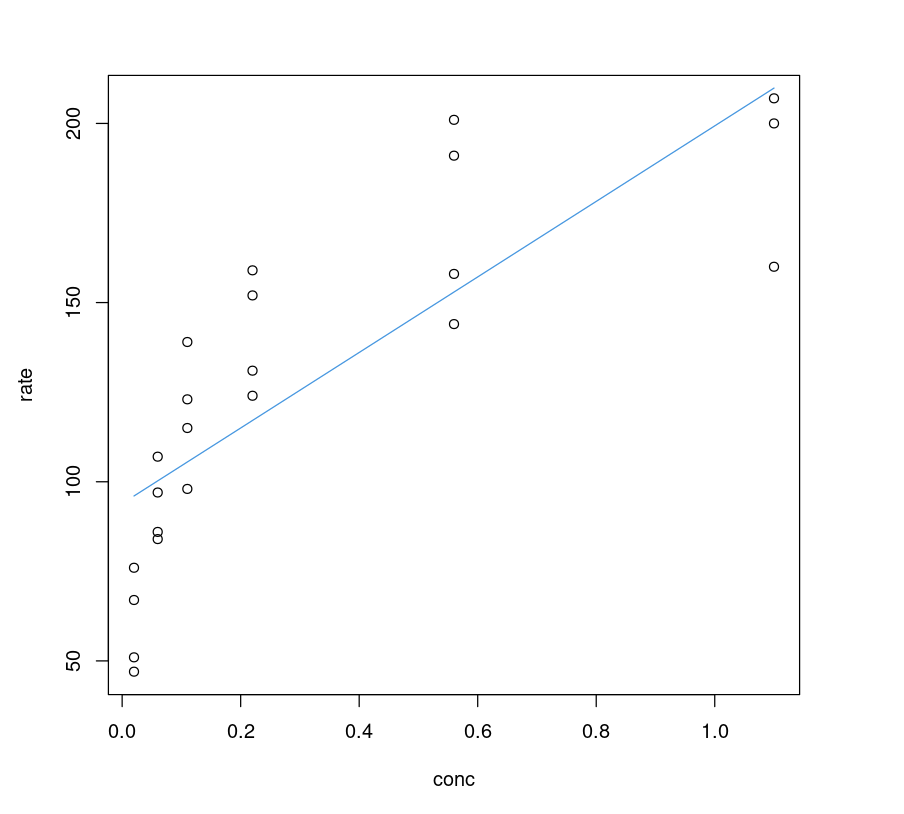
ऊपर के प्लॉट से हमें पता है कि लिनियर मॉडल का प्रदर्शन कमजोर है, पर इन मॉडलों की तुलना कैसे करें? यह सेब और संतरे की तुलना जैसा होगा। AIC परिणाम सीधे उपयोग नहीं किए जा सकते।
अच्छे फिट की परिभाषा—रिग्रेशन के लिए—यह है कि प्रेडिक्टेड और वास्तविक मान यथासंभव निकट हों। इसलिए यदि हम R के lm() फ़ंक्शन का उपयोग करके किसी मॉडल की भविष्यवाणियों की गुणवत्ता की जाँच करें तो उनकी तुलना की जा सकती है। जो मॉडल अधिक सटीक होगा उसके बिंदु आदर्श रेखा के पास गिरेंगे। आदर्श रेखा 100% सटीक मॉडल का निरूपण करती है—हर डेटा बिंदु के लिए प्रेडिक्टेड और वास्तविक मान समान होते हैं। अतः सभी बिंदु सीधी रेखा पर होंगे।
प्रत्येक इनपुट डेटा बिंदु के लिए, हम लक्ष्य मान की भविष्यवाणी करने हेतु मॉडल का उपयोग करते हैं और फिर निम्नानुसार lm() फ़ंक्शन लगाते हैं। वास्तविक रेट (x-अक्ष) और प्रेडिक्टेड रेट (y-अक्ष) के बीच स्कैटर प्लॉट बनाकर और आदर्श रेखा खींचकर देखा जा सकता है कि बिंदु रेखा के कितने पास हैं।
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104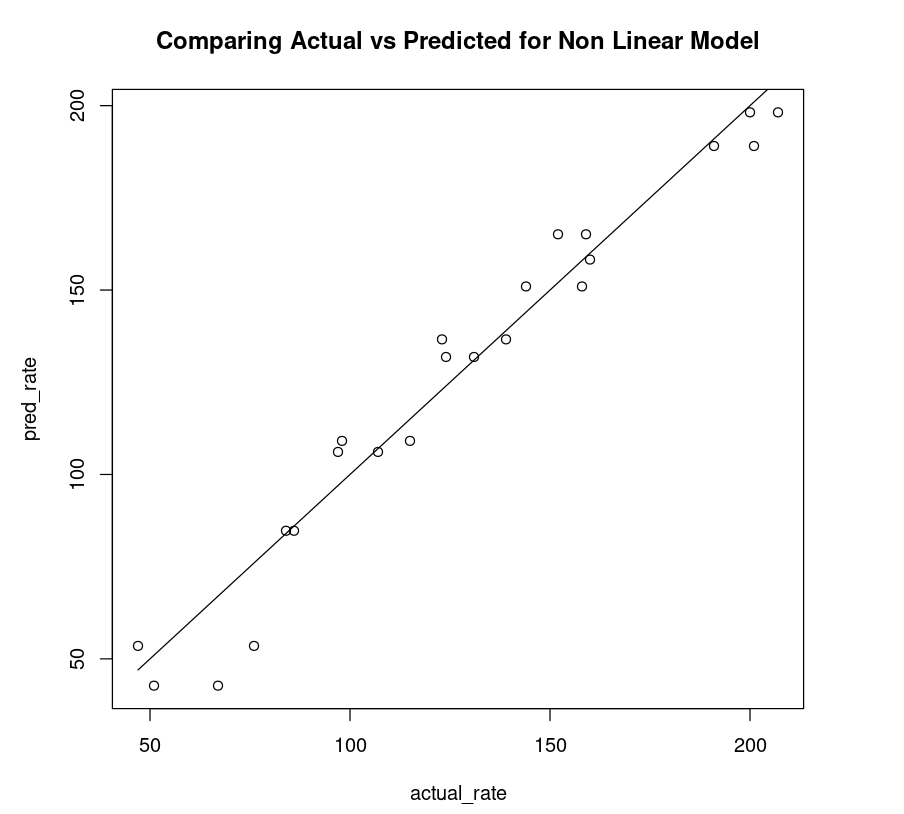
ऊपर का नॉन-लिनियर प्लॉट नीचे के लिनियर प्लॉट की तुलना में स्पष्ट रूप से बेहतर फिट है।
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551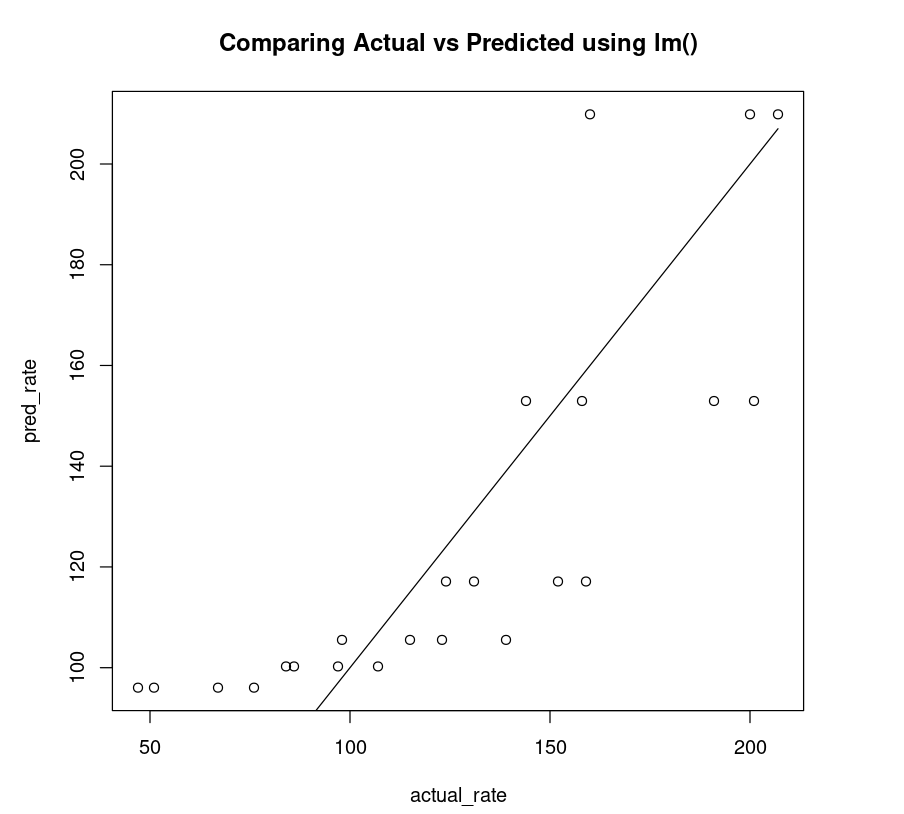
ऐसा लगता है कि हम लिनियर मॉडल के साथ न्याय नहीं कर रहे, क्योंकि स्पष्ट है कि डेटा सीधी रेखा का अनुसरण नहीं करता; अतः हम ट्रांसफॉर्म किए गए डेटा से मॉडल फिट करने का प्रयास कर सकते हैं। नीचे दिखाए अनुसार हम conc के लिए sqrt() ट्रांसफॉर्मेशन चुनते हैं और लिनियर मॉडल फिट करते हैं।
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09वास्तव में, रेजिडुअल मानक त्रुटि में कमी आती है, पर अपेक्षा के अनुरूप नहीं।
स्पष्ट है कि conc पर sqrt() लगाने से लिनियर मॉडल बेहतर होता है। हालाँकि, नॉन-लिनियर मॉडल Purboth की तुलना में यह बेहतर नहीं है। PurbothLinearSqrt मॉडल की रेजिडुअल मानक त्रुटि Purboth की लगभग दोगुनी है, इसलिए हम इस मॉडल का आगे विश्लेषण नहीं करेंगे। कोई चाहे तो उच्च-क्रम के बहुपद पदों (पॉलीनॉमियल रिग्रेशन) के साथ फिट करने का प्रयास कर सकता है, पर ऐसे मॉडल को फाइन-ट्यून करने का प्रयास कहीं अधिक होता है, जबकि नॉन-लिनियर मॉडल से बेहतर परिणाम सहज रूप से मिल सकते हैं।
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)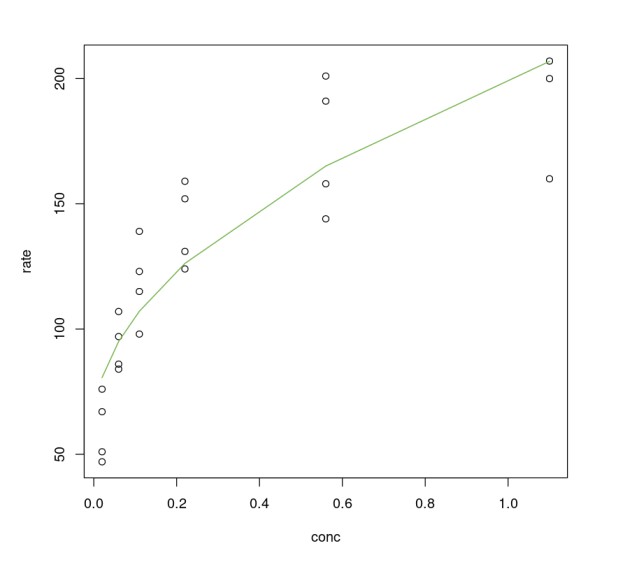
नॉन-लिनियर फ़ंक्शन को अनवाइंड कर लिनियर मॉडल फिट करने की एक तरकीब अपनाई जा सकती है। यह तकनीक उस समय उपयोग की जाती थी जब गणनाएँ हाथ से होती थीं, कंप्यूटर से नहीं। हालाँकि, ऐसे मॉडल प्रायः बेहतर काम नहीं करते।
उदाहरण के लिए, Michaelis-Menten समीकरण का व्युत्क्रम लेकर, जैसा नीचे दिखाया है, उसके संशोधित रूप से लिनियर मॉडल लगाया जा सकता है।
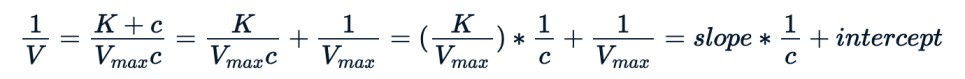
हम उसी nls() का उपयोग नई समीकरण फिट करने के लिए कर सकते हैं।
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09रेजिडुअल मानक त्रुटि कम है, पर प्रयुक्त डेटा अलग होने से इसकी तुलना नॉन-लिनियर मॉडलों से नहीं की जा सकती। सबसे अच्छा तरीका यही है कि दोनों मॉडलों का प्रदर्शन मूल डेटासेट पर विज़ुअलाइज़ किया जाए।
हम Purboth_1 मॉडल, जो दो पैरामीटर Vmax, K उपयोग करता है, की तुलना PurbothPseudoLinear से करते हैं। प्लॉट स्पष्ट करता है कि नॉन-लिनियर मॉडल बेहतर काम करता है।
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))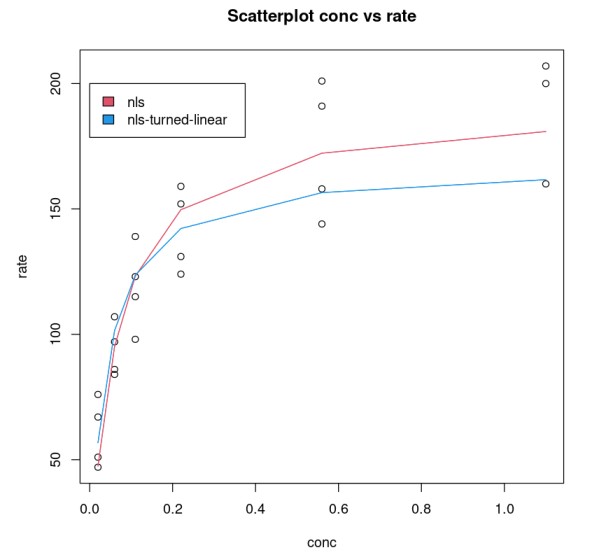
मॉडल की गुडनेस-ऑफ-फिट की तुलना की जा सकती है।
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925यह दर्शाता है कि नॉन-लिनियर फ़ंक्शन उपयोग करने वाला मॉडल कहीं बेहतर प्रदर्शन करता है।
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)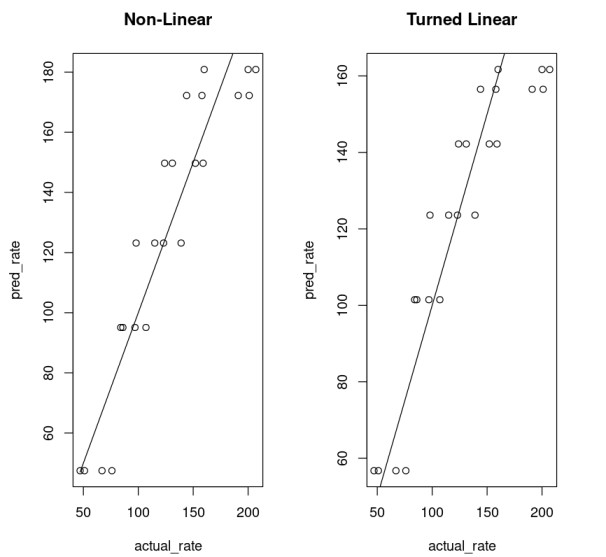
नॉन-लिनियर मॉडल अपने लिनियर समकक्ष से बेहतर प्रदर्शन करता है, विशेषकर तब जब हमारे पास मेकेनिस्टिक डेटा हो। हालाँकि, नॉन-लिनियर मॉडल अनुमान समस्या का संख्यात्मक समाधान सुनिश्चित नहीं करता। कोई प्लॉट करके ऐसा गणितीय फ़ंक्शन चुन सकता है जो डेटा के बीच संबंध को सबसे अच्छे रूप में समझा सके। ऐसे मामलों में नॉन-लिनियर मॉडल अपने लिनियर समकक्ष से बेहतर सिद्ध हो सकता है।
यदि आपको यह लेख ज्ञानवर्धक लगा और आप रिग्रेशन मॉडलों की दुनिया में और गहराई तक जाना चाहते हैं, तो DataCamp का Intermediate Regression in R कोर्स देखें।