Este tutorial es una valiosa aportación de nuestra comunidad y DataCamp lo ha editado para mejorar su claridad y precisión.
¿Te gustaría compartir tu experiencia? ¡Nos encantará leerte! Envía tus artículos o ideas a través de nuestro formulario de contribuciones de la comunidad.
Los modelos no lineales ya no son tan populares como antes. Hoy en día, muchos libros los omiten o los tratan de forma muy limitada. Y hay varios motivos. Primero, puedes ajustar una curva no lineal con regresión lineal añadiendo términos polinómicos de orden superior o aplicando funciones base (por ejemplo, transformar las variables explicativas con log o raíz cuadrada). Segundo, a menudo se prioriza la sencillez: los modelos lineales son más fáciles de interpretar y explicar.
Además, para aplicar un modelo no lineal es clave visualizar los datos y hacerse una idea de su trayectoria, algo que no siempre es posible en entornos multivariantes. Por último, los modelos no lineales encajan mejor en casos mecanicistas donde los fenómenos son puramente físicos o deterministas, algo menos frecuente en big data, donde la actividad de usuario queda registrada por máquinas.
Aun así, pese a todos estos motivos razonables, el modelado no lineal es una disciplina fascinante que merece explorarse y compararse con su contraparte lineal.
Modelo de regresión no lineal
Las técnicas de estimación para un modelo no lineal son explícitamente iterativas. Además, hay una diferencia fundamental en cómo se aplica una fórmula no lineal frente a una lineal. Las tres ecuaciones siguientes se consideran lineales porque la relación entre la variable y y B0, B1 y B2 es una línea recta.
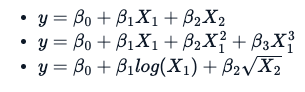
Una fórmula es no lineal cuando tiene una forma como esta:
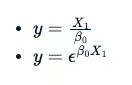
El uso de B0 o B1 es arbitrario. Sin embargo, en las dos últimas ecuaciones no hay una relación lineal entre y y B0.
Esto complica los cálculos y no garantiza encontrar una solución numérica satisfactoria al problema de estimación. Por tanto, los modelos no lineales vienen con una advertencia: obtener resultados puede no ser intuitivo ni preciso.
Modelo especializado
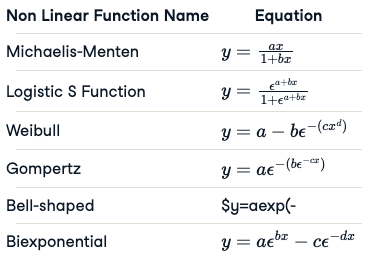
Normalmente, cuando se aplica un modelo no lineal se recurre a tipos especializados. Esto facilita el ajuste o lo hace numéricamente más estable, pero debe contar con el visto bueno de un experto en la materia y estar alineado con los datos. Por tipos especializados nos referimos a usar ecuaciones matemáticas predefinidas. Aquí tienes una lista de las más habituales (algunas se omiten por brevedad).
Estrategia para un modelo de regresión no lineal
- Visualiza los datos para ver si una función matemática especializada los explica mejor.
- Elige los valores iniciales de los parámetros a ojo a partir del gráfico o usando una función self-starter (explicada abajo).
- Ajusta el modelo y examínalo.
- Realiza un análisis estadístico del modelo ajustado para conocer los intervalos de confianza de los parámetros, el error residual y la variación explicada.
- Prueba a añadir más parámetros si ayuda a reducir el error residual.
- Ajusta siempre un modelo lineal y compara sus resultados con los del modelo no lineal.
Explicación del modelo no lineal con un ejemplo
Vamos a ajustar un modelo no lineal especializado sobre un conjunto de datos conocido, Puromycin, que recoge la velocidad de reacción y la concentración en una reacción enzimática con células expuestas al fármaco Puromycin. Hay dos clases de células: tratadas con Puromycin y no tratadas.
names(Puromycin)Puromycin'conc''rate''state'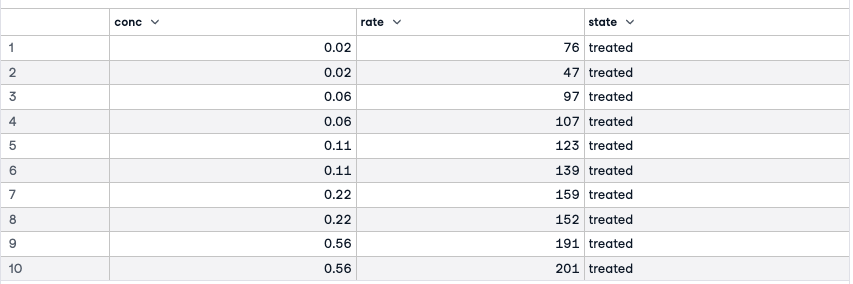
Las tres variables de este dataframe son la concentración del sustrato, la velocidad inicial de la reacción y un indicador de tratamiento.
Al representar la velocidad frente a la concentración y etiquetar los dos niveles de tratamiento, se aprecia un patrón general. Las curvas son asintóticas y claramente distintas para las cohortes de células tratadas y no tratadas.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "T", "U"))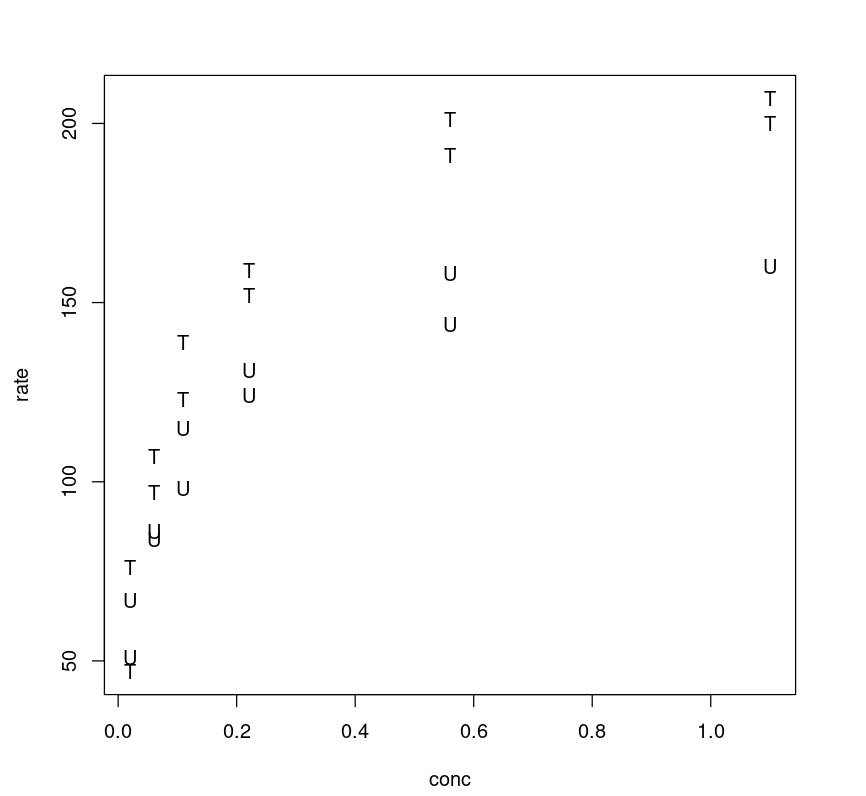
Como estos datos muestran una relación de Michaelis-Menten marcada entre velocidad de reacción y concentración, cabe esperar que el experimento se ajuste a la siguiente ecuación.
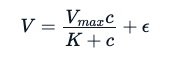
Aquí, E es el error experimental. Igual que en el modelo lineal, con un modelo no lineal especializado buscamos estimar los parámetros Vmax y K que minimicen la suma de cuadrados de los residuales (aunque hay otros métodos de estimación posibles):
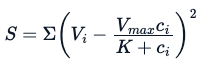
Ajuste de un modelo no lineal
Aunque conocemos la relación, ajustar un modelo no lineal no es tan directo porque el modelo requiere conjeturas iniciales para Vmax y K. Si no eliges bien esos valores iniciales, el ajuste puede ser deficiente. Tienes dos opciones:
- Estimar los valores iniciales a ojo a partir del gráfico.
- Usar una función self-starter (abajo).
Función self-starter | Modelo |
SSasymp | modelo de regresión asintótico |
SSasympOff | modelo asintótico con desplazamiento |
SSasympOrig | modelo asintótico pasando por el origen |
SSbiexp | modelo biexponencial |
SSfol | modelo de compartimento de primer orden |
SSfpl | modelo logístico de cuatro parámetros |
SSgompertz | modelo de crecimiento de Gompertz |
SSlogis | modelo logístico |
SSmicmen | modelo de Michaelis–Menten |
SSweibull | modelo de curva de crecimiento de Weibull |
Para cada tipo de modelo, existe una función self-starter correspondiente que puede ayudar a fijar los valores iniciales.
Ajuste del modelo con una conjetura inicial
Usando los valores iniciales Vmax = 160, K = 0.05 estimados a partir del gráfico, podemos emplear la función de R nls() para ajustar los datos. En regresión lineal no solemos especificar parámetros como Vm o K, pero en no lineal es distinto: todo algoritmo iterativo necesita un buen punto de partida o puede no converger. Así es como ajustamos un modelo no lineal en Puromycin con valores iniciales.
Purboth_1 <- nls(rate ~ (Vm)*conc/(K+conc), Puromycin, list(Vm=160, K=0.05))summary(Purboth_1)Formula: rate ~ (Vm) * conc/(K + conc)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80624 8.76459 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 5Achieved convergence tolerance: 5.121e-06Calcular el error residual
Calculamos el error residual así:
sse <- Purboth_1$m$deviance()sse7276.54697931423Calcular la varianza explicada
Para hallar la varianza explicada por este modelo (el equivalente al R-cuadrado en terminología lineal), necesitamos la varianza total de rate ajustando un modelo nulo, estimando la media global y extrayendo la suma total de cuadrados, sst, del resumen del modelo nulo, para luego calcular el porcentaje de variación explicada.
sse <- Purboth_1$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.3488323994681Este modelo explica el 85,34% de la variación en los datos.
Ajuste del modelo con una función self-starter
Como estamos usando el modelo de Michaelis-Menten, podemos utilizar la función self-starter SSmicmen(). Ofrece los mismos resultados.
Purboth_self <- nls(rate~SSmicmen(conc,Vm,K), Puromycin)summary(Purboth_self)Formula: rate ~ SSmicmen(conc, Vm, K)Parameters:Estimate Std. Error t value Pr(>|t|)Vm 190.80667 8.76462 21.770 6.84e-16 ***K 0.06039 0.01077 5.608 1.45e-05 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 18.61 on 21 degrees of freedomNumber of iterations to convergence: 4Achieved convergence tolerance: 6.745e-06Calcular el error residual
sse <- Purboth_self$m$deviance()sse7276.54697947673Calcular la varianza explicada
Podemos comprobar la varianza explicada por el modelo.
sse <- Purboth_self$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained85.348832399141En general, la ecuación ajustada, es decir, la relación entre velocidad y concentración, queda así:
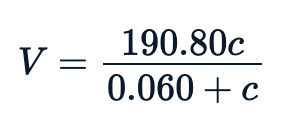
Visualizar el ajuste
Podemos ver el comportamiento del modelo al trazar la línea ajustada sobre los datos, con forma claramente no lineal.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)
Selección de un modelo mejor
Podemos afinar más el modelo añadiendo parámetros. Si observas el gráfico de velocidad frente a concentración, verás que las clases (tratadas vs no tratadas) siguen trayectorias distintas, y la diferencia de velocidad (eje y) entre ambas se aproxima a 40.
plot(Puromycin$conc, Puromycin$rate, type="n", xlab = "conc", ylab = "rate")text(Puromycin$conc, Puromycin$rate, ifelse(Puromycin$state == "treated", "+", "*"))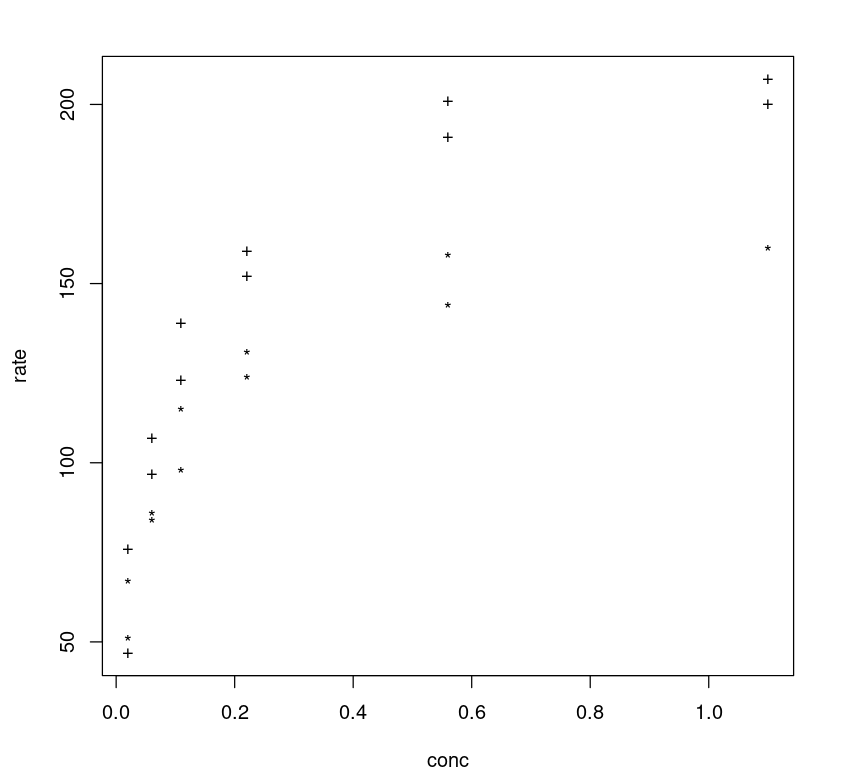
En esencia, intentamos ajustar un modelo condicionado por la variable state, lo que nos lleva a la siguiente ecuación no lineal.
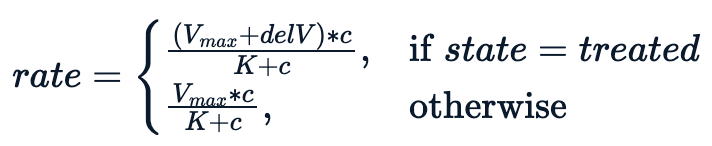
El modelo mejora al incluir el parámetro adicional delV. Le asignamos un valor inicial de 40 y ajustamos el modelo con nls usando tres parámetros.
Purboth <- nls(rate ~ (Vm + delV*(state=="treated"))*conc/(K+conc), Puromycin, list(Vm=160, delV=40, K=0.05))summary(Purboth)Formula: rate ~ (Vm + delV * (state == "treated")) * conc/(K + conc)Parameters: Estimate Std. Error t value Pr(>|t|) Vm 166.60397 5.80742 28.688 < 2e-16 ***delV 42.02591 6.27214 6.700 1.61e-06 ***K 0.05797 0.00591 9.809 4.37e-09 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 10.59 on 20 degrees of freedomNumber of iterations to convergence: 5 Achieved convergence tolerance: 8.93e-06El resumen muestra que los tres parámetros son estadísticamente significativos.
Calcular el error residual
En este modelo el error residual se reduce de forma notable:
sse <- Purboth$m$deviance()sse2240.89143883885Calcular la varianza explicada
Este modelo explica más varianza.
sse <- Purboth$m$deviance()null <- lm(rate~1, Puromycin)sst <- data.frame(summary.aov(null)[[1]])$Sum.Sqpercent_variation_explained = 100*(sst-sse)/sstpercent_variation_explained95.4880142822744Comprobación con AIC
También podemos comparar el AIC de ambos modelos. Aunque hoy lo más habitual es usar validación cruzada, eso requiere más datos; en general, cuanto menor es el AIC, mejor es el modelo.
AIC(Purboth)AIC(Purboth_1)178.591273238391203.680274951742Visualizar el ajuste
Podemos ver cómo rinde el modelo ajustado trazando la línea sobre los datos. Como era de esperar, ofrece un mejor ajuste para las distintas clases.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth, Puromycin[Puromycin$state != "treated",]), col=3)legend(0, 200, legend = c("treated", "untreated"), fill = c(2,3))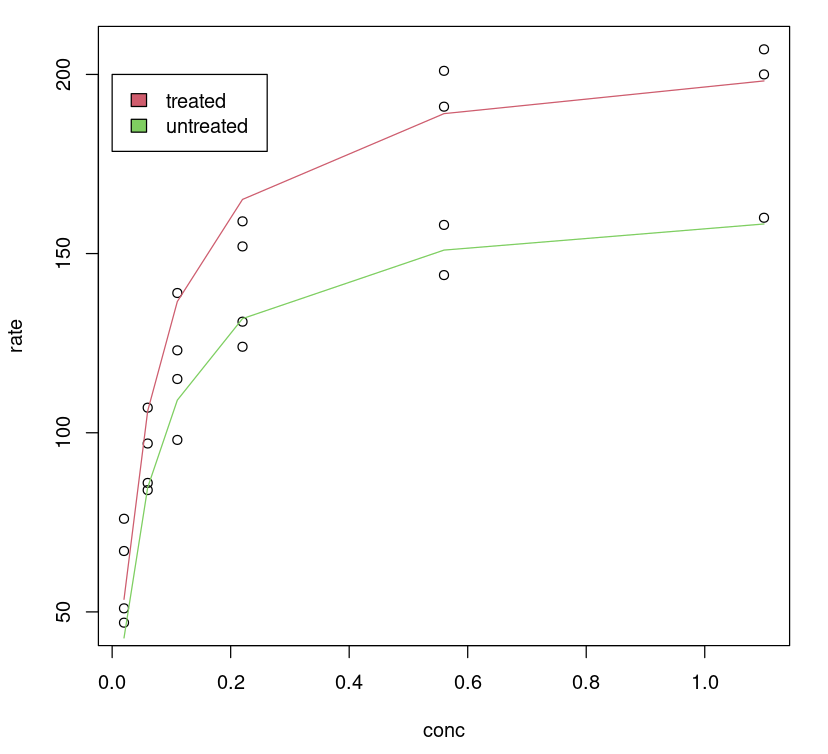
Intervalo de confianza de los parámetros
No conviene basarse solo en los p-valores: el intervalo de confianza del 95% ofrece los valores de los coeficientes para cada parámetro significativo en los percentiles 2,5% y 97,5%. Ninguno incluye 0.
confint(Purboth)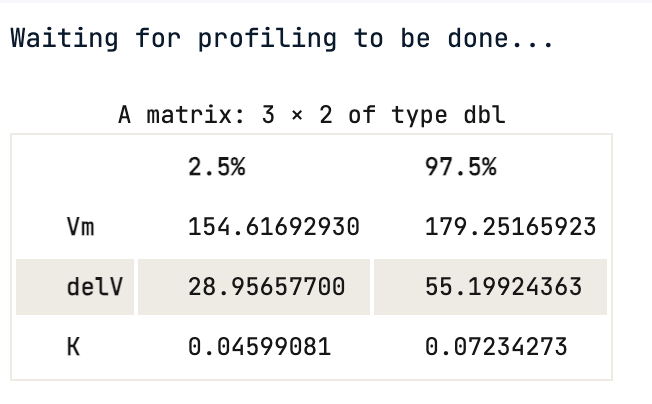
Con estos intervalos, podemos afirmar que hay un 95% de probabilidad de que el valor verdadero del parámetro (por ejemplo, Vmax) se encuentre dentro del rango indicado arriba, que para Vmax es (154.62, 179.25).
Perfilado
También podemos perfilar el modelo para entender la incertidumbre en la estimación de parámetros examinando directamente la función objetivo. En nuestro modelo hay tres parámetros, Vmax, delV, K, que podemos perfilar:
- Para obtener los intervalos de confianza.
- Y usar la función de perfil t, similar a las t de los modelos lineales. Las gráficas del perfil t proporcionan intervalos de verosimilitud para cada parámetro y muestran cuán no lineal es la estimación.
Representar el intervalo de confianza
Esto representa los intervalos de confianza de los parámetros para distintos valores de (lo que corresponde a intervalos del 99%, 95%, 90%, 80% y 50%). Es similar al intervalo de confianza (95%) que devuelve confint(object, parm, level = 0.95, ...).
Purbothpf = profile(Purboth)par( mfrow= c(2,2) )plot(Purbothpf)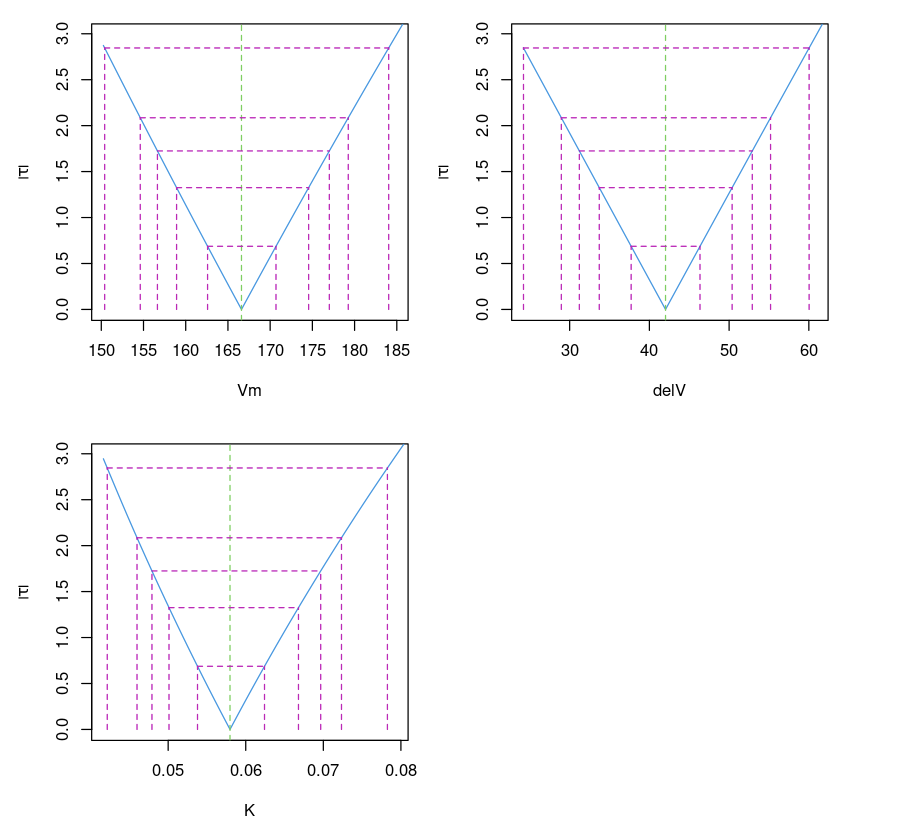
Representar T frente a parámetros
Al representar los tres parámetros Vmax, delV, K frente a T podemos intuir si el ajuste es lineal o no lineal. Se observa que la línea parece lineal para delV y Vm, y ligeramente curvada para K, como era de esperar porque K mantiene una relación no lineal.
dataVm = data.frame(Purbothpf$Vm$par.vals)datadelV = data.frame(Purbothpf$delV$par.vals)dataK = data.frame(Purbothpf$K$par.vals)par( mfrow= c(2,2) )plot(dataVm$Vm,Purbothpf$Vm$tau, type="l", xlab = "Vm", ylab = "Tau")plot(datadelV$delV,Purbothpf$delV$tau, type="l", xlab = "delV", ylab = "Tau")plot(dataK$K,Purbothpf$K$tau, type="l", xlab = "K", ylab = "Tau")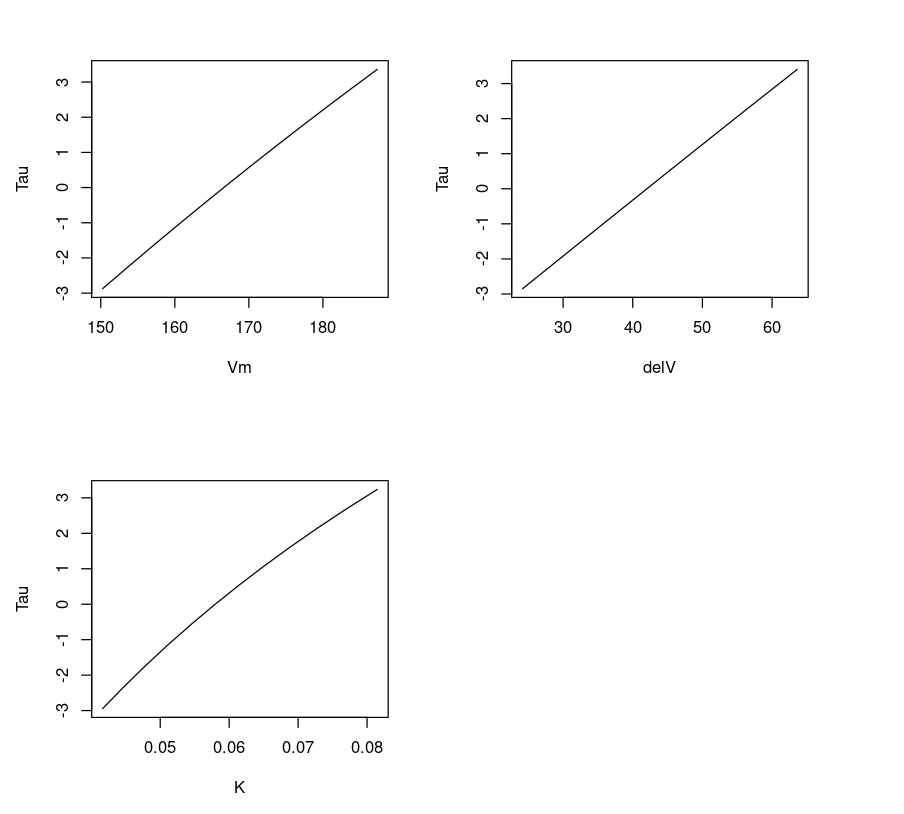
Ajuste de un modelo lineal
Podemos usar la misma función de R nls() para ajustar un modelo lineal como se muestra a continuación. Es buena práctica probar siempre un modelo lineal por su interpretabilidad y para comparar.
PurbothRealLinear <- nls(rate ~ i + m*conc, Puromycin, list(i=160, m=0.05) )summary(PurbothRealLinear)Formula: rate ~ i + m * concParameters: Estimate Std. Error t value Pr(>|t|) i 93.92 8.00 11.74 1.09e-10 ***m 105.40 16.92 6.23 3.53e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 28.82 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 2.571e-09Aunque los parámetros parecen significativos, el ajuste es pobre. El error estándar residual es alto.
Visualizar el ajuste
El modelo lineal rinde mal; se aprecia al dibujar su línea ajustada sobre los datos y compararla con la del modelo no lineal.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin$conc, predict(PurbothRealLinear), col=4)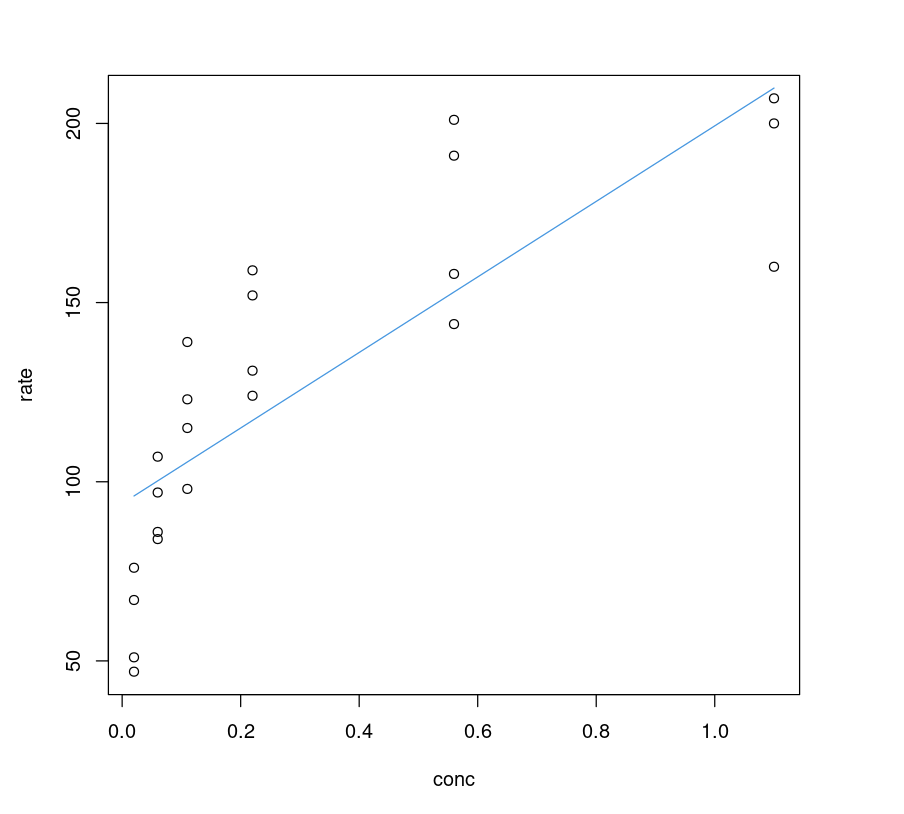
Comparar modelo no lineal vs lineal de forma analítica
Por el gráfico anterior sabemos que el modelo lineal funciona mal, pero ¿cómo comparamos ambos? Sería como comparar manzanas con naranjas. Los resultados de AIC no se pueden usar directamente.
Bondad de ajuste
En regresión, un buen ajuste implica que el valor predicho y el real estén lo más cerca posible. Si inspeccionamos la calidad de las predicciones con una función lm() de R, podemos compararlos. El modelo más preciso tendrá puntos más cercanos a la línea ideal, aquella en la que el modelo es 100% exacto: el valor predicho coincide con el real para cada observación, por lo que todos los puntos se alinean.
Ajuste no lineal
Para cada observación usamos el modelo para predecir el objetivo y luego aplicamos lm() como se muestra. Al representar en un diagrama de dispersión la velocidad real (eje x) frente a la predicha (eje y) y dibujar la línea ideal, podemos ver cuán próximos están los puntos a dicha línea.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Comparing Actual vs Predicted for Non Linear Model")lines(Puromycin$rate, Puromycin$rate)174.711198508104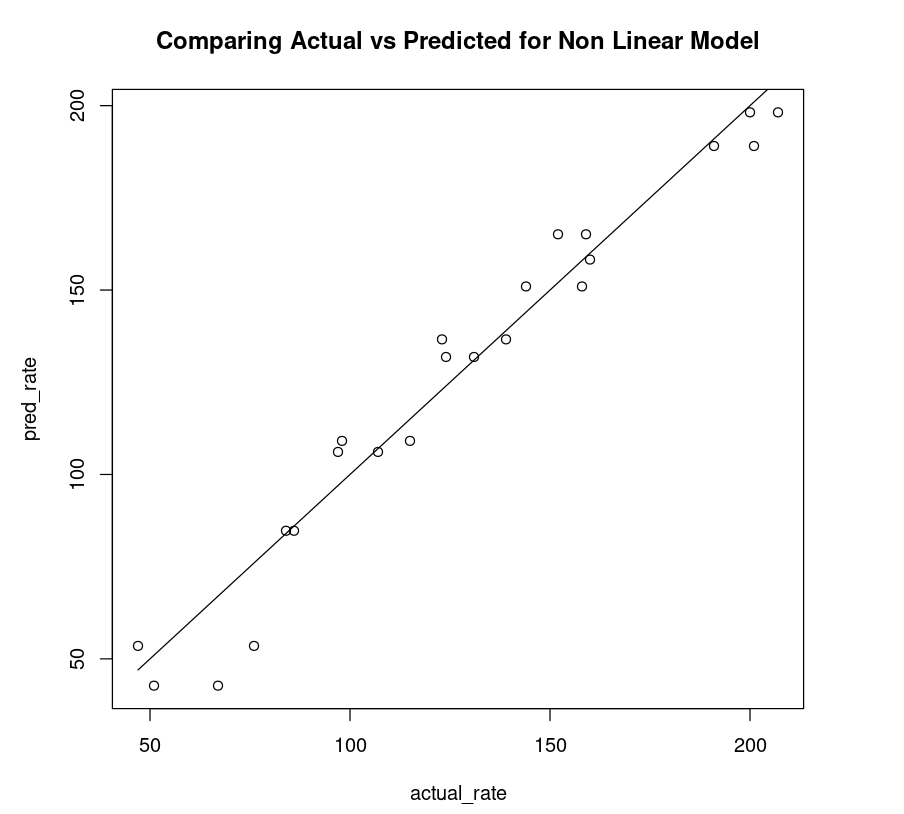
Ajuste lineal
El gráfico no lineal anterior encaja claramente mejor que el lineal (abajo).
linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(PurbothRealLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main= "Comparing Actual vs Predicted using lm()")lines(Puromycin$rate, Puromycin$rate)223.783416979551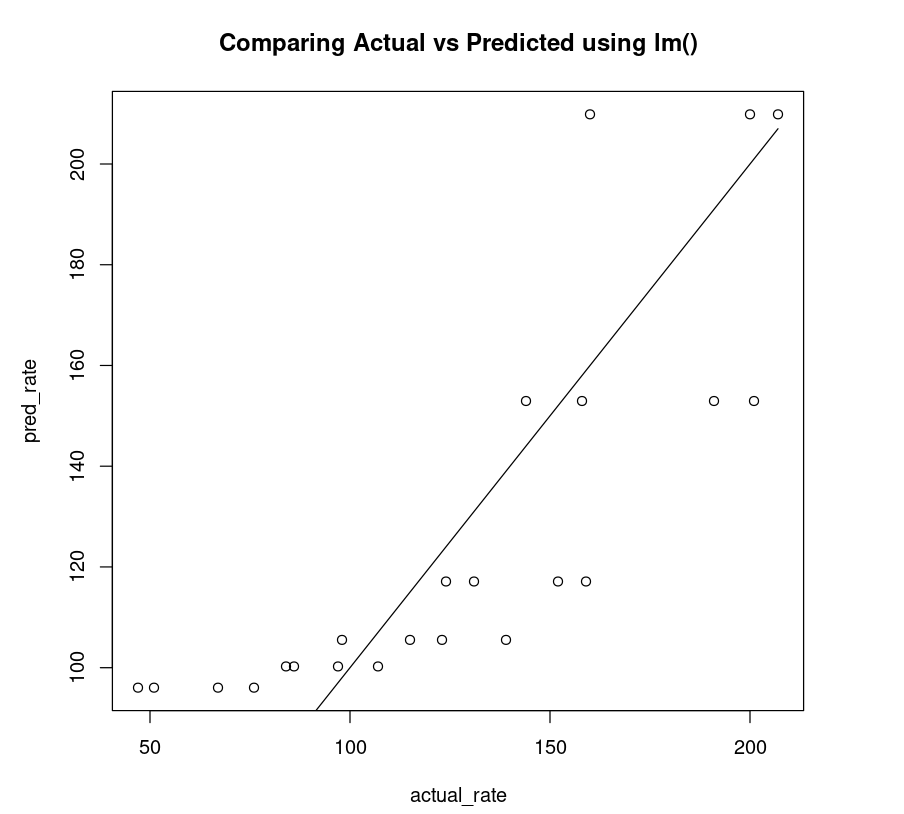
Mejorar el modelo lineal
Estamos siendo duros con el modelo lineal porque los datos no siguen una recta; probemos a ajustar con una transformación. Elegimos sqrt() para transformar conc y ajustamos un modelo lineal como sigue.
PurbothLinearSqrt = nls(rate ~ i + m*sqrt(conc), Puromycin, list(i=160, m=0.05) )summary(PurbothLinearSqrt)Formula: rate ~ i + m * sqrt(conc)Parameters: Estimate Std. Error t value Pr(>|t|) i 60.961 8.758 6.961 7.11e-07 ***m 139.134 15.675 8.876 1.50e-08 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 22.31 on 21 degrees of freedomNumber of iterations to convergence: 2 Achieved convergence tolerance: 1.838e-09Ciertamente baja el error estándar residual, pero menos de lo esperado.
Representar el ajuste
Se aprecia que aplicar sqrt() a conc mejora el modelo lineal. Sin embargo, comparado con el modelo no lineal Purboth no resulta mejor. El error estándar residual de PurbothLinearSqrt casi duplica al de Purboth, así que no lo analizaremos más. Podrías probar con términos polinómicos de mayor orden, pero el esfuerzo de ajuste fino es mucho mayor cuando con un no lineal se logran mejores resultados.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate")lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(PurbothLinearSqrt, Puromycin[Puromycin$state != "treated",]), col=3)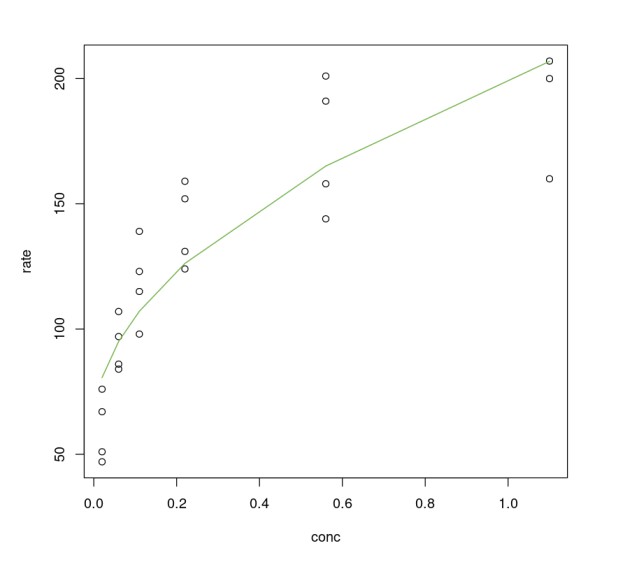
Desenrollar la no linealidad de la ecuación
Existe un truco para transformar una función no lineal y ajustar un modelo lineal. Era común cuando los cálculos se hacían a mano, no con ordenadores. Sin embargo, estos modelos rara vez superan a los no lineales.
Convertir la forma no lineal en lineal
Como ejemplo, podemos invertir la ecuación de Michaelis-Menten, como se muestra, y usar esa forma modificada para aplicar un modelo lineal.
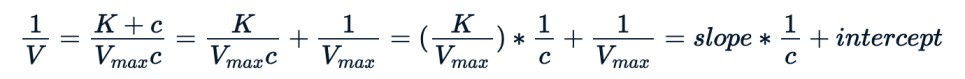
Podemos usar la misma nls() para ajustar la nueva ecuación.
PurbothPseudoLinear <- nls((1/rate) ~ K /(Vm*conc) + 1/Vm , Puromycin, list(Vm=160, K=0.05))summary(PurbothPseudoLinear)Formula: (1/rate) ~ K/(Vm * conc) + 1/VmParameters: Estimate Std. Error t value Pr(>|t|) Vm 1.674e+02 1.362e+01 12.287 4.70e-11 ***K 3.900e-02 6.172e-03 6.318 2.89e-06 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 0.001786 on 21 degrees of freedomNumber of iterations to convergence: 3 Achieved convergence tolerance: 2.997e-09El error estándar residual es bajo, pero como los datos transformados no son comparables, no podemos usarlo para comparar con los modelos no lineales. Lo mejor es visualizar cómo se comportan ambos sobre el conjunto original.
Representar el ajuste
Comparamos el modelo Purboth_1, con dos parámetros Vmax y K, frente a PurbothPseudoLinear. El gráfico muestra claramente que el modelo no lineal hace un mejor trabajo.
plot(Puromycin$conc, Puromycin$rate, xlab="conc", ylab = "rate", main = "Scatterplot conc vs rate")lines(Puromycin[Puromycin$state == "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state == "treated",]), col=2)lines(Puromycin[Puromycin$state != "treated",]$conc, predict(Purboth_1, Puromycin[Puromycin$state != "treated",]), col=2)lines(Puromycin[Puromycin$state == "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state == "treated",]) , col=4)lines(Puromycin[Puromycin$state != "treated",]$conc, 1/predict(PurbothPseudoLinear, Puromycin[Puromycin$state != "treated",]) , col=4)legend(0, 200, legend = c("nls", "nls-turned-linear"), fill = c(2,4))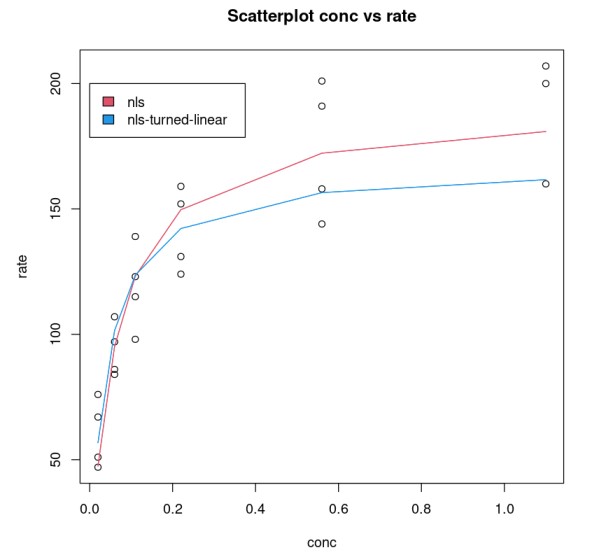
Bondad de ajuste
También podemos comparar la bondad de ajuste.
nonLinear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= predict(Purboth_1))fit_nonLinear = lm(nonLinear_df$rate ~ nonLinear_df$pred_rate)AIC(fit_nonLinear)203.017860461858linear_df = data.frame("rate"=Puromycin$rate, "pred_rate"= 1/predict(PurbothPseudoLinear))fit_linear = lm(linear_df$rate~linear_df$pred_rate)AIC(fit_linear)206.999538212925Esto confirma que un modelo con función no lineal rinde mucho mejor.
par( mfrow= c(1,2) )plot(nonLinear_df$rate, nonLinear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Non-Linear")lines(Puromycin$rate, Puromycin$rate)plot(linear_df$rate, linear_df$pred_rate, xlab="actual_rate", ylab = "pred_rate", main = "Turned Linear")lines(Puromycin$rate, Puromycin$rate)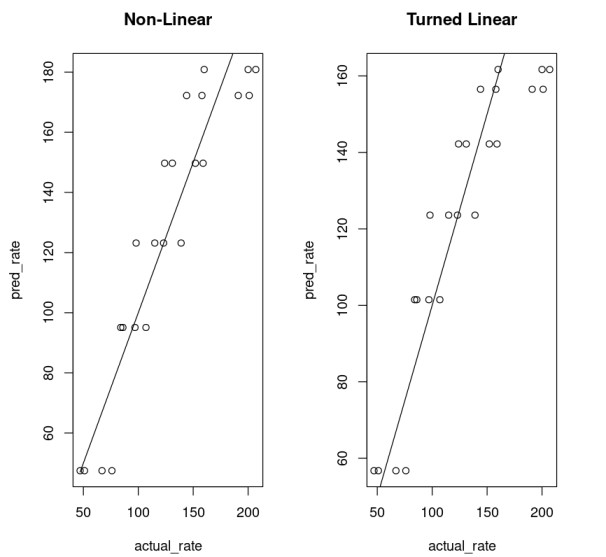
Conclusión
El modelo no lineal supera al lineal, especialmente cuando trabajamos con datos mecanicistas. Ahora bien, un modelo no lineal no garantiza una solución numérica al problema de estimación. Conviene visualizar y seleccionar una función matemática que explique bien la relación entre variables. En esos casos, el modelo no lineal puede imponerse a su equivalente lineal.
Si este artículo te ha resultado útil y quieres profundizar en el mundo de los modelos de regresión, echa un vistazo al curso de DataCamp Intermediate Regression in R.



