Last chance! 50% off DataCamp Premium
Sale ends in
Dalam tutorial ini, kami akan membahas modul Java kecil yang mengekspos alat kustom, menyimpan catatan sebagai JSON di Oracle AI Database, dan mengambilnya kembali dengan pencarian teks penuh.
Jika Anda membangun agen AI, riwayat chat jangka pendek biasanya tidak cukup. Asisten nyata sering membutuhkan sejumlah kecil memori yang tahan lama agar dapat menyimpan fakta penting dan mengambilnya kembali nanti.
Tutorial ini menunjukkan cara membangun pola tersebut dengan modul Java minimal. Anda akan menggunakan alat LangChain4j, antarmuka agen sederhana, dan Oracle AI Database sebagai penyimpanan backend. Alih-alih menambahkan embedding atau pipeline pengambilan lengkap, contoh ini sengaja mempertahankan desain yang kecil: catatan disimpan sebagai dokumen JSON dan dicari dengan Oracle Text.
Pada akhirnya, Anda akan memahami bagaimana modul ini merangkai:
LangChain4j @ToolJDBC untuk penyimpanan catatan yang tahan lamaLangChain4j memungkinkan Anda mengekspos metode Java biasa sebagai alat yang dapat dipanggil model saat membutuhkan kapabilitas eksternal. Dalam modul ini, kapabilitas tersebut berorientasi pada memori:
searchMemories(String question) menemukan catatan tersimpan yang relevanstoreMemory(String note) menulis catatan baru yang tahan lamaItu berbeda dengan riwayat chat standar yang menyimpan pesan chat dalam jendela konteks in-memory.
Memori persisten berbasis alat memutuskan kapan perlu mencari atau menyimpan catatan, dan data dasarnya hidup di database.
Pola ini berguna ketika Anda ingin agen mengingat fakta seperti catatan insiden, pengingat runbook, atau tindakan lanjutan tanpa membangun sistem pengambilan yang lebih besar terlalu dini.
Memori yang persisten dan didukung database juga dapat diakses secara bersamaan oleh satu atau lebih agen tanpa konflik data.
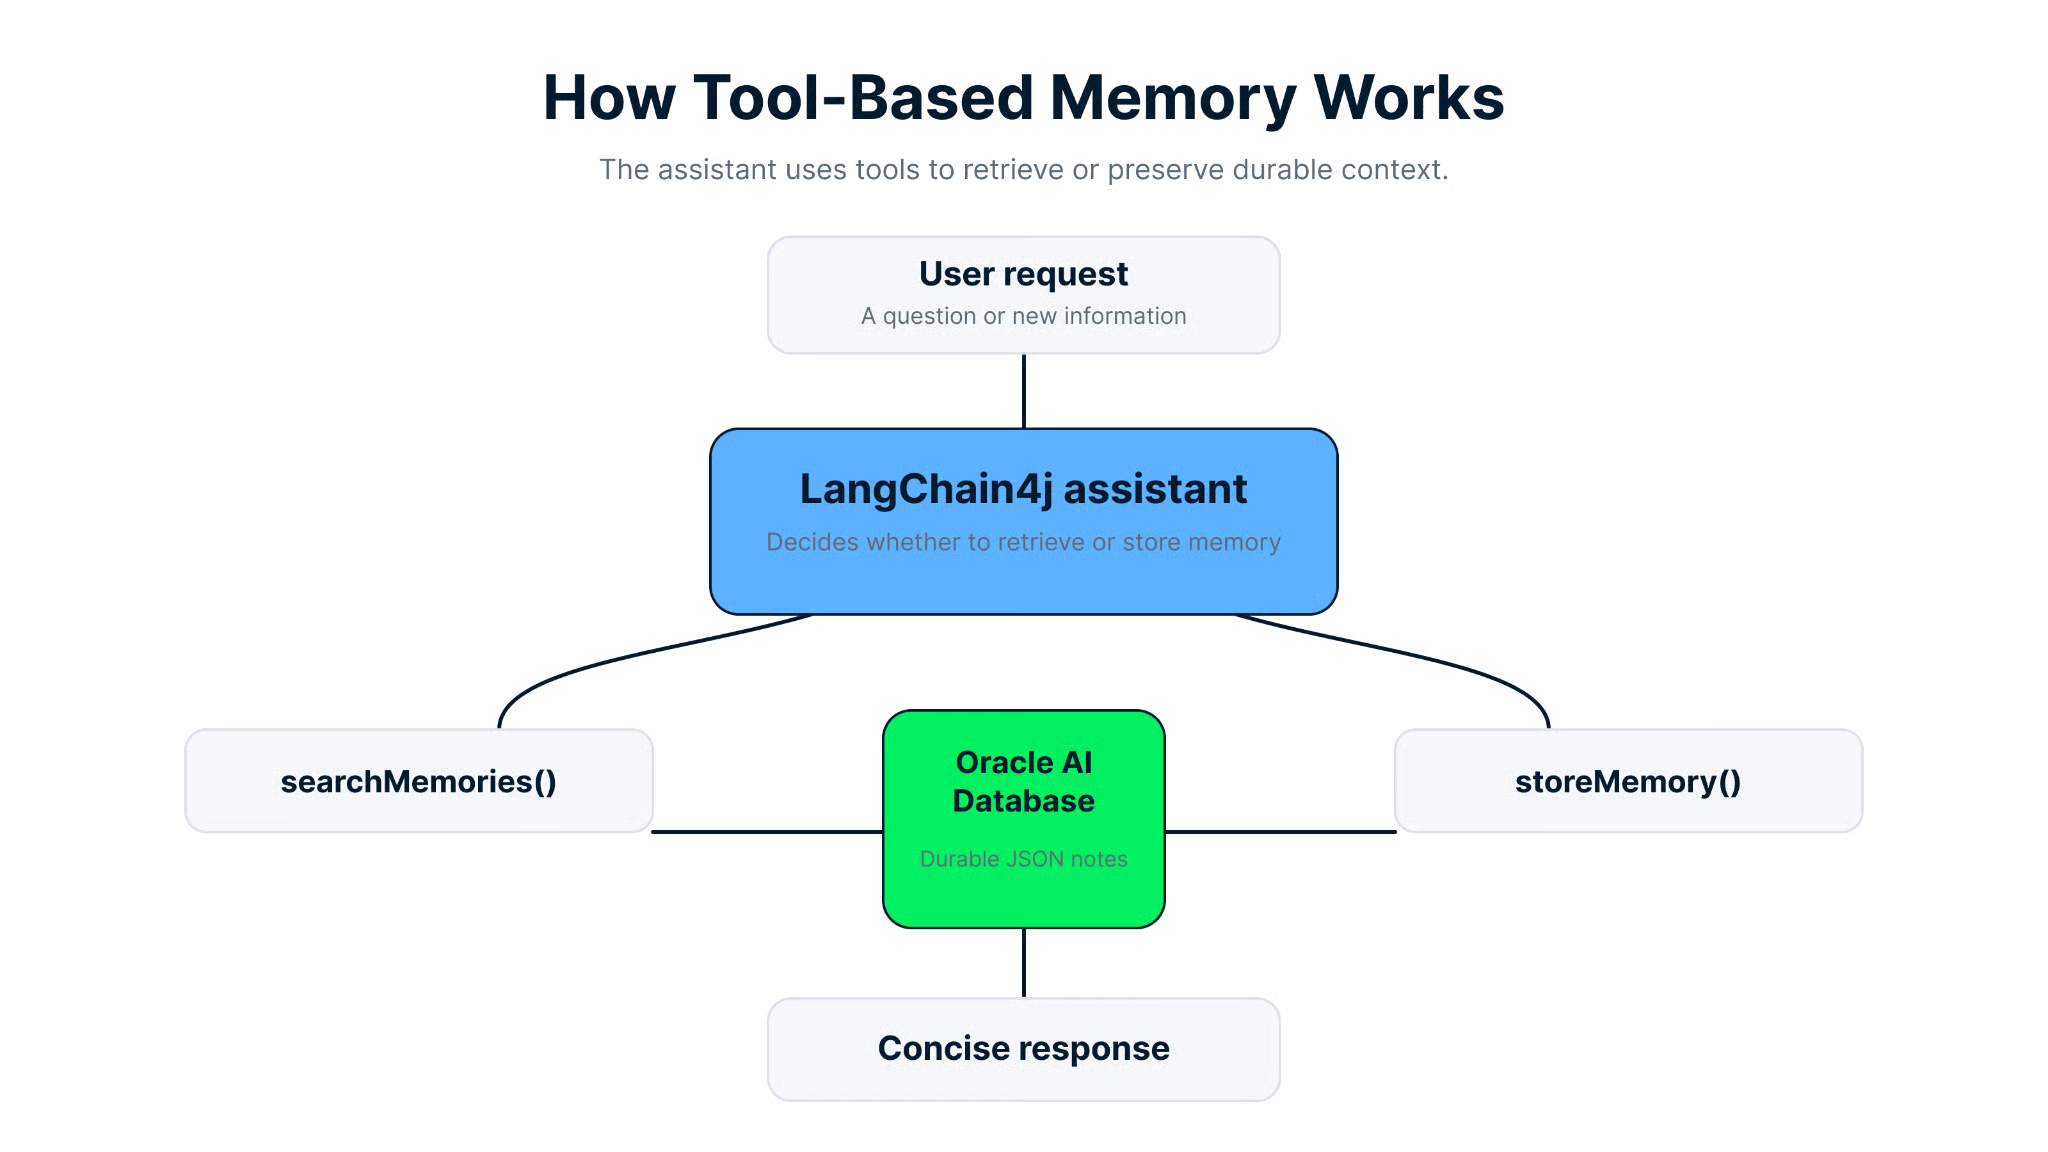
Memori berbasis alat memungkinkan asisten mengambil catatan yang ada atau menyimpan catatan baru di database yang tahan lama.
Contoh ini kecil, tetapi menunjukkan beberapa gagasan penting dalam desain agen.
Kelas MemoryTools mengekspos dua metode yang dianotasi dengan @Tool. Itu berarti LangChain4j dapat menyediakannya ke agen tanpa kode pembungkus tambahan.
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
Metode ini melakukan dua hal yang berguna. Ia mendelegasikan pengambilan ke repositori, dan memformat hasilnya dengan cara yang ramah model seperti [M12] some note text.
Itu membuat keluaran alat mudah dikutip oleh agen dalam respons akhirnya.
Catatan disimpan dalam tabel agent_memories sebagai dokumen JSON native. Setiap baris berisi:
idmemory_doccreated_atModul menginisialisasi skema secara otomatis:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
Ini menjaga model penyimpanan tetap sederhana sekaligus memberikan data terstruktur dan ketahanan yang dikelola database.
Repositori tidak menghasilkan embedding. Sebagai gantinya, ia mengekstrak kata kunci dari pertanyaan pengguna, menghapus stop word, membangun ekspresi Oracle Text dengan ACCUM, dan mencari konten dokumen JSON dengan json_textcontains.
Itu sangat membantu untuk pengenal dan istilah operasional seperti CHG2145, di mana pencocokan token yang tepat atau mendekati tepat sering lebih penting daripada kemiripan semantik.
Kelas Application membuat repositori, menginisialisasi skema, mengisi beberapa catatan awal, menyusun model chat, dan memulai loop terminal. Itu membuat contoh ini mudah dijalankan dan mudah diadaptasi ke layanan lain nanti.
Sebelum menjalankan modul, pastikan lingkungan lokal Anda sesuai dengan persyaratan proyek.
Anda memerlukan:
OPENAI_API_KEYProyek Maven bergantung pada:
langchain4jlangchain4j-open-aiojdbc11Testcontainers untuk uji integrasiSetel dulu kunci API OpenAI Anda:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
Lalu jalankan aplikasi dari direktori proyek:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
Aplikasi mengharapkan tepat tiga argumen:
1. JDBC URL
2. Nama pengguna database
3. Kata sandi database
Jika itu tidak ada, Application.main() akan melempar IllegalArgumentException. Jika OPENAI_API_KEY tidak ada, ia akan melempar IllegalStateException.
Saat aplikasi mulai, ia:
1. Membuat MemoryRepository
2. Menginisialisasi skema database
3. Mengisi tiga catatan contoh jika tabel kosong
4. Membangun OpenAiChatModel
5. Merangkaikan model dan alat ke dalam AiServices
6. Memulai loop CLI yang membaca input pengguna hingga Anda mengetik exit
Itu berarti Anda dapat mencoba pengambilan memori segera tanpa memasukkan baris secara manual terlebih dahulu.
Sekarang mari kita telusuri modul dalam urutan yang sama dengan yang digunakan aplikasi.
LangChain4j menggunakan antarmuka Java untuk mendeskripsikan kontrak agen. Dalam proyek ini, antarmuka tersebut adalah MemoryAssistant.
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
Bagian terpenting adalah pesan sistem. Ini memberi tahu model kapan harus menggunakan setiap alat:
Itu adalah contoh kebijakan alat yang ringan. Prompt-nya singkat, tetapi cukup spesifik untuk memandu pemilihan alat.
Agen tidak berinteraksi langsung dengan repositori. Sebagai gantinya, ia memanggil lapisan MemoryTools.
Berikut metode penyimpanannya:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
Ini sengaja dibuat ringkas. Seorang pengguna mungkin berkata:
Remember that the next shift should verify the checkout retry queue stays below 50.Jika model mengikuti prompt sistem dengan benar, ia memanggil storeMemory(), repositori menyimpan catatan tersebut, dan alat mengembalikan sesuatu seperti:
Stored memory M4.Nanti, pengguna dapat bertanya:
What should the next shift verify?Pada titik itu, agen dapat memanggil searchMemories() dan menggunakan catatan yang dikembalikan untuk menjawab.
Repositori adalah tempat sebagian besar logika memori yang tahan lama berada. Ini tetap berupa JDBC biasa, yang membuat desainnya mudah diperiksa.
Secara tingkat tinggi, MemoryRepository bertanggung jawab atas:
Oracle TextJalur penyisipan menormalisasi dan memvalidasi teks catatan sebelum menyimpannya:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
Dokumen JSON itu sendiri terlihat seperti ini:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
Struktur ini sederhana, tetapi cukup untuk mendukung penyimpanan dan pencarian teks.
Bagian paling menarik dari repositori adalah metode search():
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
Metode ini mengikuti alur praktis:
1. Tokenisasi pertanyaan pengguna
2. Ubah token menjadi huruf kecil
3. Hapus stop word seperti the, what, dan remember
4. Pertahankan token pendek yang bermakna saat mengandung digit
5. Bangun ekspresi Oracle Text dengan ACCUM
6. Cari data JSON dengan json_textcontains
Detail “digit diperbolehkan” itu penting. Ini membantu istilah seperti CHG2145 lolos dari ekstraksi kata kunci, yang merupakan jenis pencarian berbasis pengenal yang dibutuhkan banyak agen operasional.
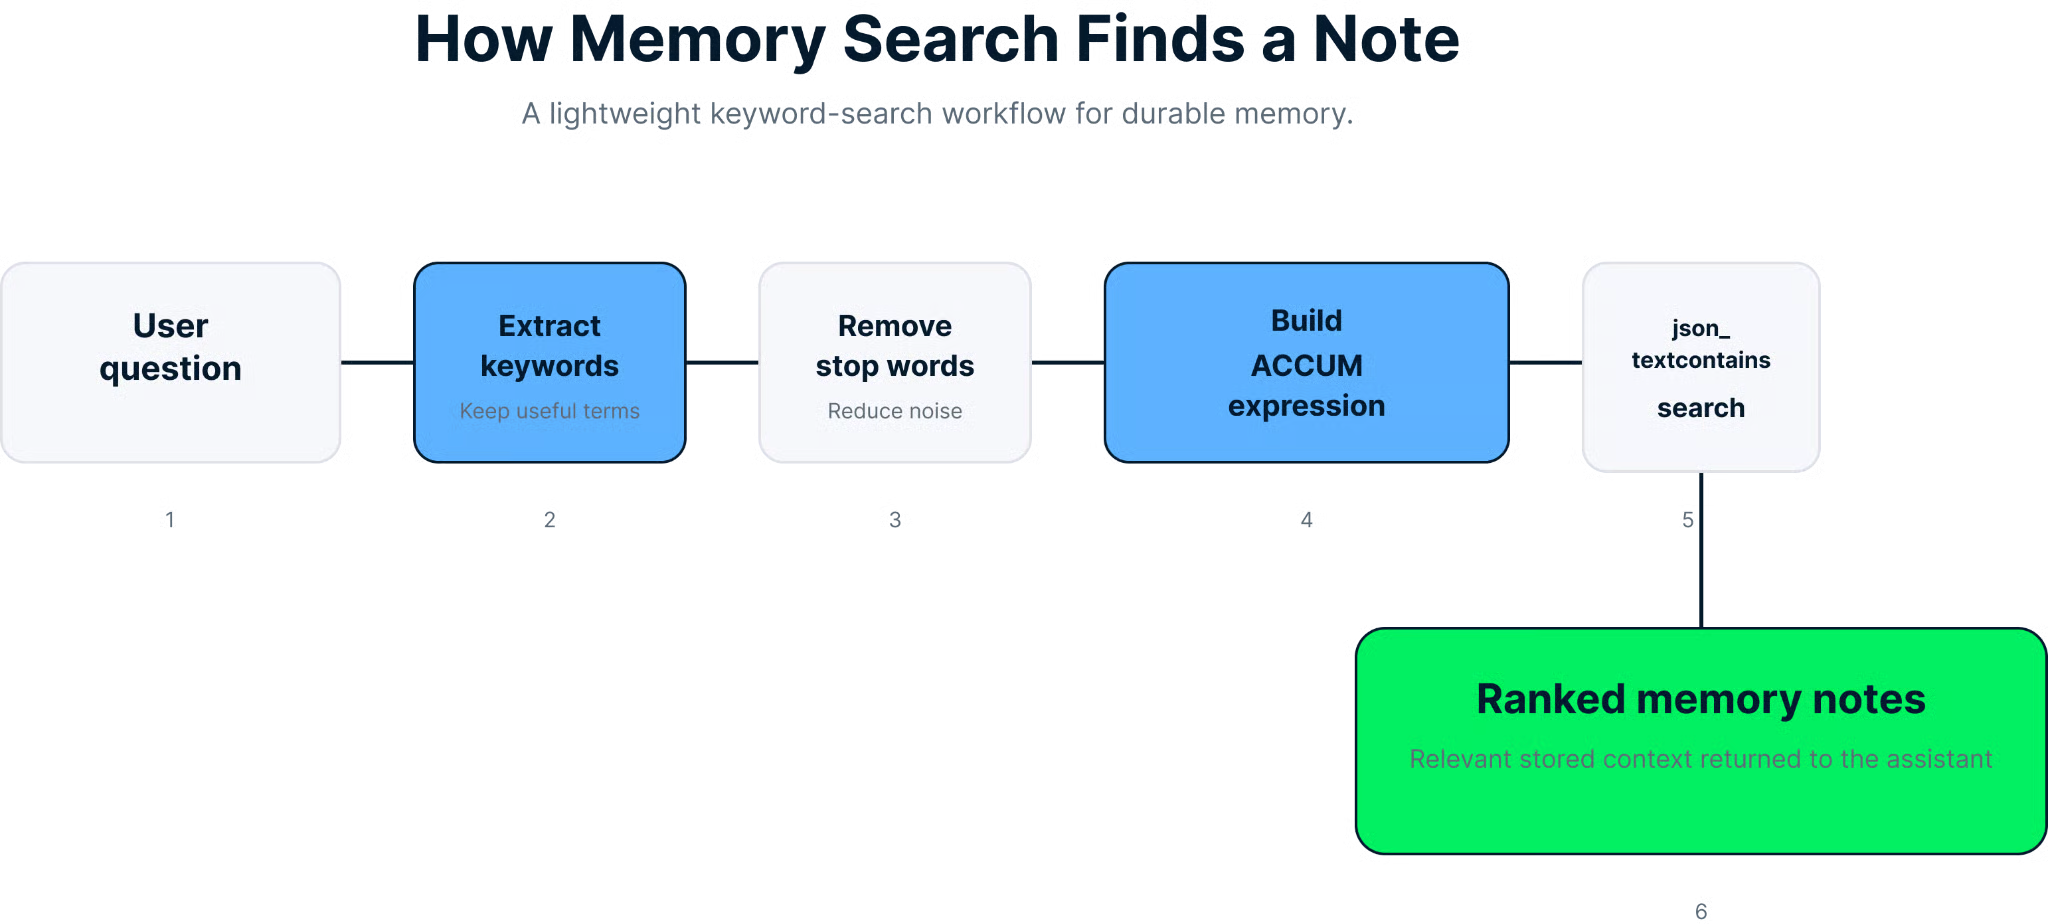
Alur pencarian mengonversi pertanyaan menjadi ekspresi kata kunci dan mengembalikan catatan memori yang diperingkat.
Kueri SQL pencariannya adalah:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
Jika pertanyaan tidak menghasilkan kata kunci yang berguna, repositori kembali ke catatan terbaru. Itu memberi agen nilai bawaan yang masuk akal alih-alih terlalu cepat mengembalikan pencarian kosong.
Aplikasi menyatukan bagian-bagian dengan AiServices.builder():
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
Ini adalah pola lengkap dalam satu tempat:
Setelah itu, loop konsol cukup meneruskan input pengguna ke assistant.chat(input).
Aplikasi mencetak beberapa prompt awal:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
Prompt ini berguna karena melatih seluruh siklus hidup memori:
Modul ini sengaja sempit, yang merupakan kekuatan saat Anda mempelajari polanya. Namun, ada beberapa detail praktis yang perlu diingat.
Prompt sistem memberi tahu model untuk menyimpan memori hanya ketika pengguna secara eksplisit memintanya. Itu membantu mengurangi penulisan yang tidak disengaja. Jika Anda memperluas prompt secara ceroboh, model bisa mulai menyimpan catatan bernilai rendah.
Repositori ini paling cocok untuk catatan operasional singkat, pengingat, dan pengenal. Ini belum merupakan sistem retrieval-augmented generation lengkap dengan embedding, chunking, pencarian hibrida, atau perankingan.
Untuk string seperti ID insiden, nomor tiket, dan referensi permintaan perubahan, pengambilan berorientasi kata kunci sering kali merupakan titik awal yang lebih baik daripada pencarian semantik. Contoh ini mencerminkan pertukaran tersebut dengan jelas.
Pengujian proyek adalah uji integrasi yang didukung oleh Testcontainers. Jika Docker tidak tersedia, mvn test akan gagal sebelum logika repositori berjalan. Itu adalah masalah lingkungan, bukan berarti bug aplikasi.
Jalankan pengujian dengan:
# Run the integration tests.
 mvn test
Pengujian mencakup dua perilaku penting:
Kesalahan umum dalam proyek agen adalah menambahkan penyimpanan vektor, riwayat percakapan, peringkasan, dan kebijakan pengambilan sekaligus. Contoh ini menunjukkan progresi yang lebih baik:
1. Definisikan kasus penggunaan memori yang konkret
2. Ekspos alat yang eksplisit
3. Dukung alat tersebut dengan penyimpanan yang tahan lama
4. Verifikasi perilaku pengambilan
5. Baru kemudian pertimbangkan pola memori yang lebih canggih
Jika Anda ingin terus membangun keterampilan agen setelah tutorial ini, sumber daya DataCamp berikut adalah langkah selanjutnya yang baik:
Anda sekarang telah melihat cara membangun agen kecil namun berguna yang berkemampuan memori dengan LangChain4j, Java, dan Oracle AI Database. Gagasan intinya sederhana: berikan alat memori yang eksplisit kepada model, simpan catatan secara tahan lama sebagai JSON, dan ambil kembali dengan strategi pencarian yang lugas.
Desain ini merupakan fondasi yang kuat karena mudah dipahami dan mudah diperluas. Setelah pola ini berfungsi, Anda dapat menambahkan penyaringan yang lebih baik, skema catatan yang lebih kaya, cakupan pengguna, atau bahkan pencarian vektor jika kasus penggunaan menuntutnya.
Jika Anda ingin terus belajar tentang desain agen, langkah baik berikutnya adalah membandingkan pola memori berbasis alat ini dengan kerangka agen yang lebih luas dan alur orkestrasi. Secara khusus, layak untuk mengeksplorasi bagaimana alat eksplisit, pola pengambilan, dan agen multi-langkah saling terhubung dalam sistem AI yang lebih besar.
Kursus Teratas DataCamp
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt