Curso
Introdução ao Oracle SQL
4 h
18.5K
Neste tutorial, vamos explorar um pequeno módulo Java que expõe ferramentas personalizadas, salva anotações como JSON no Oracle AI Database e as recupera com busca de texto completo.
Se você está criando agentes de IA, o histórico curto do chat geralmente não é suficiente. Assistentes de verdade precisam de um pouco de memória durável para guardar fatos importantes e recuperá-los depois.
Este tutorial mostra como implementar esse padrão com um módulo Java mínimo. Você vai usar ferramentas do LangChain4j, uma interface simples de agente e o Oracle AI Database como armazenamento. Em vez de adicionar embeddings ou um pipeline completo de recuperação, este exemplo mantém o design propositalmente enxuto: as notas são salvas como documentos JSON e pesquisadas com Oracle Text.
Ao final, você vai entender como o módulo integra:
LangChain4j@ToolJDBC para armazenamento durável de notasLangChain4j permite expor métodos Java comuns como ferramentas que o modelo pode chamar quando precisa de capacidades externas. Neste módulo, essas capacidades são voltadas à memória:
searchMemories(String question) encontra anotações relevantesstoreMemory(String note) grava uma nova nota durávelIsso é diferente do histórico padrão do chat, que guarda mensagens em uma janela de contexto na memória.
Memória persistente baseada em ferramentas decide quando é preciso pesquisar ou armazenar notas, e os dados ficam em um banco de dados.
Esse padrão é útil quando você quer que um agente lembre fatos como anotações de incidentes, lembretes de runbook ou ações de follow-up sem construir um sistema de recuperação maior cedo demais.
A memória persistente baseada em banco pode ser acessada simultaneamente por um ou mais agentes sem disputa de dados.
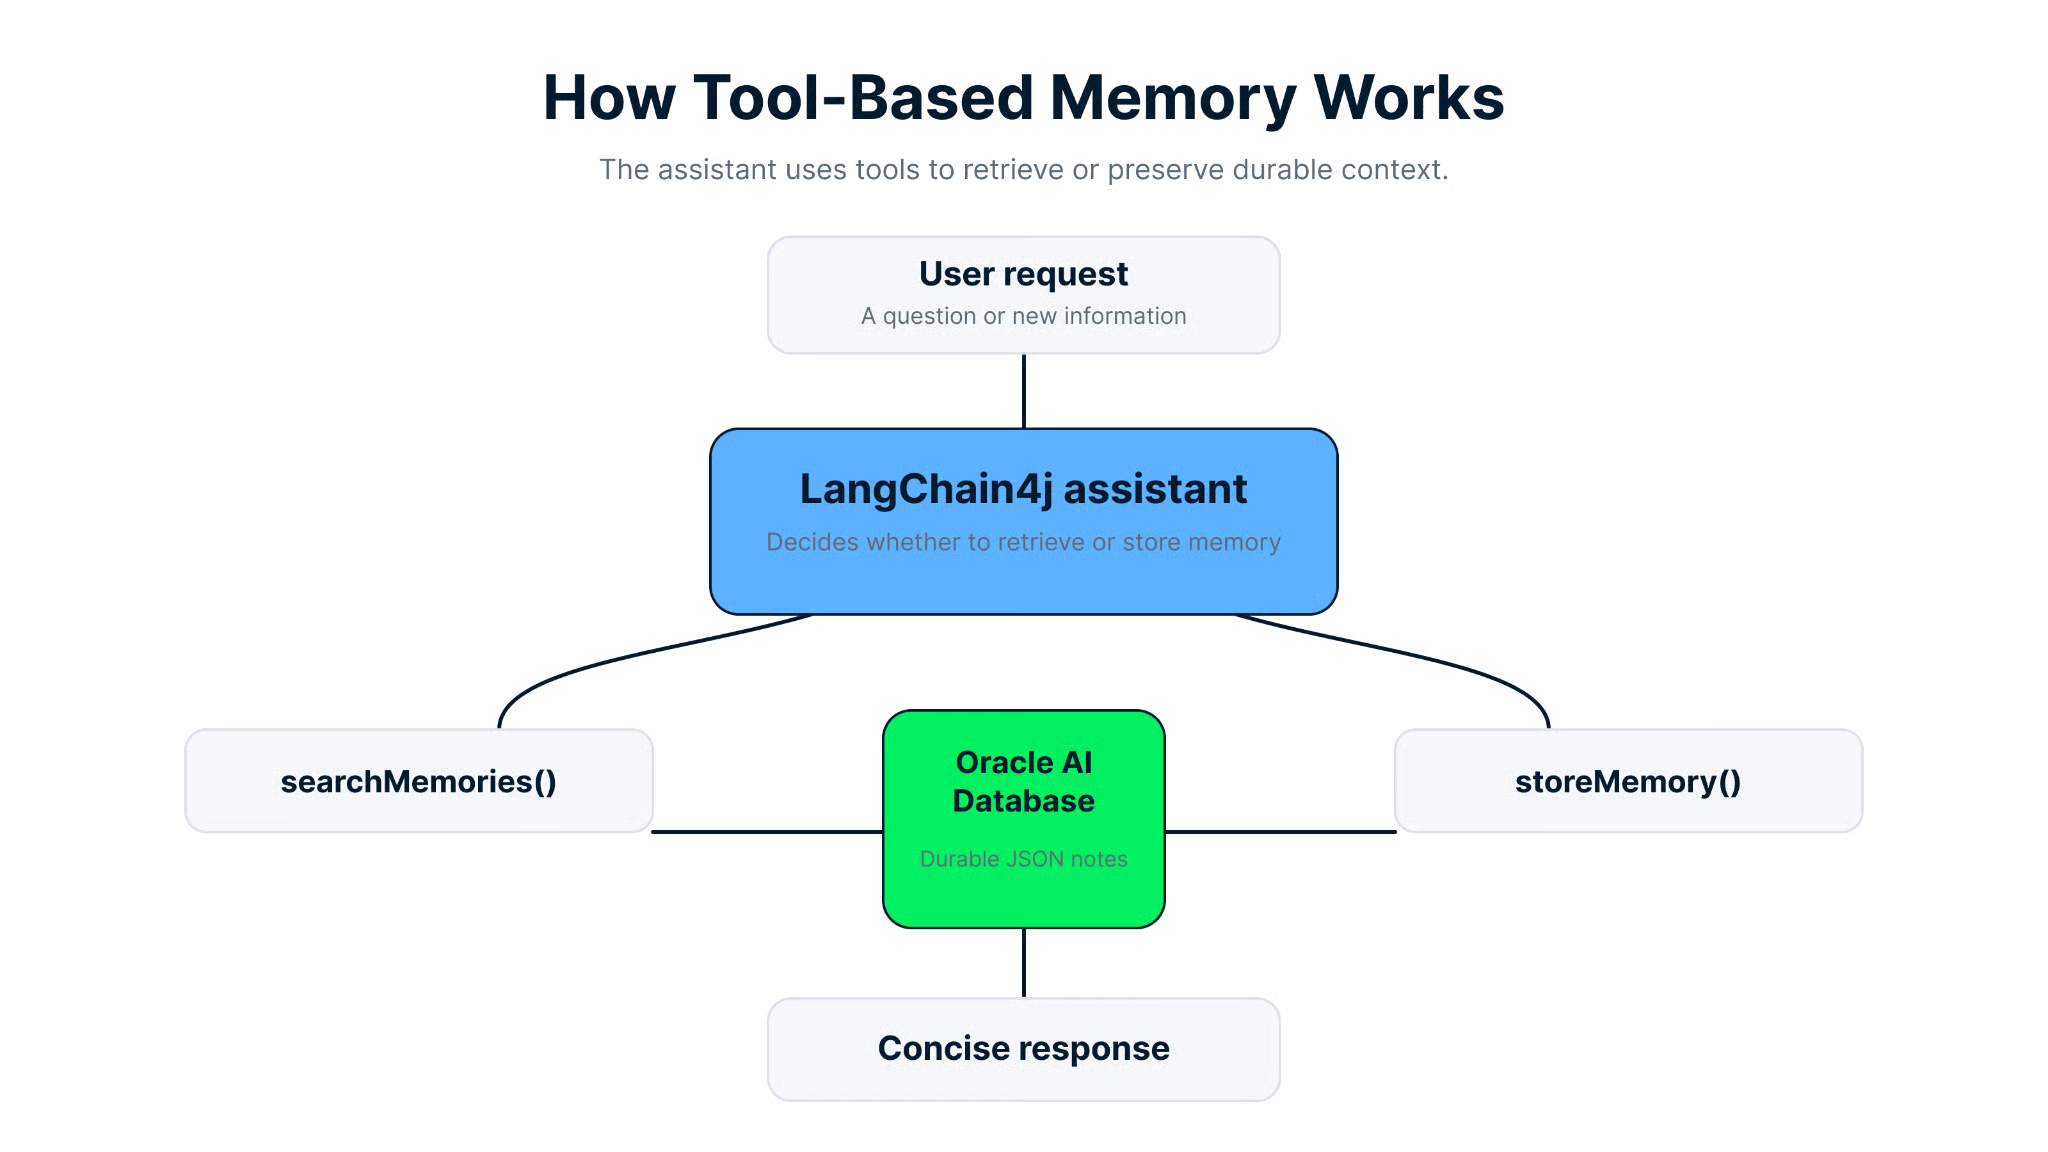
Com memória baseada em ferramentas, o assistente pode recuperar notas existentes ou salvar novas notas em um banco de dados durável.
Este exemplo é pequeno, mas demonstra várias ideias importantes de design de agentes.
A classe MemoryTools expõe dois métodos anotados com @Tool. Isso significa que o LangChain4j pode disponibilizá-los ao agente sem código adicional de "wrapper".
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
Esse método faz duas coisas úteis: delega a recuperação ao repositório e formata os resultados de um jeito amigável ao modelo, como [M12] algum texto da nota.
Isso facilita o agente citar a saída da ferramenta na resposta final.
As notas ficam em uma tabela agent_memories como documentos JSON nativos. Cada linha contém:
idmemory_doccreated_atO módulo inicializa o schema automaticamente:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
Isso mantém o modelo de armazenamento simples, oferecendo dados estruturados e durabilidade gerenciada pelo banco.
O repositório não gera embeddings. Em vez disso, extrai palavras-chave da pergunta do usuário, remove stop words, monta uma expressão do Oracle Text com ACCUM e pesquisa o conteúdo do documento JSON com json_textcontains.
Isso é especialmente útil para identificadores e termos operacionais como CHG2145, em que a correspondência exata ou quase exata costuma importar mais do que similaridade semântica.
A classe Application cria o repositório, inicializa o schema, insere algumas notas de exemplo, constrói o modelo de chat e inicia um loop no terminal. Assim, o exemplo é fácil de executar e de adaptar para outro serviço depois.
Antes de rodar o módulo, garanta que seu ambiente local atende aos requisitos do projeto.
Você vai precisar de:
OPENAI_API_KEYO projeto Maven depende de:
langchain4jlangchain4j-open-aiojdbc11Testcontainers para testes de integraçãoDefina sua chave da OpenAI primeiro:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
Depois, rode o app a partir do diretório do projeto:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
O aplicativo espera exatamente três argumentos:
1. URL JDBC
2. Nome de usuário do banco de dados
3. Senha do banco de dados
Se algo estiver faltando, Application.main() lança um IllegalArgumentException. Se OPENAI_API_KEY não estiver definida, lança um IllegalStateException.
Quando o app inicia, ele:
1. Cria um MemoryRepository
2. Inicializa o schema do banco
3. Insere três notas de exemplo se a tabela estiver vazia
4. Constrói um OpenAiChatModel
5. Conecta o modelo e as ferramentas no AiServices
6. Inicia um loop de CLI que lê a entrada do usuário até você digitar exit
Ou seja, você pode testar a recuperação de memória imediatamente, sem inserir linhas manualmente antes.
Agora vamos percorrer o módulo na mesma ordem em que o aplicativo o utiliza.
LangChain4j usa uma interface Java para descrever o contrato do agente. Neste projeto, essa interface é MemoryAssistant.
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
A parte importante é a mensagem de sistema. Ela diz ao modelo quando usar cada ferramenta:
Esse é um bom exemplo de política de ferramentas enxuta. O prompt é curto, mas específico o suficiente para orientar a seleção de ferramentas.
O agente não fala diretamente com o repositório. Em vez disso, chama a camada MemoryTools.
Aqui está o método de armazenamento:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
Isso é propositalmente compacto. Um usuário pode dizer:
Remember that the next shift should verify the checkout retry queue stays below 50.Se o modelo seguir corretamente o prompt do sistema, ele chama storeMemory(), o repositório persiste a nota e a ferramenta retorna algo como:
Stored memory M4.Depois, o usuário pode perguntar:
What should the next shift verify?Nesse ponto, o agente pode chamar searchMemories() e usar a nota retornada para responder.
O repositório concentra a maior parte da lógica de memória durável. Ainda é JDBC puro, o que deixa o design fácil de inspecionar.
Em alto nível, o MemoryRepository é responsável por:
Oracle TextO caminho de inserção normaliza e valida o texto da nota antes de armazená-lo:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
O documento JSON em si fica assim:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
Essa estrutura é simples, mas suficiente para suportar persistência e busca textual.
A parte mais interessante do repositório é o método search():
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
Esse método segue um fluxo prático:
1. Tokeniza a pergunta do usuário
2. Converte os tokens para minúsculas
3. Remove stop words como the, what e remember
4. Mantém tokens curtos significativos quando incluem dígitos
5. Monta uma expressão do Oracle Text com ACCUM
6. Pesquisa os dados JSON com json_textcontains
Esse detalhe de “permitir dígitos” é importante. Ele ajuda termos como CHG2145 a sobreviver na extração de palavras-chave — exatamente o tipo de busca por identificadores que muitos agentes operacionais precisam.
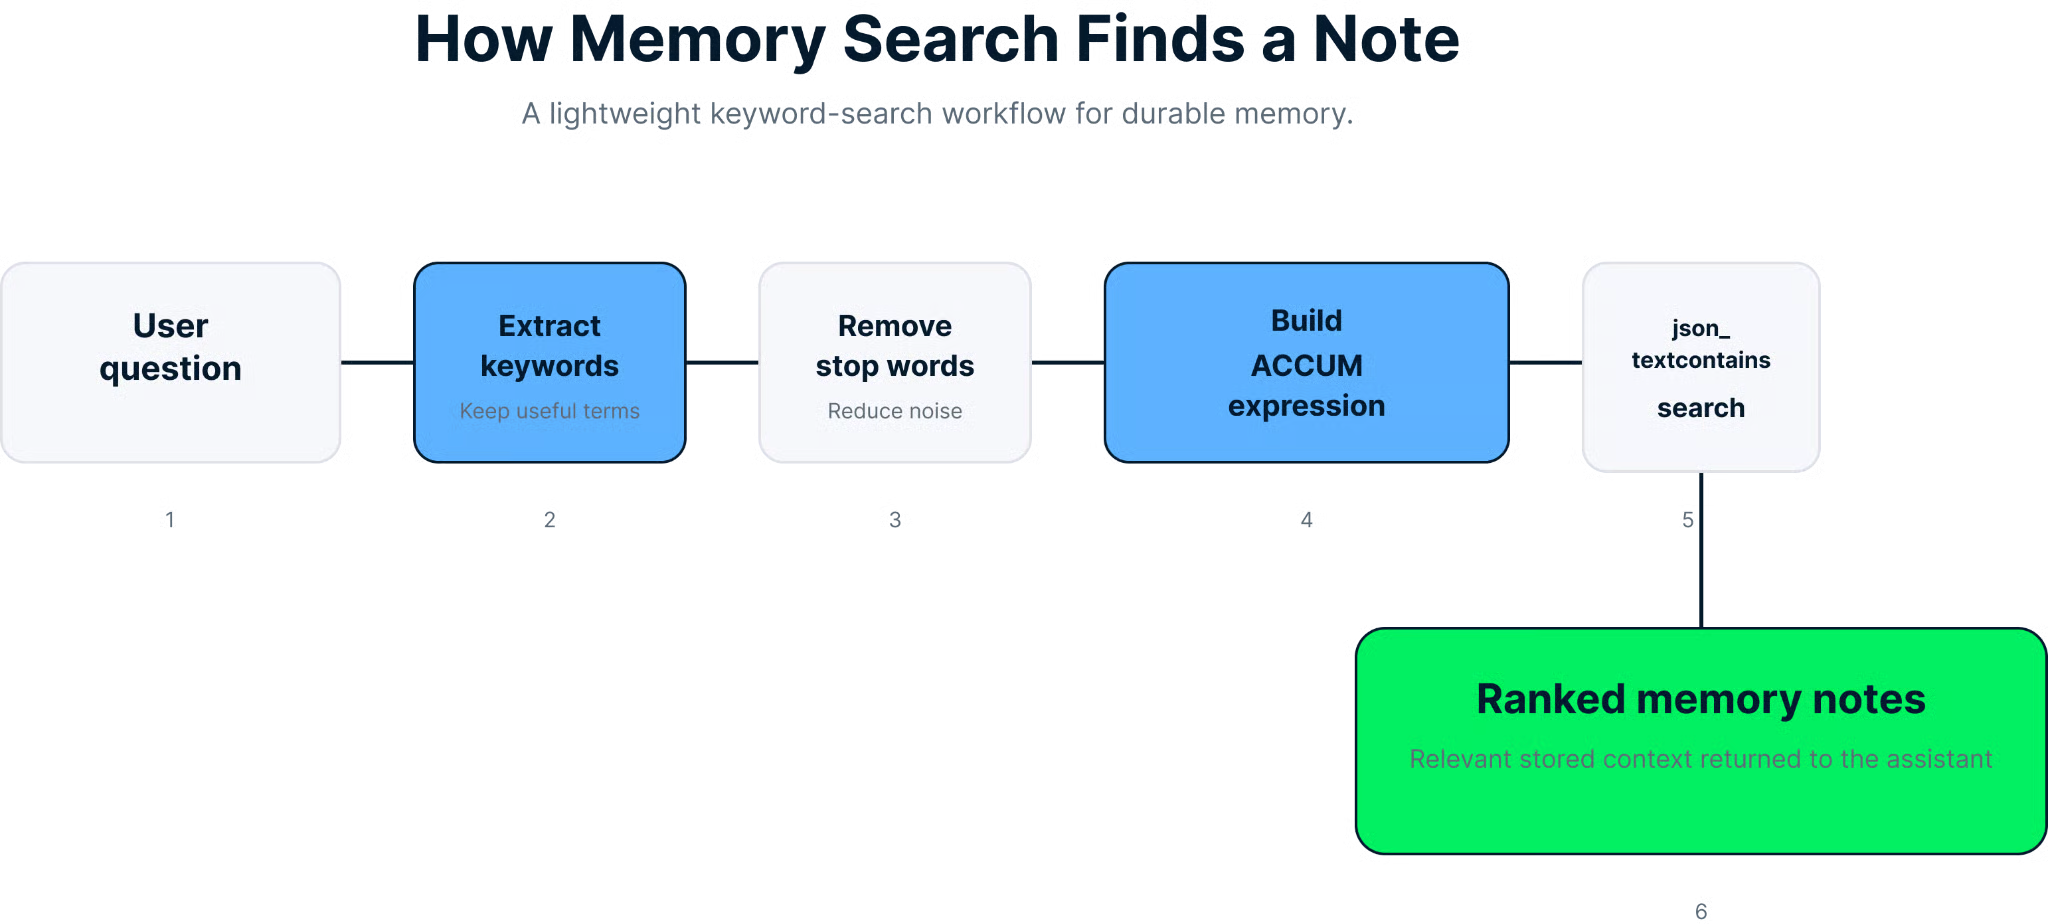
O fluxo de busca converte a pergunta em uma expressão de palavras-chave e retorna notas de memória ranqueadas.
A consulta SQL de busca é:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
Se a pergunta não gerar boas palavras-chave, o repositório faz fallback para notas recentes. Assim, o agente tem um padrão razoável em vez de retornar uma busca vazia cedo demais.
O aplicativo integra as peças com AiServices.builder():
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
Esse é o padrão completo em um só lugar:
Depois disso, o loop do console apenas passa a entrada do usuário para assistant.chat(input).
O aplicativo imprime alguns prompts iniciais:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
Eles são úteis porque exercitam todo o ciclo de memória:
Este módulo é intencionalmente focado, o que ajuda no aprendizado do padrão. Ainda assim, vale considerar alguns pontos práticos.
O prompt do sistema indica ao modelo para armazenar memória somente quando o usuário pedir explicitamente. Isso ajuda a reduzir gravações acidentais. Se você ampliar o prompt sem cuidado, o modelo pode começar a persistir notas de baixo valor.
Este repositório é melhor para notas operacionais curtas, lembretes e identificadores. Ainda não é um sistema completo de RAG com embeddings, chunking, busca híbrida ou reranqueamento.
Para strings como IDs de incidentes, números de chamados e referências de change request, a recuperação por palavras-chave costuma ser um ponto de partida melhor do que busca semântica. Este exemplo deixa esse trade-off claro.
Os testes do projeto são de integração e usam Testcontainers. Se o Docker não estiver disponível, mvn test vai falhar antes mesmo da lógica do repositório rodar. Isso é um problema de ambiente, não necessariamente um bug do app.
Execute os testes com:
# Run the integration tests.
 mvn test
Os testes cobrem dois comportamentos importantes:
Um erro comum em projetos de agentes é adicionar de uma vez só: armazenamento vetorial, histórico de conversa, sumarização e políticas de recuperação. Este exemplo sugere uma progressão melhor:
1. Defina um caso de uso concreto de memória
2. Exponha ferramentas explícitas
3. Dê suporte a essas ferramentas com armazenamento durável
4. Valide o comportamento de recuperação
5. Só então considere padrões de memória mais avançados
Se você quer continuar desenvolvendo habilidades em agentes depois deste tutorial, estes recursos da DataCamp são um ótimo próximo passo:
Você viu como criar um agente pequeno, porém útil, com memória usando LangChain4j, Java e Oracle AI Database. A ideia central é simples: dê ao modelo ferramentas explícitas de memória, armazene notas de forma durável como JSON e recupere-as com uma estratégia de busca direta.
Esse design é uma base sólida porque é fácil de entender e de evoluir. Quando o padrão estiver funcionando, você pode adicionar filtros melhores, esquemas de notas mais ricos, escopo por usuário ou até busca vetorial, caso o uso exija.
Se quiser continuar aprendendo sobre design de agentes, o próximo passo é comparar este padrão de memória baseada em ferramentas com frameworks de agentes mais amplos e fluxos de orquestração. Vale explorar como ferramentas explícitas, padrões de recuperação e agentes multiestágio se encaixam em sistemas de IA maiores.
Principais cursos da DataCamp
Curso
Curso
Programa
blog
Tutorial
Tutorial
Moez Ali
12 min
Tutorial
Ryan Ong
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Moez Ali
11 min