50 % de descuento en DataCamp Premium. Más de 700 cursos a mitad de precio. Empieza a aprender hoy.
En este tutorial, recorreremos un pequeño módulo de Java que expone herramientas personalizadas, guarda notas como JSON en Oracle AI Database y las recupera con búsqueda de texto completo.
Si estás creando agentes de IA, el historial de chat de corto plazo suele no ser suficiente. Los asistentes reales a menudo necesitan una pequeña cantidad de memoria duradera para guardar hechos importantes y recuperarlos más tarde.
Este tutorial muestra cómo implantar ese patrón con un módulo mínimo en Java. Usarás LangChain4j tools, una interfaz de agente sencilla y Oracle AI Database como almacén subyacente. En lugar de añadir embeddings o una canalización completa de retrieval, este ejemplo mantiene el diseño deliberadamente pequeño: las notas se guardan como documentos JSON y se buscan con Oracle Text.
Al final, entenderás cómo el módulo conecta:
LangChain4j@ToolJDBC para almacenamiento duradero de notasLangChain4j te permite exponer métodos Java ordinarios como herramientas que un modelo puede llamar cuando necesita capacidades externas. En este módulo, esas capacidades están orientadas a la memoria:
searchMemories(String question) encuentra notas guardadas relevantesstoreMemory(String note) escribe una nueva nota duraderaEsto es distinto del historial estándar de chat que almacena mensajes en una ventana de contexto en memoria.
La memoria persistente basada en herramientas decide cuándo necesita buscar o guardar notas, y los datos subyacentes viven en una base de datos.
Este patrón es útil cuando quieres que un agente recuerde hechos como notas de incidencias, recordatorios de runbooks o acciones de seguimiento sin construir demasiado pronto un sistema de retrieval más grande.
La memoria persistente respaldada por base de datos también puede ser accedida en paralelo por uno o más agentes sin contención de datos.
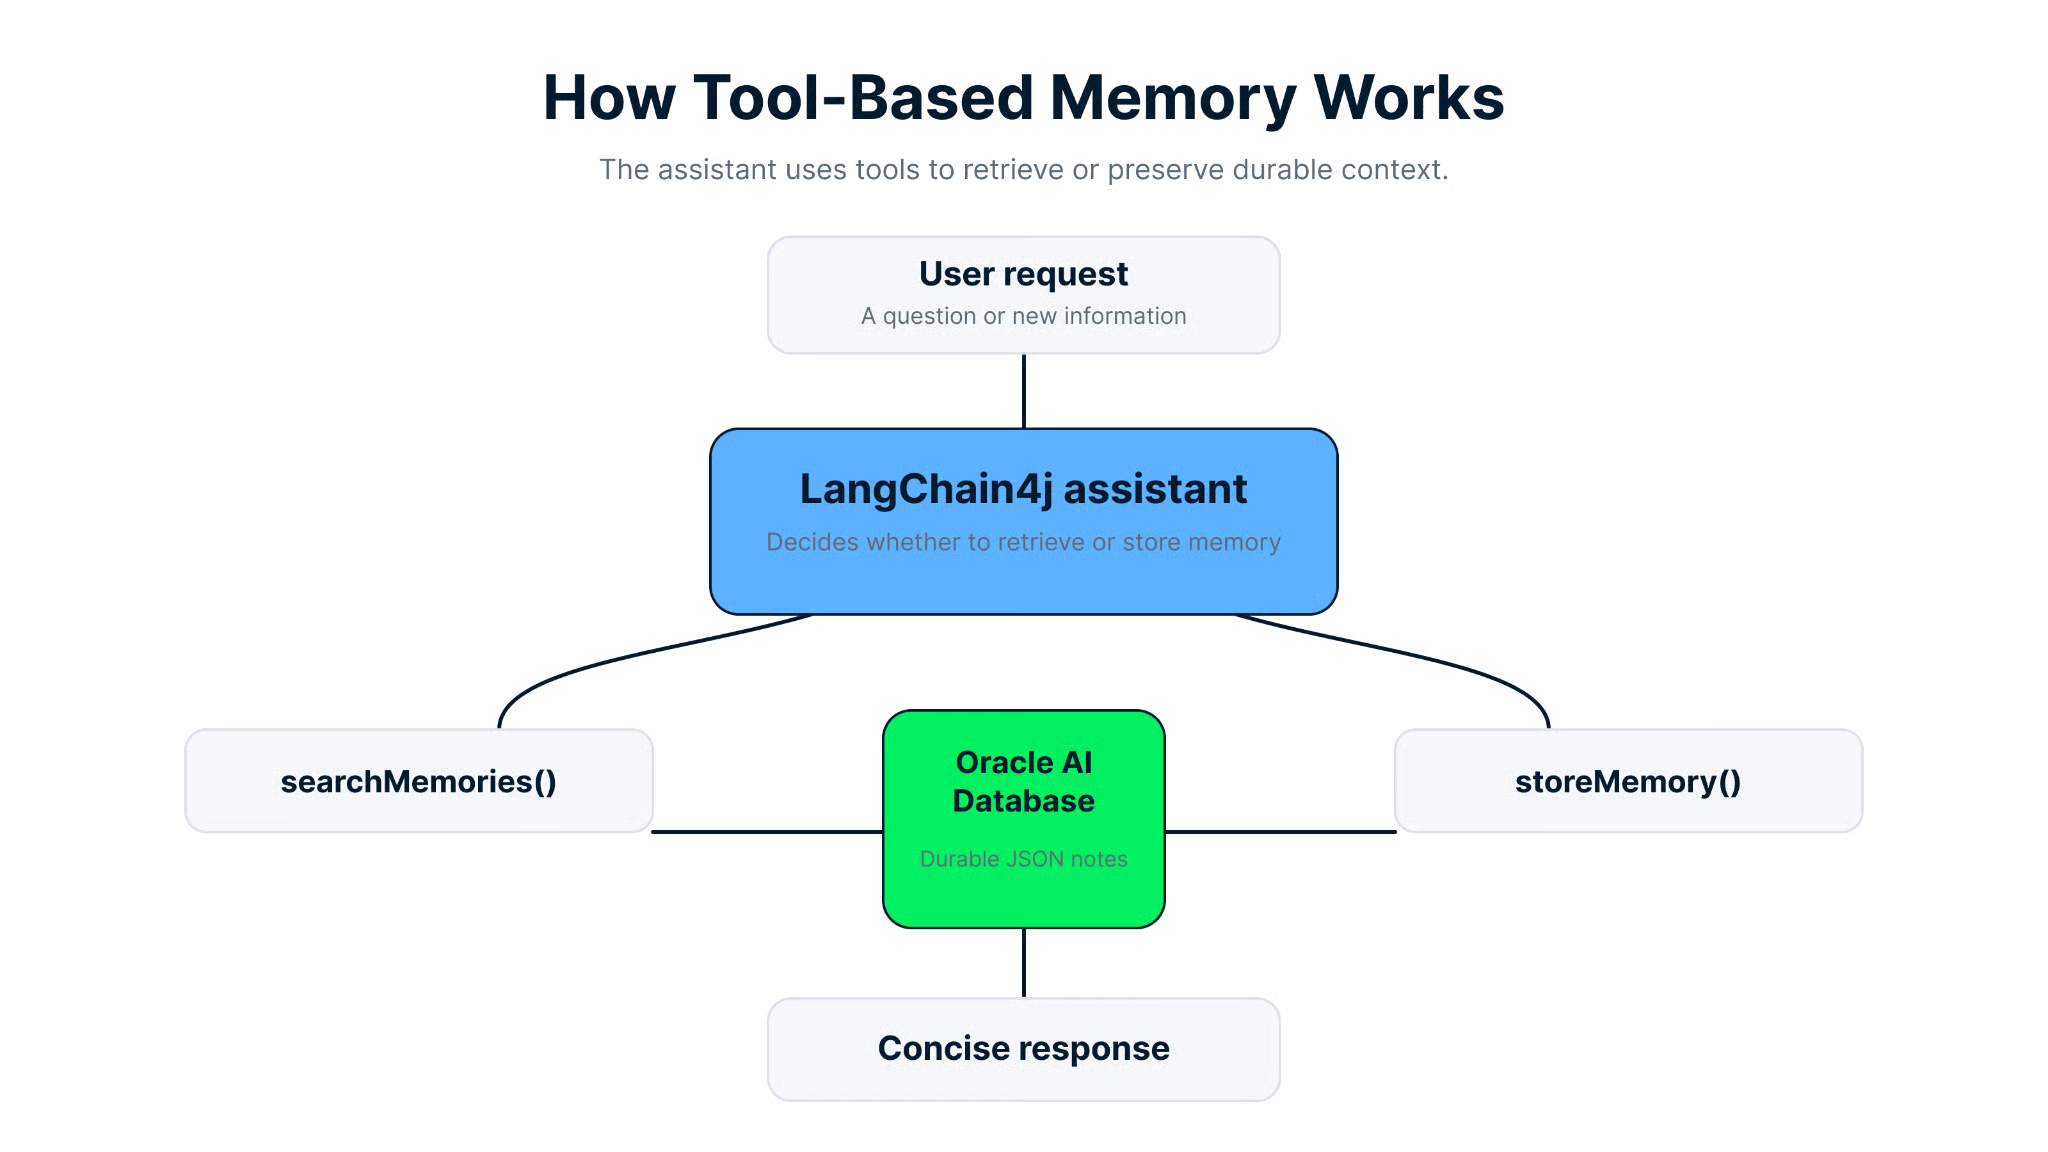
La memoria basada en herramientas permite que el asistente recupere notas existentes o guarde nuevas notas en una base de datos duradera.
Este ejemplo es pequeño, pero demuestra varias ideas importantes de diseño de agentes.
La clase MemoryTools expone dos métodos anotados con @Tool. Eso significa que LangChain4j puede ponerlos a disposición del agente sin código envoltorio adicional.
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
Este método hace dos cosas útiles. Delegar la recuperación al repositorio y dar formato a los resultados de forma que el modelo los entienda, por ejemplo [M12] some note text.
Así, la salida de la herramienta es fácil de citar por el agente en su respuesta final.
Las notas se almacenan en una tabla agent_memories como documentos JSON nativos. Cada fila contiene:
idmemory_doccreated_atEl módulo inicializa el esquema automáticamente:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
Esto mantiene el modelo de almacenamiento simple y, aun así, te da datos estructurados y durabilidad gestionada por la base de datos.
El repositorio no genera embeddings. En su lugar, extrae palabras clave de la pregunta del usuario, elimina stop words, construye una expresión de Oracle Text con ACCUM y busca el contenido del documento JSON con json_textcontains.
Esto resulta especialmente útil para identificadores y términos operativos como CHG2145, donde el ajuste exacto o casi exacto de tokens suele importar más que la similitud semántica.
La clase Application crea el repositorio, inicializa el esquema, precarga algunas notas, construye el modelo de chat y arranca un bucle en terminal. Así el ejemplo es fácil de ejecutar y de adaptar a otro servicio más adelante.
Antes de ejecutar el módulo, asegúrate de que tu entorno local cumple los requisitos del proyecto.
Necesitas:
OPENAI_API_KEYEl proyecto Maven depende de:
langchain4jlangchain4j-open-aiojdbc11Testcontainers para pruebas de integraciónPrimero, define tu clave de API de OpenAI:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
Después, ejecuta la app desde el directorio del proyecto:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
La aplicación espera exactamente tres argumentos:
1. URL JDBC
2. Nombre de usuario de la base de datos
3. Contraseña de la base de datos
Si faltan, Application.main() lanza un IllegalArgumentException. Si falta OPENAI_API_KEY, lanza un IllegalStateException.
Cuando la app arranca:
1. Crea un MemoryRepository
2. Inicializa el esquema de base de datos
3. Precaega tres notas de ejemplo si la tabla está vacía
4. Construye un OpenAiChatModel
5. Conecta el modelo y las herramientas en AiServices
6. Inicia un bucle CLI que lee entradas hasta que escribes exit
Esto te permite probar la recuperación de memoria de inmediato sin insertar filas a mano primero.
Ahora recorramos el módulo en el mismo orden en que lo usa la aplicación.
LangChain4j usa una interfaz de Java para describir el contrato del agente. En este proyecto, esa interfaz es MemoryAssistant.
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
Lo importante es el mensaje del sistema. Indica al modelo cuándo usar cada herramienta:
Es un buen ejemplo de política de herramientas ligera. El prompt es breve, pero lo bastante específico para guiar la selección de herramientas.
El agente no habla directamente con el repositorio. En su lugar, llama a la capa MemoryTools.
Este es el método de almacenamiento:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
Esto es intencionadamente compacto. Un usuario podría decir:
Remember that the next shift should verify the checkout retry queue stays below 50.Si el modelo sigue correctamente el prompt del sistema, llamará a storeMemory(), el repositorio persistirá la nota y la herramienta devolverá algo como:
Stored memory M4.Más tarde, el usuario puede preguntar:
What should the next shift verify?En ese momento, el agente puede llamar a searchMemories() y usar la nota devuelta para responder.
El repositorio es donde vive la mayor parte de la lógica de memoria duradera. Sigue siendo JDBC puro, lo que facilita inspeccionar el diseño.
A alto nivel, MemoryRepository se encarga de:
Oracle TextLa ruta de inserción normaliza y valida el texto de la nota antes de almacenarlo:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
El propio documento JSON tiene este aspecto:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
La estructura es simple, pero suficiente para soportar persistencia y búsqueda de texto.
La parte más interesante del repositorio es el método search():
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
Este método sigue un flujo práctico:
1. Tokeniza la pregunta del usuario
2. Pasa los tokens a minúsculas
3. Elimina stop words como the, what y remember
4. Conserva tokens cortos significativos cuando incluyan dígitos
5. Construye una expresión de Oracle Text con ACCUM
6. Busca en los datos JSON con json_textcontains
Ese detalle de “se permiten dígitos” es importante. Ayuda a que términos como CHG2145 sobrevivan a la extracción de palabras clave, justo el tipo de búsquedas con identificadores que muchos agentes operativos necesitan.
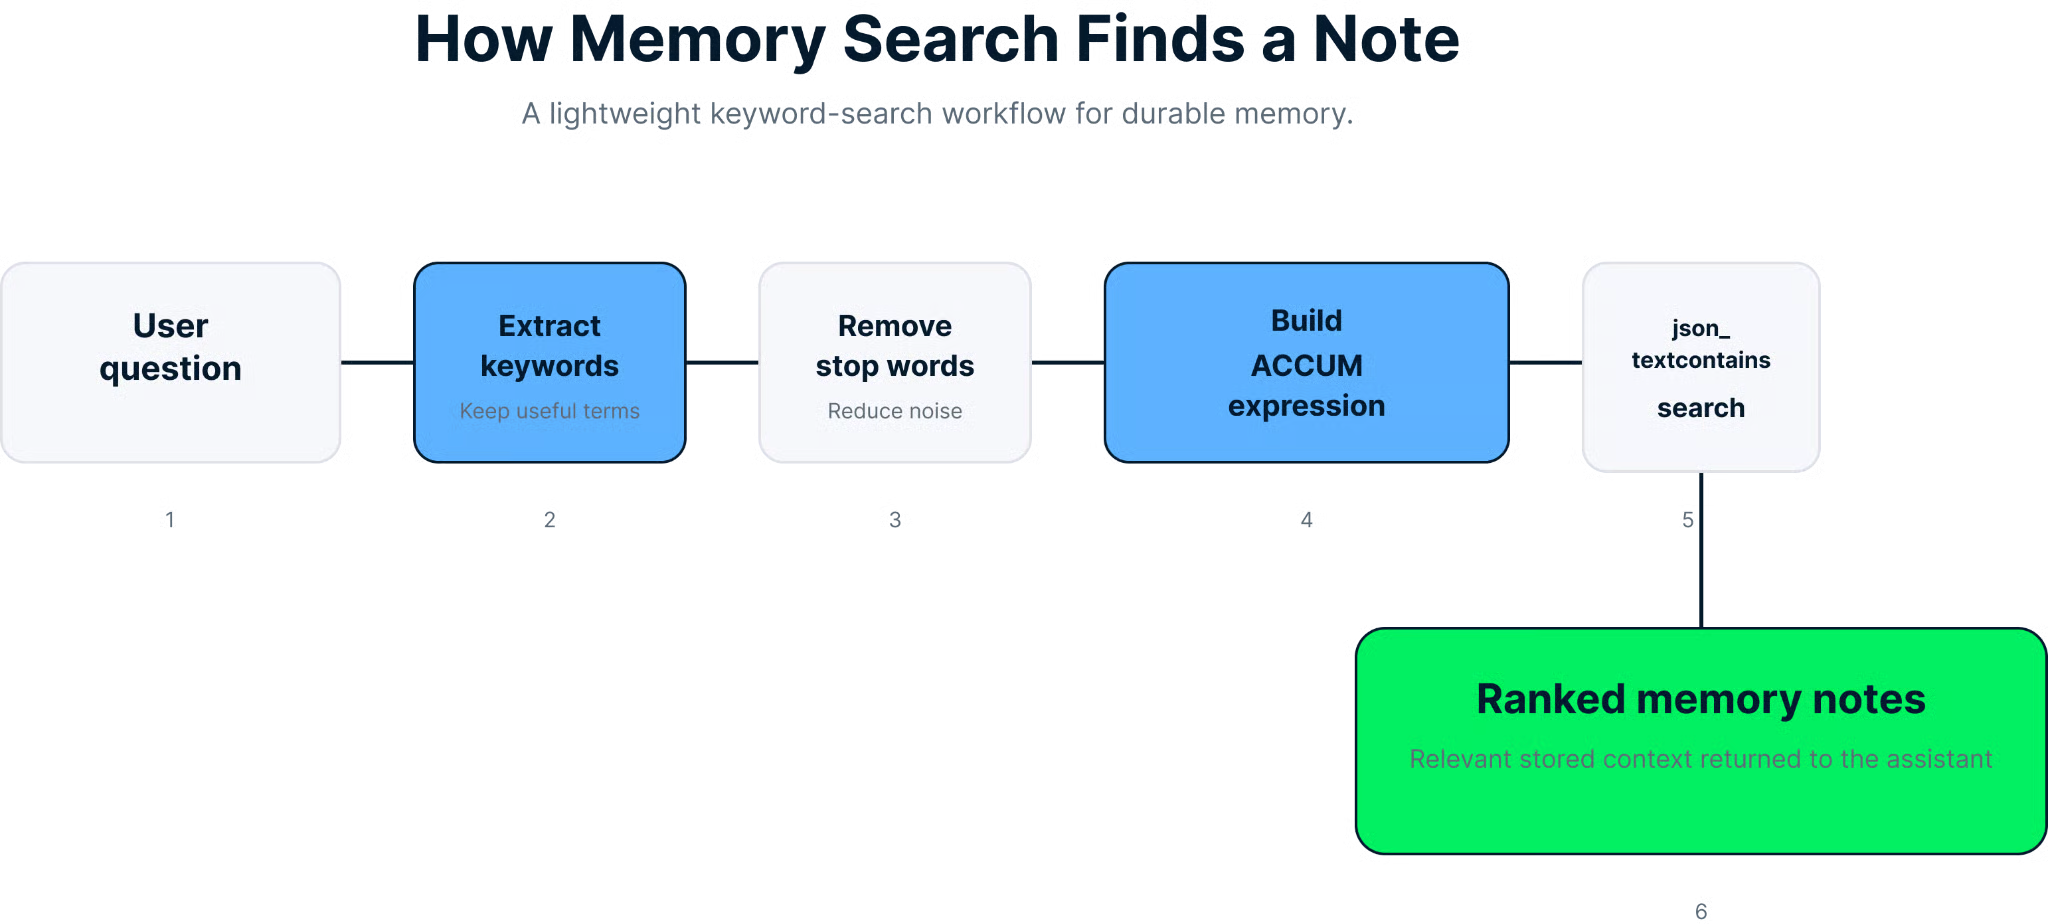
El flujo de búsqueda convierte una pregunta en una expresión de palabras clave y devuelve notas ordenadas por relevancia.
La consulta SQL de búsqueda es:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
Si la pregunta no produce palabras clave útiles, el repositorio recurre a notas recientes. Eso da al agente un valor por defecto razonable en lugar de devolver demasiado pronto una búsqueda vacía.
La aplicación une las piezas con AiServices.builder():
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
Este es el patrón completo en un solo lugar:
Después de eso, el bucle de consola simplemente pasa la entrada del usuario a assistant.chat(input).
La aplicación imprime algunos prompts de inicio:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
Estos prompts son útiles porque ejercitan todo el ciclo de memoria:
Este módulo es deliberadamente acotado, lo que es una ventaja cuando aprendes el patrón. Aun así, conviene tener presentes algunos detalles prácticos.
El prompt del sistema indica al modelo que solo guarde memoria cuando el usuario lo pida explícitamente. Eso ayuda a reducir escrituras accidentales. Si amplías el prompt sin cuidado, el modelo puede empezar a persistir notas de poco valor.
Este repositorio es ideal para notas operativas cortas, recordatorios e identificadores. Aún no es un sistema completo de generación aumentada con recuperación con embeddings, particionado, búsqueda híbrida o reordenamiento.
Para cadenas como IDs de incidencias, números de tickets y referencias de solicitudes de cambio, la recuperación orientada a palabras clave suele ser un mejor punto de partida que la búsqueda semántica. Este ejemplo refleja claramente ese compromiso.
Las pruebas del proyecto son de integración y se ejecutan con Testcontainers. Si Docker no está disponible, mvn test fallará antes de que se ejecute la lógica del repositorio. Eso es un problema de entorno, no necesariamente un bug de la aplicación.
Ejecuta las pruebas con:
# Run the integration tests.
 mvn test
Las pruebas cubren dos comportamientos importantes:
Un error común en proyectos de agentes es añadir almacenamiento vectorial, historial de conversación, resumen y políticas de retrieval todo a la vez. Este ejemplo propone una mejor secuencia:
1. Define un caso de uso concreto de memoria
2. Expón herramientas explícitas
3. Respalda esas herramientas con almacenamiento duradero
4. Verifica el comportamiento de recuperación
5. Solo entonces valora patrones de memoria más avanzados
Si quieres seguir desarrollando habilidades con agentes después de este tutorial, estos recursos de DataCamp son un buen siguiente paso:
Ya has visto cómo crear un agente pequeño pero útil con memoria usando LangChain4j, Java y Oracle AI Database. La idea principal es sencilla: dale al modelo herramientas de memoria explícitas, guarda las notas de forma duradera como JSON y recupéralas con una estrategia de búsqueda directa.
Este diseño es una base sólida porque es fácil de entender y de ampliar. Una vez que este patrón funcione, podrás añadir mejor filtrado, esquemas de notas más ricos, ámbito por usuario o incluso búsqueda vectorial si el caso de uso lo requiere.
Si quieres seguir aprendiendo sobre diseño de agentes, un buen siguiente paso es comparar este patrón de memoria basada en herramientas con frameworks de agentes más amplios y flujos de orquestación. En particular, merece la pena explorar cómo encajan las herramientas explícitas, los patrones de retrieval y los agentes multi‑paso en sistemas de IA más grandes.
Cursos destacados de DataCamp
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Programa} other {Programas}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {Tutorial} other {Tutoriales}}
{count, plural, one {Tutorial} other {Tutoriales}}
Ryan Ong
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Moez Ali
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Zoumana Keita
15 min