{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Oracle SQL
{hours} uur
18.5K
In deze tutorial lopen we door een kleine Java-module die aangepaste tools beschikbaar maakt, notities als JSON opslaat in de Oracle AI Database en ze ophaalt met full-text search.
Als je AI-agents bouwt, is korte chatgeschiedenis meestal niet genoeg. Echte assistenten hebben vaak een beetje duurzame geheugenopslag nodig zodat ze belangrijke feiten kunnen bewaren en later terughalen.
Deze tutorial laat zien hoe je dat patroon bouwt met een minimale Java-module. Je gebruikt LangChain4j-tools, een eenvoudige agentinterface en Oracle AI Database als achterliggende opslag. In plaats van embeddings of een volledige retrieval-pijplijn toe te voegen, houdt dit voorbeeld het ontwerp bewust klein: notities worden opgeslagen als JSON-documenten en doorzocht met Oracle Text.
Aan het einde begrijp je hoe de module dit aan elkaar koppelt:
LangChain4j-agentinterface@Tool-methodenJDBC-repository voor duurzame notitieopslagLangChain4j laat je gewone Java-methoden blootstellen als tools die een model kan aanroepen wanneer het externe mogelijkheden nodig heeft. In deze module zijn die mogelijkheden geheugen-georiënteerd:
searchMemories(String question) vindt relevante opgeslagen notitiesstoreMemory(String note) schrijft een nieuwe, duurzame notitie wegDat is anders dan standaard chatgeschiedenis die chatberichten in een in-memory contextvenster bewaart.
Persistente, toolgebaseerde geheugenopslag beslist wanneer er gezocht of opgeslagen moet worden, en de onderliggende data leeft in een database.
Dit patroon is handig wanneer je een agent feitjes wilt laten onthouden zoals incidentnotities, runbook-herinneringen of opvolgacties zonder te vroeg een grotere retrieval-oplossing te bouwen.
Persistente, database-ondersteunde geheugenopslag kan ook gelijktijdig worden benaderd door één of meer agents zonder dataconflicten.
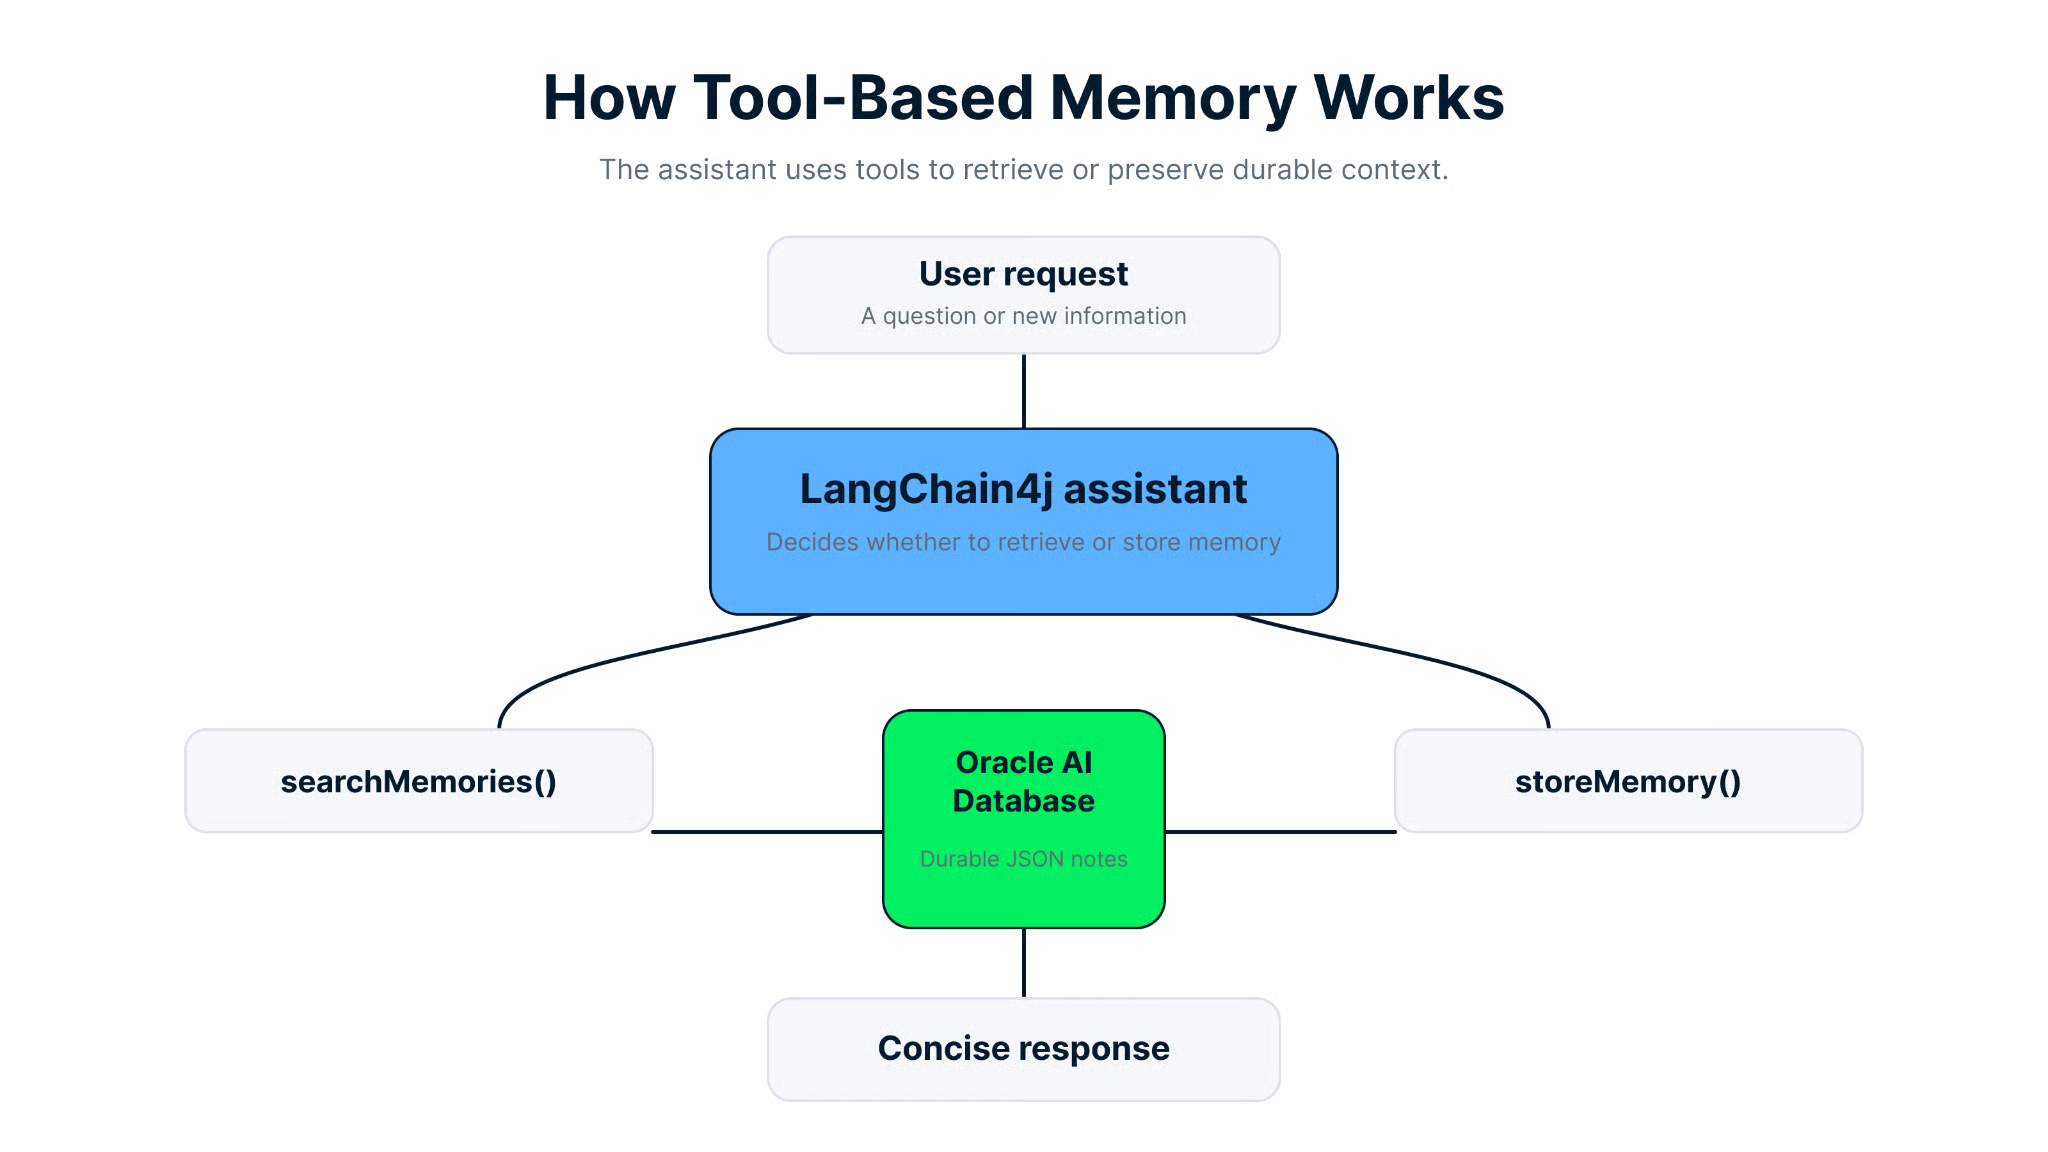
Met toolgebaseerd geheugen kan de assistent bestaande notities ophalen of nieuwe notities opslaan in een duurzame database.
Dit voorbeeld is klein, maar demonstreert verschillende belangrijke ontwerppatronen voor agents.
De klasse MemoryTools stelt twee methoden bloot die zijn geannoteerd met @Tool. Dat betekent dat LangChain4j ze beschikbaar kan maken voor de agent zonder extra wrappercode.
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
Deze methode doet twee handige dingen. Ze delegeert het ophalen aan de repository en formatteert de resultaten op een modelvriendelijke manier zoals [M12] wat notitietekst.
Daardoor kan de agent de tooloutput makkelijk citeren in z'n eindantwoord.
Notities worden opgeslagen in een agent_memories-tabel als native JSON-documenten. Elke rij bevat:
idmemory_doccreated_at-timestampDe module initialiseert het schema automatisch:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
Zo blijft het opslagmodel eenvoudig, terwijl je toch gestructureerde data en door de database beheerde duurzaamheid krijgt.
De repository genereert geen embeddings. In plaats daarvan extraheert hij trefwoorden uit de vraag van de gebruiker, verwijdert stopwoorden, bouwt een Oracle Text-expressie met ACCUM en doorzoekt de JSON-documentinhoud met json_textcontains.
Dat is vooral handig voor identifiers en operationele termen zoals CHG2145, waarbij exacte of bijna-exacte tokenmatching vaak belangrijker is dan semantische gelijkenis.
De klasse Application maakt de repository aan, initialiseert het schema, vult een paar notities, construeert het chatmodel en start een terminallus. Daardoor is het voorbeeld makkelijk te draaien en later aan te passen in een andere service.
Controleer voordat je de module draait of je lokale omgeving aan de projectvereisten voldoet.
Je hebt nodig:
OPENAI_API_KEY Het Maven-project hangt af van:
langchain4jlangchain4j-open-aiojdbc11Testcontainers voor integratietestsStel eerst je OpenAI API-sleutel in:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
Voer daarna de app uit vanuit de projectdirectory:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
De applicatie verwacht precies drie argumenten:
1. JDBC-URL
2. Databasegebruikersnaam
3. Databasewachtwoord
Als die ontbreken, gooit Application.main() een IllegalArgumentException. Als OPENAI_API_KEY ontbreekt, gooit hij een IllegalStateException.
Wanneer de app start, doet hij het volgende:
1. Maakt een MemoryRepository
2. Initialiseert het databaseschema
3. Vult drie voorbeeldnotities als de tabel leeg is
4. Bouwt een OpenAiChatModel
5. Verbindt het model en de tools met AiServices
6. Start een CLI-lus die invoer leest totdat je exit typt
Dat betekent dat je geheugenophalen meteen kunt proberen zonder eerst handmatig rijen in te voegen.
Laten we nu de module doorlopen in dezelfde volgorde als de applicatie hem gebruikt.
LangChain4j gebruikt een Java-interface om het agentcontract te beschrijven. In dit project is die interface MemoryAssistant.
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
Het belangrijkste is het system-bericht. Dat vertelt het model wanneer het elke tool moet gebruiken:
Dat is een goed voorbeeld van een lichtgewicht toolbeleid. De prompt is kort, maar specifiek genoeg om toolselectie te sturen.
De agent praat niet direct met de repository. In plaats daarvan roept hij de laag MemoryTools aan.
Hier is de opslagmethode:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
Dit is bewust beknopt. Een gebruiker zou kunnen zeggen:
Remember that the next shift should verify the checkout retry queue stays below 50.Als het model de system-prompt correct volgt, roept het storeMemory() aan, slaat de repository de notitie op en geeft de tool iets terug als:
Stored memory M4.Later kan de gebruiker vragen:
What should the next shift verify?Op dat moment kan de agent searchMemories() aanroepen en de teruggegeven notitie gebruiken om te antwoorden.
In de repository zit het grootste deel van de logica voor duurzaam geheugen. Het is nog steeds gewone JDBC, wat het ontwerp makkelijk te doorgronden maakt.
Op hoofdlijnen is MemoryRepository verantwoordelijk voor:
Oracle Text-zoekopdrachtenHet insert-pad normaliseert en valideert notitietekst voordat die wordt opgeslagen:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
Het JSON-document zelf ziet er zo uit:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
Die structuur is simpel, maar genoeg voor zowel persistentie als tekstzoekopdrachten.
Het interessantste deel van de repository is de methode search():
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
Deze methode volgt een praktische flow:
1. Tokenize de vraag van de gebruiker
2. Zet de tokens in lowercase
3. Verwijder stopwoorden zoals the, what en remember
4. Behoud betekenisvolle korte tokens wanneer ze cijfers bevatten
5. Bouw een Oracle Text-expressie met ACCUM
6. Doorzoek de JSON-data met json_textcontains
Dat detail “cijfers zijn toegestaan” is belangrijk. Het helpt termen zoals CHG2145 de trefwoordextractie te overleven — precies het soort identifier-rijke lookup dat veel operationele agents nodig hebben.
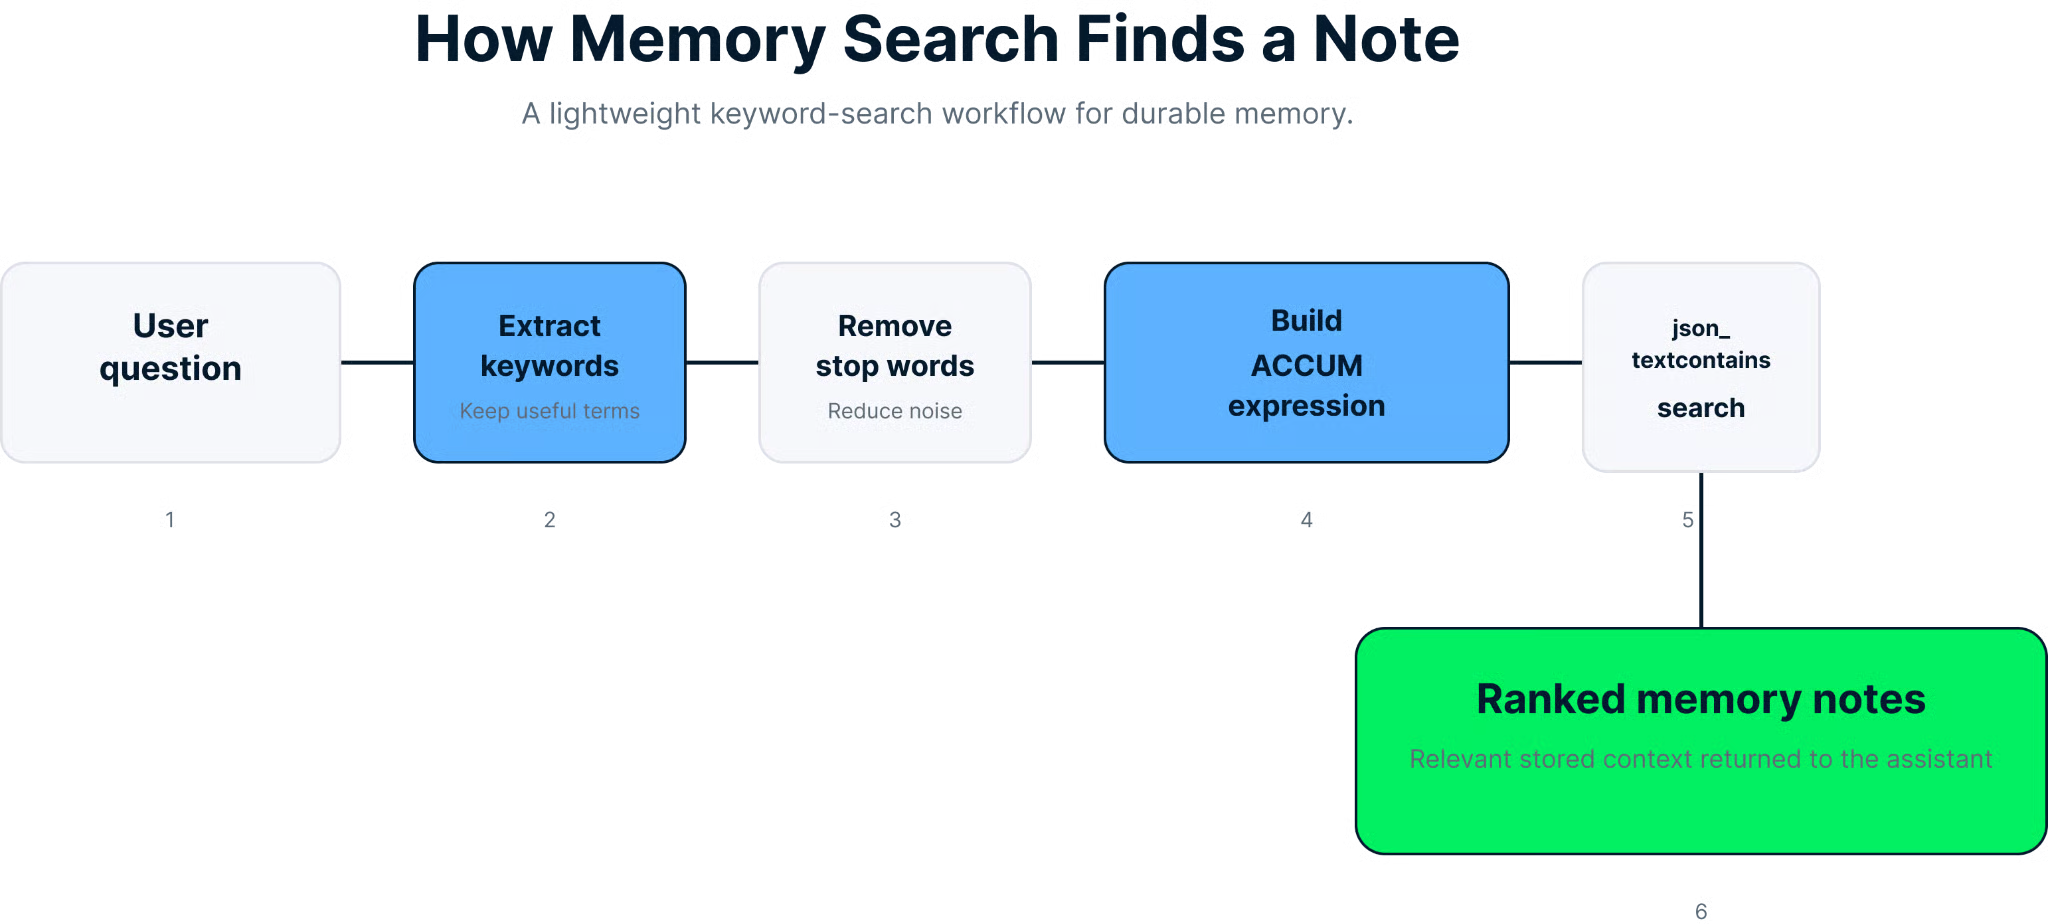
De zoekworkflow zet een vraag om in een trefwoordexpressie en geeft gerankte geheugennotities terug.
De SQL-zoekquery is:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
Als de vraag geen bruikbare trefwoorden oplevert, valt de repository terug op recente notities. Dat geeft de agent een redelijk default in plaats van te vroeg een lege zoekopdracht terug te geven.
De applicatie verbindt de onderdelen met AiServices.builder():
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
Dit is het volledige patroon op één plek:
Daarna geeft de consolelus simpelweg gebruikersinvoer door aan assistant.chat(input).
De applicatie print een paar starters:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
Deze prompts zijn handig omdat ze de volledige geheugenlevenscyclus oefenen:
Deze module is bewust smal, wat een kracht is wanneer je het patroon leert. Toch zijn er een paar praktische details om in gedachten te houden.
De system-prompt vertelt het model om alleen geheugen op te slaan wanneer de gebruiker daar expliciet om vraagt. Dat helpt onbedoelde writes te verminderen. Als je de prompt onzorgvuldig verbreedt, kan het model beginnen met het bewaren van laagwaardige notities.
Deze repository is het best voor korte operationele notities, herinneringen en identifiers. Het is nog geen volledige retrieval-augmented generation-oplossing met embeddings, chunking, hybride zoekopdrachten of ranking.
Voor strings zoals incident-ID’s, ticketnummers en change request-verwijzingen is trefwoordgeoriënteerde retrieval vaak een beter startpunt dan semantische zoekopdrachten. Dit voorbeeld weerspiegelt die afweging duidelijk.
De tests van het project zijn integratietests die worden aangedreven door Testcontainers. Als Docker niet beschikbaar is, zal mvn test falen voordat de repositorylogica draait. Dat is een omgevingsprobleem, niet per se een bug in de applicatie.
Voer de tests uit met:
# Run the integration tests.
 mvn test
De tests dekken twee belangrijke gedragingen:
Een veelgemaakte fout in agentprojecten is om vectoropslag, conversatiegeschiedenis, samenvattingen en retrievalbeleid allemaal tegelijk toe te voegen. Dit voorbeeld laat een betere opbouw zien:
1. Definieer een concreet geheugengebruiksscenario
2. Stel expliciete tools bloot
3. Ondersteun die tools met duurzame opslag
4. Verifieer het retrieval-gedrag
5. Overweeg pas daarna meer geavanceerde geheugenpatronen
Wil je na deze tutorial verder bouwen aan agentvaardigheden, dan zijn deze DataCamp-bronnen een goede volgende stap:
Je hebt nu gezien hoe je een kleine maar nuttige agent met geheugen bouwt met LangChain4j, Java en Oracle AI Database. Het kernidee is simpel: geef het model expliciete geheugentools, sla notities duurzaam op als JSON en haal ze op met een eenvoudige zoekstrategie.
Dit ontwerp is een sterke basis omdat het makkelijk te begrijpen en uit te breiden is. Als dit patroon werkt, kun je betere filtering, rijkere notitieschema’s, gebruikersafbakening of zelfs vector search toevoegen als het gebruiksscenario daarom vraagt.
Wil je meer leren over agentontwerp, vergelijk dit toolgebaseerde geheugenpatroon dan met bredere agentframeworks en orkestratieworkflows. Het is met name de moeite waard om te verkennen hoe expliciete tools, retrievalpatronen en multi-step agents samenkomen in grotere AI-systemen.
Top DataCamp Courses
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

