Last chance! 50% off DataCamp Premium
Sale ends in
In questo tutorial, vedremo un piccolo modulo Java che espone strumenti personalizzati, salva note come JSON in Oracle AI Database e le recupera con la ricerca full-text.
Se stai creando agenti AI, la cronologia chat a breve termine di solito non basta. Gli assistenti reali spesso hanno bisogno di una piccola quantità di memoria durevole per archiviare fatti importanti e recuperarli in seguito.
Questo tutorial mostra come creare questo pattern con un modulo Java minimale. Userai gli strumenti LangChain4j, una semplice interfaccia dell'agente e Oracle AI Database come archivio di supporto. Invece di aggiungere embedding o una pipeline completa di retrieval, questo esempio mantiene il design volutamente essenziale: le note vengono salvate come documenti JSON e cercate con Oracle Text.
Alla fine, capirai come il modulo collega:
LangChain4j @ToolJDBC per l'archiviazione durevole delle noteLangChain4j ti permette di esporre normali metodi Java come strumenti che un modello può chiamare quando ha bisogno di capacità esterne. In questo modulo, tali capacità sono orientate alla memoria:
searchMemories(String question) trova note salvate rilevantistoreMemory(String note) scrive una nuova nota durevoleQuesto è diverso dalla classica cronologia chat, che memorizza i messaggi in una finestra di contesto in memoria.
La memoria persistente basata su strumenti decide quando deve cercare o salvare note, e i dati sottostanti vivono in un database.
Questo pattern è utile quando vuoi che un agente ricordi fatti come note sugli incidenti, promemoria di runbook o azioni di follow-up, senza costruire troppo presto un sistema di retrieval più grande.
La memoria persistente supportata da database può anche essere accessibile in parallelo da uno o più agenti senza contesa sui dati.
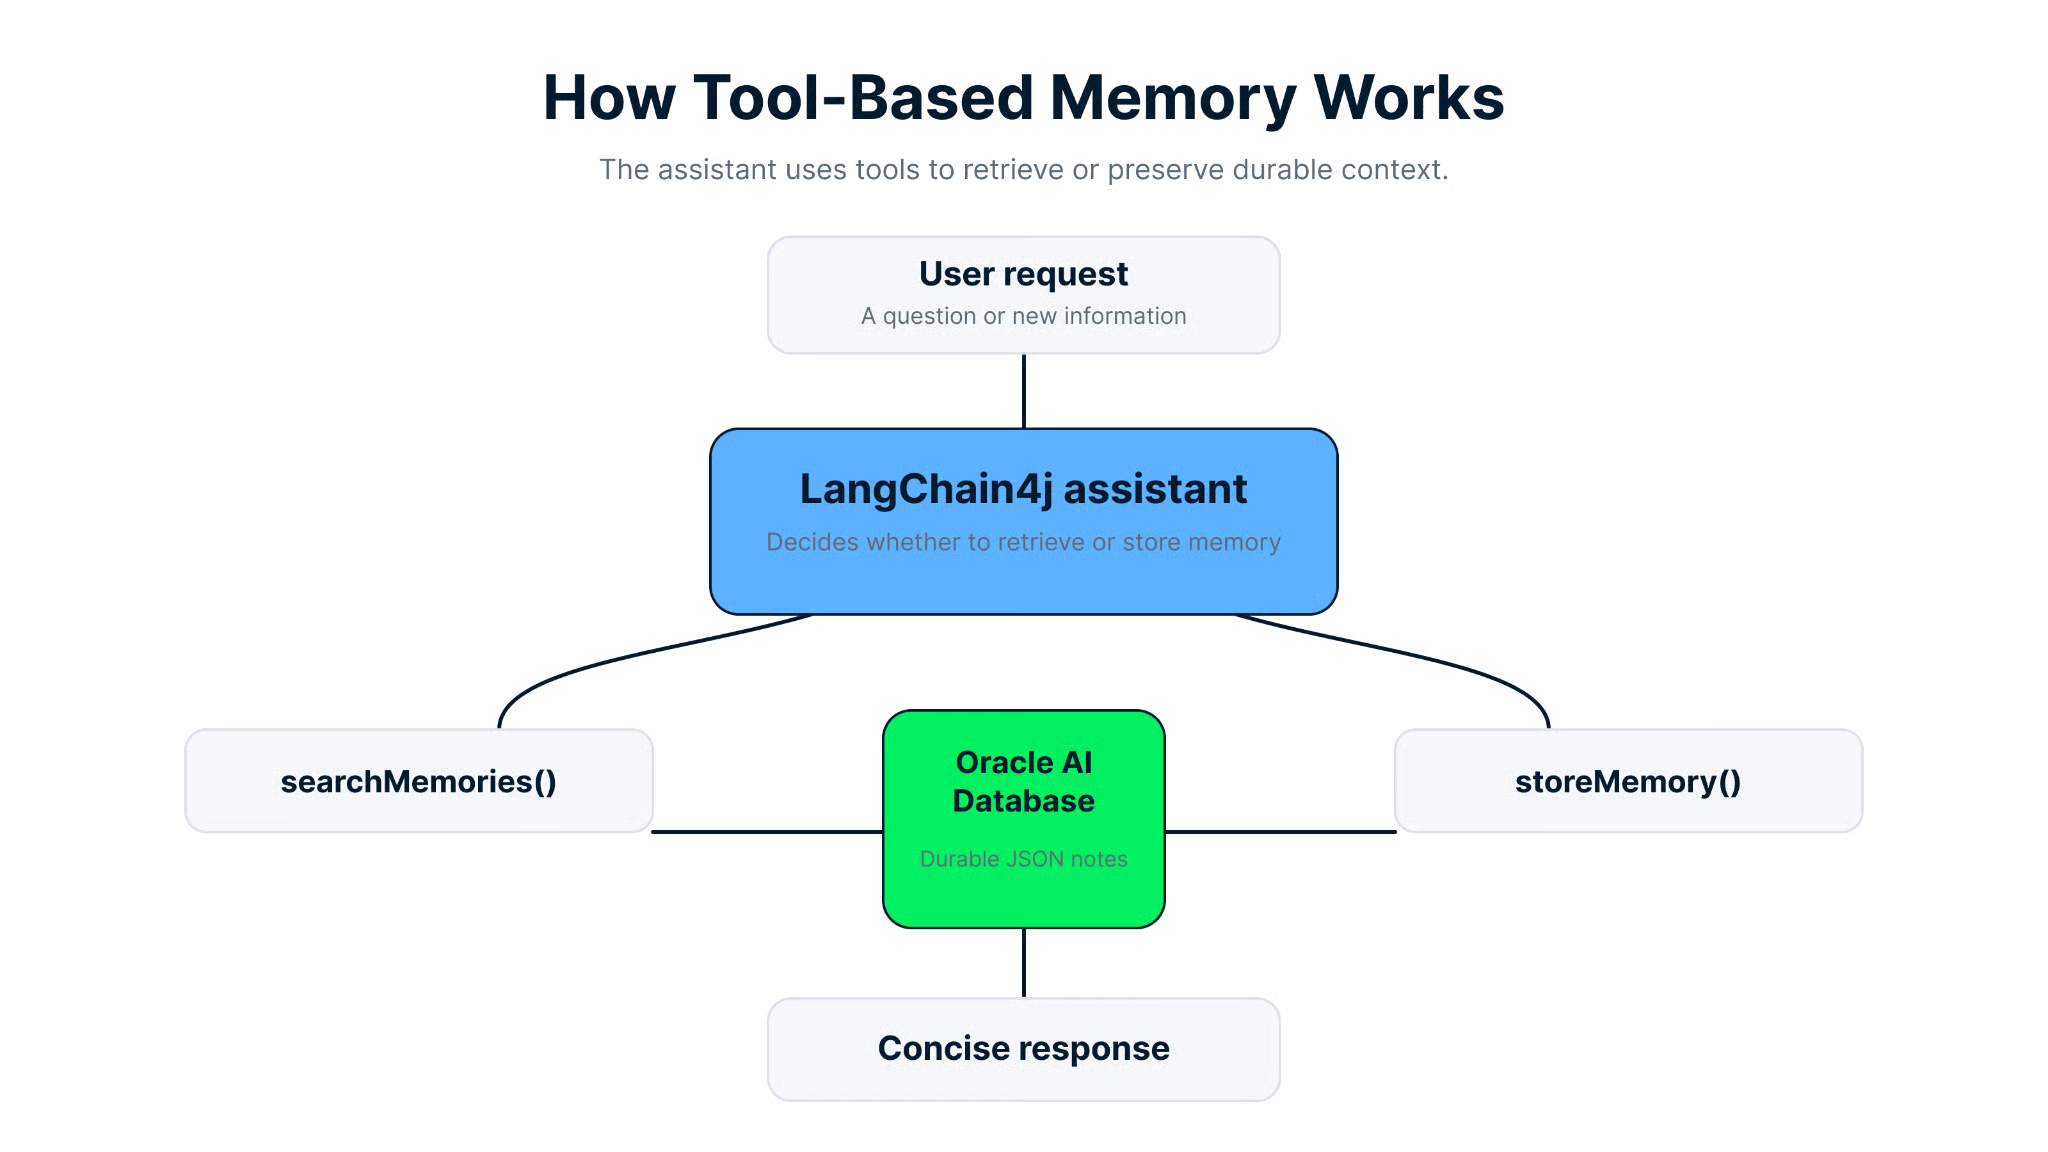
La memoria basata su strumenti consente all'assistente di recuperare note esistenti o di salvarne di nuove in un database durevole.
Questo esempio è piccolo, ma dimostra diverse idee importanti di design degli agenti.
La classe MemoryTools espone due metodi annotati con @Tool. Ciò significa che LangChain4j può renderli disponibili all'agente senza codice wrapper aggiuntivo.
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
Questo metodo fa due cose utili. Delega il recupero al repository e formatta i risultati in un modo adatto al modello, ad esempio [M12] testo della nota.
Questo rende l'output dello strumento facile da citare nella risposta finale dell'agente.
Le note sono archiviate in una tabella agent_memories come documenti JSON nativi. Ogni riga contiene:
idmemory_doccreated_atIl modulo inizializza automaticamente lo schema:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
Questo mantiene il modello di archiviazione semplice, offrendo comunque dati strutturati e durabilità gestita dal database.
Il repository non genera embedding. Invece, estrae parole chiave dalla domanda dell'utente, rimuove le stop word, costruisce un'espressione Oracle Text con ACCUM e cerca il contenuto del documento JSON con json_textcontains.
Questo è particolarmente utile per identificatori e termini operativi come CHG2145, dove la corrispondenza esatta o quasi esatta dei token conta spesso più della somiglianza semantica.
La classe Application crea il repository, inizializza lo schema, inserisce alcune note di esempio, costruisce il modello di chat e avvia un loop da terminale. Questo rende l'esempio facile da eseguire e da adattare in un altro servizio in seguito.
Prima di eseguire il modulo, assicurati che il tuo ambiente locale rispetti i requisiti del progetto.
Ti servono:
OPENAI_API_KEYIl progetto Maven dipende da:
langchain4jlangchain4j-open-aiojdbc11Testcontainers per i test di integrazioneImposta prima la tua chiave API OpenAI:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
Poi esegui l'app dalla directory del progetto:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
L'applicazione si aspetta esattamente tre argomenti:
1. JDBC URL
2. Username del database
3. Password del database
Se mancano, Application.main() genera una IllegalArgumentException. Se OPENAI_API_KEY manca, genera una IllegalStateException.
Quando l'app parte, esegue:
1. Crea un MemoryRepository
2. Inizializza lo schema del database
3. Popola tre note di esempio se la tabella è vuota
4. Costruisce un OpenAiChatModel
5. Collega modello e strumenti in AiServices
6. Avvia un loop CLI che legge l'input finché non digiti exit
Questo significa che puoi provare subito il recupero della memoria senza inserire manualmente righe in anticipo.
Ora percorriamo il modulo nello stesso ordine usato dall'applicazione.
LangChain4j usa un'interfaccia Java per descrivere il contratto dell'agente. In questo progetto, quell'interfaccia è MemoryAssistant.
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
La parte importante è il messaggio di sistema. Dice al modello quando usare ogni strumento:
Questo è un buon esempio di policy leggera sugli strumenti. Il prompt è breve, ma abbastanza specifico da guidare la selezione degli strumenti.
L'agente non parla direttamente con il repository. Invece, chiama il layer MemoryTools.
Ecco il metodo di archiviazione:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
Questo è volutamente compatto. Un utente potrebbe dire:
Remember that the next shift should verify the checkout retry queue stays below 50.Se il modello segue correttamente il prompt di sistema, chiama storeMemory(), il repository persiste la nota e lo strumento restituisce qualcosa come:
Stored memory M4.In seguito, l'utente può chiedere:
What should the next shift verify?A quel punto, l'agente può chiamare searchMemories() e usare la nota restituita per rispondere.
Il repository è dove vive la maggior parte della logica di memoria durevole. È comunque semplice JDBC, il che rende il design facile da ispezionare.
A livello alto, MemoryRepository è responsabile di:
Oracle Text searchIl percorso di inserimento normalizza e valida il testo della nota prima di archiviarlo:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
Il documento JSON in sé appare così:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
Questa struttura è semplice, ma sufficiente a supportare sia la persistenza sia la ricerca testuale.
La parte più interessante del repository è il metodo search():
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
Questo metodo segue un flusso pratico:
1. Tokenizza la domanda dell'utente
2. Converte in minuscolo i token
3. Rimuove le stop word come the, what e remember
4. Mantiene token brevi ma significativi quando includono cifre
5. Costruisce un'espressione Oracle Text con ACCUM
6. Cerca i dati JSON con json_textcontains
Quel dettaglio “sono ammesse le cifre” è importante. Aiuta termini come CHG2145 a sopravvivere all'estrazione delle parole chiave, esattamente il tipo di lookup ricco di identificatori di cui molti agenti operativi hanno bisogno.
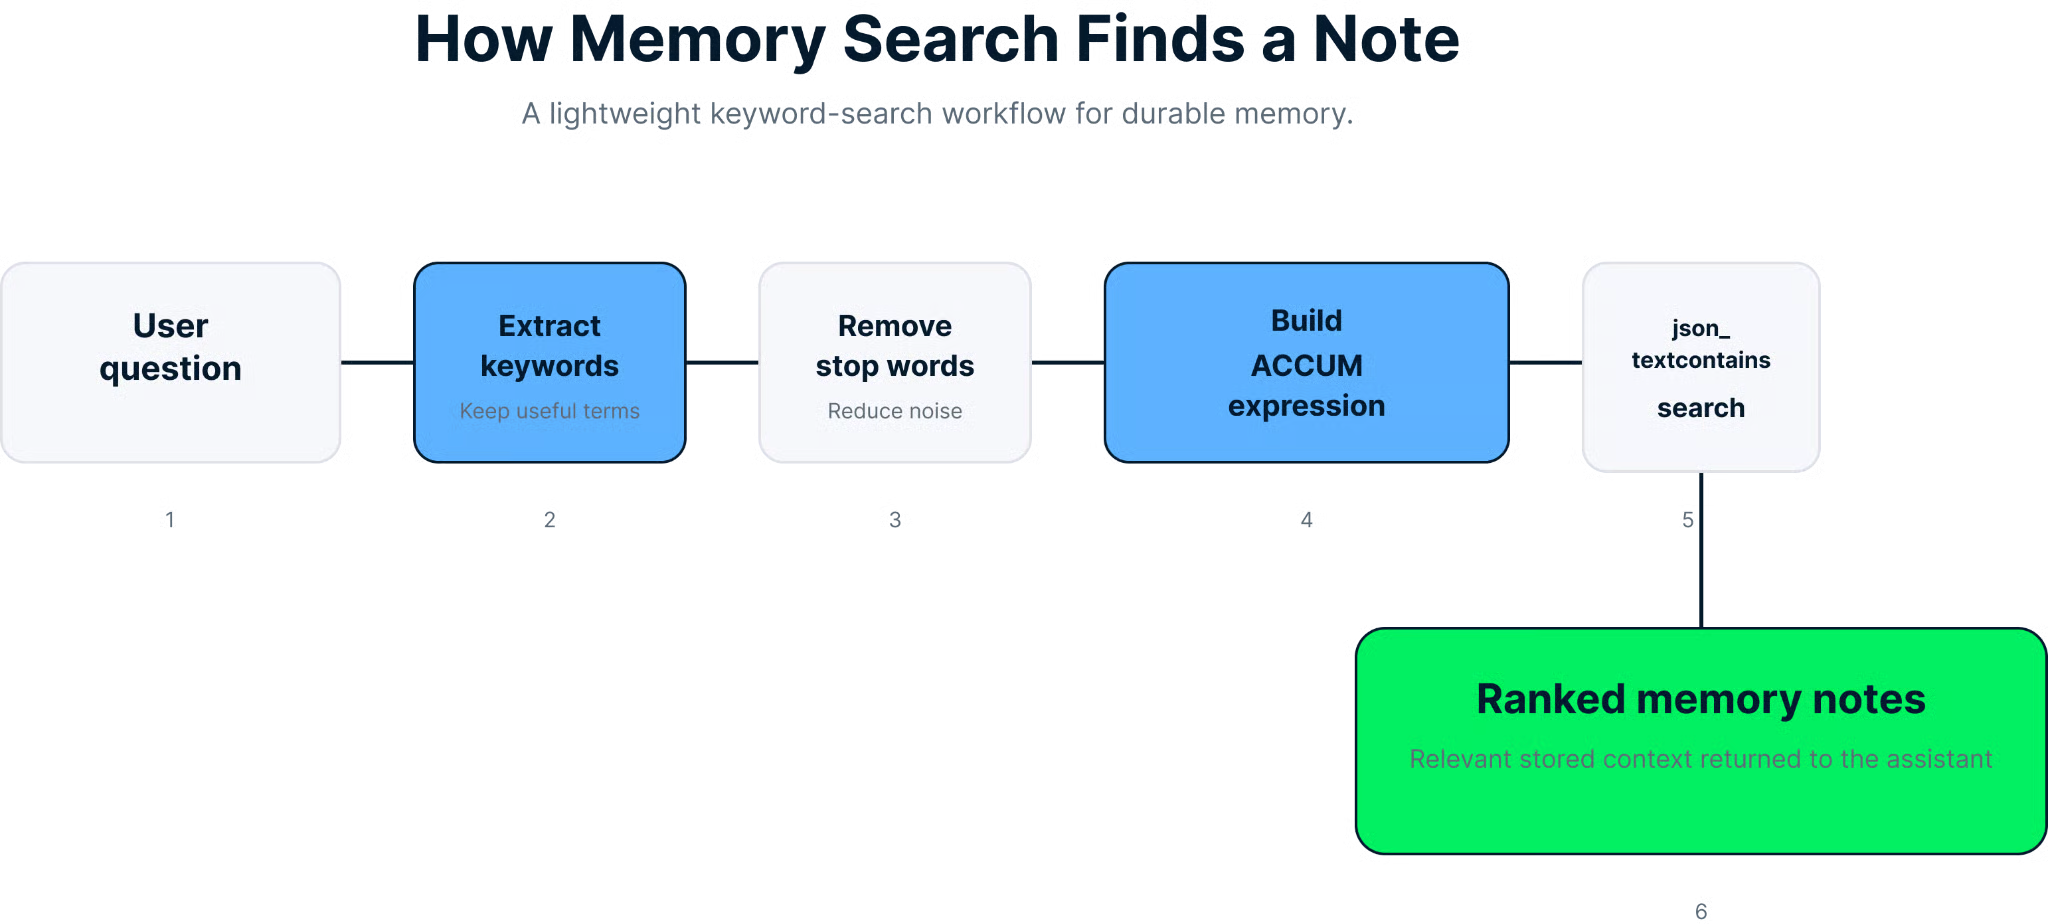
Il workflow di ricerca converte una domanda in un'espressione di parole chiave e restituisce note di memoria classificate.
La query SQL di ricerca è:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
Se la domanda non produce parole chiave utili, il repository ripiega sulle note recenti. Questo dà all'agente un default ragionevole invece di restituire troppo presto una ricerca vuota.
L'applicazione collega i pezzi con AiServices.builder():
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
Questo è l'intero pattern in un unico punto:
Dopo di che, il loop da console passa semplicemente l'input utente a assistant.chat(input).
L'applicazione stampa alcuni prompt iniziali:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
Questi prompt sono utili perché esercitano l'intero ciclo di vita della memoria:
Questo modulo è volutamente ristretto, il che è un punto di forza quando impari il pattern. Ci sono comunque alcuni dettagli pratici da tenere a mente.
Il prompt di sistema dice al modello di salvare la memoria solo quando l'utente lo chiede esplicitamente. Questo aiuta a ridurre le scritture accidentali. Se ampli il prompt senza attenzione, il modello potrebbe iniziare a persistere note di scarso valore.
Questo repository è ideale per brevi note operative, promemoria e identificatori. Non è ancora un sistema completo di retrieval-augmented generation con embedding, chunking, ricerca ibrida o ranking.
Per stringhe come ID di incidenti, numeri di ticket e riferimenti a richieste di modifica, un retrieval orientato alle parole chiave è spesso un punto di partenza migliore rispetto alla ricerca semantica. Questo esempio riflette chiaramente questo trade-off.
I test del progetto sono test di integrazione alimentati da Testcontainers. Se Docker non è disponibile, mvn test fallirà prima che venga eseguita la logica del repository. Si tratta di un problema di ambiente, non necessariamente di un bug dell'applicazione.
Esegui i test con:
# Run the integration tests.
 mvn test
I test coprono due comportamenti importanti:
Un errore comune nei progetti di agenti è aggiungere archiviazione vettoriale, cronologia conversazioni, sintesi e policy di retrieval tutte insieme. Questo esempio mostra una progressione migliore:
1. Definisci un caso d'uso concreto per la memoria
2. Espone strumenti espliciti
3. Supporta quegli strumenti con storage durevole
4. Verifica il comportamento di retrieval
5. Solo dopo valuta pattern di memoria più avanzati
Se vuoi continuare a sviluppare competenze sugli agenti dopo questo tutorial, queste risorse DataCamp sono un buon passo successivo:
Hai visto come creare un agente piccolo ma utile, abilitato alla memoria, con LangChain4j, Java e Oracle AI Database. L'idea centrale è semplice: fornisci al modello strumenti di memoria espliciti, salva le note in modo durevole come JSON e recuperale con una strategia di ricerca lineare.
Questo design è una base solida perché è facile da capire e da estendere. Una volta che questo pattern funziona, puoi aggiungere filtri migliori, schemi di note più ricchi, scoping per utente o persino la ricerca vettoriale se il caso d'uso lo richiede.
Se vuoi continuare a imparare il design degli agenti, il prossimo buon passo è confrontare questo pattern di memoria basato su strumenti con framework di agenti più ampi e workflow di orchestrazione. In particolare, vale la pena esplorare come strumenti espliciti, pattern di retrieval e agenti multi-step si integrano in sistemi AI più grandi.
Corsi DataCamp in evidenza
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min