कोर्स
Oracle SQL परिचय
4 घंटा
18.5K
इस ट्यूटोरियल में, हम एक छोटा सा Java मॉड्यूल देखेंगे जो कस्टम टूल एक्सपोज़ करता है, नोट्स को JSON के रूप में Oracle AI Database में स्टोर करता है, और उन्हें फुल-टेक्स्ट सर्च से प्राप्त करता है।
यदि आप AI एजेंट बना रहे हैं, तो अल्पकालिक चैट हिस्ट्री प्रायः पर्याप्त नहीं होती। वास्तविक सहायक को अक्सर थोड़ी-सी टिकाऊ मेमोरी चाहिए होती है ताकि वे महत्वपूर्ण तथ्यों को सहेज सकें और बाद में उन्हें पुनः प्राप्त कर सकें।
यह ट्यूटोरियल दिखाता है कि एक न्यूनतम Java मॉड्यूल से यह पैटर्न कैसे बनाया जाए। आप LangChain4j टूल्स, एक सरल एजेंट इंटरफ़ेस, और बैकिंग स्टोर के रूप में Oracle AI Database का उपयोग करेंगे। एंबेडिंग या पूर्ण रिट्रीवल पाइपलाइन जोड़ने के बजाय, यह सैंपल डिज़ाइन को जानबूझकर छोटा रखता है: नोट्स को JSON डॉक्यूमेंट्स के रूप में सेव किया जाता है और Oracle Text से खोजा जाता है।
अंत तक, आप समझेंगे कि मॉड्यूल इन चीज़ों को कैसे आपस में जोड़ता है:
LangChain4j एजेंट इंटरफ़ेस@Tool मेथड्सJDBC रिपॉजिटरीLangChain4j आपको सामान्य Java मेथड्स को टूल्स के रूप में एक्सपोज़ करने देता है जिन्हें मॉडल बाहरी क्षमताओं की आवश्यकता होने पर कॉल कर सकता है। इस मॉड्यूल में, वे क्षमताएँ मेमोरी-केंद्रित हैं:
searchMemories(String question) प्रासंगिक सहेजे गए नोट्स ढूंढता हैstoreMemory(String note) नया टिकाऊ नोट लिखता हैयह मानक चैट हिस्ट्री से अलग है जो चैट संदेशों को इन-मेमाेरी कॉन्टेक्स्ट विंडो में स्टोर करती है।
स्थायी टूल-आधारित मेमोरी यह तय करती है कि कब उसे खोज करनी है या नोट्स स्टोर करने हैं, और आधारभूत डेटा डेटाबेस में रहता है।
यह पैटर्न तब उपयोगी है जब आप चाहते हैं कि एजेंट घटना-सम्बंधी नोट्स, रनबुक रिमाइंडर्स, या फॉलो-अप कार्रवाइयों जैसी बातों को याद रखे—बिना बहुत जल्दी बड़ा रिट्रीवल सिस्टम बनाए।
स्थायी, डेटाबेस-समर्थित मेमोरी को एक या अधिक एजेंट साथ-साथ एक्सेस कर सकते हैं, बिना डेटा कंटेंशन के।
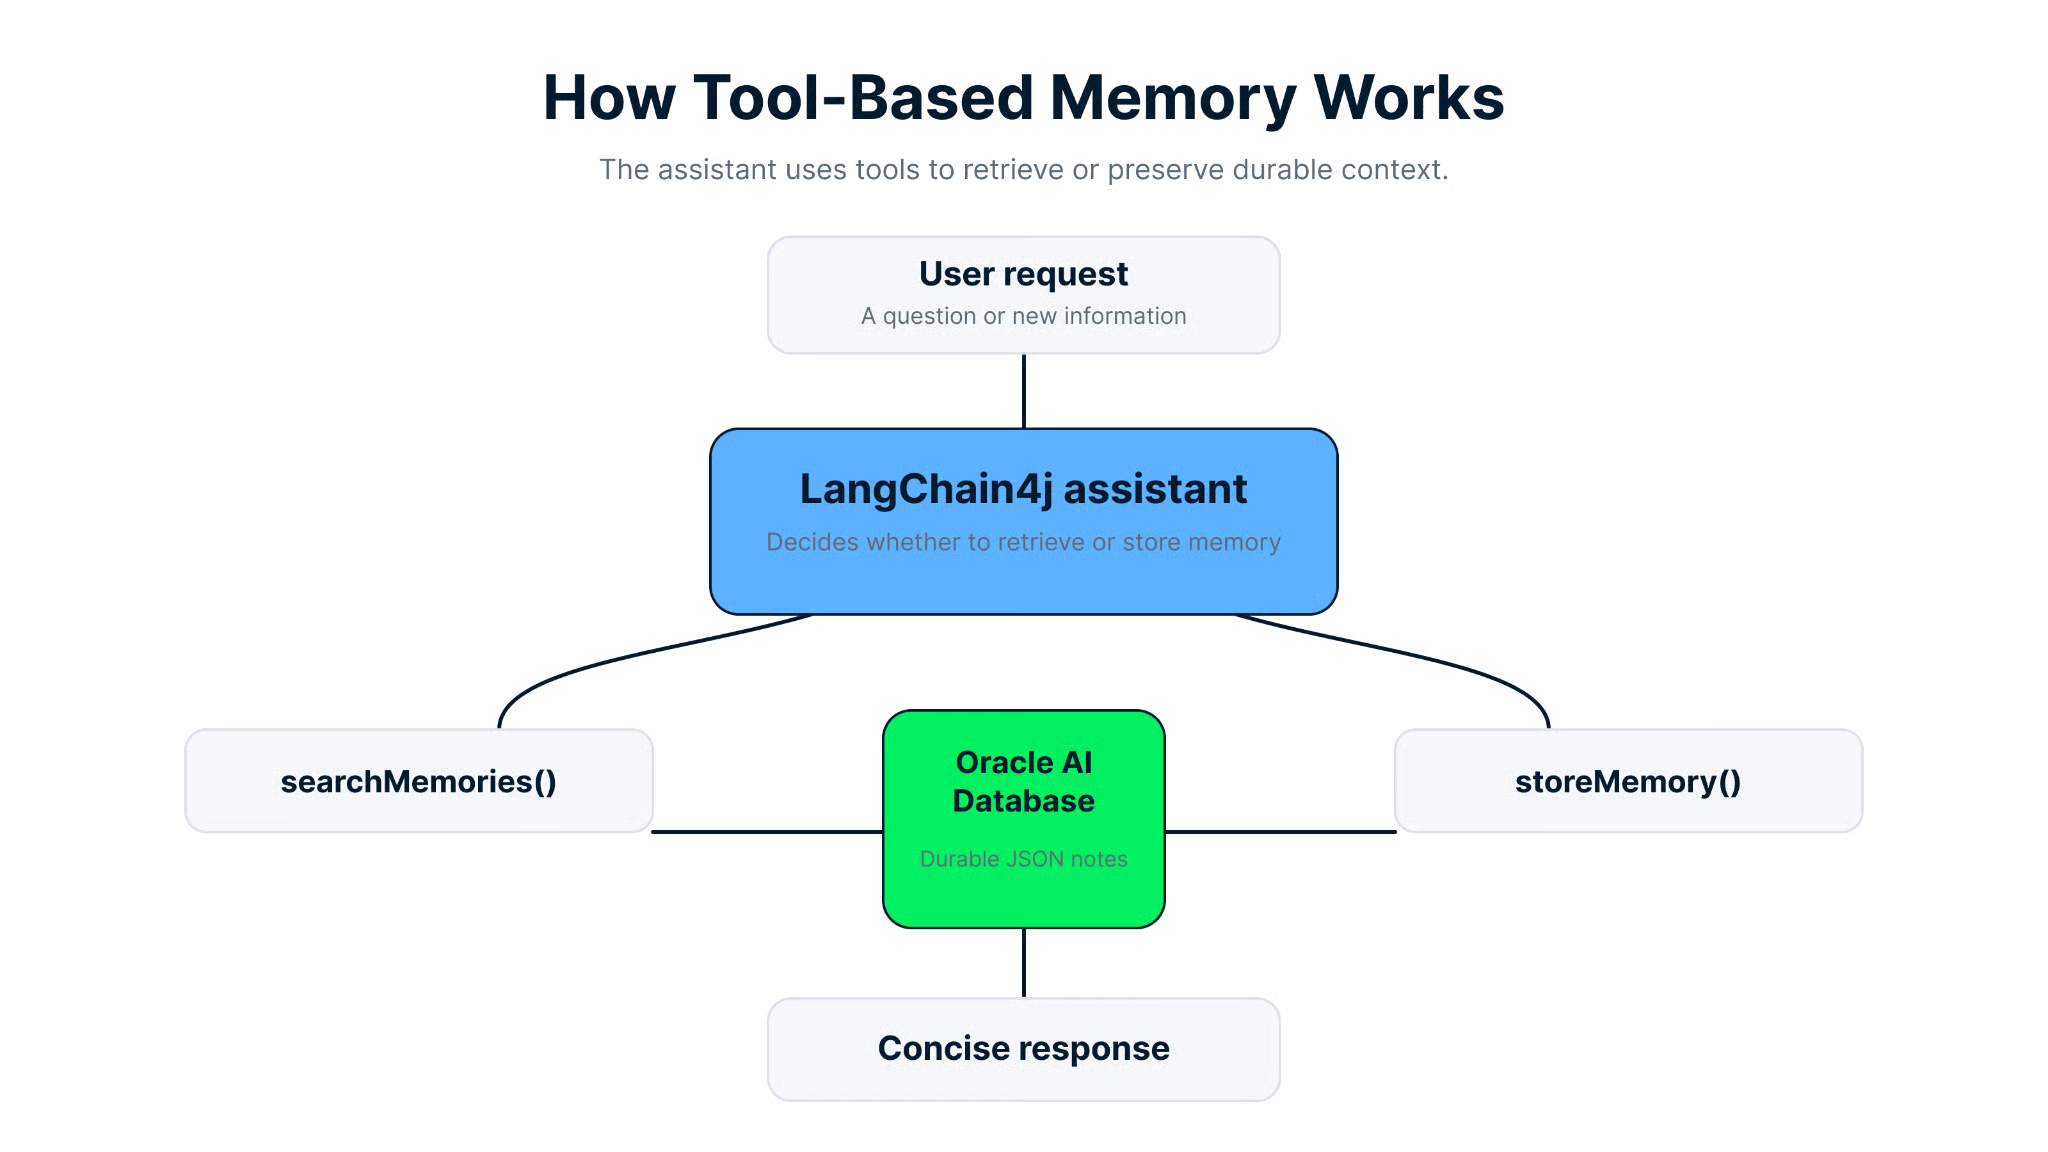
टूल-आधारित मेमोरी सहायक को मौजूदा नोट्स प्राप्त करने या नए नोट्स को एक टिकाऊ डेटाबेस में स्टोर करने देती है।
यह सैंपल छोटा है, लेकिन यह कई महत्वपूर्ण एजेंट डिज़ाइन विचारों को दर्शाता है।
क्लास MemoryTools दो मेथड्स एक्सपोज़ करता है जिन पर @Tool एनोटेशन लगा है। इसका अर्थ है कि LangChain4j उन्हें अतिरिक्त रैपर कोड के बिना एजेंट के लिए उपलब्ध करा सकता है।
// Retrieve relevant notes and format them for the assistant.
 @Tool(
     	"Search saved memory notes when earlier context might help answer the user."
 )
 public String searchMemories(String question) {
 	List<MemoryRepository.Note> matches = repository.search(question, 3);
 	if (matches.isEmpty()) {
     	return "No saved memory matched that question.";
 	}

 	StringBuilder builder = new StringBuilder();
 	for (int i = 0; i < matches.size(); i++) {
     	MemoryRepository.Note note = matches.get(i);
     	builder.append(i + 1)
             	.append(". [M")
             	.append(note.id())
             	.append("] ")
             	.append(note.text());
     	if (i + 1 < matches.size()) {
         	builder.append('\n');
     	}
 	}
 	return builder.toString();
 }
यह मेथड दो उपयोगी काम करता है। यह रिट्रीवल को रिपॉजिटरी को सौंपता है, और परिणामों को मॉडल-अनुकूल तरीके से फॉर्मेट करता है जैसे [M12] some note text।
इससे टूल आउटपुट को एजेंट के लिए अपनी अंतिम प्रतिक्रिया में उद्धृत करना आसान हो जाता है।
नोट्स को agent_memories टेबल में नैटिव JSON डॉक्यूमेंट्स के रूप में स्टोर किया जाता है। प्रत्येक पंक्ति में होता है:
idmemory_doc हैcreated_at टाइमस्टैम्पमॉड्यूल स्कीमा को अपने-आप इनिशियलाइज़ करता है:
-- Create a JSON-backed table for durable agent notes.
 CREATE TABLE IF NOT EXISTS agent_memories (
 	id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
 	memory_doc JSON NOT NULL,
 	created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP NOT NULL
 )
यह स्टोरेज मॉडल को सरल रखता है, जबकि आपको स्ट्रक्चर्ड डेटा और डेटाबेस-प्रबंधित टिकाऊपन देता है।
रिपॉजिटरी एंबेडिंग्स जनरेट नहीं करती। इसके बजाय, यह उपयोगकर्ता के प्रश्न से कीवर्ड्स निकालती है, स्टॉप वर्ड्स हटाती है, ACCUM के साथ एक Oracle Text एक्सप्रेशन बनाती है, और json_textcontains से JSON डॉक्यूमेंट सामग्री सर्च करती है।
यह पहचानकर्ताओं और ऑपरेशनल टर्म्स जैसे CHG2145 के लिए खास तौर पर सहायक है, जहाँ सटीक या लगभग-सटीक टोकन-मिलान अक्सर सिमेंटिक समानता से ज़्यादा मायने रखता है।
क्लास Application रिपॉजिटरी बनाती है, स्कीमा इनिशियलाइज़ करती है, कुछ नोट्स सीड करती है, चैट मॉडल बनाती है, और एक टर्मिनल लूप शुरू करती है। इससे उदाहरण चलाना आसान हो जाता है और बाद में किसी अन्य सर्विस में रूपांतरित करना भी।
मॉड्यूल चलाने से पहले, सुनिश्चित करें कि आपका लोकल वातावरण प्रोजेक्ट की आवश्यकताओं से मेल खाता है।
आपको चाहिए:
OPENAI_API_KEY वातावरण चरMaven प्रोजेक्ट निर्भर करता है:
langchain4jlangchain4j-open-aiojdbc11Testcontainersसबसे पहले अपना OpenAI API कुंजी सेट करें:
# Set the API key used by the chat model.
 export OPENAI_API_KEY=<your key>
फिर प्रोजेक्ट डायरेक्टरी से ऐप चलाएँ:
# Compile and run the sample with the database connection details.
 mvn compile exec:java \
     -Dexec.args="jdbc:oracle:thin:@localhost:1521/freepdb1 testuser testpwd"
एप्लिकेशन को ठीक तीन आर्ग्युमेंट्स की अपेक्षा होती है:
1. JDBC URL
2. डेटाबेस उपयोगकर्ता नाम
3. डेटाबेस पासवर्ड
यदि वे अनुपस्थित हैं, तो Application.main() एक IllegalArgumentException फेंकता है। यदि OPENAI_API_KEY अनुपस्थित है, तो यह एक IllegalStateException फेंकता है।
जब ऐप शुरू होता है, यह:
1. एक MemoryRepository बनाता है
2. डेटाबेस स्कीमा इनिशियलाइज़ करता है
3. यदि टेबल खाली है तो तीन सैंपल नोट्स सीड करता है
4. एक OpenAiChatModel बनाता है
5. मॉडल और टूल्स को AiServices में वायर करता है
6. एक CLI लूप शुरू करता है जो यूज़र इनपुट पढ़ता है, जब तक आप exit नहीं टाइप करते
इसका अर्थ है कि आप बिना पहले पंक्तियाँ मैन्युअली डालें, तुरंत मेमोरी रिट्रीवल आज़मा सकते हैं।
अब आइए मॉड्यूल को उसी क्रम में देखें जैसा एप्लिकेशन इसका उपयोग करता है।
LangChain4j एजेंट कॉन्ट्रैक्ट का वर्णन करने के लिए Java इंटरफ़ेस का उपयोग करता है। इस प्रोजेक्ट में, वह इंटरफ़ेस है MemoryAssistant।
// Define the interface that receives each user message.
 public interface MemoryAssistant {

 	@SystemMessage("""
         	You are a simple assistant with access to durable memory notes.
         	Use searchMemories when earlier notes might help answer the user.
         	If the user explicitly asks you to remember something for later, call storeMemory.
         	Keep answers concise.
         	""")
 	@UserMessage("{{message}}")
 	String chat(@V("message") String message);
 }
महत्वपूर्ण हिस्सा सिस्टम मैसेज है। यह मॉडल को बताता है कि कब कौन-सा टूल इस्तेमाल करना है:
यह हल्के-फुल्के टूल पॉलिसी का अच्छा उदाहरण है। प्रॉम्प्ट छोटा है, लेकिन टूल चयन को निर्देशित करने के लिए पर्याप्त विशिष्ट है।
एजेंट सीधे रिपॉजिटरी से बात नहीं करता। इसके बजाय, वह MemoryTools लेयर को कॉल करता है।
यहाँ स्टोरेज मेथड है:
// Save a note and return its generated memory identifier.
 @Tool(
     	"Store a new memory note when the user asks you to remember something "
             	+ "important for later."
 )
 public String storeMemory(String note) {
 	long id = repository.store(note);
 	return "Stored memory M" + id + ".";
 }
यह जानबूझकर कॉम्पैक्ट है। उपयोगकर्ता कह सकता है:
Remember that the next shift should verify the checkout retry queue stays below 50.यदि मॉडल सिस्टम प्रॉम्प्ट का सही तरह पालन करता है, तो वह storeMemory() कॉल करेगा, रिपॉजिटरी नोट को पर्सिस्ट करेगी, और टूल कुछ ऐसा लौटाएगा:
Stored memory M4.बाद में, उपयोगकर्ता पूछ सकता है:
What should the next shift verify?उस समय, एजेंट searchMemories() कॉल कर सकता है और प्राप्त नोट का उपयोग उत्तर देने के लिए कर सकता है।
रिपॉजिटरी वह जगह है जहाँ अधिकतर टिकाऊ मेमोरी लॉजिक रहता है। यह अभी भी साधारण JDBC है, जिससे डिज़ाइन का निरीक्षण करना आसान हो जाता है।
उच्च स्तर पर, MemoryRepository के दायित्व हैं:
Oracle Text सर्चइंसर्शन पाथ स्टोर करने से पहले नोट टेक्स्ट को नॉर्मलाइज़ और वैलिडेट करता है:
// Normalize the note, store its JSON document, and return the generated ID.
 public long store(String note) {
 	String normalized = normalizeNote(note);
 	Instant createdAt = Instant.now();
 	try (
         	Connection connection = dataSource.getConnection();
         	PreparedStatement statement = connection.prepareStatement(
                 	INSERT_SQL,
                 	new String[]{"id"})
 	) {
     	statement.setObject(
             	1,
                 toJsonDocument(normalized, createdAt),
             	OracleTypes.JSON
     	);
     	statement.setTimestamp(2, Timestamp.from(createdAt));
     	statement.executeUpdate();
     	try (ResultSet keys = statement.getGeneratedKeys()) {
         	if (keys.next()) {
             	return keys.getLong(1);
         	}
     	}
     	throw new IllegalStateException(
             	"No generated id returned for stored memory."
     	);
 	} catch (SQLException e) {
     	throw new RuntimeException("Failed to store memory", e);
 	}
 }
स्वयं JSON डॉक्यूमेंट इस तरह दिखता है:
{
 	"noteText": "Runbook note: use section 3 to validate checkout recovery after a rollback.",
 	"createdAt": "2026-04-27T17:00:00Z"
 }
यह संरचना सरल है, लेकिन पर्सिस्टेंस और टेक्स्ट सर्च—दोनों को सपोर्ट करने के लिए पर्याप्त है।
रिपॉजिटरी का सबसे दिलचस्प हिस्सा है search() मेथड:
// Search by extracted keywords or fall back to recent notes.
 public List<Note> search(String question, int maxResults) {
 	List<String> keywords = extractKeywords(question);
 	if (keywords.isEmpty()) {
     	return findRecent(maxResults);
 	}
 	return textSearch(buildTextExpression(keywords), maxResults);
 }
यह मेथड एक व्यावहारिक फ्लो का पालन करता है:
1. उपयोगकर्ता प्रश्न को टोकनाइज़ करें
2. टोकन को लोअरकेस करें
3. the, what, और remember जैसे स्टॉप वर्ड्स हटा दें
4. जब छोटे टोकन में अंक शामिल हों तो उन्हें अर्थपूर्ण मानकर रखें
5. ACCUM के साथ एक Oracle Text एक्सप्रेशन बनाएँ
6. json_textcontains से JSON डेटा सर्च करें
यह “अंक स्वीकार्य हैं” वाला विवरण महत्वपूर्ण है। यह CHG2145 जैसे टर्म्स को कीवर्ड एक्सट्रैक्शन में बने रहने में मदद करता है—जो कि वही पहचानकर्ता-प्रधान लुकअप है जिसकी कई ऑपरेशनल एजेंट्स को ज़रूरत होती है।
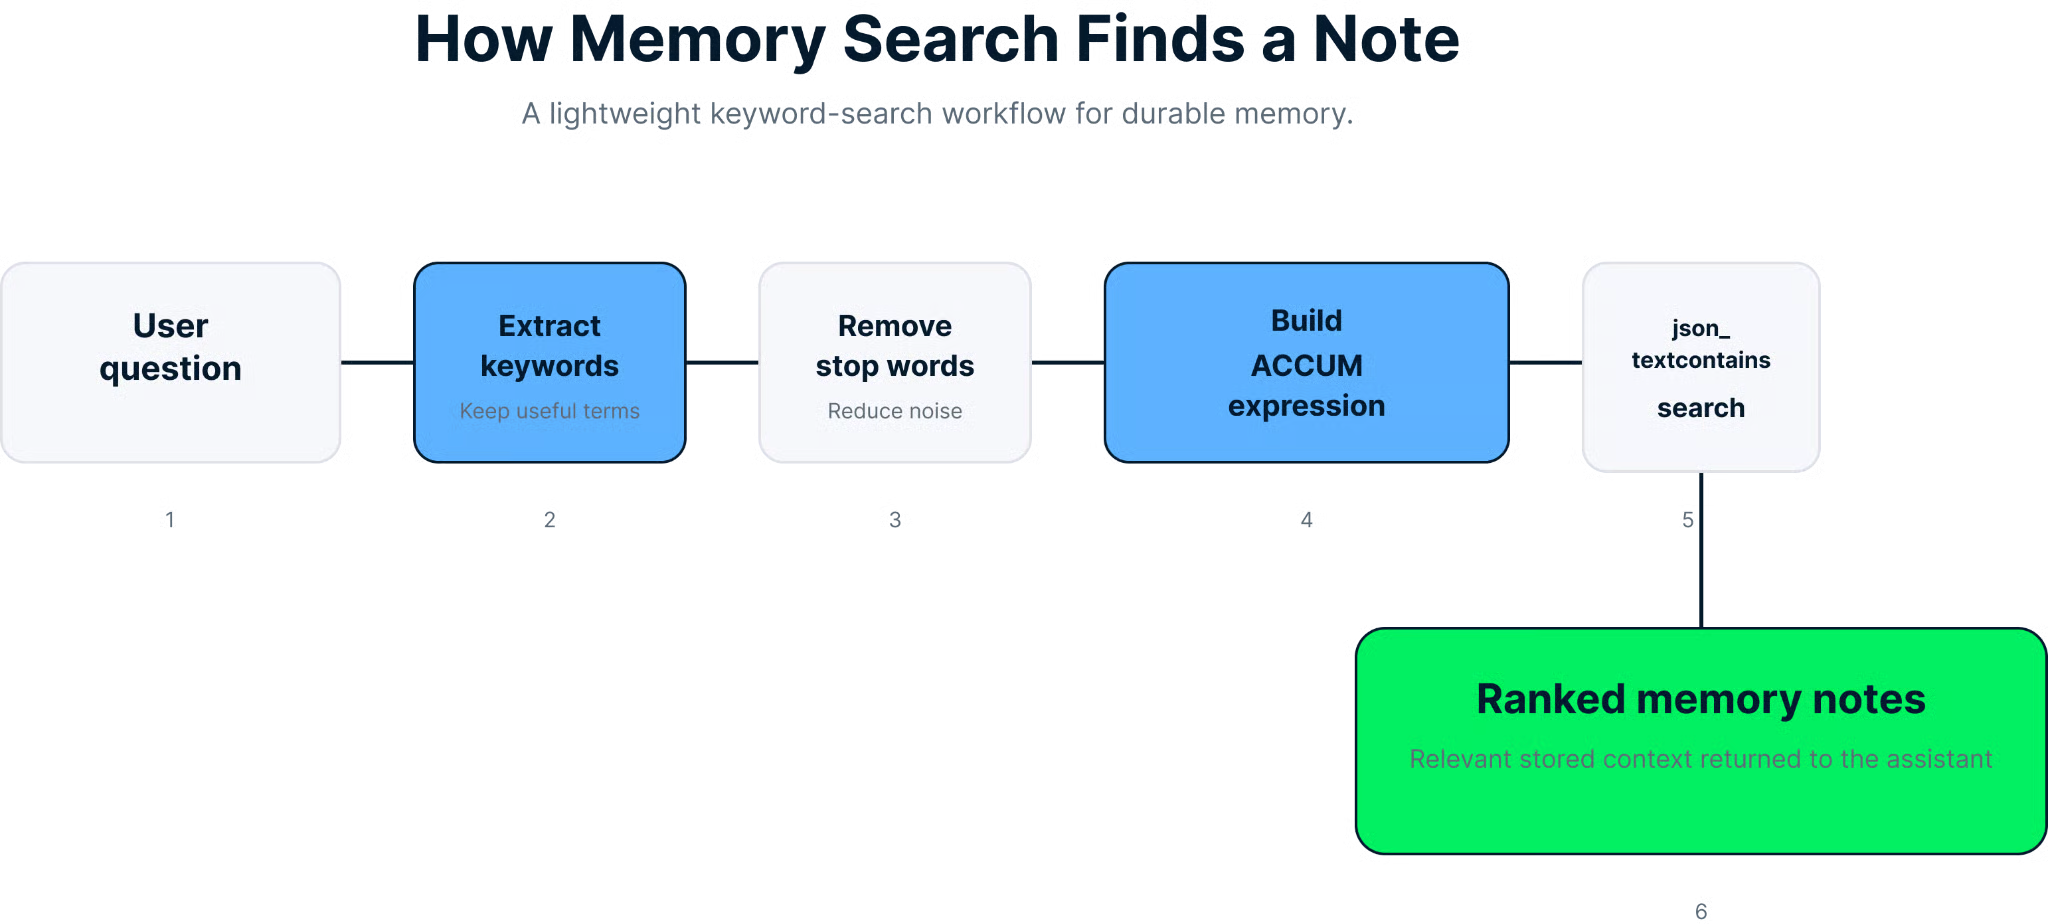
सर्च वर्कफ़्लो प्रश्न को कीवर्ड एक्सप्रेशन में बदलता है और रैंक किए हुए मेमोरी नोट्स लौटाता है।
SQL सर्च क्वेरी है:
-- Rank matching notes by Oracle Text relevance.
 SELECT id,
    	JSON_VALUE(
        	memory_doc,
        	'$.noteText' RETURNING VARCHAR2(2000 CHAR)
    	) AS note_text,
    	created_at,
    	SCORE(1) AS text_score
 FROM agent_memories
 WHERE JSON_TEXTCONTAINS(memory_doc, '$', ?, 1)
 ORDER BY SCORE(1) DESC, id DESC
 FETCH FIRST ? ROWS ONLY
यदि प्रश्न से उपयोगी कीवर्ड्स नहीं मिलते, तो रिपॉजिटरी हालिया नोट्स पर फॉलबैक करती है। इससे एजेंट को बहुत जल्दी खाली सर्च लौटाने के बजाय एक उचित डिफॉल्ट मिलता है।
एप्लिकेशन इन्हें AiServices.builder() से एक साथ जोड़ता है:
// Build the chat model, then attach the memory tools to the assistant.
 ChatModel chatModel = OpenAiChatModel.builder()
     	.apiKey(apiKey)
         .modelName("gpt-5-nano")
     	.build();

 MemoryAssistant assistant = AiServices.builder(MemoryAssistant.class)
     	.chatModel(chatModel)
     	.tools(new MemoryTools(repository))
     	.build();
यह पूरा पैटर्न एक ही जगह पर है:
उसके बाद, कंसोल लूप बस यूज़र इनपुट को assistant.chat(input) में पास करता है।
एप्लिकेशन कुछ स्टार्टर प्रॉम्प्ट्स प्रिंट करता है:
What do we know about CHG2145?
 Remember that the next shift should verify the checkout retry queue stays below 50.
 What should the next shift verify?
ये प्रॉम्प्ट्स उपयोगी हैं क्योंकि वे पूरी मेमोरी लाइफसायकल को एक्सरसाइज़ करते हैं:
यह मॉड्यूल जानबूझकर संकीर्ण है, जो पैटर्न सीखते समय एक ताकत है। फिर भी, कुछ व्यावहारिक बातों का ध्यान रखें।
सिस्टम प्रॉम्प्ट मॉडल को केवल तब मेमोरी स्टोर करने को कहता है जब उपयोगकर्ता स्पष्ट रूप से ऐसा कहे। यह अनजाने में लिखे जाने वाले डेटा को कम करने में मदद करता है। यदि आप प्रॉम्प्ट को लापरवाही से व्यापक कर देते हैं, तो मॉडल कम-मूल्य वाले नोट्स पर्सिस्ट करना शुरू कर सकता है।
यह रिपॉजिटरी छोटे ऑपरेशनल नोट्स, रिमाइंडर्स, और पहचानकर्ताओं के लिए सर्वोत्तम है। यह अभी तक एंबेडिंग्स, चंकिंग, हाइब्रिड सर्च, या रैंकिंग के साथ एक पूर्ण रिट्रीवल-ऑगमेंटेड जनरेशन सिस्टम नहीं है।
इंसिडेंट IDs, टिकट नंबर, और चेंज रिक्वेस्ट रेफरेंस जैसी स्ट्रिंग्स के लिए, कीवर्ड-उन्मुख रिट्रीवल अक्सर सिमेंटिक सर्च से बेहतर शुरुआती बिंदु होता है। यह सैंपल उस ट्रेडऑफ को स्पष्ट रूप से दर्शाता है।
प्रोजेक्ट के टेस्ट्स Testcontainers द्वारा संचालित इंटीग्रेशन टेस्ट्स हैं। यदि Docker उपलब्ध नहीं है, तो mvn test रिपॉजिटरी लॉजिक चलने से पहले असफल हो जाएगा। वह एक वातावरण संबंधी समस्या है, जरूरी नहीं कि एप्लिकेशन बग हो।
टेस्ट्स चलाएँ:
# Run the integration tests.
 mvn test
टेस्ट्स दो महत्वपूर्ण व्यवहारों को कवर करते हैं:
एजेंट प्रोजेक्ट्स में एक आम गलती है एक साथ वेक्टर स्टोरेज, कन्वर्सेशन हिस्ट्री, समरीकरण, और रिट्रीवल पॉलिसीज़ जोड़ देना। यह सैंपल बेहतर क्रम दिखाता है:
1. एक ठोस मेमोरी उपयोग मामला परिभाषित करें
2. स्पष्ट टूल्स एक्सपोज़ करें
3. उन टूल्स को टिकाऊ स्टोरेज से बैक करें
4. रिट्रीवल व्यवहार सत्यापित करें
5. तभी अधिक उन्नत मेमोरी पैटर्न पर विचार करें
यदि आप इस ट्यूटोरियल के बाद एजेंट स्किल्स बनाना जारी रखना चाहते हैं, तो ये DataCamp संसाधन अगला अच्छा कदम हैं:
अब आपने देखा कि कैसे LangChain4j, Java, और Oracle AI Database के साथ एक छोटा पर उपयोगी मेमोरी-सक्षम एजेंट बनाया जा सकता है। मूल विचार सरल है: मॉडल को स्पष्ट मेमोरी टूल्स दें, नोट्स को JSON के रूप में टिकाऊ रूप से स्टोर करें, और उन्हें एक सीधे-सादे सर्च स्ट्रैटेजी से रिट्रीव करें।
यह डिज़ाइन एक मजबूत आधार है क्योंकि इसे समझना और बढ़ाना दोनों आसान है। एक बार यह पैटर्न काम करने लगे, तो आप बेहतर फ़िल्टरिंग, समृद्ध नोट स्कीमाज़, यूज़र स्कोपिंग, या यदि उपयोग के मामले की माँग हो तो वेक्टर सर्च भी जोड़ सकते हैं।
यदि आप एजेंट डिज़ाइन के बारे में सीखते रहना चाहते हैं, तो अगला अच्छा कदम है इस टूल-आधारित मेमोरी पैटर्न की तुलना विस्तृत एजेंट फ़्रेमवर्क्स और ऑर्केस्ट्रेशन वर्कफ़्लोज़ से करना। विशेष रूप से, यह देखना सार्थक है कि बड़े AI सिस्टम्स में स्पष्ट टूल्स, रिट्रीवल पैटर्न्स, और मल्टी-स्टेप एजेंट्स एक-दूसरे के साथ कैसे फिट बैठते हैं।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
लर्निंग पाथ