Kursus
Konsep MLOps
2 jam
45.9K
Pernahkah Anda melihat kembali sebuah proyek machine learning dan bertanya-tanya mengapa Anda membuat keputusan tertentu, atau bahkan apa sebenarnya yang dilakukan kode tersebut? Misalnya, mengapa Anda memilih subset fitur ini, versi data mana yang Anda gunakan untuk melatih model final, atau bagaimana kumpulan hiperparameter model yang berbeda memengaruhi kinerja? Sepertinya Anda perlu menerapkan praktik terbaik eksperimen ke dalam proyek machine learning Anda!
Eksperimen machine learning adalah proses merancang, membangun, mencatat, dan mengevaluasi sebuah pipeline machine learning untuk mengidentifikasi model yang mencapai kinerja yang diinginkan berdasarkan metrik tertentu, misalnya F1 score, RMSE, dan sebagainya. Ini adalah langkah krusial dalam mengembangkan model machine learning, baik sebelum deployment maupun sebagai bagian dari pelatihan ulang. Seperti eksperimen lain, eksperimen ini harus dirancang untuk:
Dengan menjaga tujuan-tujuan ini, Anda dapat memastikan kemudahan menemukan apa yang Anda perlukan, seperti hiperparameter model atau versi dataset, serta berbagi informasi seperti kinerja model dan kode sumber.
Untungnya, di sinilah Weights & Biases berperan!
Weights & Biases adalah platform dan pustaka Python untuk insinyur machine learning dalam menjalankan eksperimen, mencatat artefak, mengotomatisasi penalaan hiperparameter, dan mengevaluasi kinerja. Tutorial ini akan memperkenalkan fungsionalitas inti dengan mendemonstrasikan sebuah pipeline machine learning di mana elemen-elemen kunci dicatat dan kemudian diperiksa di sebuah dasbor!
# Install Python library
!pip install wandb
Untuk login, Anda perlu mendaftar akun.
Setelah dibuat, kunjungi halaman otorisasi untuk mengakses kunci API yang dapat Anda gunakan untuk login. Catat kunci ini, tetapi jangan bagikan kepada siapa pun!
Untuk login, buka Terminal baru dan masukkan wandb login atau tambahkan sel baru ke notebook Anda dan jalankan !wandb login.
Anda akan diminta memasukkan kunci API Anda, yang dapat Anda salin dan tempel, untuk berhasil login. Kredensial Anda akan disimpan secara lokal di ~/.netrc ke depannya.
wandb loginWeights & Biases memiliki beberapa komponen termasuk Experiments, Artifacts, Sweeps, dan Models. Mari mulai dengan melihat inti alur kerja—membuat dan menjalankan eksperimen.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
Di Weights & Biases, sebuah Experiment juga dikenal sebagai project. Untuk membuat project baru, kita memanggil fungsi wand.init(), meneruskan nama project sebagai string ke argumen kata kunci project. Anda dapat menetapkannya ke variabel bernama run, sehingga kita dapat mencatat file, model, dan metrik penting ke run tersebut.
Secara opsional, Anda juga dapat memberikan string ke argumen kata kunci job_type, sehingga mudah membedakan antara langkah berbeda seperti EDA, rekayasa fitur, atau penalaan hiperparameter. Selain itu, kode yang Anda jalankan dapat dicatat dengan menetapkan save_code sama dengan True.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Anda dapat mencatat informasi penting apa pun, seperti dataset, variabel, atau file, sebagai sebuah Artifact. Untuk melakukannya, pertama buat variabel dengan memanggil wandb.Artifact(), berikan nama dan tipe. Lalu catat ini menggunakan fungsi wandb.log_artifact(). Mari mulai dengan mencatat dataset asli.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)Exploratory Data Analysis (EDA) adalah langkah krusial dalam alur kerja machine learning, membantu Anda memastikan data sesuai dengan tipe data yang diperlukan dan bebas dari nilai hilang serta pencilan. Ini juga kesempatan untuk memeriksa distribusi dan hubungan antar fitur.
Keuntungan tambahan menggunakan Weights & Biases adalah kita dapat mencatat data saat melakukan prapemrosesan, bersama dengan visualisasi apa pun yang dihasilkan.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()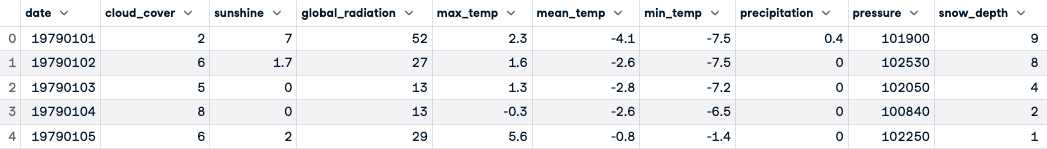
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()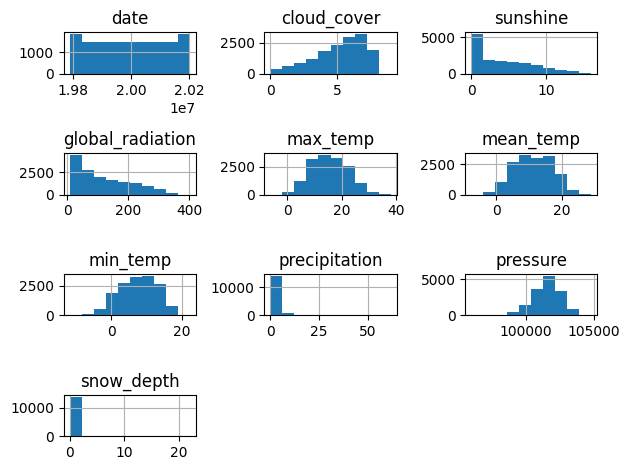
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Sekarang data telah dibersihkan, Anda dapat mencatatnya sebagai Artifact menggunakan wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>Langkah berikutnya dalam alur kerja adalah mengidentifikasi fitur potensial untuk pemodelan sekaligus menghindari multikolinearitas. Untuk melakukannya, Anda dapat terlebih dahulu membuat heatmap korelasi, lalu menggunakan Ridge Regression untuk mengukur pentingnya fitur dalam memprediksi "mean_temperature".
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()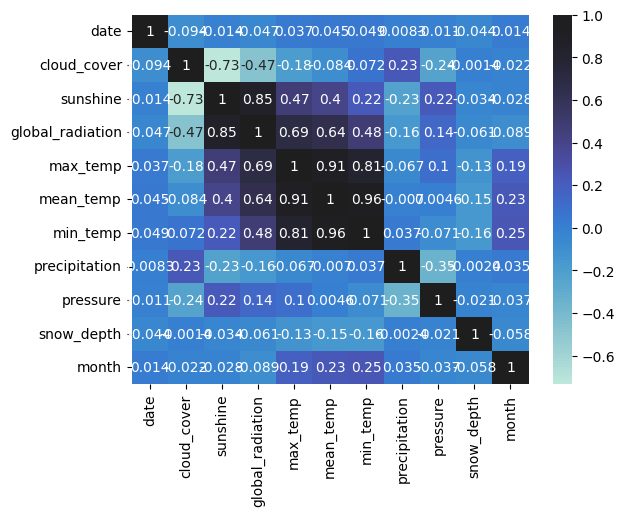
Anda dapat mencatat plot ini menggunakan wandb.Image()!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()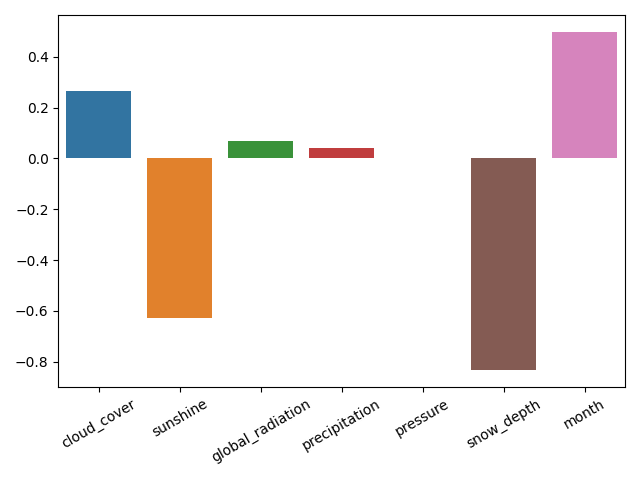
Mari simpan model dan plot pentingnya fitur menggunakan pickle.dump() dan wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Kerja bagus! Saatnya melatih model baseline menggunakan fitur penting yang teridentifikasi, yaitu yang memiliki koefisien model Ridge lebih dari nol. Anda juga akan mencatat data latih dan uji yang baru.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Mari latih dan evaluasi model Decision Tree Regression, menggunakan Root Mean Squared Error (RMSE) dan R-Squared sebagai metrik kinerja.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Anda dapat mengulas lebih dalam kinerja model dengan memvisualisasikan residual model. Weights & Biases memiliki fungsi dalam modul sklearn mereka untuk membuat ini!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})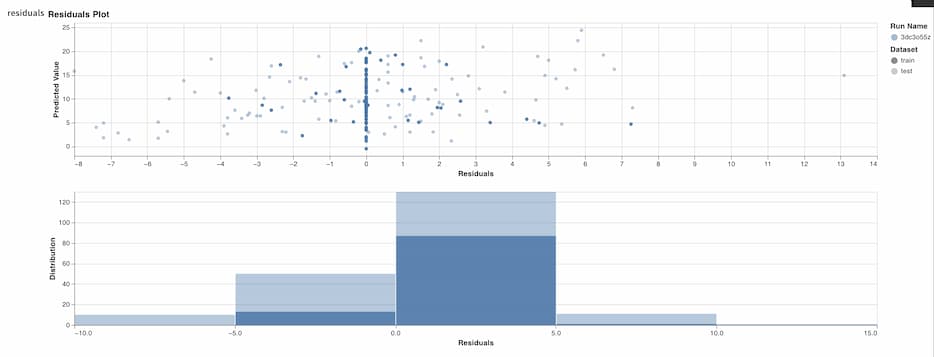
Pelatihan dan evaluasi selesai, jadi mari akhiri run saat ini.
# Finish run
wandb.finish()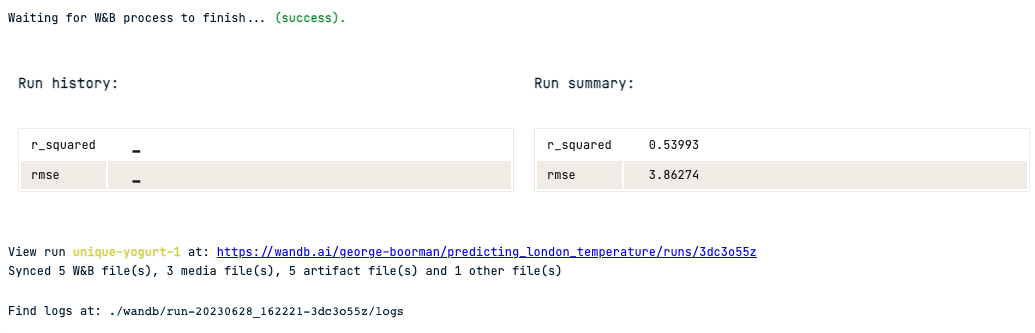
Sekarang Anda telah membuat dan mencatat model baseline beserta metrik kinerjanya, mari lihat bagaimana Anda dapat melakukan penalaan hiperparameter dan membuat versi model menggunakan Weights & Biases serta scikit-learn.
Kita akan menggunakan GridSearchCV untuk mencari model dengan kinerja terbaik pada ruang hiperparameter, berdasarkan RMSE.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()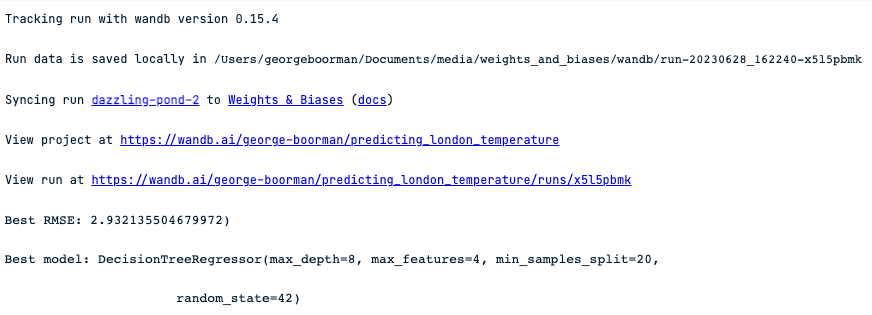
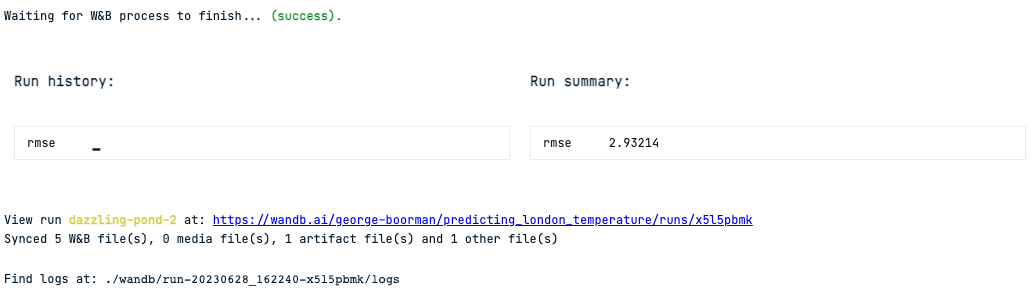
Untuk meninjau run dan artefak, Anda dapat pergi ke www.wandb.ai/<your-profile-name>/projects lalu pilih project yang telah Anda buat.
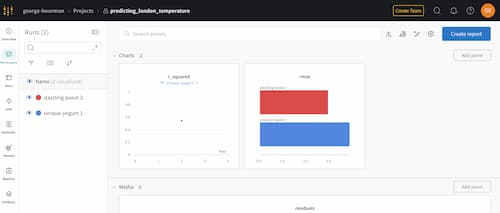
Setelah masuk, Anda akan melihat setiap run yang Anda buat, beserta media apa pun, seperti plot, seperti ini:
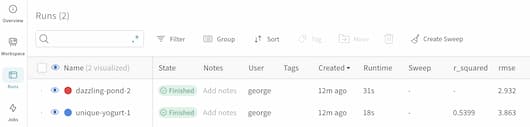
Dengan mengeklik ikon Runs, Anda dapat melihat semua run dan informasi kunci, termasuk metrik yang dicatat seperti RMSE dan R-Squared.
Weights & Biases memiliki jauh lebih banyak fungsionalitas untuk Anda jelajahi, seperti menggunakan artefak yang ada sebagai bagian dari run baru, alat Command Line Interface, dan Prompts untuk pengembangan LLM!
Untuk memperkuat pengetahuan Anda tentang eksperimen machine learning dan teknik MLOps yang lebih luas, Anda mungkin ingin melihat:
Pelajari topik yang disebutkan dalam tutorial ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



