कोर्स
MLOps Concepts
2 घंटा
45.8K
क्या आपने कभी किसी मशीन लर्निंग प्रोजेक्ट को पीछे मुड़कर देखा है और सोचा है कि आपने कुछ खास फैसले क्यों लिए थे, या कोड असल में कर क्या रहा है? उदाहरण के लिए, आपने फीचर्स का यह सबसेट क्यों चुना, फाइनल मॉडल को आपने डेटा के किस वर्शन पर ट्रेन किया, या अलग-अलग हाइपरपैरामीटर सेट्स ने प्रदर्शन को कैसे प्रभावित किया? लगता है कि आपको अपने मशीन लर्निंग प्रोजेक्ट्स में एक्सपेरिमेंटेशन की बेहतरीन प्रथाएँ अपनाने की जरूरत है!
मशीन लर्निंग एक्सपेरिमेंटेशन उस प्रक्रिया को कहते हैं जिसमें किसी दिए गए मेट्रिक या मेट्रिक्स (जैसे F1 स्कोर, RMSE, आदि) के संदर्भ में वांछित प्रदर्शन हासिल करने वाले मॉडल की पहचान के लिए मशीन लर्निंग पाइपलाइन को डिज़ाइन, बनाना, लॉग करना और मूल्यांकन करना शामिल है। यह डिप्लॉयमेंट से पहले और रिट्रेनिंग के हिस्से के रूप में, मशीन लर्निंग मॉडलों के विकास में एक अहम कदम है। अन्य किसी भी प्रयोग की तरह, इसे इस तरह डिज़ाइन किया जाना चाहिए कि:
इन लक्ष्यों को ध्यान में रखकर आप सुनिश्चित कर सकते हैं कि आपको जो चाहिए, जैसे किसी मॉडल के हाइपरपैरामीटर्स या किसी डेटा सेट का वर्शन, वह आसानी से मिल जाए, और आप मॉडल परफॉर्मेंस और सोर्स कोड जैसी जानकारी साझा कर सकें।
खुशकिस्मती से, यहीं Weights & Biases काम आता है!
Weights & Biases मशीन लर्निंग इंजीनियरों के लिए एक प्लेटफ़ॉर्म और Python लाइब्रेरी है, जो एक्सपेरिमेंट्स चलाने, आर्टिफैक्ट्स लॉग करने, हाइपरपैरामीटर ट्यूनिंग ऑटोमेट करने और परफॉर्मेंस का मूल्यांकन करने में मदद करती है। यह ट्यूटोरियल एक मशीन लर्निंग पाइपलाइन के ज़रिये कोर फ़ंक्शनैलिटी से परिचित कराएगा, जिसमें मुख्य तत्वों को लॉग किया जाएगा और बाद में डैशबोर्ड में देखा जाएगा!
# Install Python library
!pip install wandb
लॉगिन करने के लिए, आपको एक खाता बनाना होगा।
खाता बन जाने के बाद, authorize पेज पर जाएँ ताकि API कुंजी प्राप्त कर सकें, जिसका उपयोग आप लॉगिन के लिए करेंगे। इसे नोट कर लें, पर किसी और से साझा न करें!
लॉगिन करने के लिए, या तो एक नया टर्मिनल खोलकर wandb login दर्ज करें या अपने नोटबुक में एक नया सेल जोड़कर !wandb login चलाएँ।
आपसे आपकी API कुंजी देने के लिए कहा जाएगा, जिसे आप कॉपी-पेस्ट कर सकते हैं, और सफलतापूर्वक लॉगिन हो जाएगा। आगे चलकर आपके क्रेडेंशियल्स लोकली ~/.netrc में स्टोर हो जाएँगे।
wandb loginWeights & Biases में कई कंपोनेंट्स होते हैं, जैसे Experiments, Artifacts, Sweeps, और Models। आइए वर्कफ़्लो के मूल से शुरू करते हैं—एक्सपेरिमेंट बनाना और चलाना।
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
Weights & Biases में एक Experiment को प्रोजेक्ट भी कहा जाता है। नया प्रोजेक्ट बनाने के लिए हम wand.init() फ़ंक्शन कॉल करते हैं, और project कीवर्ड आर्ग्युमेंट में स्ट्रिंग के रूप में प्रोजेक्ट का नाम देते हैं। आप इसे run नाम के वेरिएबल में असाइन कर सकते हैं ताकि हम महत्वपूर्ण फाइलें, मॉडल्स और मेट्रिक्स इसी run में लॉग कर सकें।
वैकल्पिक रूप से, आप job_type कीवर्ड आर्ग्युमेंट में स्ट्रिंग देकर EDA, फीचर इंजीनियरिंग, या हाइपरपैरामीटर ट्यूनिंग जैसे अलग-अलग स्टेप्स के बीच आसानी से अंतर कर सकते हैं। साथ ही, आप जो कोड चलाते हैं, उसे save_code को True सेट करके लॉग कर सकते हैं।
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)आप किसी भी महत्वपूर्ण जानकारी, जैसे डेटा सेट, वेरिएबल्स, या फाइलें, को एक आर्टिफैक्ट के रूप में लॉग कर सकते हैं। ऐसा करने के लिए, पहले wandb.Artifact() कॉल करके नाम और प्रकार देते हुए एक वेरिएबल बनाइए। फिर wandb.log_artifact() फ़ंक्शन का उपयोग करके इसे लॉग कीजिए। चलिए मूल डेटा सेट को लॉग करने से शुरू करते हैं।
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)
एक्सप्लोरेटरी डेटा एनालिसिस (EDA) मशीन लर्निंग वर्कफ़्लो का एक अहम चरण है, जो यह सुनिश्चित करने में मदद करता है कि डेटा आवश्यक डेटा टाइप्स के अनुरूप है और उसमें मिसिंग वैल्यूज़ तथा आउटलायर्स नहीं हैं। यह फीचर्स के वितरण और उनके बीच संबंधों की जाँच करने का भी अवसर देता है।
Weights & Biases का अतिरिक्त लाभ यह है कि हम प्रीप्रोसेसिंग करते समय डेटा को, और बने हुए किसी भी विज़ुअलाइज़ेशन को, साथ-साथ लॉग कर सकते हैं।
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()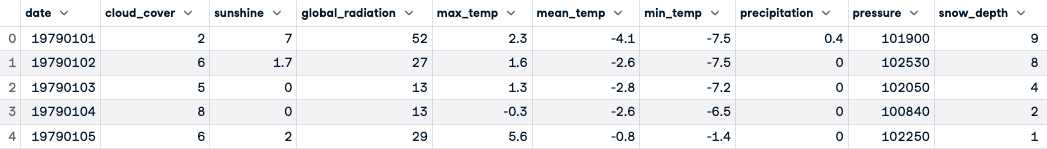
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()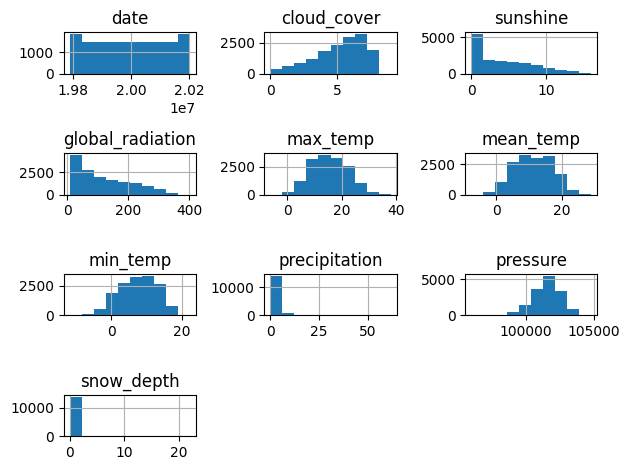
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
अब जब डेटा साफ़ कर लिया गया है, तो आप इसे wand.Artifact() का उपयोग करके एक आर्टिफैक्ट के रूप में लॉग कर सकते हैं।
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>वर्कफ़्लो का अगला चरण मॉडलिंग के लिए संभावित फीचर्स की पहचान करना है, साथ ही मल्टीकोलिनियरिटी से बचना है। इसके लिए, आप पहले एक कोरिलेशन हीटमैप बना सकते हैं, फिर "mean_temperature" की भविष्यवाणी में फीचर महत्त्व को परिमाणित करने के लिए Ridge Regression का उपयोग कर सकते हैं।
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()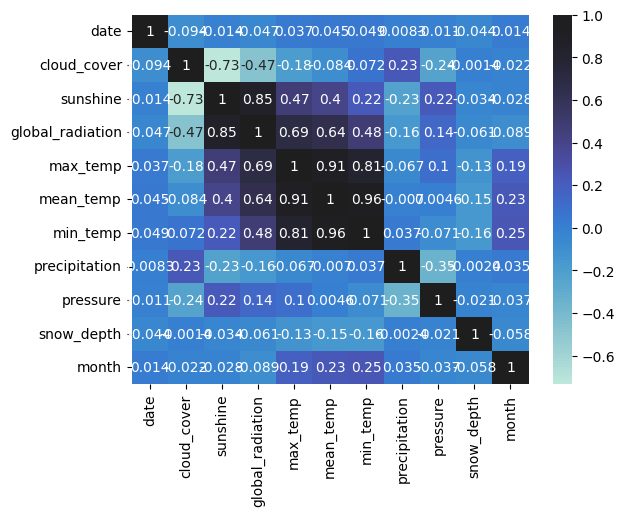
आप इस प्लॉट को wandb.Image() का उपयोग कर लॉग कर सकते हैं!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()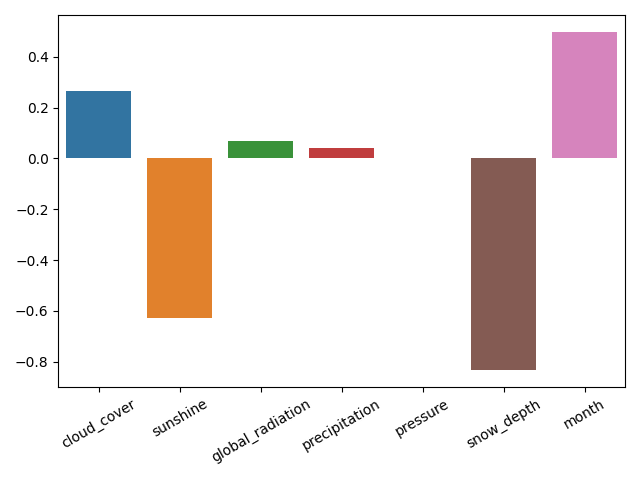
आइए मॉडल और फीचर इम्पॉर्टेंस प्लॉट को pickle.dump() और wandb.log() का उपयोग करके सेव करें।
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>बहुत बढ़िया! अब पहचाने गए महत्वपूर्ण फीचर्स का उपयोग करके अपना बेसलाइन मॉडल ट्रेन करने का समय है—वे जिनके Ridge मॉडल कॉइफिशिएंट शून्य से अधिक हैं। आप नए ट्रेनिंग और टेस्ट डेटा को भी लॉग करेंगे।
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
चलिए एक Decision Tree Regression मॉडल ट्रेन और मूल्यांकित करते हैं, जिसमें Root Mean Squared Error (RMSE) और R-Squared को परफॉर्मेंस मेट्रिक्स के रूप में उपयोग करेंगे।
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
आप मॉडल के रेजिडुअल्स को विज़ुअलाइज़ करके परफॉर्मेंस में और गहराई से जा सकते हैं। Weights & Biases में उनके sklearn मॉड्यूल में यह बनाने का एक फ़ंक्शन है!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})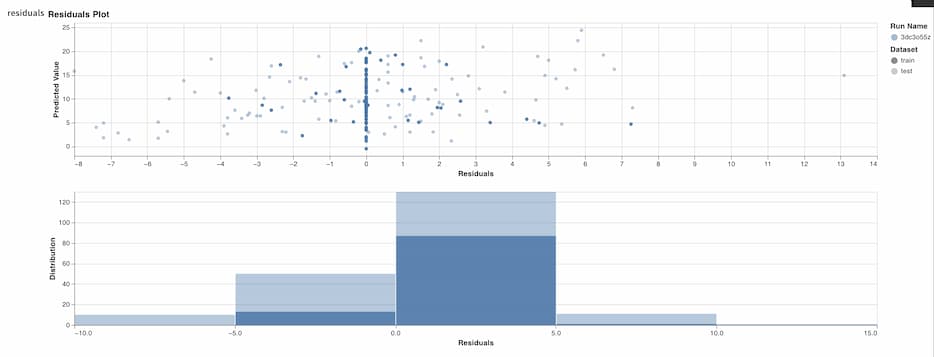
ट्रेनिंग और मूल्यांकन पूरा हो चुका है, तो आइए मौजूदा रन को समाप्त करें।
# Finish run
wandb.finish()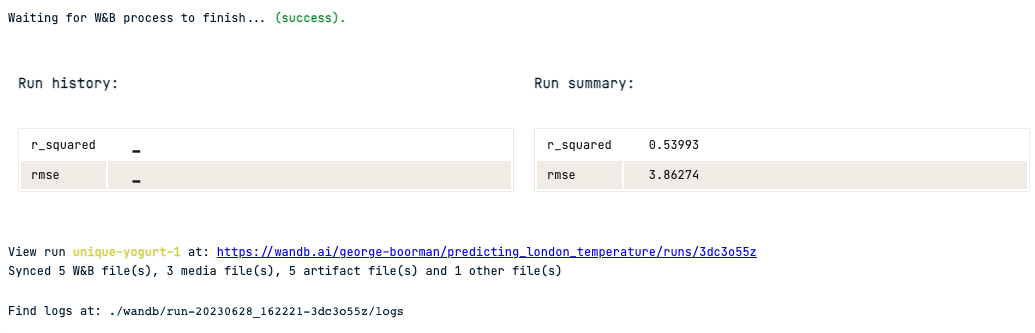
अब आपने बेसलाइन मॉडल और उससे जुड़े परफॉर्मेंस मेट्रिक्स को बना और लॉग कर लिया है, तो देखते हैं कि Weights & Biases और scikit-learn का उपयोग करके आप हाइपरपैरामीटर ट्यूनिंग कैसे कर सकते हैं और अपने मॉडलों का वर्ज़निंग कैसे कर सकते हैं।
हम GridSearchCV का उपयोग करेंगे ताकि हाइपरपैरामीटर स्पेस में सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल को RMSE के आधार पर ढूँढा जा सके।
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()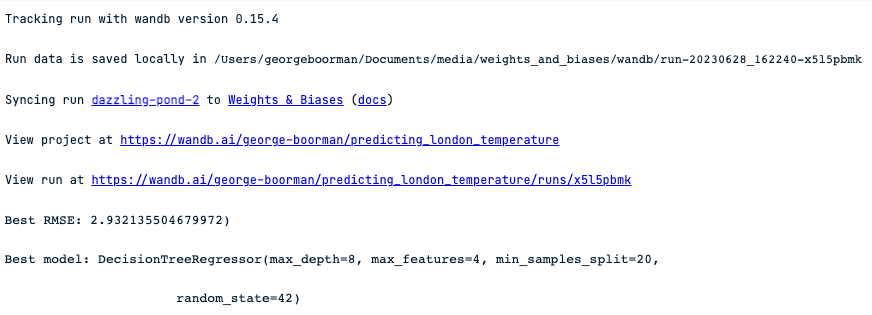
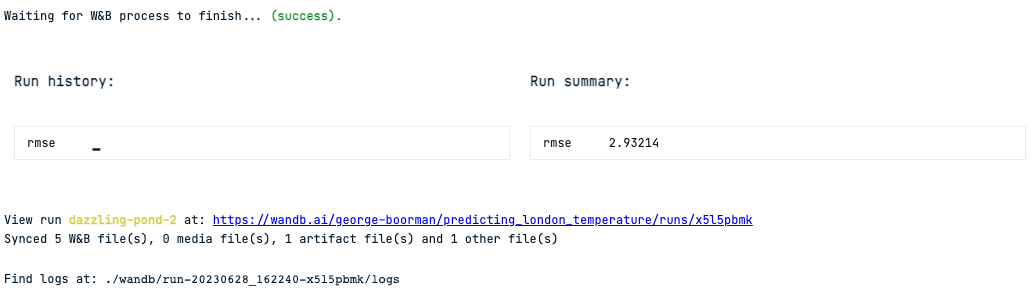
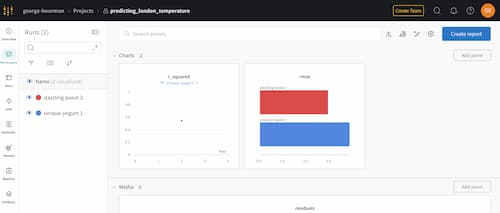
रन और आर्टिफैक्ट्स की जाँच करने के लिए आप www.wandb.ai/<your-profile-name>/projects पर जा सकते हैं, फिर बनाए गए प्रोजेक्ट का चयन करें।
अंदर जाने पर, आपको आपके द्वारा बनाए गए हर रन दिखेंगे, साथ ही कोई भी मीडिया, जैसे प्लॉट्स, इस तरह:
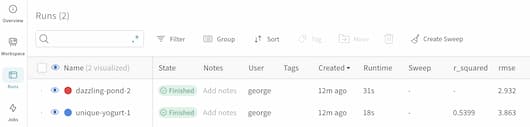
Runs आइकॉन पर क्लिक करके, आप अपने सभी रन और मुख्य जानकारी देख सकते हैं, जिसमें RMSE और R-Squared जैसे लॉग किए गए मेट्रिक्स शामिल हैं।
Weights & Biases में और भी बहुत सी क्षमताएँ हैं जिन्हें आप एक्सप्लोर कर सकते हैं, जैसे नई रन का हिस्सा बनकर मौजूदा आर्टिफैक्ट्स का उपयोग करना, एक कमांड लाइन इंटरफ़ेस टूल, और LLMs के विकास के लिए Prompts!
मशीन लर्निंग एक्सपेरिमेंटेशन और व्यापक MLOps तकनीकों के बारे में अपने ज्ञान को मज़बूत करने के लिए, आप यह देखना चाहेंगे:
इस ट्यूटोरियल में बताए गए विषय सीखें!
कोर्स
कोर्स
कोर्स