Cursus
MLOps-concepten
2 uur
45.7K
Heb je ooit teruggekeken op een machinelearning-project en je afgevraagd waarom je bepaalde keuzes hebt gemaakt, of zelfs wat de code nu eigenlijk doet? Bijvoorbeeld: waarom koos je voor deze subset van features, met welke versie van de data heb je het definitieve model getraind, of hoe beïnvloedden verschillende sets hyperparameters de performance? Klinkt alsof je best practices voor experimentatie aan je machinelearning-projecten moet toevoegen!
Machinelearning-experimentatie is het proces van het ontwerpen, bouwen, loggen en evalueren van een machinelearning-pijplijn om het model te identificeren dat de gewenste performance behaalt volgens een bepaalde metriek of metrieken, bijv. F1-score, RMSE, enz. Het is een cruciale stap bij het ontwikkelen van machinelearning-modellen, zowel voorafgaand aan deployment als bij het hertrainen. Net als elk ander experiment moet het zo worden ontworpen dat het:
Door deze doelen in gedachten te houden, zorg je ervoor dat je gemakkelijk vindt wat je nodig hebt, zoals de hyperparameters van een model of een versie van een dataset, en informatie kunt delen, zoals modelperformance en broncode.
Gelukkig is dit precies waar Weights & Biases om de hoek komt kijken!
Weights & Biases is een platform en Python-bibliotheek voor machinelearning-engineers om experimenten uit te voeren, artefacten te loggen, hyperparametertuning te automatiseren en performance te evalueren. Deze tutorial introduceert de kernfunctionaliteit door een machinelearning-pijplijn te demonstreren waarbij de belangrijkste elementen worden gelogd en vervolgens onderzocht in een dashboard!
# Install Python library
!pip install wandb
Om in te loggen moet je je aanmelden voor een account.
Ga na het aanmaken naar de autorisatiepagina om een API-sleutel te krijgen waarmee je kunt inloggen. Noteer deze, maar deel hem niet met anderen!
Om in te loggen open je ofwel een nieuwe Terminal en voer je wandb login uit, of je voegt een nieuwe cel toe aan je notebook en voert !wandb login uit.
Je wordt gevraagd je API-sleutel op te geven; kopieer en plak deze om succesvol in te loggen. Je inloggegevens worden lokaal opgeslagen in ~/.netrc voor toekomstig gebruik.
wandb loginWeights & Biases heeft verschillende componenten, waaronder Experiments, Artifacts, Sweeps en Models. Laten we beginnen met de kern van de workflow: het aanmaken en uitvoeren van experimenten.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
In Weights & Biases staat een Experiment ook bekend als een project. Om een nieuw project te maken roepen we de functie wand.init() aan en geven we onze projectnaam als string mee aan het project-keywordargument. Je kunt dit toewijzen aan een variabele met de naam run, zodat we belangrijke bestanden, modellen en metriek kunnen loggen bij de run.
Optioneel kun je ook een string doorgeven aan het job_type-keywordargument, zodat je verschillende stappen, zoals EDA, feature engineering of hyperparametertuning, gemakkelijk kunt onderscheiden. Daarnaast kan de code die je uitvoert worden gelogd door save_code op True te zetten.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Je kunt alle belangrijke informatie, zoals datasets, variabelen of bestanden, loggen als een Artifact. Maak hiervoor eerst een variabele aan met wandb.Artifact(), waarbij je de naam en het type opgeeft. Log dit vervolgens met de functie wandb.log_artifact(). Laten we beginnen met het loggen van de originele dataset.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)
Exploratory Data Analysis (EDA) is een cruciale stap in de machinelearning-workflow. Het helpt je te controleren of data de juiste datatypes heeft en vrij is van missende waarden en outliers. Het is ook een kans om distributies en relaties tussen features te onderzoeken.
Het extra voordeel van Weights & Biases is dat we de data tijdens de preprocessing kunnen loggen, samen met alle gemaakte visualisaties.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()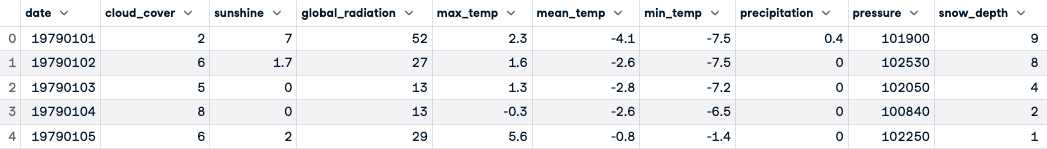
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()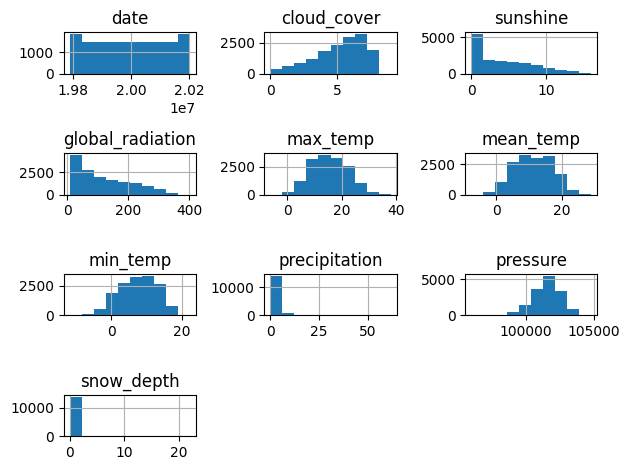
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Nu de data is opgeschoond, kun je deze loggen als een Artifact met wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>De volgende stap in de workflow is het identificeren van potentiële features voor modellering, terwijl je multicollineariteit vermijdt. Maak hiervoor eerst een correlatie-heatmap en gebruik daarna Ridge-regressie om featurebelang te kwantificeren bij het voorspellen van "mean_temperature".
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()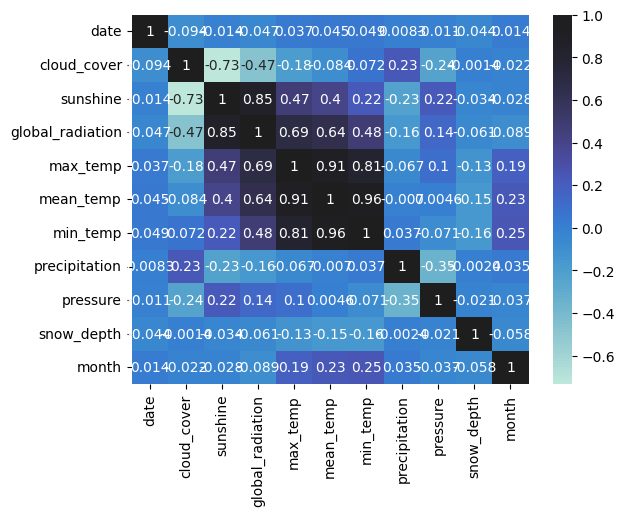
Je kunt deze plot loggen met wandb.Image()!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()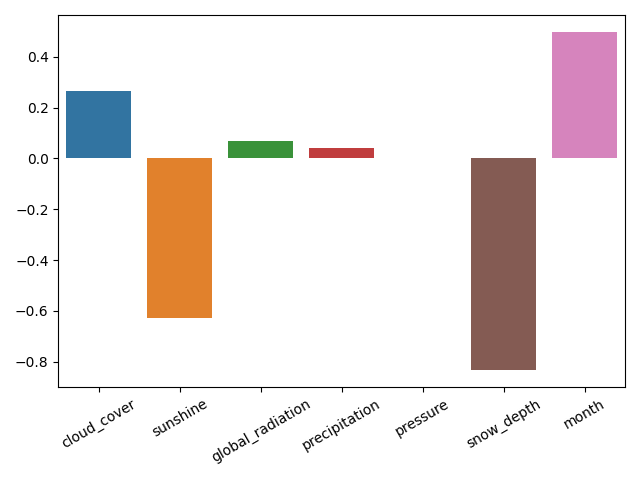
Laten we het model en de plot met featurebelang opslaan met pickle.dump() en wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Gelukt! Tijd om je basismodel te trainen met de geïdentificeerde belangrijke features, oftewel die met een Ridge-coëfficiënt groter dan nul. Je logt ook de nieuwe trainings- en testdata.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Laten we een Decision Tree Regressie-model trainen en evalueren, met Root Mean Squared Error (RMSE) en R-squared als performancemetrieken.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Je kunt dieper inzoomen op de modelperformance door de residuen van het model te visualiseren. Weights & Biases heeft hiervoor een functie in hun sklearn-module!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})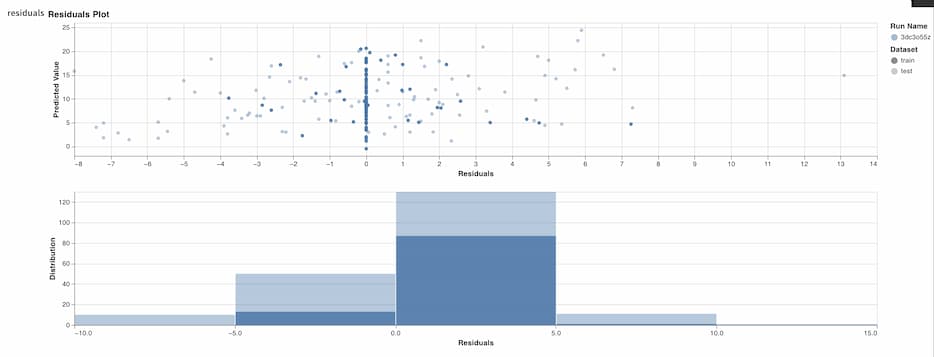
Training en evaluatie zijn voltooid, dus laten we de huidige run afronden.
# Finish run
wandb.finish()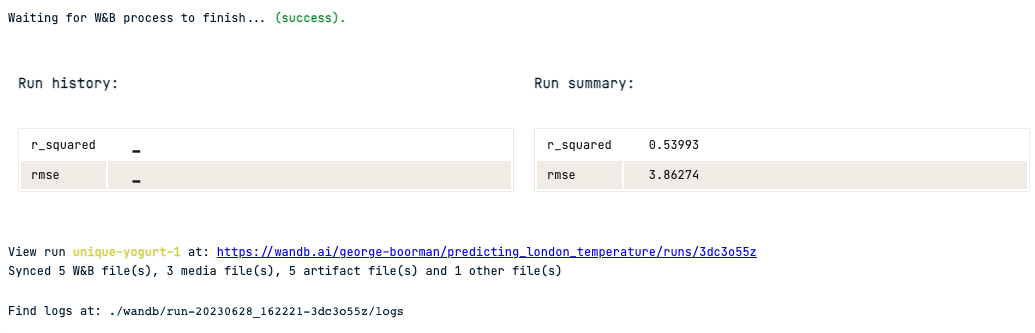
Nu je een basismodel hebt gemaakt en gelogd met de bijbehorende performancemetrieken, bekijken we hoe je hyperparametertuning kunt uitvoeren en je modellen kunt versies met Weights & Biases en scikit-learn.
We gebruiken GridSearchCV om te zoeken naar het best presterende model binnen een hyperparameter-ruimte, op basis van RMSE.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()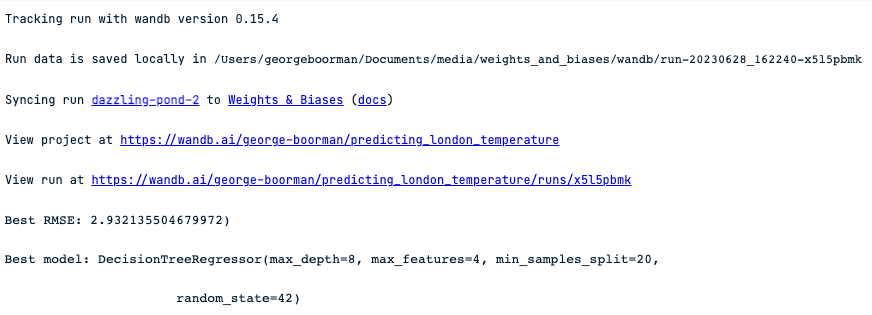
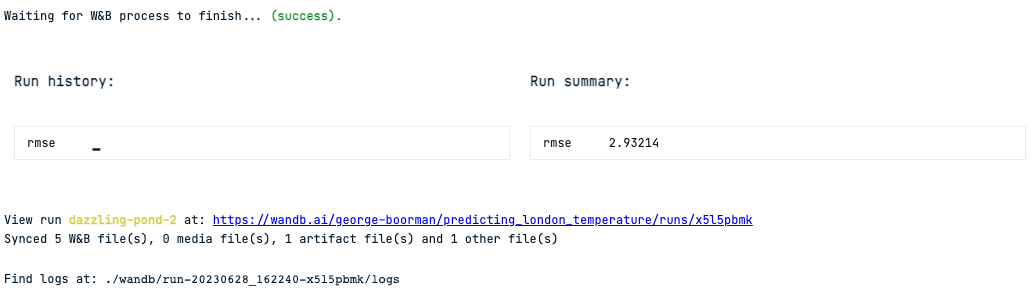
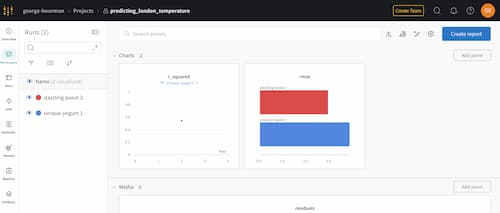
Om runs en artefacten te bekijken ga je naar www.wandb.ai/<your-profile-name>/projects en selecteer je het project dat je hebt gemaakt.
Eenmaal binnen zie je elke run die je hebt gemaakt, samen met alle media, zoals plots, zoals deze:
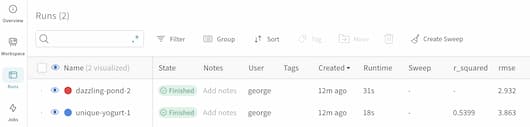
Door op het pictogram Runs te klikken, kun je al je runs en kerninformatie zien, waaronder gelogde metriek zoals RMSE en R-squared.
Weights & Biases heeft nog veel meer functionaliteit om te ontdekken, zoals bestaande artefacten gebruiken als onderdeel van nieuwe runs, een Command Line Interface-tool en Prompts voor de ontwikkeling van LLM's!
Om je kennis over machinelearning-experimentatie en de bredere MLOps-technieken te versterken, kun je eens kijken naar:
Leer de onderwerpen uit deze tutorial!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

