Corso
Concetti di MLOps
2 ore
45.8K
Ti è mai capitato di ripensare a un progetto di machine learning e chiederti perché hai preso certe decisioni, o persino cosa faccia davvero il codice? Per esempio: perché hai scelto quel sottoinsieme di feature, su quale versione dei dati hai allenato il modello finale, o come diversi set di iperparametri hanno influenzato le prestazioni? Sembra proprio che tu debba adottare le best practice di sperimentazione nei tuoi progetti di machine learning!
La sperimentazione nel machine learning è il processo di progettazione, costruzione, registrazione e valutazione di una pipeline di machine learning per identificare il modello che raggiunge prestazioni desiderate in termini di una o più metriche, ad esempio F1 score, RMSE, ecc. È uno step cruciale nello sviluppo dei modelli, sia prima del deploy sia come parte del retraining. Come ogni altro esperimento, dovrebbe essere progettata per:
Tenendo a mente questi obiettivi, puoi assicurarti di trovare facilmente ciò che ti serve, come gli iperparametri di un modello o una versione di un dataset, e condividere informazioni come prestazioni del modello e codice sorgente.
Per fortuna, qui entra in gioco Weights & Biases!
Weights & Biases è una piattaforma e libreria Python per ingegneri di machine learning che consente di eseguire esperimenti, registrare artifact, automatizzare il tuning degli iperparametri e valutare le prestazioni. Questo tutorial introduce le funzionalità di base mostrando una pipeline di machine learning in cui gli elementi chiave vengono registrati e poi analizzati in una dashboard!
# Install Python library
!pip install wandb
Per accedere, dovrai creare un account.
Una volta creato, visita la pagina di autorizzazione per ottenere una chiave API da usare per l’accesso. Prendine nota, ma non condividerla con nessuno!
Per accedere, apri un nuovo Terminale ed esegui wandb login oppure aggiungi una nuova cella al tuo notebook ed esegui !wandb login.
Ti verrà chiesto di fornire la tua chiave API: copiala e incollala per completare l’accesso. Le tue credenziali verranno salvate localmente in ~/.netrc.
wandb loginWeights & Biases include diversi componenti, tra cui Experiments, Artifacts, Sweeps e Models. Iniziamo dal cuore del flusso di lavoro: creare ed eseguire esperimenti.
# Import required modules
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import wandb
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error, r2_score
In Weights & Biases un Experiment è anche chiamato project. Per creare un nuovo progetto chiamiamo la funzione wand.init(), passando il nome del progetto come stringa all’argomento keyword project. Puoi assegnare il risultato a una variabile chiamata run, così da poter registrare file, modelli e metriche importanti nella run.
Facoltativamente, puoi anche fornire una stringa all’argomento job_type, così da distinguere facilmente tra step diversi come EDA, feature engineering o tuning degli iperparametri. Inoltre, il codice che esegui può essere registrato impostando save_code uguale a True.
# Initialize a run
run = wandb.init(project="predicting_london_temperature",
                 job_type="Baseline modeling",
save_code=True)Puoi registrare qualsiasi informazione importante, come dataset, variabili o file, come Artifact. Per farlo, crea prima una variabile chiamando wandb.Artifact(), fornendo nome e tipo. Poi registrala usando la funzione wandb.log_artifact(). Iniziamo registrando il dataset originale.
original_data = "london_weather.csv"
# Create an Artifact
data_artifact = wandb.Artifact(name="original_dataset",
                               type="data",
                               description="London weather dataset")
# Add the file to the Artifact
data_artifact.add_file(original_data)
# Log the Artifact as part of the run
run.log_artifact(data_artifact)L’Analisi Esplorativa dei Dati (EDA) è uno step cruciale nel flusso di lavoro di machine learning: ti aiuta a verificare che i dati rispettino i tipi richiesti e siano privi di valori mancanti e outlier. È anche un’occasione per esaminare distribuzioni e relazioni tra feature.
Il vantaggio aggiuntivo di usare Weights & Biases è che possiamo registrare i dati mentre eseguiamo il preprocessing, insieme a qualsiasi visualizzazione prodotta.
# Read in the data
london = pd.read_csv(original_data)

# Previewing the first five rows
london.head()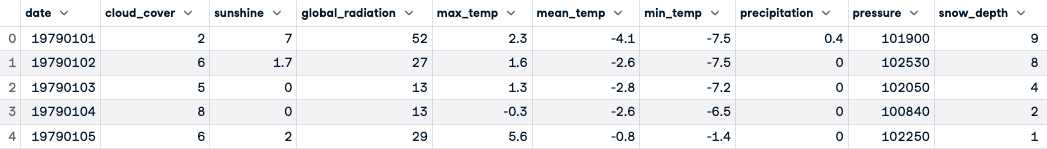
# Visualize distributions
plt.figure(figsize=(12,8))
london.hist()
plt.tight_layout()
plt.show()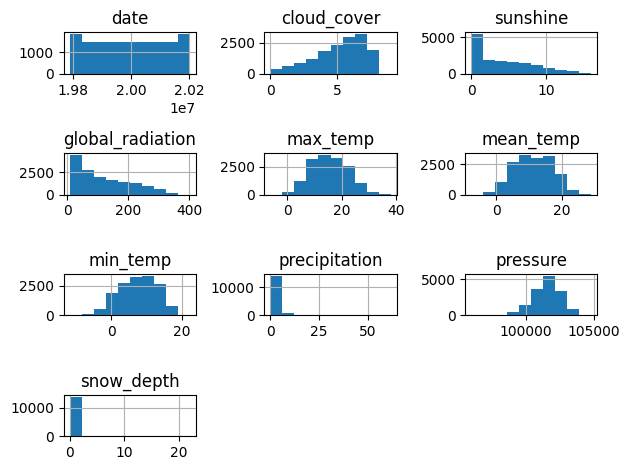
# View data types and non-null counts
london.info()


<class 'pandas.core.frame.DataFrame'>
RangeIndex: 15341 entries, 0 to 15340
Data columns (total 10 columns):
 #   Column            Non-Null Count  Dtype
---  ------            --------------  -----
 0   date              15341 non-null  int64
 1   cloud_cover       15322 non-null  float64
 2   sunshine          15341 non-null  float64
 3   global_radiation  15322 non-null  float64
 4   max_temp          15335 non-null  float64
 5   mean_temp         15305 non-null  float64
 6   min_temp          15339 non-null  float64
 7   precipitation     15335 non-null  float64
 8   pressure          15337 non-null  float64
 9   snow_depth        13900 non-null  float64
dtypes: float64(9), int64(1)
memory usage: 1.2 MB


# Convert date to datetime
london["date"] = pd.to_datetime(london["date"], format="%Y%m%d")

# Add a month column
london["month"] = london["date"].dt.month

# Drop missing values
london.dropna(inplace=True)
Ora che i dati sono stati puliti, puoi registrarli come Artifact usando wand.Artifact().
# Save and log the new version of the data
london.to_csv("london_weather_preprocessed.csv", index=False)
preprocessed_data = "london_weather_preprocessed.csv"
# Create an Artifact
preprocessed_data_artifact = wandb.Artifact(name="london_weather_preprocessed",
                               type="data",
                               description="London weather dataset - preprocessed")
# Add the file to the Artifact
preprocessed_data_artifact.add_file(preprocessed_data)
# Log the Artifact as part of the run
run.log_artifact(preprocessed_data_artifact)


<wandb.sdk.artifacts.local_artifact.Artifact at 0x15bfe6710>Il passo successivo del flusso è identificare le possibili feature per il modeling evitando la multicollinearità. Per farlo, puoi prima creare una heatmap di correlazione, quindi usare la Ridge Regression per quantificare l’importanza delle feature nel predire "mean_temperature".
# Correlation heatmap
sns.heatmap(london.corr(), annot=True, center=True)
plt.show()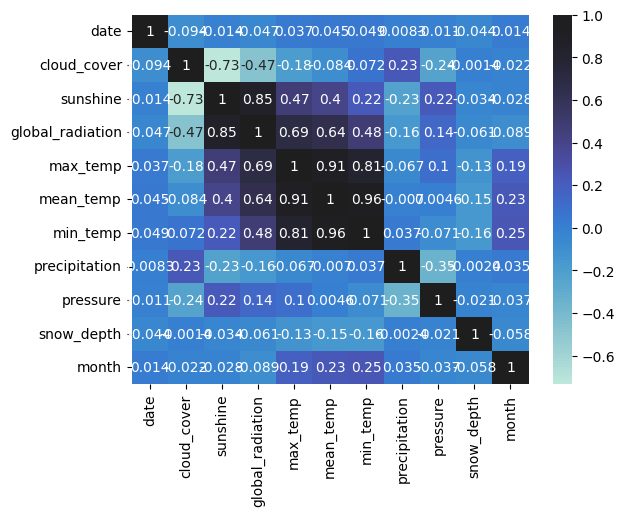
Puoi registrare questo grafico usando wandb.Image()!
# Log the heatmap
wandb.log({"correlation_heatmap": wandb.Image(plt)})


# Split the data
X = london.drop(columns=["mean_temp", "min_temp", "max_temp", "date"])
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

# Build a Ridge regression model
ridge = Ridge(alpha=0.1)
ridge.fit(X_train, y_train)
y_pred = ridge.predict(X_test)

# Visualize feature importance using the coefficients
fig = plt.figure()
sns.barplot(x=X_train.columns, y=ridge.coef_)
plt.xticks(rotation=30)
plt.tight_layout()
plt.savefig("feature_selection.png")
plt.show()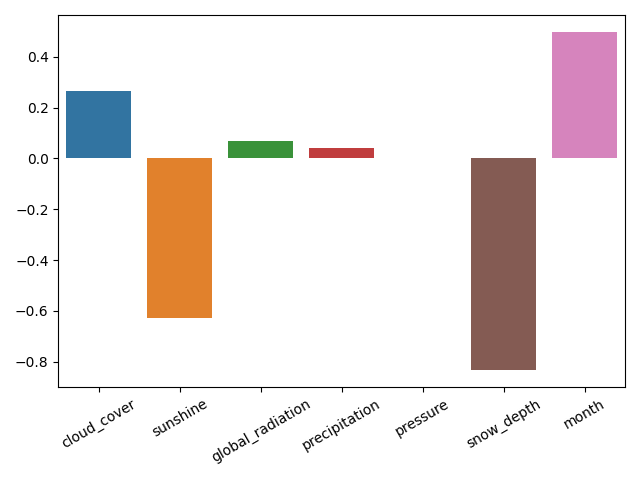
Salviamo il modello e il grafico dell’importanza delle feature usando pickle.dump() e wandb.log().
import pickle
pickle.dump(ridge, open("feature_selection_model.pkl", "wb"))
feature_selection_model = wandb.Artifact("feature_selection_model", type="model")
feature_selection_model.add_file("feature_selection_model.pkl")
run.log_artifact(feature_selection_model)
wandb.log({"feature_selection_plot": wandb.Image(fig)})


<Figure size 640x480 with 0 Axes>Ci sei! È il momento di addestrare il tuo modello baseline usando le feature importanti identificate, cioè quelle con un coefficiente del modello Ridge maggiore di zero. Registrerai anche i nuovi dati di training e test.
X = london[["cloud_cover", "global_radiation", "precipitation", "month"]]
y = london["mean_temp"]
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)

def log_data(X_train, y_train, X_test, y_test):
    # Log the training and test data
    training_features = wandb.Artifact(name="X_train",
                               type="data",
                               description="Training features")
    X_train.to_csv("X_train.csv", index=False)
    training_features.add_file("X_train.csv")
    run.log_artifact(training_features)

    training_labels = wandb.Artifact(name="y_train",
                               type="data",
                               description="Training labels")
    y_train.to_csv("y_train.csv", index=False)

    training_labels.add_file("y_train.csv")
    run.log_artifact(training_labels)

    test_features = wandb.Artifact(name="X_test",
                               type="data",
                               description="Test features")
    X_test.to_csv("X_test.csv", index=False)
    test_features.add_file("X_test.csv")
    run.log_artifact(test_features)

    test_labels = wandb.Artifact(name="y_test",
                               type="data",
                               description="Test labels")
    y_test.to_csv("y_test.csv", index=False)
    test_labels.add_file("y_test.csv")
    run.log_artifact(test_labels)

log_data(X_train, y_train, X_test, y_test)
Alleniamo e valutiamo un modello di Decision Tree Regression, usando Root Mean Squared Error (RMSE) e R-Squared come metriche di prestazione.
# Fit and evaluate the model
dt_reg = DecisionTreeRegressor(random_state=42)
dt_reg.fit(X_train, y_train)
y_pred = dt_reg.predict(X_test)
rmse = mean_squared_error(y_test, y_pred, squared=False)
r_squared = r2_score(y_test, y_pred)
print(rmse, r_squared)


3.8627385194713346 0.5399282872125385

# Save and log the model and metrics
pickle.dump(dt_reg, open("baseline_decision_tree.pkl", "wb"))
baseline_model = wandb.Artifact("baseline_decision_tree", type="model")
baseline_model.add_file("baseline_decision_tree.pkl")
run.log_artifact(baseline_model)
wandb.log({"rmse": rmse, "r_squared": r_squared})
Puoi approfondire ulteriormente le prestazioni del modello visualizzando i residui. Weights & Biases ha una funzione nel suo modulo sklearn per generarlo!
# Plot training residuals
wandb.log({"baseline_residuals_plot": wandb.sklearn.plot_residuals(dt_reg, X_train, y_train)})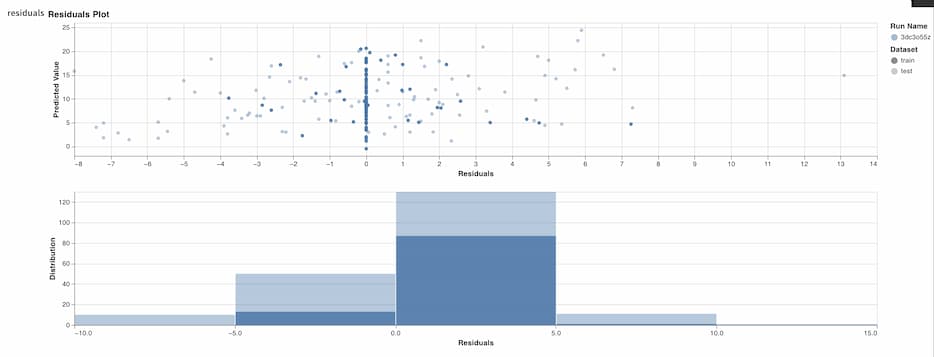
Training e valutazione sono completi, quindi concludiamo la run corrente.
# Finish run
wandb.finish()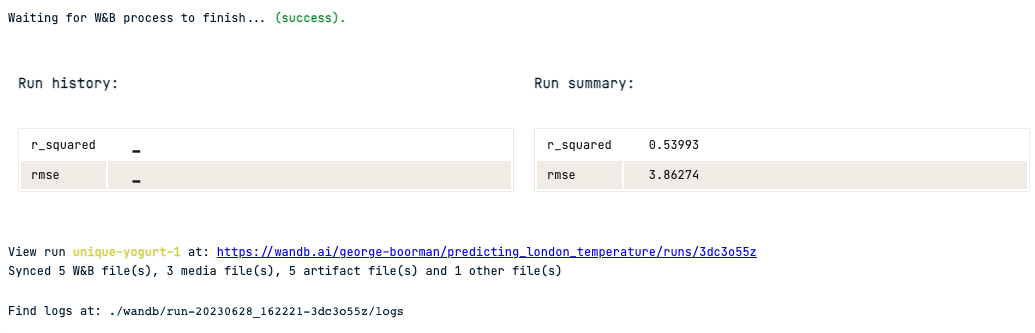
Ora che hai creato e registrato un modello baseline con le relative metriche di prestazione, vediamo come eseguire l’hyperparameter tuning e versionare i modelli usando Weights & Biases e scikit-learn.
Useremo GridSearchCV per cercare il modello con le prestazioni migliori in uno spazio di iperparametri, in base all’RMSE.
# Initialize a new run
run_v2 = wandb.init(project="predicting_london_temperature",
                 job_type="Hyperparameter tuning",
                 save_code=True)

# Split the data and create a KFold object
X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.2)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

# Create the hyperparameter space
params = {"max_depth":[2, 5, 8, 12, 20],
          "min_samples_split": [2, 5, 8, 12, 20],
          "max_features": [1, 2, 3, 4],
          "random_state": [42]
          }

# Create a GridSearchCV object
dt_reg = DecisionTreeRegressor()
dt_reg_cv = GridSearchCV(dt_reg,
                         params,
                         cv=kf,
                         scoring="neg_root_mean_squared_error")

# Fit the data
dt_reg_cv.fit(X_train, y_train)

# Evaluate and log performance
## GridSearchCV uses negative RMSE
## so you can convert it to positive
print(f"Best RMSE: {-1 * dt_reg_cv.best_score_})")
print(f"Best model: {dt_reg_cv.best_estimator_}")

# Save and log the model, metrics, and parameters
pickle.dump(dt_reg_cv, open("tuned_decision_tree.pkl", "wb"))
tuned_decision_tree = wandb.Artifact("tuned_decision_tree", type="model")
tuned_decision_tree.add_file("tuned_decision_tree.pkl")
run_v2.log_artifact(tuned_decision_tree)
wandb.log({"rmse": -1 * dt_reg_cv.best_score_})
wandb.finish()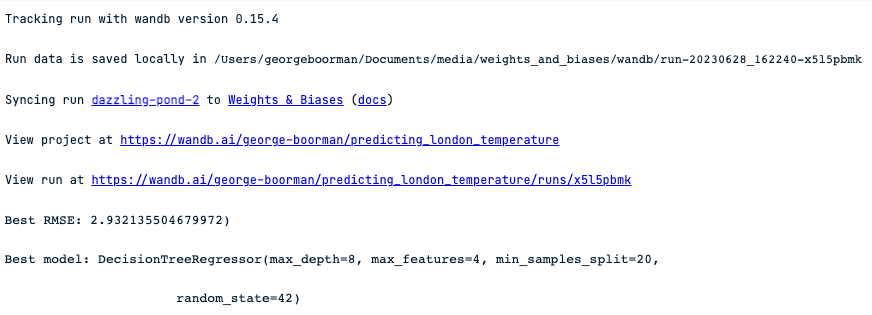
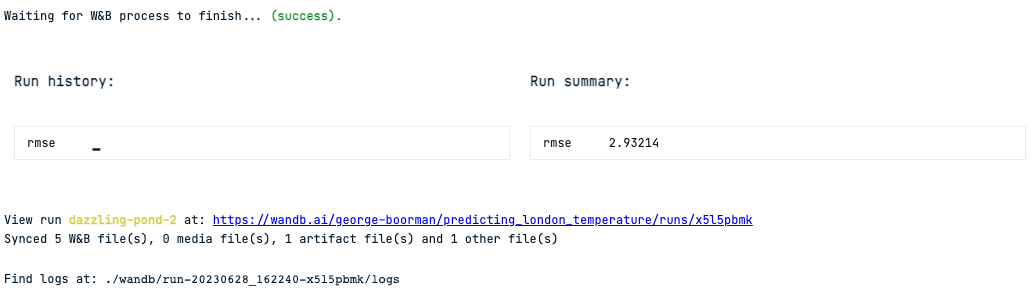
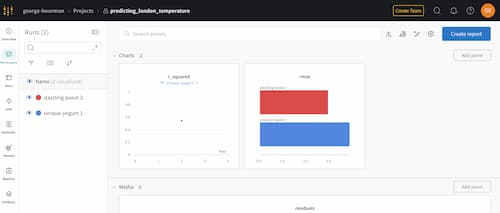
Per esaminare run e artifact puoi andare su www.wandb.ai/<your-profile-name>/projects e poi selezionare il progetto che hai creato.
All’interno vedrai ogni run che hai creato, insieme a qualsiasi media, come i grafici, ad esempio:
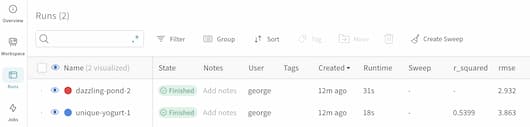
Cliccando sull’icona Runs, puoi vedere tutte le tue run e le informazioni chiave, incluse le metriche registrate come RMSE e R-Squared.
Weights & Biases offre molte altre funzionalità da esplorare, come usare artifact esistenti come parte di nuove run, uno strumento Command Line Interface e i Prompts per lo sviluppo di LLM!
Per consolidare le tue conoscenze sulla sperimentazione nel machine learning e sulle tecniche più ampie di MLOps, potresti dare un’occhiata a:
Impara gli argomenti menzionati in questo tutorial!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



