
Last chance! 50% off DataCamp Premium
Sale ends in
Mistral Large 3 एक मल्टीमोडल MoE मॉडल है, जिसे जटिल विज़ुअल दस्तावेज़ों से जानकारी पढ़ने, उस पर तर्क करने, और उसे संरचित करने के लिए बनाया गया है। चार्ट और PDFs को स्थिर छवियों की तरह देखने के बजाय, इसे उनसे टेबल निकालने, इनसाइट्स जनरेट करने, और सुसंगत नैरेटिव बनाने के लिए डिज़ाइन किया गया है।
इस ट्यूटोरियल में, हम Mistral Large 3 (mistral-large-2512) मॉडल का उपयोग करके Streamlit में एक मल्टीमोडल इंटेलिजेंस इवैल्यूएशन हब बनाएंगे। फ्लो इस प्रकार है:
यह सब एक ही मॉडल (mistral-large-2512), एक ही एंडपॉइंट (/v1/chat/completions), और सख्त JSON Schema के साथ किया जाता है ताकि आउटपुट संरचित और विश्वसनीय रहे।
हमारे Mistral 3 पर लेख को पढ़ने की मैं सिफारिश करता/करती हूँ, जो नए मॉडलों की प्रमुख विशेषताओं का परिचय देता है। आप एक अलग ट्यूटोरियल में Ministral 3 को फाइन-ट्यून करने के बारे में भी जान सकते हैं।
Mistral Large 3 एक sparse mixture-of-experts (MOE) आर्किटेक्चर है, जिसमें 675B कुल में से 41B सक्रिय पैरामीटर हैं, और इमेज समझने के लिए 2.5B पैरामीटर वाला विज़न एन्कोडर है।
इस मॉडल से संबंधित कुछ प्रमुख गुण यहाँ दिए गए हैं:
मॉडल कार्ड और इकोसिस्टम डॉक्युमेंट्स कुछ महत्वपूर्ण सावधानियाँ भी बताते हैं:
इस खंड में, हम Mistral Large 3 का उपयोग करके, जिसे Streamlit ऐप में रैप किया गया है, एक मल्टीमोडल इंटेलिजेंस इवैल्यूएशन हब बनाएंगे। उच्च-स्तरीय रूप में, अंतिम ऐप यह करता है:
mistral-large-2512 को भेजते हैं, जो response_format को JSON Schema मोड में इस्तेमाल करके एक संरचित JSON पेलोड लौटाता है।यह एक स्थिर विज़ुअल रिपोर्ट को पूरी तरह Mistral Large 3 द्वारा संचालित एक इंटरैक्टिव इंटेलिजेंस असिस्टेंट में बदल देता है।
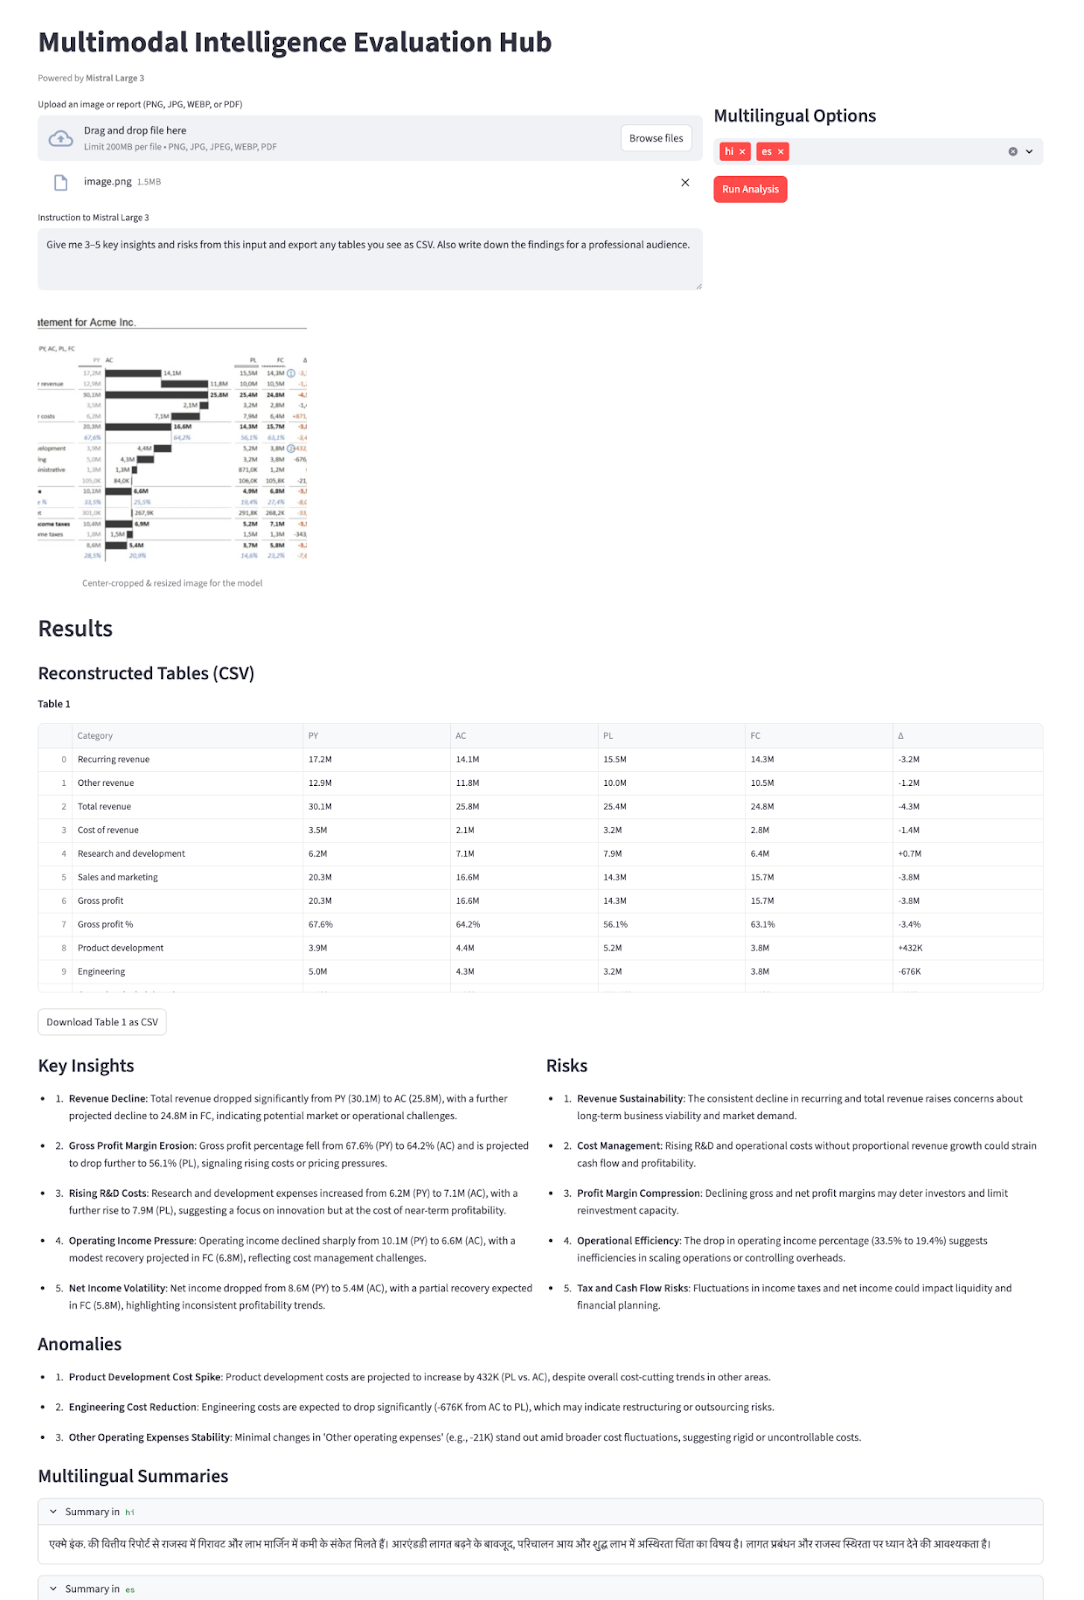
आइए इसे चरण दर चरण बनाते हैं।
Mistral Large 3 पर आधारित हमारा Streamlit डेमो बनाने से पहले, हमें Mistral API के जरिए मॉडल से बात करने के लिए एक बुनियादी लोकल एनवायरनमेंट चाहिए। UI, दस्तावेज़ों, और कॉन्फ़िगरेशन को संभालने के लिए कुछ हेल्पर लाइब्रेरी इंस्टॉल करके शुरुआत करें।
pip install streamlit mistralai pillow pdf2image pandas python-dotenvहम ऊपर दी गई कोर लाइब्रेरीज़ का उपयोग करेंगे, जैसे streamlit इंटरैक्टिव वेब ऐप UI के लिए, mistralai Mistral API से बात करने के लिए, pillow और pdf2image PDFs खोलने और उन्हें इमेज में बदलने के लिए, pandas किसी भी सारणीबद्ध डेटा या लॉग को संभालने के लिए, और python-dotenv ताकि .env फ़ाइल से MISTRAL_API_KEY जैसे एनवायरनमेंट वेरिएबल सुरक्षित रूप से लोड किए जा सकें।
इसके बाद, Mistral AI प्लेटफ़ॉर्म में लॉग इन करें और API Keys टैब पर जाएँ।
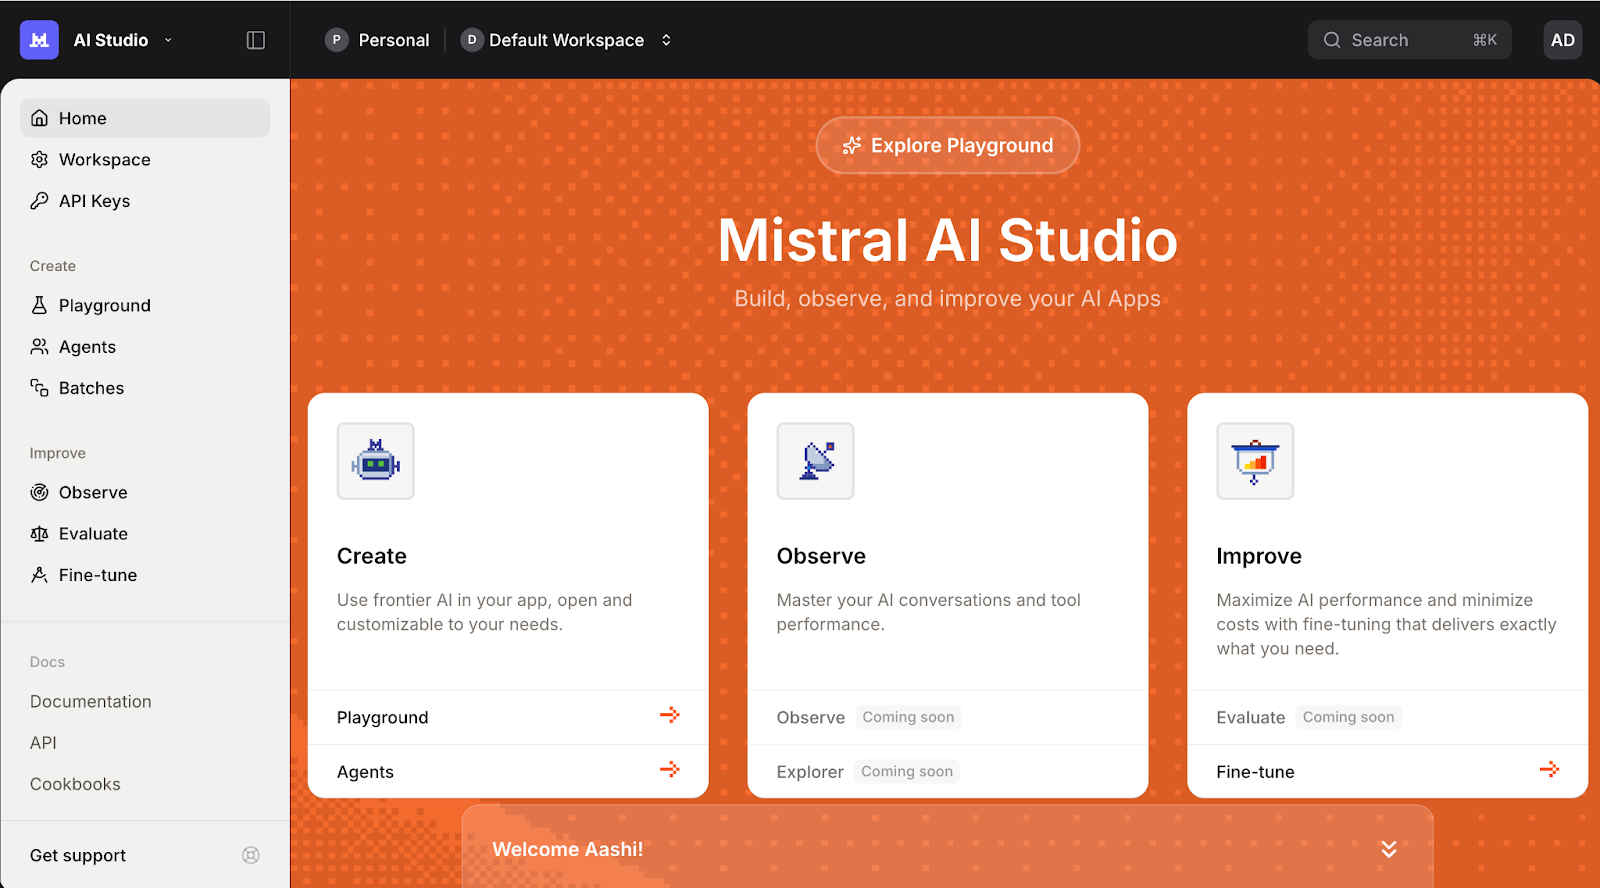
अपना डिफ़ॉल्ट वर्कस्पेस सेट करें (यदि पूछा जाए) और Create new key पर क्लिक करें।
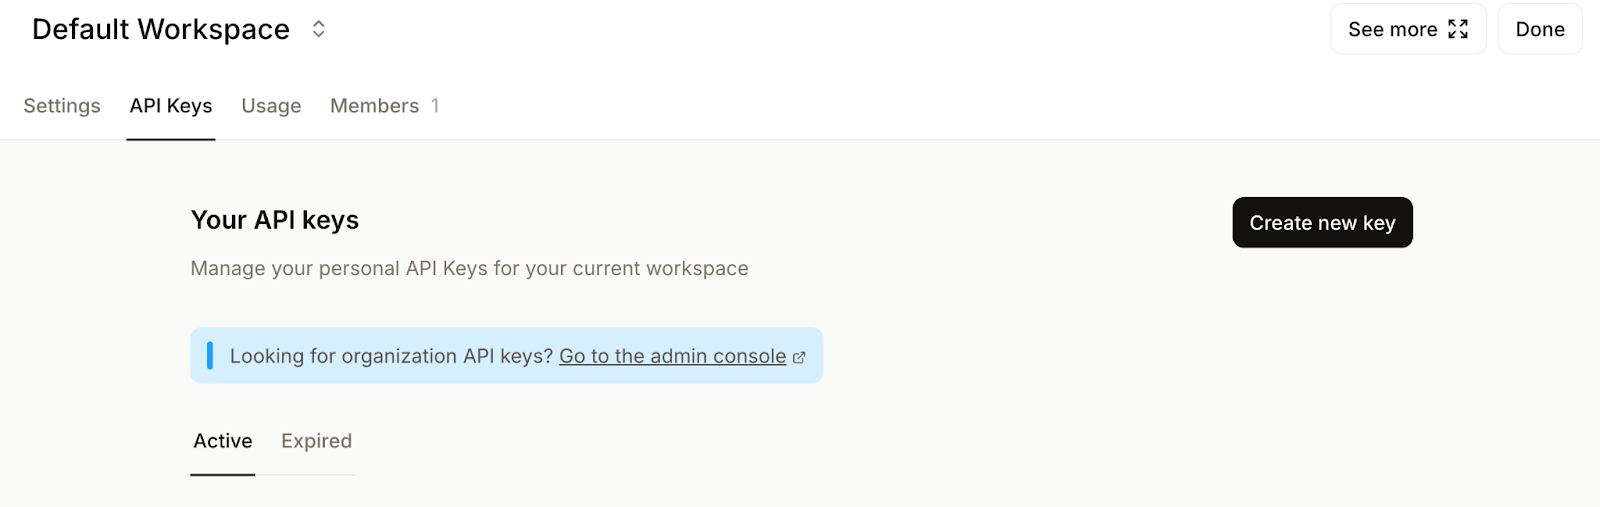
अपनी कुंजी को एक सार्थक नाम दें और वैकल्पिक रूप से एक समाप्ति तिथि सेट करें।
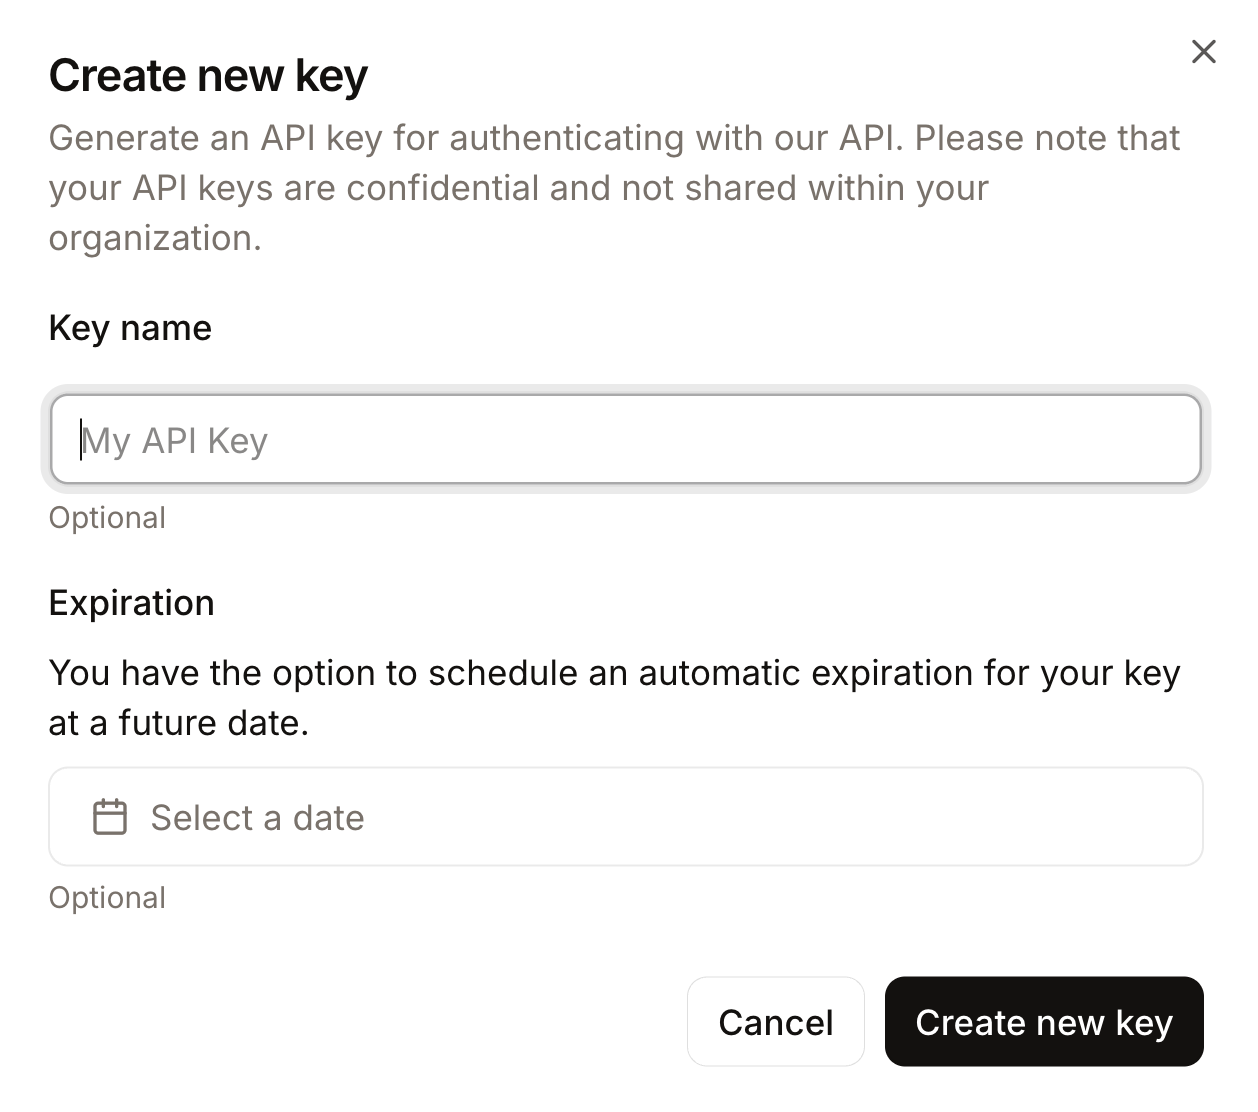
अंत में, जनरेट की गई कुंजी कॉपी करें और इसे निम्नानुसार एक एनवायरनमेंट वेरिएबल के रूप में एक्सपोर्ट करें:
export MISTRAL_API_KEY="your_mistral_api_key_here"इस बिंदु पर, हमारा एनवायरनमेंट अब Mistral API के साथ प्रमाणीकृत होने के लिए तैयार है।
एनवायरनमेंट कॉन्फ़िगर होने और डिपेंडेंसीज़ इंस्टॉल होने के बाद, अगला कदम Mistral क्लाइंट को इनिशियलाइज़ करना है, जो Mistral Large 3 मॉडल के सभी कॉल्स को संभालेगा। इससे हमें अपने Streamlit ऐप से Mistral Large 3 को प्रॉम्प्ट भेजने का एंट्री पॉइंट मिलता है।
MISTRAL_API_KEY = os.getenv("MISTRAL_API_KEY")
MODEL_ID = "mistral-large-2512"
if MISTRAL_API_KEY is None:
    raise RuntimeError("Please set the MISTRAL_API_KEY environment variable.")
client = MistralClient(api_key=MISTRAL_API_KEY)
ऊपर दिया गया कोड ब्लॉक तीन काम करता है:
MISTRAL_API_KEY पढ़ता है और मॉडल का नाम MODEL_ID में सहेजता है, ताकि हम इसे पूरे ऐप में पुन: उपयोग कर सकें।mistralai SDK का उपयोग करके एक MistralClient इंस्टेंस भी बनाता है, जिसका उपयोग हम मॉडल को हर अगली रिक्वेस्ट के लिए करेंगे।क्लाइंट इनिशियलाइज़ होने के साथ, हम अगला कुछ हेल्पर फ़ंक्शन बनाएँगे जो Streamlit UI के भीतर प्रॉम्प्ट भेजेंगे और रिस्पॉन्स संभालेंगे।
Mistral Large 3 को कोई भी इमेज या PDF भेजने से पहले, हमें उन्हें “मॉडल-फ्रेंडली” बनाना होगा। Vision API तब सबसे अच्छा काम करता है जब इनपुट स्क्वायर, उचित आकार के, और एक समान फ़ॉर्मेट में एन्कोडेड हों।
हम अपलोड की गई इमेज को लोड करके उसे स्क्वायर क्रॉप में बदलने से शुरू करते हैं।
def load_image_from_upload(uploaded_file) -> Image.Image:
    return Image.open(io.BytesIO(uploaded_file.read())).convert("RGB")
def center_crop_to_square(img: Image.Image) -> Image.Image:
    width, height = img.size
    if width == height:
        return img
    if width > height:
        offset = (width - height) // 2
        box = (offset, 0, offset + height, height)
    else:
        offset = (height - width) // 2
        box = (0, offset, width, offset + width)
    return img.crop(box)
ऊपर का कोड ब्लॉक सुनिश्चित करता है कि हमारे द्वारा अपलोड किए गए चार्ट या टेबल मॉडल तक जाने से पहले स्क्वायर क्रॉप में बदल दिए जाएँ, जो Mistral की विज़न गाइडेंस के अनुरूप है।
इसके बाद, हम इमेज का आकार अधिकतम (1024×1024) तक रीसाइज़ करते हैं, ताकि गुणवत्ता, लेटेंसी, और टोकन लागत में संतुलन रहे।
def resize_for_vlm(img: Image.Image, max_size: int = 1024) -> Image.Image:
    width, height = img.size
    scale = min(max_size / width, max_size / height, 1.0)
    if scale == 1.0:
        return img
    new_w = int(width * scale)
    new_h = int(height * scale)
    return img.resize((new_w, new_h), Image.LANCZOS)
यहाँ, हम एक scale फ़ैक्टर निकालते हैं जो दोनों डाइमेंशन्स को max_size से नीचे रखते हुए आस्पेक्ट रेशियो को संरक्षित रखता है। अगर इमेज पहले से ही पर्याप्त छोटी है, तो हम उसे ज्यों का त्यों लौटा देते हैं। अन्यथा, हम नए डाइमेंशन निकालते हैं और उच्च-गुणवत्ता वाले डाउनसाइज़िंग के लिए LANCZOS रिसैंपलिंग का उपयोग करते हैं।
यह कदम सुनिश्चित करता है कि इमेज आपका कॉन्टेक्स्ट विंडो अनावश्यक रूप से न बढ़ाएँ या प्रतिक्रिया को धीमा न करें।
PDFs के लिए, हम अक्सर मॉडल को एक से अधिक पेज दिखाना चाहते हैं। एक सरल ट्रिक है सभी पेजों को रेंडर करना और उन्हें वर्टिकली एक लंबी इमेज में स्टैक करना।
def stack_images_vertically(images: List[Image.Image]) -> Image.Image:
    if not images:
        raise ValueError("No images to stack")
    target_width = images[0].size[0]
    resized_images = []
    for img in images:
        if img.size[0] != target_width:
            aspect_ratio = img.size[1] / img.size[0]
            new_height = int(target_width * aspect_ratio)
            img = img.resize((target_width, new_height), Image.LANCZOS)
        resized_images.append(img)
    total_height = sum(img.size[1] for img in resized_images)
    stacked = Image.new('RGB', (target_width, total_height))
    y_offset = 0
    for img in resized_images:
        stacked.paste(img, (0, y_offset))
        y_offset += img.size[1]
    return stacked
def uploaded_file_to_square_base64(uploaded_file) -> Tuple[str, str]:
    mime_type = uploaded_file.type
    raw_bytes = uploaded_file.getvalue()
    if mime_type == "application/pdf":
        pages = convert_from_bytes(raw_bytes)
        pages_rgb = [page.convert("RGB") for page in pages]
        img = stack_images_vertically(pages_rgb)
        img = resize_for_vlm(img, max_size=1024)
        mime_type = "image/png"
    else:
        img = Image.open(io.BytesIO(raw_bytes)).convert("RGB")
        img = center_crop_to_square(img)
        img = resize_for_vlm(img, max_size=1024)
    return mime_type, image_to_base64_data_url(img, mime_type=mime_type)
stack_images_vertically() फ़ंक्शन PIL इमेज की एक सूची लेता है, उन्हें आस्पेक्ट रेशियो संरक्षित रखते हुए एक कॉमन चौड़ाई पर सामान्यीकृत करता है, कुल ऊँचाई निकालता है, और उन्हें एक-दूसरे के नीचे एकल RGB कैनवस पर पेस्ट करता है। जबकि uploaded_file_to_square_base64() फ़ंक्शन इसके बाद MIME टाइप के आधार पर क्या करना है, यह तय करता है:
दोनों ही मामलों में, यह अंतिम एन्कोडिंग स्टेप के लिए MIME टाइप के साथ एक नॉर्मलाइज़्ड इमेज लौटाता है।
Mistral की Vision API image_url ऑब्जेक्ट के रूप में इमेज स्वीकार करती है, जो वास्तविक URLs या data: URLs हो सकते हैं।
def image_to_base64_data_url(img: Image.Image, mime_type: str = "image/png") -> str:
    buffer = io.BytesIO()
    if mime_type == "image/jpeg":
        img.save(buffer, format="JPEG", quality=90)
    else:
        img.save(buffer, format="PNG")
        mime_type = "image/png"
    b64 = base64.b64encode(buffer.getvalue()).decode("utf-8")
    return f"data:{mime_type};base64,{b64}"
हम पहले इमेज को इन-मेमाेरी बफ़र में लिखते हैं और एक उपयुक्त फ़ॉर्मेट (जैसे JPEG या PNG) चुनते हैं, और अंत में बाइट्स को base64 में एन्कोड करते हैं।
अंततः, हम एन्कोडेड स्ट्रिंग को data:{mime_type};base64 URL में रैप करते हैं, जिसे image_url के रूप में सीधे Mistral Vision API को पास किया जा सकता है।
इस चरण के अंत तक, हर अपलोड की गई फ़ाइल—चाहे वह एकल PNG हो, एक वाइड डैशबोर्ड हो, या मल्टी-पेज PDF—एक ही पाइपलाइन से होकर गुजरती है: सेंटर-क्रॉप, रीसाइज़िंग, PDF स्टैकिंग, और base64 डेटा URL रूपांतरण।
इस चरण में, हम सब कुछ एक सिंगल हेल्पर फ़ंक्शन में रैप करते हैं, जो विज़न प्लस टेक्स्ट रिक्वेस्ट भेजता है और मॉडल को JSON फ़ॉर्मेट में उत्तर देने के लिए बाध्य करता है। हम यह निम्नलिखित को मिलाकर करते हैं:
response_format के जरिए पास किया जाता है, ताकि आउटपुट संरचित और आसानी से पार्स होने योग्य रहे।def call_mistral_large_multimodal(
mime_type: str,
image_data_url: str,
user_instruction: str,
languages: List[str],
) -> Dict[str, Any]:
json_schema = {
"type": "object",
"properties": {
"csv_tables": {
"type": "array",
"items": {"type": "string"},
"description": "Each item is a CSV string representing one table found in the image."
},
"insights": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key insights about the content."
},
"risks": {
"type": "array",
"items": {"type": "string"},
"description": "Up to 5 key risks or red flags."
},
"anomalies": {
"type": "array",
"items": {"type": "string"},
"description": "Any anomalies, outliers, or surprising patterns you detect."
},
"translations": {
"type": "object",
"properties": {
lang: {"type": "string"} for lang in languages
},
"description": "Short high-level summaries in the selected languages."
},
},
"required": ["csv_tables", "insights", "risks"],
"additionalProperties": False,
}
system_prompt = (
"You are a Multimodal Intelligence Evaluator using Mistral Large 3.\n"
"You are given a single document-like image (e.g. chart + table, financial report page).\n\n"
"Your tasks:\n"
"1. Read all visible text and numbers directly from the image.\n"
"2. Reconstruct any clearly visible tables into valid CSV strings.\n"
" - Use the first row as headers when possible.\n"
" - Use commas as separators and newline per row.\n"
"3. Derive up to 5 concise INSIGHTS about trends, patterns, or takeaways.\n"
"4. Derive up to 5 concise RISKS or red flags (business, financial, operational, etc.).\n"
"5. Detect any anomalies or surprising patterns if present (else return an empty list).\n"
"6. Provide short summaries in the requested languages.\n\n"
"You MUST respond ONLY with a JSON object that matches the provided JSON schema.\n"
"Do not include any extra commentary outside of the JSON."
)
messages = [
{
"role": "system",
"content": [
{"type": "text", "text": system_prompt},
],
},
{
"role": "user",
"content": [
{
"type": "text",
"text": user_instruction or "Analyze this financial report page.",
},
{
"type": "image_url",
"image_url": image_data_url,
},
],
},
]
response = client.chat(
model=MODEL_ID,
messages=messages,
temperature=0.2,
max_tokens=2048,
response_format={
"type": "json_schema",
"json_schema": {
"name": "multimodal_intel_eval",
"schema": json_schema,
"strict": True,
},
},
)
content = response.choices[0].message.content
try:
parsed = json.loads(content)
except json.JSONDecodeError:
try:
start = content.index("{")
end = content.rindex("}") + 1
parsed = json.loads(content[start:end])
except Exception:
raise ValueError(f"Model did not return valid JSON. Raw content:\n{content}")
return parsedफ़ंक्शन call_mistral_large_multimodal() बहु-मोडल इंटेलिजेंस डेमो का कोर इंजन बनाता है।
csv_tables, insights, risks, anomalies के लिए ऐरे परिभाषित करता है, और languages सूची से निकली कुंजियों वाला एक translations ऑब्जेक्ट भी। call_mistral_large_multimodal() फ़ंक्शन फिर चैट फ़ॉर्मैट में संदेशों की ऐरे बनाता है, जिसमें सिस्टम निर्देशों को एक उपयोगकर्ता संदेश के साथ जोड़ा जाता है जिसमें पाठ निर्देश और image_url पेलोड दोनों होते हैं। यह निर्धारक आउटपुट के लिए तापमान कम रखते हुए MODEL_ID के साथ client.chat() को कॉल करता है, और response_format={"type": "json_schema",} देता है ताकि प्रतिक्रिया स्कीमा के अनुरूप हो। अंत में, हम इसे json.loads से पार्स करने का प्रयास करते हैं।इसके साथ, अब आपके पास किसी कच्चे चार्ट या रिपोर्ट इमेज को संरचित नैरेटिव में बदलने के लिए एक मज़बूत एंट्री पॉइंट है।
प्रीप्रोसेसिंग पाइपलाइन और Mistral क्लाइंट तैयार होने के साथ, अंतिम चरण है सब कुछ एक Streamlit इंटरफ़ेस में लपेटना।
st.set_page_config(
    page_title="Multimodal Intelligence Evaluation Hub - Mistral Large 3",
    layout="wide",
)
st.title("Multimodal Intelligence Evaluation Hub")
st.caption("Powered by **Mistral Large 3**")
col_left, col_right = st.columns([2, 1])
with col_left:
    uploaded_file = st.file_uploader(
        "Upload an image or report (PNG, JPG, WEBP, or PDF)",
        type=["png", "jpg", "jpeg", "webp", "pdf"],
    )
    default_prompt = (
        "Give me 3–5 key insights and risks from this input and export any tables you see as CSV "
        "Also write down the findings for a professional audience."
    )
    user_instruction = st.text_area(
        "Instruction to Mistral Large 3",
        value=default_prompt,
        height=120,
    )
with col_right:
    st.subheader("Multilingual Options")
    languages = st.multiselect(
        "Additional summary languages",
        options=["fr", "de", "es", "hi", "zh", "ja"],
        default=["hi"],
        help="Mistral Large 3 supports dozens of languages; these will receive short summaries.",
        label_visibility="collapsed",
    )
    run_button = st.button("Run Analysis", type="primary")
if run_button:
    if uploaded_file is None:
        st.error("Please upload an image or PDF first.")
        st.stop()
    prep_msg = "Preparing PDF (combining all pages)..." if uploaded_file.type == "application/pdf" else "Preparing image..."
    with st.spinner(prep_msg):
        mime_type, data_url = uploaded_file_to_square_base64(uploaded_file)
    mime, b64_part = data_url.split(",", 1)
    img_bytes = base64.b64decode(b64_part)
    st.image(img_bytes, caption="Center-cropped & resized image for the model", width=400)
    with st.spinner("Processing..."):
        try:
            result = call_mistral_large_multimodal(
                mime_type=mime_type,
                image_data_url=data_url,
                user_instruction=user_instruction,
                languages=languages,
            )
        except Exception as e:
            st.error(f"Error calling Mistral Large 3: {e}")
            st.stop()
    st.header("Results")
    csv_tables = result.get("csv_tables", [])
    if csv_tables:
        st.subheader("Reconstructed Tables (CSV)")
        for i, csv_str in enumerate(csv_tables):
            st.markdown(f"**Table {i+1}**")
            try:
                df = pd.read_csv(io.StringIO(csv_str))
                st.dataframe(df, use_container_width=True)
            except Exception:
                st.text_area(f"Raw CSV for Table {i+1}", value=csv_str, height=150)
            st.download_button(
                label=f"Download Table {i+1} as CSV",
                data=csv_str,
                file_name=f"table_{i+1}.csv",
                mime="text/csv",
                key=f"csv_download_{i}",
            )
    else:
        st.info("No tables were detected or reconstructed.")
    insights = result.get("insights", [])
    risks = result.get("risks", [])
    anomalies = result.get("anomalies", [])
    col_ins, col_risk = st.columns(2)
    with col_ins:
        st.subheader("Key Insights")
        if insights:
            for bullet in insights:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit insights returned._")
    with col_risk:
        st.subheader("Risks")
        if risks:
            for bullet in risks:
                st.markdown(f"- {bullet}")
        else:
            st.write("_No explicit risks returned._")
    st.subheader("Anomalies")
    if anomalies:
        for bullet in anomalies:
            st.markdown(f"- {bullet}")
    else:
        st.write("_No anomalies reported._")
    translations = result.get("translations", {}) or {}
    if translations:
        st.subheader(" Multilingual Summaries")
        for lang_code, summary in translations.items():
            with st.expander(f"Summary in {lang_code}"):
                st.write(summary)
    else:
        st.info("No multilingual summaries were requested or returned.")
    # Raw JSON (debug)
    # with st.expander(" Raw JSON (debug)"):
    #     st.json(result)
ऊपर दिए गए StreamLit UI कोड में कुछ प्रमुख बातें हैं:
st.set_page_config मेथड लेआउट को दो कॉलम में बाँटता है। बाईं ओर मुख्य इनपुट्स हैं (फ़ाइल अपलोडर और डिफ़ॉल्ट निर्देशों वाला एक संपादनयोग्य टेक्स्ट एरिया)। इसके विपरीत, दाईं ओर st.multiselect के माध्यम से बहुभाषी विकल्प और एक प्राथमिक Run Analysis बटन देता है। बटन क्लिक होने पर, ऐप यह मान्य करता है कि कोई फ़ाइल मौजूद है, छवियों या PDF को base64 डेटा URL में परिवर्तित करता है, और पूर्वावलोकन छवि दिखाता है।
जब परिणाम वापस आता है, तो पुनर्निर्मित CSV टेबल्स को डेटा फ़्रेम के रूप में रेंडर किया जाता है, साथ ही इनसाइट्स, जोखिम, विसंगतियाँ, और कोई भी बहुभाषी सारांश। वैकल्पिक रूप से, हम डिबग व्यू (कमेंटेड) भी रख सकते हैं, जो विकास के दौरान रॉ JSON का निरीक्षण करने देता है।
यह चरण पूरा होने के बाद, आप सब कुछ app.py के रूप में सहेज सकते हैं और पूरी अनुभव को इस कमांड से चला सकते हैं:
streamlit run app.pyनीचे दिए गए वीडियो में, आप इमेज और PDF दोनों इनपुट के साथ वर्कफ़्लो का एक संक्षिप्त संस्करण क्रिया में देख सकते हैं:
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स
